尽管特定目标 GPU 中可用的具体资源会有所不同,但资源的种类在各平台之间是共通的,而这些资源在 PTX 中通过状态空间和数据类型加以抽象。
5.1. 状态空间#
状态空间是具有特定特征的存储区域。所有变量都位于某个状态空间之中。状态空间的特征包括其大小、 可寻址性、访问速度、访问权限,以及线程之间的共享级别。
PTX 中定义的状态空间是并行编程和图形编程的副产品。状态空间列表见 表 6,状态空间的属性见 表 7。
名称 |
描述 |
|---|---|
|
寄存器,速度快。 |
|
特殊寄存器。只读;预定义;平台相关。 |
|
共享的只读内存。 |
|
全局内存,由所有线程共享。 |
|
局部内存,每个线程私有。 |
|
Kernel 参数,按网格定义;或 函数或局部参数,按线程定义。 |
|
可寻址内存,按 CTA 定义,在定义它的 CTA 的整个生命周期内, cluster 中的所有线程均可访问。 |
|
全局纹理内存(已弃用)。 |
名称 |
可寻址 |
可初始化 |
访问 |
共享 |
|---|---|---|---|---|
|
否 |
否 |
R/W |
每线程 |
|
否 |
否 |
RO |
每 CTA |
|
是 |
是1 |
RO |
每网格 |
|
是 |
是1 |
R/W |
上下文 |
|
是 |
否 |
R/W |
每线程 |
|
是2 |
否 |
RO |
每网格 |
|
受限3 |
否 |
R/W |
每线程 |
|
是 |
否 |
R/W |
每 cluster5 |
|
否4 |
是,通过驱动程序 |
RO |
上下文 |
|
注释: 1 处于 2 仅可通过 3 可通过 4 仅可通过 5 对所属 CTA 以及 cluster 中的其他活动 CTA 可见。 |
||||
5.1.1. 寄存器状态空间#
寄存器(.reg 状态空间)是快速的存储位置。寄存器的数量有限,并且因平台而异。
当超出该限制时,寄存器变量会被溢出到内存中,从而引起性能变化。每种架构都有建议使用寄存器
数量的上限(详见 CUDA 编程指南)。
寄存器可以是有类型的(有符号整数、无符号整数、浮点、谓词)或无类型的。寄存器大小受限;
除 1 位的谓词寄存器外,标量寄存器的宽度为 8、16、32、64 或 128 位,向量寄存器的宽度为
16、32、64 或 128 位。8 位寄存器最常见的用途是与 ld、st 和 cvt
指令配合使用,或者作为向量元组的元素。
寄存器与其他状态空间的不同之处在于,它们并非完全可寻址,即无法引用寄存器的地址。在使用
应用二进制接口(ABI)进行编译时,寄存器变量被限制在函数作用域内,且不得在模块作用域中声明。
在编译包含模块作用域 .reg 变量的旧式 PTX 代码(ISA 3.0 之前的版本)时,编译器会静默
禁用 ABI 的使用。寄存器可能具有多字宽加载与存储所要求的对齐边界。
5.1.2. 特殊寄存器状态空间#
特殊寄存器(.sreg)状态空间保存预定义的、平台相关的寄存器,例如网格、cluster、
CTA 和线程参数、时钟计数器以及性能监控寄存器。所有特殊寄存器都是预定义的。
5.1.3. 常量状态空间#
常量(.const)状态空间是由主机初始化的只读内存。常量内存通过
ld.const 指令访问。常量内存的大小受限,目前限制为 64 KB,可用于存放静态大小的
常量变量。此外还有 640 KB 的常量内存,组织为十个相互独立的 64 KB 区域。驱动程序可以在这些
区域中分配并初始化常量缓冲区,并将指向这些缓冲区的指针作为 kernel 函数参数传递。由于这十个
区域并不连续,驱动程序必须确保常量缓冲区的分配方式使每个缓冲区完全位于某个 64 KB 区域之内,
而不跨越区域边界。
静态大小的常量变量带有可选的变量初始化器;没有显式初始化器的常量变量默认初始化为零。 由驱动程序分配的常量缓冲区由主机初始化,指向这类缓冲区的指针作为参数传递给 kernel。关于将 指向常量缓冲区的指针作为 kernel 参数传递的更多细节,请参见 Kernel 函数参数属性 中对 kernel 参数属性的说明。
5.1.3.1. 分 bank 常量状态空间(已弃用)#
早期版本的 PTX 将常量内存以十一个 64 KB bank 的形式暴露出来,变量声明和访问时都需要显式的 bank 编号。
在 PTX ISA 2.2 版之前,常量内存被组织为固定大小的 bank。共有十一个 64 KB 的 bank,bank 使用
.const[bank] 修饰符指定,其中 bank 的取值范围为 0 到 10。如果未给出 bank 编号,
则默认为零号 bank。
按照约定,零号 bank 用于所有静态大小的常量变量。其余的 bank 用于声明不完整的常量数组 (例如在 C 语言中),其大小在编译时未知。例如,声明
.extern .const[2] .b32 const_buffer[];
会使 const_buffer 指向二号常量 bank 的起始位置。随后即可使用该指针访问整个
64 KB 的常量 bank。在同一 bank 中声明的多个不完整数组变量彼此别名,各自都指向所指定常量
bank 的起始地址。
要访问一号到十号常量 bank 中的数据,需要在加载指令的状态空间中给出 bank 编号。例如, 二号 bank 中的不完整数组按如下方式访问:
.extern .const[2] .b32 const_buffer[];
ld.const[2].b32  %r1, [const_buffer+4]; // load second word
在 PTX ISA 2.2 版中,我们取消了显式的 bank,并用 kernel 参数属性取代了驱动程序分配的常量 缓冲区的不完整数组表示形式,该属性允许将指向常量缓冲区的指针作为 kernel 参数传递。
5.1.4. 全局状态空间#
全局(.global)状态空间是同一上下文中的所有线程均可访问的内存。它是位于不同
CTA、cluster 和网格中的线程进行通信的机制。使用 ld.global、st.global 和
atom.global 访问全局变量。
全局变量带有可选的变量初始化器;没有显式初始化器的全局变量默认初始化为零。
5.1.5. 局部状态空间#
局部状态空间(.local)是每个线程私有的内存,用于保存其自身数据。它通常是带缓存的
标准内存。其大小受限,因为必须按线程分配。使用 ld.local 和 st.local 访问局部
变量。
在使用应用二进制接口(ABI)进行编译时,.local 状态空间的变量必须在函数作用域内声明,
并分配在栈上。在不支持栈的实现中,所有局部内存变量都存储在固定地址上,不支持递归函数调用,
并且 .local 变量可以在模块作用域中声明。在编译包含模块作用域 .local 变量的旧式
PTX 代码(ISA 3.0 之前的版本)时,编译器会静默禁用 ABI 的使用。
5.1.6. 参数状态空间#
参数(.param)状态空间用于(1)将输入实参从主机传递给 kernel,(2a)为在 kernel 执行
过程中调用的设备函数声明形式输入参数与返回参数,以及(2b)声明用作函数调用实参的局部作用域
字节数组变量,典型场景是按值向函数传递大型结构体。Kernel 函数参数与设备函数参数在访问和共享
方面有所不同(只读与读写,按 kernel 与按线程)。请注意,PTX ISA 1.x 版仅支持 .param 空间中的
kernel 函数参数;设备函数参数此前被限制在寄存器状态空间中。将参数状态空间用于设备函数参数
自 PTX ISA 2.0 版引入,并要求目标架构为 sm_20 或更高版本。在带有 .param 状态空间的
指令上,可以额外指定子限定符 ::entry 或 ::func,以表明该地址指的是 kernel 函数参数
还是设备函数参数。如果与 .param 状态空间一起未指定子限定符,则默认的子限定符因具体指令
而异,并取决于该指令。例如,st.param 等价于 st.param::func,而
isspacep.param 等价于 isspacep.param::entry。有关默认子限定符推断的更多细节,
请参阅相应指令的说明。
注
参数空间的位置由具体实现决定。例如,在某些实现中 kernel 参数位于全局内存中,此时参数空间与
全局空间之间不提供访问保护。尽管 kernel 参数空间的确切位置由实现决定,但 kernel 参数空间窗口
始终包含在全局空间窗口之内。类似地,函数参数根据应用二进制接口(ABI)的函数调用约定被映射到
参数传递寄存器和/或栈位置。因此,PTX 代码不应针对 .param 空间变量的相对位置或排列顺序
作出任何假设。
5.1.6.1. Kernel 函数参数#
每个 kernel 函数定义都可包含一个可选的参数列表。这些参数是在 .param 状态空间中声明的
可寻址、只读变量。从主机传递给 kernel 的值通过这些参数变量、使用 ld.param 指令访问。
Kernel 参数变量在同一网格内所有 cluster 的所有 CTA 之间共享。
Kernel 参数的地址可以使用 mov 指令移动到寄存器中。所得到的地址处于
.param 状态空间,并使用 ld.param 指令访问。
示例
.entry foo ( .param .b32 N, .param .align 8 .b8 buffer[64] )
{
.reg .u32 %n;
.reg .f64 %d;
ld.param.u32 %n, [N];
ld.param.f64 %d, [buffer];
...
plaintext
示例
.entry bar ( .param .b32 len )
{
.reg .u32 %ptr, %n;
mov.u32 %ptr, len;
ld.param.u32 %n, [%ptr];
...
plaintext
Kernel 函数参数可以表示普通数据值,也可以保存指向常量、全局、局部或共享状态空间中对象的地址。 就指针而言,编译器和运行时系统需要了解哪些参数是指针,以及它们指向哪个状态空间。Kernel 参数 属性指示符用于在 PTX 层面提供这一信息。关于 kernel 参数属性指示符的说明,请参见 Kernel 函数参数属性。
注
当前实现不允许在把指向常量缓冲区的指针作为 kernel 参数传递的程序中创建指向常量变量的通用指针
(cvta.const)。
5.1.6.2. Kernel 函数参数属性#
Kernel 函数参数在声明时可以带上可选的 .ptr 属性,用以表明该参数是指向内存的指针,并同时指出
所指内存的状态空间与对齐要求。Kernel 参数属性:.ptr
介绍了 .ptr kernel 参数属性。
5.1.6.3. Kernel 参数属性:.ptr#
.ptr
Kernel 参数对齐属性。
语法
.param .type .ptr .space .align N  varname
.param .type .ptr        .align N  varname
.space = { .const, .global, .local, .shared };
说明
用于指定指针类型 kernel 参数所指内存的状态空间,并可选地指定其对齐要求。若存在对齐值 N, 则它必须是 2 的幂。若未指定状态空间,则该指针被视为通用地址,指向常量、全局、局部或共享内存之一。 若未指定对齐要求,则默认所指内存按 4 字节边界对齐。
.ptr、.space 与 .align 之间的空格可以省略,以提升可读性。
示例
.entry foo ( .param .u32 param1,
             .param .u32 .ptr.global.align 16 param2,
             .param .u32 .ptr.const.align 8 param3,
             .param .u32 .ptr.align 16 param4  // generic address
                                               // pointer
) { .. }
5.1.6.4. 设备函数参数#
PTX ISA 2.0 版将参数空间的用法扩展到设备函数参数。最常见的用途是按值传递无法放入 PTX 寄存器的
对象,例如大于 8 字节的 C 结构体。在这种情况下,使用参数空间中的字节数组。通常,调用方会声明一个
局部作用域的 .param 字节数组变量,它代表一个被展平的 C 结构体或联合体。该变量按值传递给被
调用方,后者声明一个 .param 形式参数,其大小与对齐与传入实参相同。
示例
// pass object of type struct { double d; int y; };
.func foo ( .reg .b32 N, .param .align 8 .b8 buffer[12] )
{
.reg .f64 %d;
.reg .s32 %y;
ld.param.f64 %d, [buffer];
ld.param.s32 %y, [buffer+8];
...
plaintext
}
// code snippet from the caller
// struct { double d; int y; } mystruct; is flattened, passed to foo
…
.reg .f64 dbl;
.reg .s32 x;
.param .align 8 .b8 mystruct;
…
st.param.f64 [mystruct+0], dbl;
st.param.s32 [mystruct+8], x;
call foo, (4, mystruct);
…
更多细节请参见函数调用语法一节。
函数输入参数可通过 ld.param 读取,函数返回参数可使用 st.param 写入;向输入参数
写入或从返回参数读取都是非法的。
除了按值传递结构体之外,只要被调用函数内部对某个形式参数取地址,就必须使用 .param 空间。
在 PTX 中,函数输入参数的地址可以使用 mov 指令移动到寄存器中。请注意,必要时该参数会被
复制到栈上,因此其地址处于 .local 状态空间,并通过 ld.local 和
st.local 指令访问。无法使用 mov 来获取局部作用域 .param 空间变量的地址。
自 PTX ISA 6.0 版起,可以使用 mov 指令获取设备函数返回参数的地址。
示例
// pass array of up to eight floating-point values in buffer
.func foo ( .param .b32 N, .param .b32 buffer[32] )
{
.reg .u32 %n, %r;
.reg .f32 %f;
.reg .pred %p;
ld.param.u32 %n, [N];
mov.u32 %r, buffer; // forces buffer to .local state space
plaintext
Loop:
setp.eq.u32 %p, %n, 0;
@%p bra Done;
ld.local.f32 %f, [%r];
…
add.u32 %r, %r, 4;
sub.u32 %n, %n, 1;
bra Loop;
Done:
…
}
5.1.7. 共享状态空间#
共享(.shared)状态空间是由正在执行的 CTA 拥有的内存,并对同一 cluster 内所有 CTA 的
线程可访问。共享内存中的地址可以被 CTA cluster 中的任意线程读取和写入。
在带有 .shared 状态空间的指令上,可以额外指定子限定符 ::cta 或
::cluster,分别用以表明该地址属于正在执行的 CTA 的共享内存窗口,还是属于 cluster 中
任意 CTA 的共享内存窗口。.shared::cta 窗口中的地址同样落在
.shared::cluster 窗口之内。如果与 .shared 状态空间一起未指定子限定符,则默认为
::cta。例如,ld.shared 等价于 ld.shared::cta。
在 .shared 状态空间中声明的变量指的是当前 CTA 中的内存地址。指令
mapa 给出 cluster 内另一个 CTA 中对应变量的 .shared::cluster 地址。
共享内存通常有一些为支持共享而做的优化。一个例子是广播,即所有线程从同一地址读取。另一个是 顺序线程的顺序访问。
静态分配共享内存的最大容量为每个 CTA 48 KB。
诸如 sm_90a 这样的架构专用目标,支持超出每个 CTA 48 KB 的扩展静态分配共享内存容量,
如下文所述:
目标架构 |
静态分配共享内存的最大大小 |
|---|---|
|
228 KB |
|
228 KB |
|
228 KB |
|
100 KB |
5.1.8. 纹理状态空间(已弃用)#
纹理(.tex)状态空间是通过纹理指令访问的全局内存。它由上下文中的所有线程共享。纹理
内存是只读且被缓存的,因此对纹理内存的访问与对纹理图像的全局内存写入之间不保证一致性。
GPU 硬件可访问的纹理绑定数量是固定的,可在单个 kernel 内使用(通常为 128 个)。.tex 指示符会把
具名纹理内存变量绑定到一个硬件纹理标识符上,其中纹理标识符从零开始按顺序分配。多个名称可以绑定到
同一个物理纹理标识符。如果超出物理资源数量的上限,则会生成错误。纹理名称必须是
.u32 或 .u64 类型。
物理纹理资源按 kernel 粒度分配,并且 .tex 变量必须定义在全局作用域中。
纹理内存是只读的。纹理的基地址默认按 16 字节边界对齐。
示例
.tex .u32 tex_a;         // bound to physical texture 0
.tex .u32 tex_c, tex_d;  // both bound to physical texture 1
.tex .u32 tex_d;         // bound to physical texture 2
.tex .u32 tex_f;         // bound to physical texture 3
注
在纹理状态空间中显式声明变量这一做法已被弃用,程序应当改为通过 .texref 类型的变量引用
纹理内存。.tex 指示符为向后兼容而保留,并且在 .tex 状态空间中声明的变量等价于
.global 状态空间中模块作用域的 .texref 变量。
例如,如下旧式 PTX 定义
.tex .u32 tex_a;
等价于:
.global .texref tex_a;
关于 .texref 类型的说明,请参见
纹理、采样器与表面类型;关于其在纹理指令中的用法,请参见
纹理指令。
5.2. 类型#
5.2.1. 基本类型#
在 PTX 中,基本类型反映了目标架构所支持的原生数据类型。一个基本类型同时指定一个基础类型和一个大小。寄存器变量始终是基本类型,指令也在这些类型上操作。类型-大小指定符同时用于变量定义和指令类型限定,因此它们的名称被刻意取短。
表 8 列出了每种基础类型的基本类型指定符:
基础类型 |
基本类型指定符 |
|---|---|
有符号整数 |
|
无符号整数 |
|
浮点 |
|
位(无类型) |
|
谓词 |
|
大多数指令有一个或多个类型指定符,用于完整指定指令行为。操作数的类型和大小会与指令类型进行兼容性检查。
如果两个基本类型具有相同的基础类型且大小相同,则它们兼容。如果有符号和无符号整数类型大小相同,则它们兼容。位大小类型与任何具有相同大小的基本类型兼容。
原则上,所有变量(谓词除外)都可以仅使用位大小类型来声明,但带类型的变量能提升程序可读性,并允许更好的操作数类型检查。
5.2.2. 子字宽的受限使用#
.u8、.s8 和 .b8 指令类型仅限于 ld、st、add、sub、min、max、neg 和 cvt 指令。.f16 浮点类型在半精度浮点指令和纹理获取指令中允许使用。.f16x2 浮点类型仅在半精度浮点算术指令和纹理获取指令中允许使用。
为方便起见,ld、st 和 cvt 指令允许源和目标数据操作数宽于指令类型大小,从而可以使用常规宽度寄存器来加载、存储和转换窄值。例如,在加载、存储或转换为其他类型和大小时,8 位或 16 位值可以直接保存在 32 位或 64 位寄存器中。
5.2.3. 其他浮点数据格式#
PTX 中支持的基本浮点类型具有隐含的位表示,用以指示用于存储指数和尾数的位数。例如,.f16 类型表示指数预留 5 位、尾数预留 10 位。除了基本类型所假定的浮点表示之外,PTX 还允许以下其他浮点数据格式:
-
bf16数据格式: -
此数据格式是一种 16 位浮点格式,指数 8 位,尾数 7 位。包含
bf16数据的寄存器变量必须以.b16类型声明。 -
e4m3数据格式: -
此数据格式是一种 8 位浮点格式,指数 4 位,尾数 3 位。
e4m3编码不支持无穷大,且NaN值仅限于0x7f和0xff。包含e4m3值的寄存器变量必须使用位大小类型声明。 -
e5m2数据格式: -
此数据格式是一种 8 位浮点格式,指数 5 位,尾数 2 位。包含
e5m2值的寄存器变量必须使用位大小类型声明。 -
tf32数据格式: -
此数据格式是一种特殊的 32 位浮点格式,由矩阵乘加指令支持,范围与
.f32相同但精度降低(>=10 位)。tf32格式的内部布局由实现定义。PTX 支持从单精度.f32类型到tf32格式的转换。包含tf32数据的寄存器变量必须以.b32类型声明。 -
e2m1数据格式: -
此数据格式是一种 4 位浮点格式,指数 2 位,尾数 1 位。
e2m1编码不支持无穷大和NaN。e2m1值必须以指定为e2m1x2的打包格式使用。包含两个e2m1值的寄存器变量必须以.b8类型声明。 -
e2m3数据格式: -
此数据格式是一种 6 位浮点格式,指数 2 位,尾数 3 位。
e2m3编码不支持无穷大和NaN。e2m3值必须以指定为e2m3x2的打包格式使用。包含两个e2m3值的寄存器变量必须以.b16类型声明,其中每个.b8元素包含 6 位浮点值,最高 2 位(MSB)用零填充。 -
e3m2数据格式: -
此数据格式是一种 6 位浮点格式,指数 3 位,尾数 2 位。
e3m2编码不支持无穷大和NaN。e3m2值必须以指定为e3m2x2的打包格式使用。包含两个e3m2值的寄存器变量必须以.b16类型声明,其中每个.b8元素包含 6 位浮点值,最高 2 位(MSB)用零填充。 -
ue8m0数据格式: -
此数据格式是一种 8 位无符号浮点格式,指数 8 位,尾数 0 位。
ue8m0编码不支持无穷大。NaN值仅限于0xff。ue8m0值必须以指定为ue8m0x2的打包格式使用。包含两个ue8m0值的寄存器变量必须以.b16类型声明。 -
ue4m3数据格式: -
此数据格式是一种 7 位无符号浮点格式,指数 4 位,尾数 3 位。
ue4m3编码不支持无穷大。NaN值仅限于0x7f。包含单个ue4m3值的寄存器变量必须以.b8类型声明,最高位(MSB)用零填充。 -
ue5m3数据格式: -
此数据格式是一种 8 位无符号浮点格式,指数 5 位,尾数 3 位。
ue5m3编码不支持无穷大。NaN值仅限于0xff。包含单个ue5m3值的寄存器变量必须以.b8类型声明。
其他数据格式不能作为基本类型使用。它们仅在某些指令中作为源格式或目标格式受支持。
5.2.4. 定点数据格式#
PTX 支持以下定点数据格式:
-
s2f6数据格式: -
此数据格式是 8 位有符号 2 的补码整数,含 2 位符号整数位和 6 位小数位,形式为 xx.xxxxxx。
s2f6编码不支持无穷大和NaN。s2f6值 = s8 值 * 2^(-6) 正最大值表示 = 01.111111 = 127 * 2^(-6) = 1.984375 负最大值表示 = 10.000000 = -128 * 2^(-6) = -2.0
5.2.5. 打包数据类型#
某些 PTX 指令并行地作用于两组或更多组输入,并产生两组或更多组输出。这样的指令可以使用以打包格式存储的数据。PTX 支持将两个或四个相同标量数据类型的值打包成单个更大的值。该打包值被视为一种打包数据类型的值。本节介绍 PTX 支持的打包数据类型。
5.2.5.1. 打包浮点数据类型#
PTX 支持打包浮点数据类型的多种变体。其中,只有 .f16x2 作为基本类型受支持,而其他类型不能作为基本类型使用——它们在某些指令中作为指令类型受支持。使用带有此类非基本类型的指令时,操作数数据变量必须是大小合适的位类型。例如,对于指令类型为 .bf16x2 的指令,所有操作数变量都必须是 .b32 类型。表 9 描述了 PTX 中打包浮点数据类型的各种变体。
打包浮点类型 |
打包格式包含的元素数量 |
每个元素的类型 |
声明中使用的寄存器变量类型 |
|---|---|---|---|
|
两个 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
||
|
|
||
|
|
||
|
|
||
|
|
||
|
|
|
|
|
四个 |
|
|
|
|
||
|
|
||
|
|
||
|
|
||
|
|
||
|
|
|
5.2.5.2. 打包整数数据类型#
PTX 支持四种打包整数数据类型的变体:.u16x2、.s16x2、.u8x4 和 .s8x4。.u16x2、.s16x2 打包数据类型由两个 .u16 或 .s16 值组成。.u8x4、.s8x4 打包数据类型由四个 .u8 或 .s8 值组成。包含 .u16x2、.s16x2、.u8x4、.s8x4 数据的寄存器变量必须以 .b32 类型声明。打包整数数据类型不能作为基本类型使用。它们在某些指令中作为指令类型受支持。
5.2.5.3. 打包定点数据类型#
PTX 支持 .s2f6x2 打包定点数据类型,由两个 .s2f6 打包定点值组成。包含 .s2f6x2 值的寄存器变量必须以 .b16 类型声明。打包定点数据类型不能作为基本类型使用,仅作为指令类型受支持。
5.3. 纹理、采样器与表面类型#
PTX 包含用于定义纹理、采样器和表面描述符变量的内置不透明类型。这些类型具有类似于结构体的命名字段,但关于布局、字段顺序、基地址和整体大小的所有信息对 PTX 程序都是隐藏的,因此称为不透明。这些不透明类型的使用仅限于:
在全局(模块)作用域内以及 kernel 入口参数列表中进行变量定义。
使用以逗号分隔的静态赋值表达式,对该类型的命名字段进行模块作用域变量的静态初始化。
通过纹理和表面加载/存储指令(
tex、suld、sust、sured)引用纹理、采样器或表面。通过查询指令(
txq、suq)获取命名字段的值。使用
mov创建指向不透明变量的指针,例如mov.u64 reg, opaque_var;。所得指针可以存储到内存并从内存加载,可作为参数传递给函数,并可被纹理和表面的加载、存储、查询指令解引用,但该指针不能以其他方式被当作地址处理,即用ld和st指令访问该指针或执行指针运算将导致未定义的结果。不透明变量不得出现在初始化器中,例如用于初始化指向不透明变量的指针。
注
从 PTX ISA 3.1 版开始,支持使用指向不透明变量的指针对纹理和表面进行间接访问,并要求目标为 sm_20 或更高。
仅在统一纹理模式下支持对纹理的间接访问(见下文)。
这三种内置类型是 .texref、.samplerref 和 .surfref。在处理纹理和采样器方面,PTX 有两种操作模式。在统一模式下,纹理和采样器信息通过单个 .texref 句柄访问。在独立模式下,纹理和采样器信息各自拥有自己的句柄,允许它们分别定义,并在程序中的使用处组合。在独立模式下,.texref 类型中描述采样器属性的字段会被忽略,因为这些属性由 .samplerref 变量定义。
表 10 和 表 11 列出了统一和独立纹理模式下每种类型的命名字段。这些字段及其值与在纹理 HW 类中定义的方法与值,以及通过 API 暴露的值具有精确的映射关系。
成员 |
.texref 值 |
.surfref 值 |
|---|---|---|
|
以元素为单位 |
|
|
以元素为单位 |
|
|
以元素为单位 |
|
|
|
|
|
|
|
|
|
N/A |
|
|
N/A |
|
|
N/A |
|
作为纹理数组中纹理的数量 |
作为表面数组中表面的数量 |
|
作为带 mipmap 的纹理中的层级数量 |
N/A |
|
作为多重采样纹理中的采样数量 |
N/A |
|
N/A |
|
5.3.1. 纹理与表面属性#
width、height 和 depth 字段以每个维度中的元素数量指定纹理或表面的大小。
channel_data_type 和 channel_order 字段使用与源语言 API 对应的枚举类型来指定纹理或表面的这些属性。例如,参见 通道数据类型与通道顺序字段 了解 PTX 当前支持的 OpenCL 枚举类型。
5.3.2. 采样器属性#
normalized_coords 字段指示纹理或表面使用的是范围 [0.0, 1.0) 内的归一化坐标,还是范围 [0, N) 内的非归一化坐标。如果未指定值,则由运行时系统根据源语言设置默认值。
filter_mode 字段指定如何根据输入的纹理坐标计算纹理读取所返回的值。
addr_mode_{0,1,2} 字段定义每个维度中的寻址模式,决定如何处理越界坐标。
有关这些属性的更多细节,请参阅CUDA C++ 编程指南。
成员 |
.samplerref 值 |
.texref 值 |
.surfref 值 |
|---|---|---|---|
|
N/A |
以元素为单位 |
|
|
N/A |
以元素为单位 |
|
|
N/A |
以元素为单位 |
|
|
N/A |
|
|
|
N/A |
|
|
|
N/A |
|
N/A |
|
|
N/A |
N/A |
|
|
忽略 |
N/A |
|
|
N/A |
N/A |
|
N/A |
作为纹理数组中纹理的数量 |
作为表面数组中表面的数量 |
|
N/A |
作为带 mipmap 的纹理中的层级数量 |
N/A |
|
N/A |
作为多重采样纹理中的采样数量 |
N/A |
|
N/A |
N/A |
|
在独立纹理模式下,采样器属性由独立的 .samplerref 变量承载,并且这些字段在 .texref 变量中被禁用。另有一个额外的采样器属性 force_unnormalized_coords 在独立纹理模式下可用。
force_unnormalized_coords 字段是 .samplerref 变量的一项属性,允许采样器覆盖纹理头中的 normalized_coords 属性。此字段仅在独立纹理模式下定义。当为 True 时,覆盖纹理头设置并使用非归一化坐标;当为 False 时,使用纹理头设置。
force_unnormalized_coords 属性用于编译 OpenCL;在 OpenCL 中,归一化坐标这一属性由采样器头承载。为了将 OpenCL 编译为 PTX,纹理头始终以 normalized_coords 设为 True 的方式初始化,而基于 OpenCL 采样器的 normalized_coords 标志会(取反后)映射到 PTX 层面的 force_unnormalized_coords 标志。
使用这些类型的变量可以在模块作用域内或 kernel 入口参数列表中声明。在模块作用域中,这些变量必须位于 .global 状态空间中。作为 kernel 参数时,这些变量在 .param 状态空间中声明。
示例
.global .texref     my_texture_name;
.global .samplerref my_sampler_name;
.global .surfref    my_surface_name;
在模块作用域中声明时,这些类型可以使用一组静态表达式列表进行初始化,为命名字段赋值。
示例
.global .texref tex1;
.global .samplerref tsamp1 = { addr_mode_0 = clamp_to_border,
                               filter_mode = nearest
                             };
5.3.3. 通道数据类型与通道顺序字段#
channel_data_type 和 channel_order 字段具有与源语言 API 对应的枚举类型。目前,OpenCL 是唯一定义这些字段的源语言。表 13 和 表 12 展示了 OpenCL 1.0 版中为通道数据类型和通道顺序定义的枚举值。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
5.4. 变量#
在 PTX 中,变量声明同时描述变量的类型及其状态空间。除基本类型之外,PTX 还支持用于简单聚合 对象(如向量和数组)的类型。
5.4.1. 变量声明#
数据的所有存储都通过变量声明来指定。每个变量必须位于上一节列举的状态空间之一中。
变量声明指明变量所处的空间、其类型与大小、其名称、可选的数组大小、可选的初始化器, 以及变量的可选固定地址。
谓词变量只能在寄存器状态空间中声明。
示例
.global .u32 loc;
.reg    .s32 i;
.const  .f32 bias[] = {-1.0, 1.0};
.global .u8  bg[4] = {0, 0, 0, 0};
.reg    .v4 .f32 accel;
.reg    .pred p, q, r;
5.4.2. 向量#
支持限长向量类型。任意非谓词基本类型的长度为 2 和 4 的向量,可以通过在类型前加上 .v2 或 .v4 来声明。向量必须
基于一个基本类型,并且可以位于寄存器空间中。向量长度不能超过 128 位;例如,.v4 .f64 是不允许的。三元素向量可以
通过使用 .v4 向量来处理,其中第四个元素提供填充。这是三维网格、纹理等的常见情形。
示例
.global .v4 .f32 V;   // a length-4 vector of floats
.shared .v2 .u16 uv;  // a length-2 vector of unsigned ints
.global .v4 .b8  v;   // a length-4 vector of bytes
默认情况下,向量变量对齐到其整体大小(向量长度乘以基本类型大小)的倍数,以启用要求地址对齐到 访问大小倍数的向量加载和存储指令。
5.4.3. 数组声明#
提供数组声明以允许程序员保留空间。要声明数组,变量名后面跟随维度声明,类似于 C 中的固定大小数组 声明。每个维度的大小是一个常量表达式。
示例
.local  .u16 kernel[19][19];
.shared .u8  mailbox[128];
数组的大小指定应保留多少个元素。对于上述数组 kernel 的声明,保留了 19*19 = 361 个半字, 总计 722 字节。
当使用初始化器声明时,数组的第一个维度可以省略。数组第一维的大小由数组初始化器中元素的数目决定。
示例
.global .u32 index[] = { 0, 1, 2, 3, 4, 5, 6, 7 };
.global .s32 offset[][2] = { {-1, 0}, {0, -1}, {1, 0}, {0, 1} };
数组 index 有八个元素,数组 offset 是一个 4x2 数组。
5.4.4. 初始化器#
声明的变量可以使用类似于 C/C++ 的语法指定初始值,其中变量名后跟一个等号以及变量的初始值(单个 或多个)。标量取单个值,而向量和数组取花括号内嵌套的值列表(嵌套与声明的维度相对应)。
与 C 中一样,数组初始化器可以是不完整的,即初始化器元素的数目可以少于对应数组维度的范围, 其余数组位置被初始化为指定数组类型的默认值。
示例
.const  .f32 vals[8] = { 0.33, 0.25, 0.125 };
.global .s32 x[3][2] = { {1,2}, {3} };
等价于
.const  .f32 vals[8] = { 0.33, 0.25, 0.125, 0.0, 0.0, 0.0, 0.0, 0.0 };
.global .s32 x[3][2] = { {1,2}, {3,0}, {0,0} };
目前,变量初始化仅对常量和全局状态空间受支持。常量和全局状态空间中没有显式初始化器的变量默认 初始化为零。外部变量声明中不允许使用初始化器。
出现在初始化器中的变量名表示变量的地址;这可用于静态初始化指向变量的指针。初始化器还可以包含 var+offset
表达式,其中 offset 是加到 var 地址上的字节偏移。只有在
.global 或 .const 状态空间中的变量才能用于初始化器。默认情况下,得到的
地址是变量所在状态空间中的偏移(与使用 mov 指令取变量地址的情形相同)。提供了一个运算符 generic(),
为初始化器中使用的变量创建通用地址。
自 PTX ISA 7.1 版起,提供了一个运算符 mask(),其中 mask 是一个整数
常量。mask() 运算符中唯一允许的表达式是整数常量表达式以及表示变量地址的符号表达式。mask() 运算符从初始化器中使用的表达式提取 n
个连续位,并将这些位插入到被初始化变量的最低位位置。数目 n 以及待提取位的起始位置
由整数常量 mask 指定。PTX ISA 7.1 版仅支持从变量地址按字节边界起始提取单个字节。PTX ISA
7.3 版支持将整数常量表达式作为 mask() 运算符中的操作数。
mask 支持的值为:0xFF, 0xFF00, 0XFF0000, 0xFF000000, 0xFF00000000, 0xFF0000000000,
0xFF000000000000, 0xFF00000000000000。
示例
.const  .u32 foo = 42;
.global .u32 bar[] = { 2, 3, 5 };
.global .u32 p1 = foo;          // offset of foo in .const space
.global .u32 p2 = generic(foo); // generic address of foo
// array of generic-address pointers to elements of bar
.global .u32 parr[] = { generic(bar), generic(bar)+4,
generic(bar)+8 };
// examples using mask() operator are pruned for brevity
.global .u8 addr[] = {0xff(foo), 0xff00(foo), 0xff0000(foo), …};
.global .u8 addr2[] = {0xff(foo+4), 0xff00(foo+4), 0xff0000(foo+4),…}
.global .u8 addr3[] = {0xff(generic(foo)), 0xff00(generic(foo)),…}
.global .u8 addr4[] = {0xff(generic(foo)+4), 0xff00(generic(foo)+4),…}
// mask() operator with integer const expression
.global .u8 addr5[] = { 0xFF(1000 + 546), 0xFF00(131187), …};
注
PTX 3.1 重新定义了初始化器中全局变量的默认寻址方式,从通用地址改为全局状态空间中的偏移。遗留
PTX 代码被视为对初始化器中使用的每个全局变量都有一个隐式的 generic() 运算符。PTX 3.1 代码应当
要么在初始化器中包含显式的 generic() 运算符,要么使用 cvta.global 在运行时形成
通用地址,要么使用 ld.global 从非通用地址加载。
出现在初始化器中的设备函数名表示函数中第一条指令的地址;这可用于初始化一个函数指针表,以供间接 调用使用。自 PTX ISA 3.1 版起,kernel 函数名可以用作初始化器,例如初始化一个 kernel 函数指针表,以与 CUDA 动态并行性(CUDA Dynamic Parallelism)配合从 GPU 启动 kernel。详见 CUDA Dynamic Parallelism Programming Guide。
标签不能用于初始化器中。
保存变量或函数地址的变量应当为类型 .u8 或 .u32 或
.u64。
仅当使用 mask() 运算符时才允许类型 .u8。
除 .f16、.f16x2 和 .pred 之外的所有类型都允许使用初始化器。
示例
.global .s32 n = 10;
.global .f32 blur_kernel[][3]
               = {{.05,.1,.05},{.1,.4,.1},{.05,.1,.05}};
.global .u32 foo[] = { 2, 3, 5, 7, 9, 11 };
.global .u64 ptr = generic(foo);   // generic address of foo[0]
.global .u64 ptr = generic(foo)+8; // generic address of foo[2]
5.4.5. 对齐#
所有可寻址变量的存储的字节对齐可以在变量声明中指定。对齐通过使用一个可选的 .align byte-count 说明符来指定,
该说明符紧接在状态空间说明符之后。变量将对齐到一个作为 byte-count 整数倍量的地址。对齐值 byte-count 必须是 2 的幂。对于数组,对齐
指定的是整个数组起始地址的地址对齐,而非各个元素的对齐。
标量和数组变量的默认对齐是基本类型大小的倍数。向量变量的默认对齐是向量整体大小的倍数。
示例
 // allocate array at 4-byte aligned address.  Elements are bytes.
.const .align 4 .b8 bar[8] = {0,0,0,0,2,0,0,0};
请注意,所有访问内存的 PTX 指令都要求地址对齐到访问大小的倍数。内存指令的访问大小是内存中访问的
字节总数。例如,ld.v4.b32 的访问大小为 16 字节,而 atom.f16x2 的访问大小为 4 字节。
5.4.6. 参数化变量名#
由于 PTX 支持虚拟寄存器,编译器前端生成大量寄存器名是很常见的。PTX 支持一种语法,用于创建一组具有 公共前缀字符串并附加整数后缀的变量,而不要求对每个名字进行显式声明。
例如,假设某个程序使用了大量(比如说一百个).b32 变量,命名为
%r0、%r1、…、%r99。这 100 个寄存器变量可以按如下方式声明:
.reg .b32 %r<100>; // declare %r0, %r1, ..., %r99
这种简写语法可以与任意基本类型以及任意状态空间一起使用,并且可以在前面加上一个对齐说明符。数组变量 不能以这种方式声明,也不允许使用初始化器。
5.4.7. 变量属性#
变量可以使用一个可选的 .attribute 指示符进行声明,该指示符允许指定变量的特殊
属性。关键字 .attribute 之后是括号内的属性说明。多个属性之间用逗号分隔。
变量和函数属性指示符:.attribute 描述了 .attribute
指示符。
5.4.8. 变量和函数属性指示符:.attribute#
.attribute
变量和函数属性
说明
用于指定变量或函数的特殊属性。
支持以下属性。
.managed-
.managed属性指定变量将被分配到统一虚拟内存环境中的一个位置,在该位置主机和系统中的其他设备可以直接引用该变量。此属性只能与 .global 状态空间中的变量一起使用。详见 CUDA UVM-Lite Programming Guide。 .unified-
.unified属性指定函数在主机上和系统中的其他设备上 具有相同的内存地址。整数常量uuid1和uuid2分别指定与函数或变量关联的唯一标识符的高 64 位和低 64 位。此 属性只能用于设备函数,或用于.global状态空间中的变量。带有.unified属性的变量是只读的,并且必须通过指定.unified限定符在ld指令的地址操作数上来加载,否则行为是 未定义的。
示例
.global .attribute(.managed) .s32 g;
.global .attribute(.managed) .u64 x;
.global .attribute(.unified(19,95)) .f32 f;
.func .attribute(.unified(0xAB, 0xCD)) bar() { … }
5.5. 张量#
张量是内存中的一种多维矩阵结构。张量由以下属性定义:
维度数
各维度上的维度大小
各个元素类型
各维度上的张量步长
PTX 支持可对张量数据进行操作的指令。PTX 张量指令包括:
在全局内存与共享内存之间复制数据
用源对目标张量数据进行归约。
张量数据可由各种 wmma.mma、mma 和 wgmma.mma_async
指令进行操作。
PTX 张量指令将全局内存中的张量数据视为多维结构,并将共享内存中的数据视为线性数据。
5.5.1. 张量维度、大小与格式#
张量可以具有如下维度:1D、2D、3D、4D 或 5D。
每个维度都有一个大小,表示沿该维度的元素数量。这些元素可以具有以下类型之一:
位宽类型:
.b32、.b64子字节类型:
.b4x16、.b4x16_p64、.b6x16_p32、.b6p2x16整数:
.u8、.u16、.u32、.s32、.u64、.s64浮点与其他浮点:
.f16、.bf16、.tf32、.f32、.f64(向最近偶数舍入)。
张量可以在每个维度的末尾设置填充,为后续维度中的数据提供对齐。可使用张量步长来指定每个维度中的填充量。
5.5.1.1. 子字节类型#
5.5.1.1.1. 子字节类型的填充与对齐#
子字节类型预期在全局内存中连续打包,张量复制指令将通过追加空位将它们展开,如下所示:
类型
.b4x16: 使用该类型时不涉及填充,一个 64 位容器内打包的十六个.b4元素 会在共享内存与全局内存之间原样复制。-
类型
.b4x16_p64: 使用该类型时,将 16 段连续的 4 位数据从全局内存复制到共享内存,并在其后追加 64 位填充,如 图 5所示。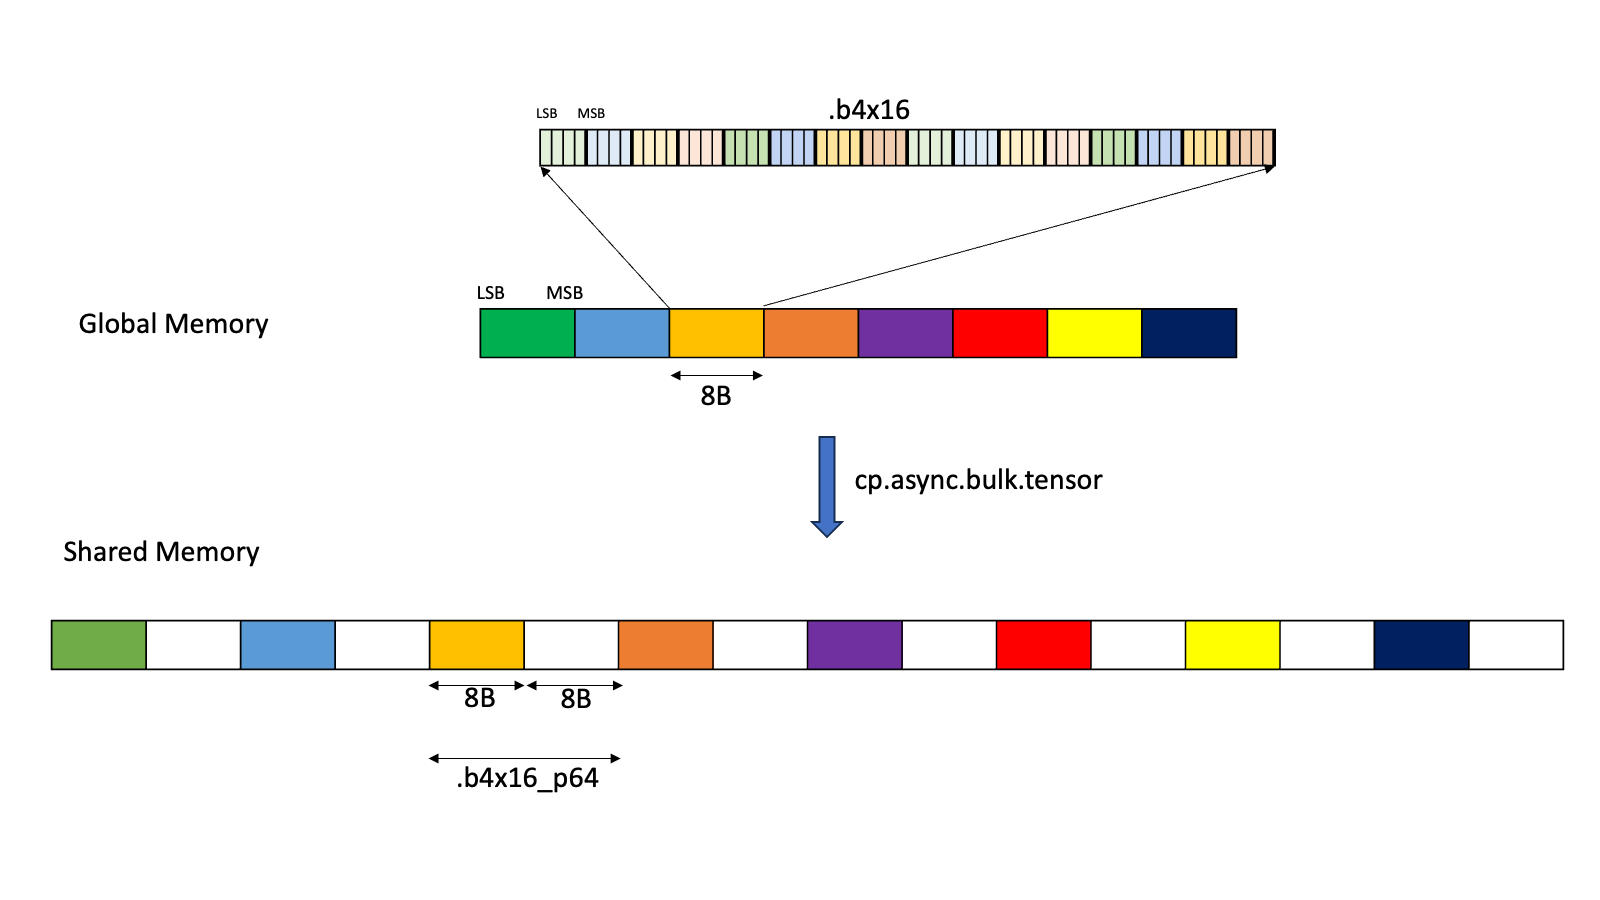
图 5 .b4x16_p64 的布局
所添加的填充区域未初始化。
-
类型
.b6x16_p32: 使用该类型时,将 16 段 6 位数据从全局内存复制到共享内存,并在其后追加 32 位填充,如 图 6所示。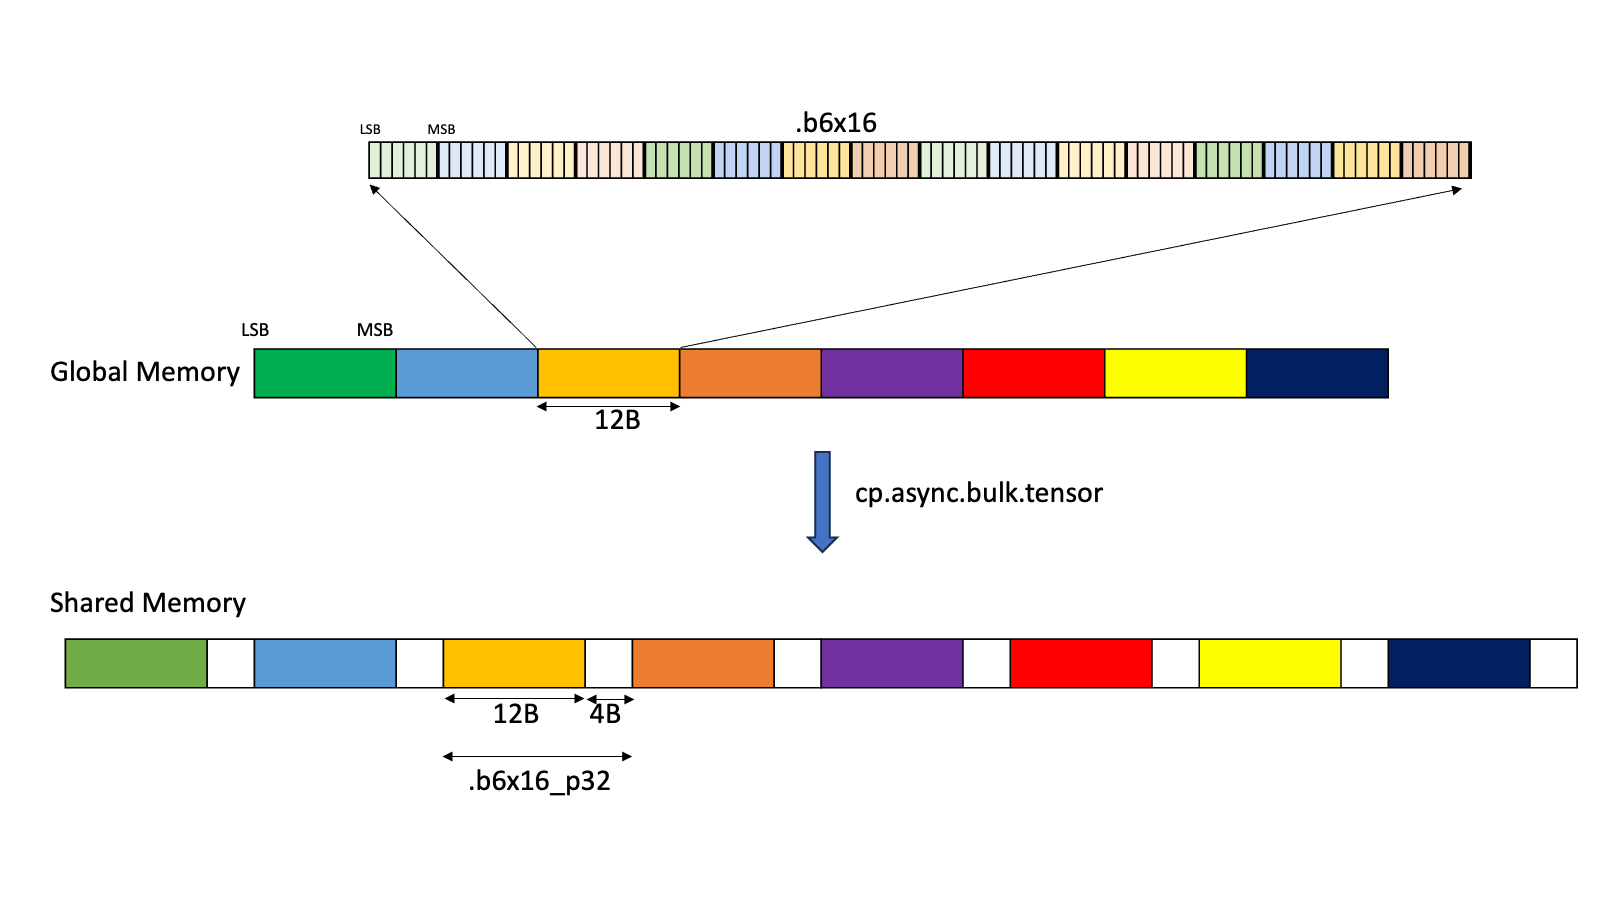
图 6 .b6x16_p32 的布局
所添加的填充区域未初始化。
-
类型
.b6p2x16: 使用该类型时,16 个元素——每个元素的最低有效位(LSB)处包含 6 位数据、最高有效位(MSB)处包含 2 位填充—— 通过丢弃这 2 位填充数据并将 6 位数据连续打包,从共享内存复制到全局内存,如 图 7所示。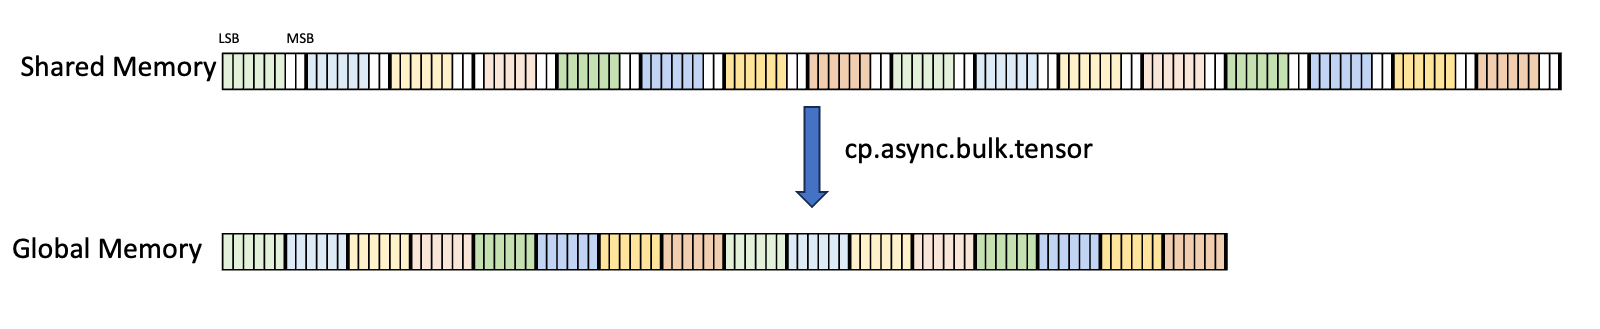
图 7 .b6p2x16 的布局
对于 .b6x16_p32 和 .b4x16_p64,所添加的填充区域未初始化。
类型 .b6x16_p32 和 .b6p2x16 在描述符中共享相同的编码值
(值为 15),因为这两种类型适用于不同类型的张量复制操作:
类型 |
有效的张量复制方向 |
|---|---|
|
|
|
|
5.5.2. 张量访问模式#
张量数据可以按两种模式进行访问:
-
Tiled 模式:
在 tiled 模式下,源多维张量布局在目标处被保留。
-
Im2col 模式:
在 im2col 模式下,源张量边界框中的元素在目标处被重排为列。更多细节请参见 此处。
5.5.3. Tiled 模式#
本节介绍张量与张量访问在 tiled 模式下如何工作。
5.5.3.1. 边界框#
张量可按称为边界框的块进行访问。边界框与其所访问的张量具有相同的维度数。 每个边界框的大小必须是 16 字节的倍数。边界框的地址也必须对齐到 16 字节。
边界框具有以下访问属性:
边界框维度大小
越界访问模式
遍历步长
在 PTX 张量指令中指定的张量坐标,用于指定边界框的起始偏移。边界框的起始偏移连同其余的边界框 信息一起,用于确定要访问的元素。
5.5.3.2. 遍历步长#
当边界框沿某个维度迭代张量时,遍历步长指定要跳过的元素的精确数量。如果无需跳过,必须指定默认值 1。
维度 0 中的遍历步长可用于交错布局。 对于非交错布局,维度 0 中的遍历步长必须始终为 1。
图 8 说明了张量、张量大小、张量步长、 边界框大小与遍历步长。
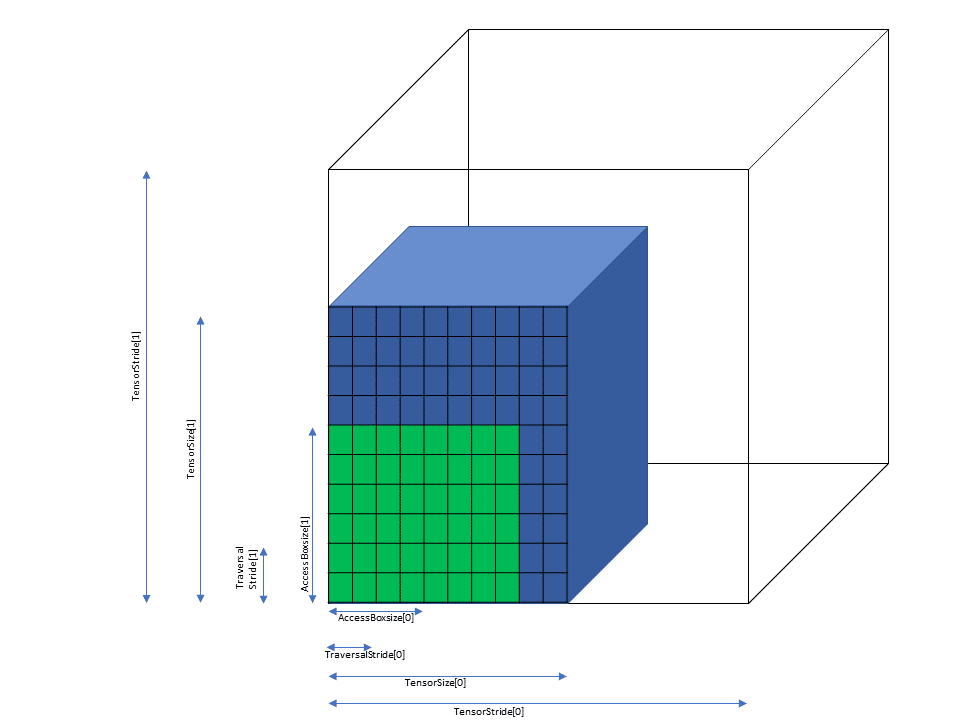
图 8 Tiled 模式边界框、张量大小与遍历步长
5.5.3.3. 越界访问#
PTX 张量操作可以检测并处理边界框在任一维度上越过张量边界的情况。共有 2 种模式:
-
零填充模式:
边界框中落在张量边界之外的元素被设为 0。
-
OOB-NaN填充模式:边界框中落在张量边界之外的元素被设为一种特殊的 NaN,称为
OOB-NaN。
图 9 展示了越界访问的一个示例。
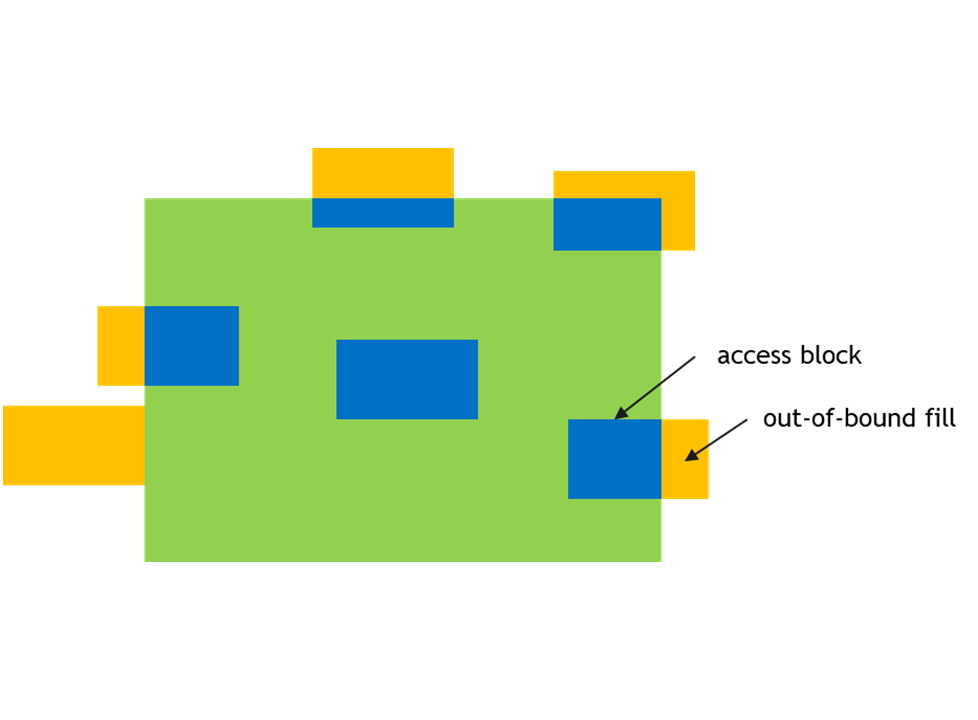
图 9 越界访问
5.5.3.4. .tile::scatter4 与 .tile::gather4 模式#
这些模式与 tiled 模式类似,但受限之处在于这些模式仅作用于 2D 张量数据。
Tile::scatter4 与 Tile::gather4 模式用于访问张量数据中多个不连续的行。
在 Tile::scatter4 模式下,单个 2D 源张量被拆分为 2D 目标张量中的四行。
在 Tile::gather4 模式下,源 2D 张量中的四行被合并为单个 2D 目标张量。
这些模式作用于四行,因此该指令将接受:
沿维度 0 的四个张量坐标
沿维度 1 的一个张量坐标
交错布局不支持 .tile::scatter4 与 .tile::gather4 模式。
tiled 模式的所有其他约束和规则同样适用于这些模式。
5.5.3.4.1. 边界框#
对于 Tile::scatter4 与 Tile::gather4 模式,四个请求坐标将在张量空间中形成四个边界框。
图 10 以起始坐标 (1, 2)、(1, 5)、(1, 0) 和 (1, 9) 展示了相应的示例。
维度 0 中边界框的大小表示行的长度。维度 1 中边界框的大小必须为一。
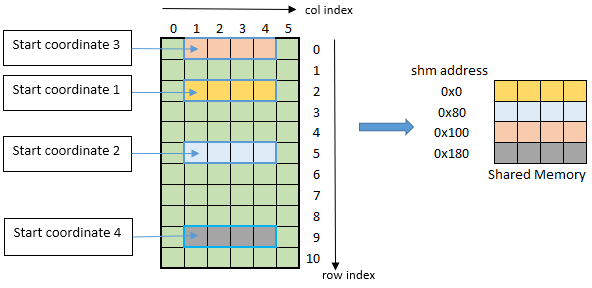
图 10 tiled::scatter4/tiled::gather4 模式边界框示例
5.5.4. im2col 模式#
Im2col 模式支持以下张量维度:3D、4D 和 5D。在该模式下,张量数据被视为一批图像,具有以下属性:
N:批次中图像的数量
D、H、W:3D 图像的大小(深度、高度与宽度)
C:每个图像元素的通道数
上述属性与 3D、4D、5D 张量的对应关系如下:
维度 |
N/D/H/W/C 适用性 |
|---|---|
3D |
NWC |
4D |
NHWC |
5D |
NDHWC |
5.5.4.1. 边界框#
在 im2col 模式下,边界框在 DHW 空间中定义。沿其他维度的边界由Pixels-per-Column与Channels-per-Pixel参数指定,如下文所述。
边界框的维度数比张量的维度数少二。
以下属性描述了如何在 im2col 模式下访问元素:
Bounding-Box Lower-Corner
Bounding-Box Upper-Corner
Pixels-per-Column
Channels-per-Pixel
Bounding-Box Lower-Corner与Bounding-Box Upper-Corner指定边界框在 DHW 空间中的两个对角。Bounding-Box Lower-Corner指定坐标最小的 角,Bounding-Box Upper-Corner指定坐标最大的角。
Bounding-Box Upper-Corner与Lower-Corner是 16 位有符号值,其取值范围随维度不同而不同,如下所示:
3D |
4D |
5D |
|
|---|---|---|---|
上角 / 下角大小 |
[-215, 215-1] |
[-27, 27-1] |
[-24, 24-1] |
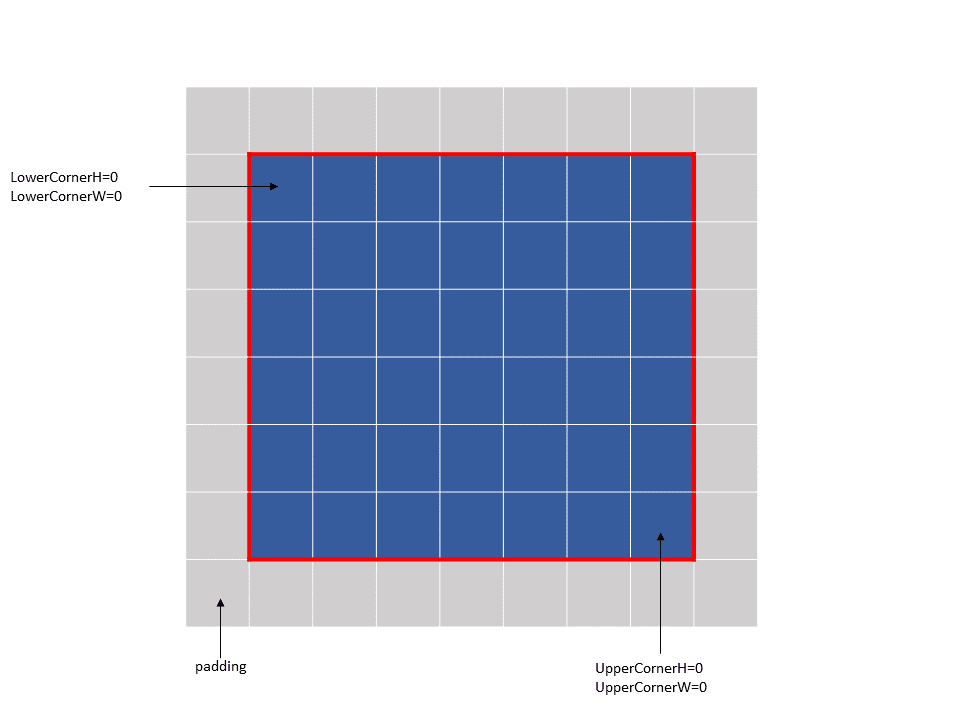
图 11 im2col 模式边界框示例 1
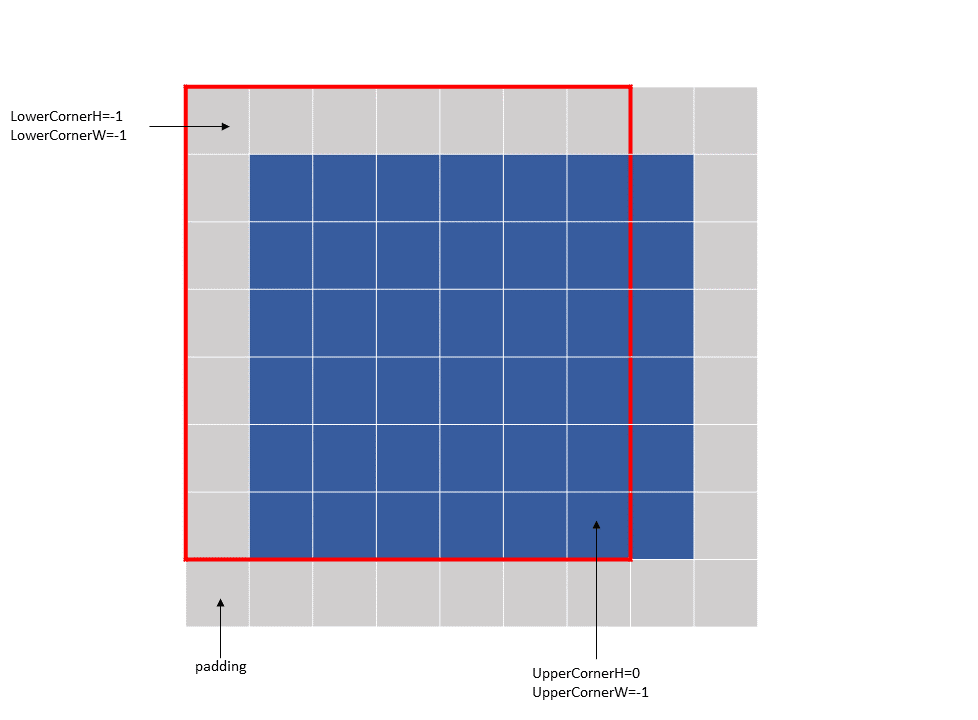
图 12 im2col 模式边界框示例 2
Bounding-Box Upper-Corner与Lower-Corner仅指定边界,而不指定要访问的元素数量。Pixels-per-Column指定要在 NDHW 空间中访问的元素数量。
Channels-per-Pixel指定沿 C 维度要访问的元素数量。
在 PTX 张量指令中指定的张量坐标,在不同维度上的行为不同:
沿 N 和 C 维度:指定沿该维度的起始偏移,类似于 tiled 模式。
沿 DHW 维度:指定张量空间中卷积滤波器基点的位置。滤波器角位置必须位于边界框内。
在 im2col 模式下的 PTX 张量指令中指定的 im2col 偏移会加到滤波器基点坐标上, 以确定张量空间中开始访问元素的起始位置。
im2col 偏移的大小随维度不同而不同,其有效取值范围如下所示:
3D |
4D |
5D |
|
|---|---|---|---|
im2col 偏移范围 |
[0, 216-1] |
[0, 28-1] |
[0, 25-1] |
以下是 im2col 模式访问的一些示例:
-
示例 1(图 13):
Tensor Size[0] = 64
Tensor Size[1] = 9
Tensor Size[2] = 14
Tensor Size[3] = 64
Pixels-per-Column = 64
channels-per-pixel = 8
Bounding-Box Lower-Corner W = -1
Bounding-Box Lower-Corner H = -1
Bounding-Box Upper-Corner W = -1
Bounding-Box Upper-Corner H = -1.
tensor coordinates = (7, 7, 4, 0)
im2col offsets : (0, 0)
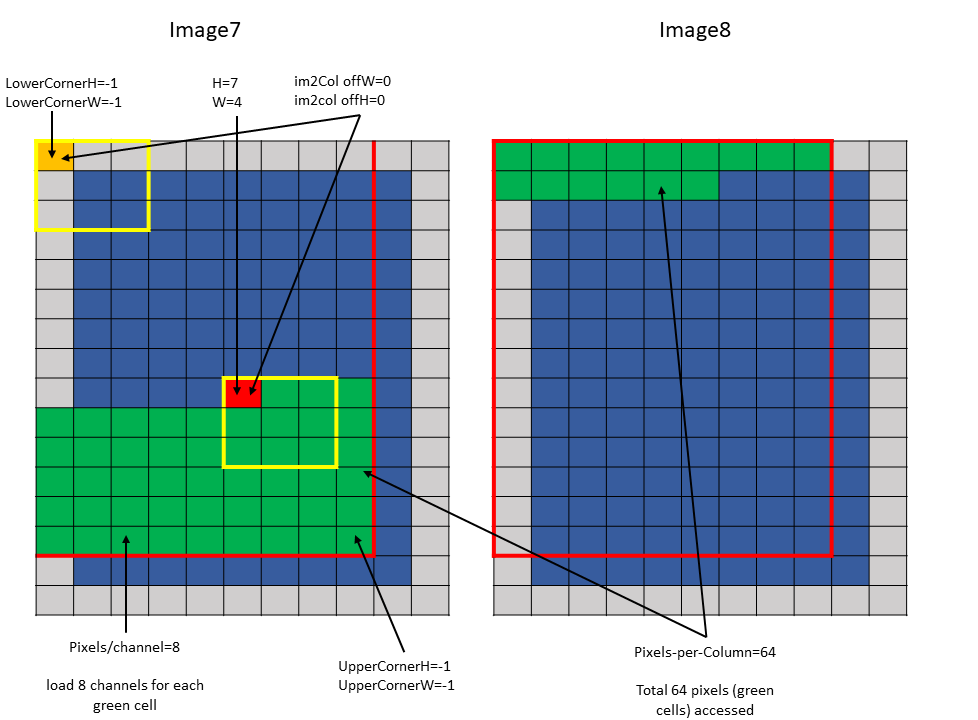
图 13 im2col 模式示例 1
-
示例 2(图 14):
Tensor Size[0] = 64
Tensor Size[1] = 9
Tensor Size[2] = 14
Tensor Size[3] = 64
Pixels-per-Column = 64
channels-per-pixel = 8
Bounding-Box Lower-Corner W = 0
Bounding-Box Lower-Corner H = 0
Bounding-Box Upper-Corner W = -2
Bounding-Box Upper-Corner H = -2
tensor coordinates = (7, 7, 4, 0)
im2col offsets: (2, 2)
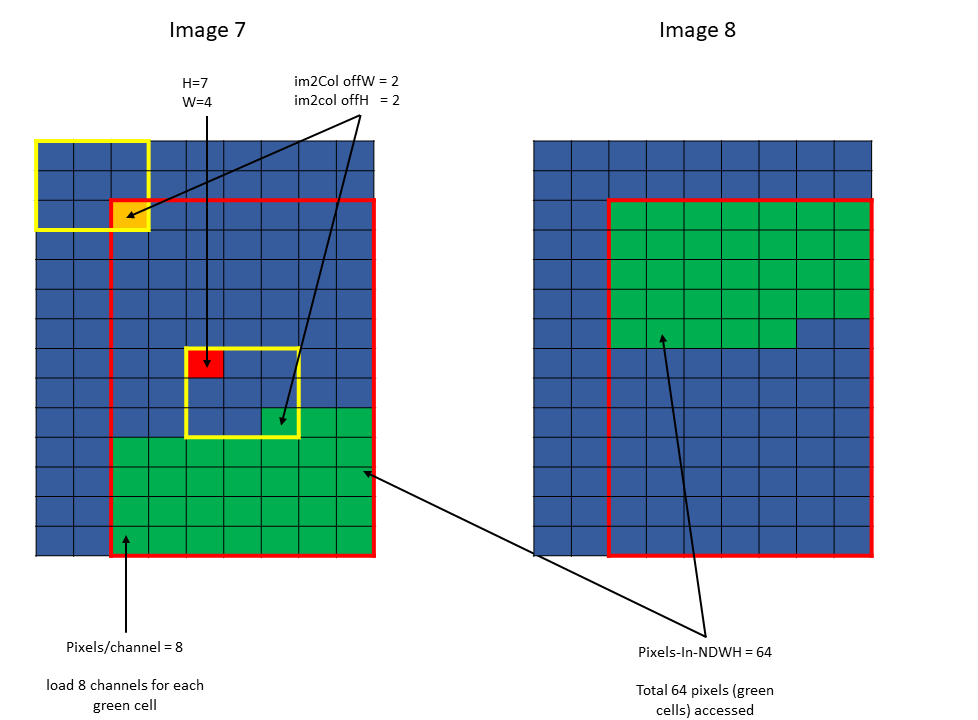
图 14 im2col 模式示例 2
5.5.4.2. 遍历步长#
在 im2col 模式下,遍历步长不会影响被访问的元素(或像素)总数,这与 tiled 模式不同。 在 im2col 模式下,被访问的元素总数由Pixels-per-Column决定。
沿 D、H 和 W 维度被遍历的元素数量,按该维度的遍历步长进行跨步。
以下示例结合图 15说明了带遍历步长的访问:
Tensor Size[0] = 64
Tensor Size[1] = 8
Tensor Size[2] = 14
Tensor Size[3] = 64
Traversal Stride = 2
Pixels-per-Column = 32
channels-per-pixel = 16
Bounding-Box Lower-Corner W = -1
Bounding-Box Lower-Corner H = -1
Bounding-Box Upper-Corner W = -1
Bounding-Box Upper-Corner H = -1.
Tensor coordinates in the instruction = (7, 7, 5, 0)
Im2col offsets in the instruction : (1, 1)
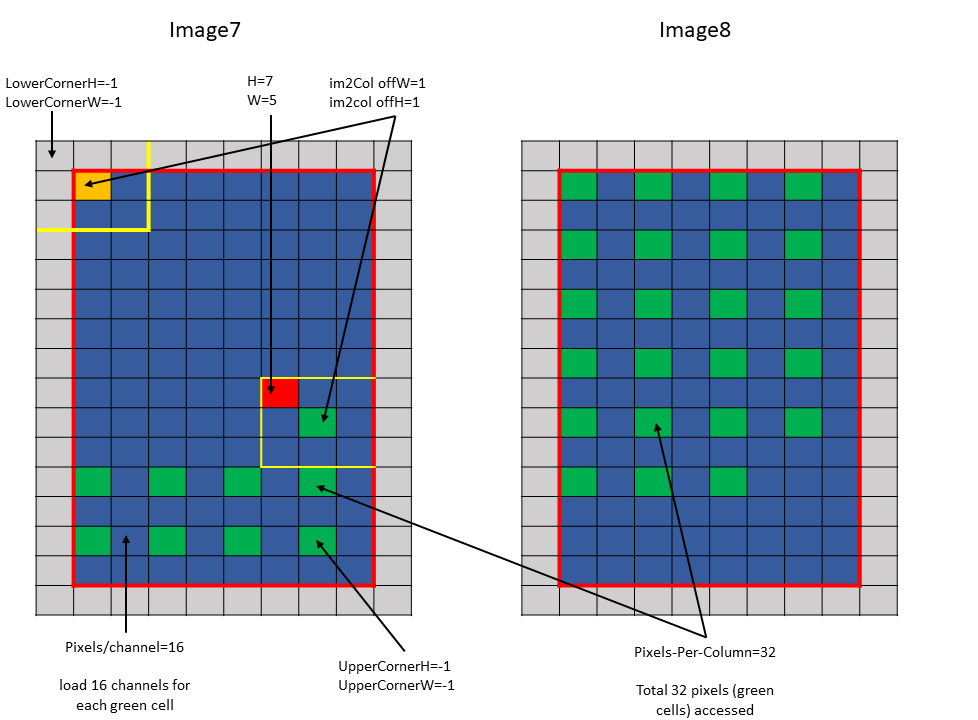
图 15 im2col 模式遍历步长示例
5.5.4.3. 越界访问#
在 im2col 模式下,当由Pixels-per-Column指定的 NDHW 空间中请求的像素数量超过图像批次中可用的像素数量时,则执行越界访问。
与 tiled 模式类似,可以根据所指定的填充模式执行零填充或 OOB-NaN 填充。
5.5.5. im2col::w、im2col_no_offs::w 与 im2col::w::128 模式#
这些模式与 im2col 模式类似,只是限制为仅跨 W 维度访问元素,
同时保持 H 与 D 维度不变。
im2col 模式的所有约束和规则同样适用于这些模式。 注意,对于这些模式,必须使用合法的 重排模式。 换言之,重排模式不得设置为 (i)无重排,以及(ii)带 8 字节翻转的 32 字节原子性的 128 字节重排模式。
在 im2col::w::128 模式中访问的元素数量是固定的,等于 128。
在 im2col::w 与 im2col_no_offs::w 模式中访问的元素数量取决于
TensorMap 中的 Pixels-per-Column 字段。
5.5.5.1. 边界框#
在这些模式中,D 与 H 维度的边界框大小为 1。
PTX 指令中张量坐标参数里的 D 与 H 维度指定边界框在张量空间中的位置。
Bounding-Box Lower-Corner-W 与 Bounding-Box Upper-Corner-W 指定边界框在
W 维度上的两个对角。
PTX 指令中张量坐标参数里的 W 维度指定边界框中将要被访问的第一个元素的位置。
在 im2col::w 模式中加载的像素数量,以及在 im2col_no_offs::w 模式中存储或以其他方式
归约的像素数量,由 TensorMap 中的 Pixels-per-Column 指定。
在 im2col::w::128 模式中加载的像素数量始终为 128。因此,在 im2col::w::128 模式中
忽略 Pixels-per-Column。
图 16 展示了 im2col::w 与
im2col::w:128 模式的一个示例。
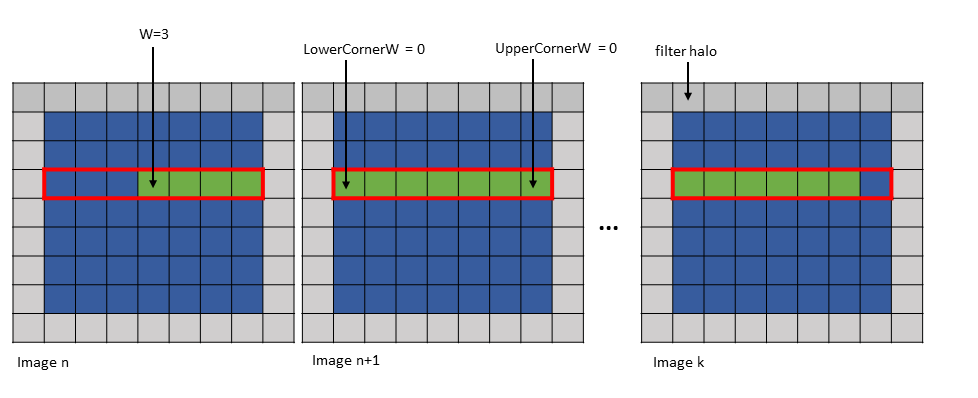
图 16 im2col::w 与 im2col::w::128 模式示例
第一个元素只能位于边界框之外,且仅在 W 维度上、只在边界框的左侧。图 17 展示了这一点的一个示例。
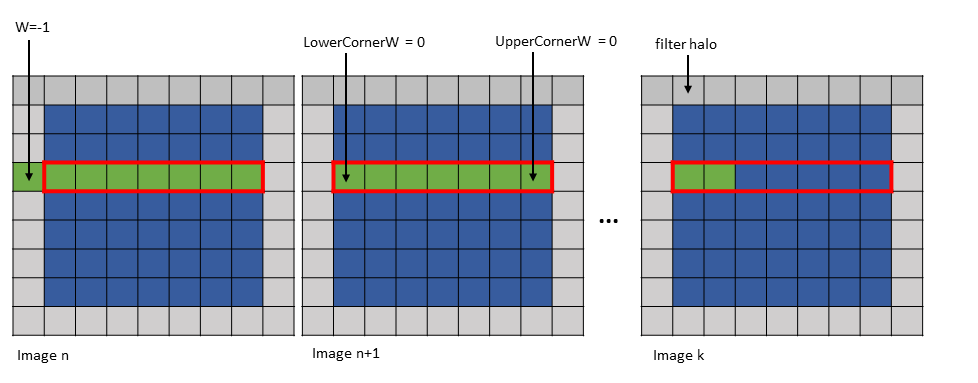
图 17 im2col::w 与 im2col::w::128 模式第一个元素位于边界框之外示例
对于 im2col_no_offs::w mode,由于张量数据正在被存储或以其他方式归约到全局内存,
边界框必须始终保持在张量边界限制之内。换言之,
Lower-Corner-W 的数值必须为非负,而 Upper-Corner-W 的数值必须为非正。在此模式下,
也可以自然而然地得出,张量坐标的负值会导致非法的越界访问,并且在这些情况下会引发运行时错误。
另外,请注意,一旦检测到越界访问,即使所操作的像素总数小于
TensorMap 中指定的 Pixels-per-Column 值,后续的像素操作也不会被执行。
图 18 展示了 im2col_no_offs::w 模式的一个示例。
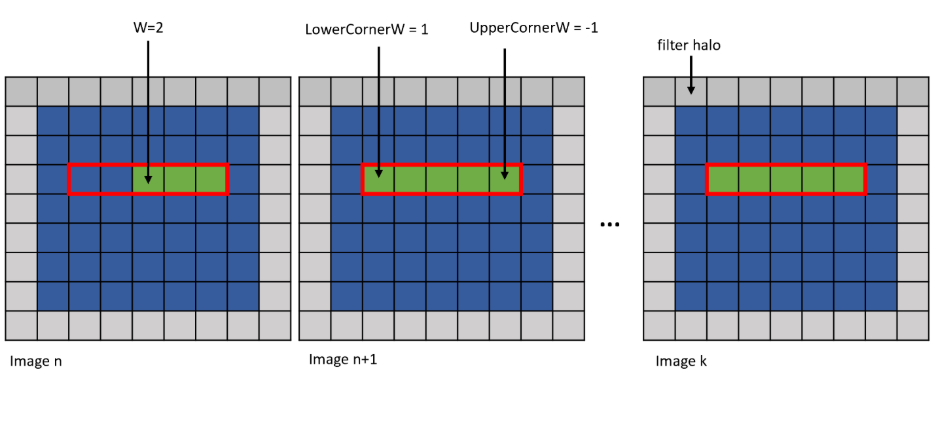
图 18 im2col_no_offs::w 模式示例
5.5.5.2. 遍历步长#
这与 im2col 模式类似,不同之处在于:仅沿 W 维度遍历的元素数量按 TensorMap 中指定的遍历步长进行步进。
5.5.5.3. wHalo#
在 im2col::w 模式中,PTX 指令中的 wHalo 参数指定在图像末尾必须加载多少个滤波器
halo 元素。
在 im2col::w::128 模式中,沿 W 维度在边界框内每 32 个元素之后加载 halo 元素。PTX 指令中的 wHalo 参数指定每 32 个元素之后必须加载多少个
halo 元素。
请注意,对于 im2col_no_offs::w 模式,显式指定 wHalo 值是非法的,
它始终默认为 0。
以下是 .im2col::w 模式访问的一个示例:
Tensor Size [0] = 128
Tensor Size [1] = 9
Tensor Size [2] = 7
Tensor Size [3] = 64
Pixels-per-column = 128
Channels-per-pixel = 64
Bounding Box Lower Corner W = 0
Bounding Box Upper Corner W = 0
Tensor Coordinates in the instruction = (7, 2, 3, 0)
wHalo in the instruction = 2 (as 3x3 convolution filter is used)
使用上述参数的张量拷贝操作会加载 128 个像素和两个 halo 像素,如 图 19 所示。
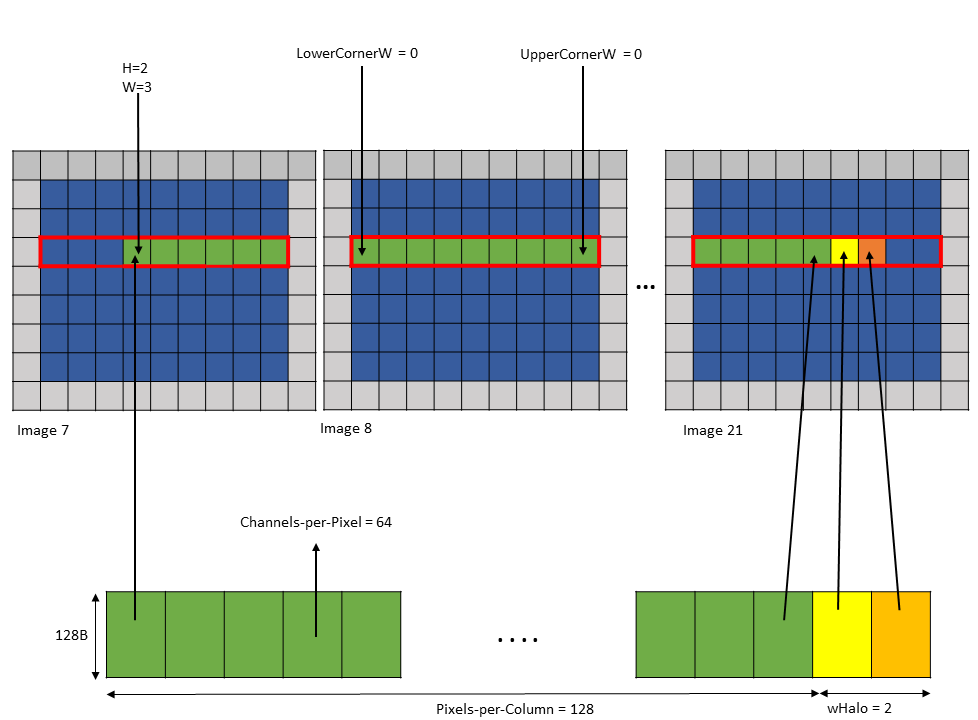
图 19 使用 im2col::w 模式的张量拷贝操作示例
halo 像素始终加载在共享内存中紧邻主行像素的位置,如 图 19 所示。
以下是 .im2col::w::128 模式访问的一个示例:
Tensor Size [0] = 128
Tensor Size [1] = 9
Tensor Size [2] = 7
Tensor Size [3] = 64
Channels-per-pixel = 64
Bounding Box Lower Corner W = 0
Bounding Box Upper Corner W = 0
Tensor Coordinates in the instruction = (7, 2, 3, 0)
wHalo in the instruction = 2 (as 3x3 convolution filter is used)
使用上述参数的张量拷贝操作会加载 128 个元素,使得每 32 个元素之后加载 wHalo 数量的元素,如 图 20 所示。
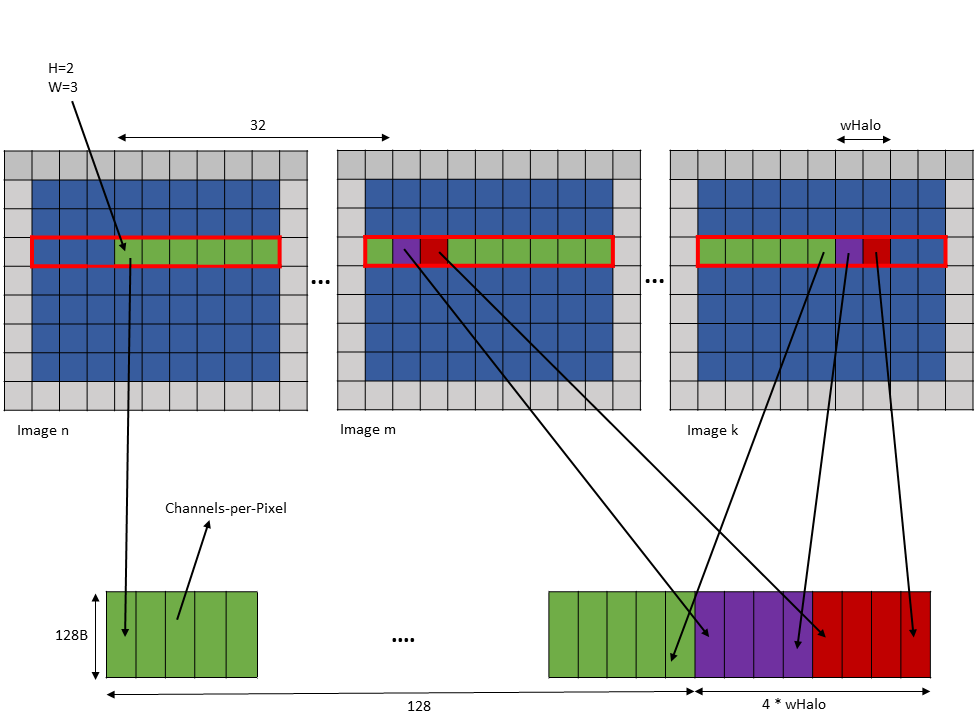
图 20 使用 im2col::w::128 模式的张量拷贝操作示例
5.5.5.4. wOffset#
在卷积计算中,沿 W 维度的相同元素会在卷积滤波器覆盖范围内的不同位置被重复使用。根据像素被使用的次数,像素可能被加载到不同的共享内存缓冲区中。每个缓冲区都可以由一个独立的
张量拷贝操作加载。
张量拷贝与预取指令中的 wOffset 参数会为每个缓冲区调整源像素位置。缓冲区的精确位置使用以下公式沿 W 维度进行调整:
Bounding Box Lower Corner W += wOffset
Bounding Box Upper Corner W += wOffset
W += wOffset
请注意,对于 im2col_no_offs::w 模式,显式指定 wOffset 值是非法的,
它始终默认为 0。
以下是使用各种 wHalo 和 wOffset 值进行张量拷贝到多个缓冲区的示例:
示例 1:
Tensor Size [0] = 128
Tensor Size [1] = 9
Tensor Size [2] = 67
Tensor Size [3] = 64
Pixels-per-Column = 128
Channels-per-pixel = 64
Bounding Box Lower Corner W = -1
Bounding Box Upper Corner W = 0
Traversal Stride = 2
Tensor Coordinates in the instruction = (7, 2, -1, 0)
Shared memory buffer 1:
wHalo = 1
wOffset = 0
Shared memory buffer 2:
wHalo = 0
wOffset = 1
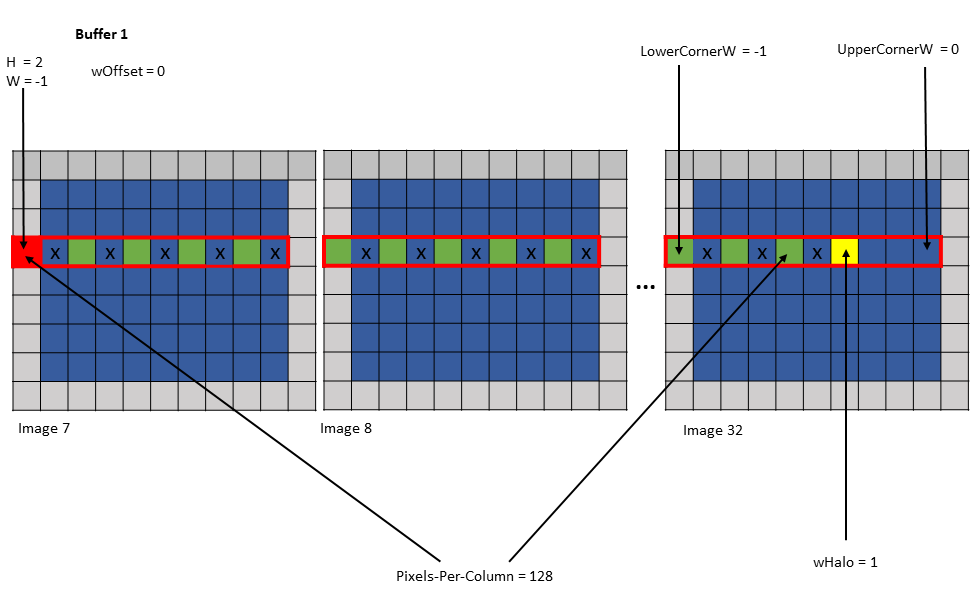
图 21 示例 1 中到缓冲区 1 的张量拷贝操作
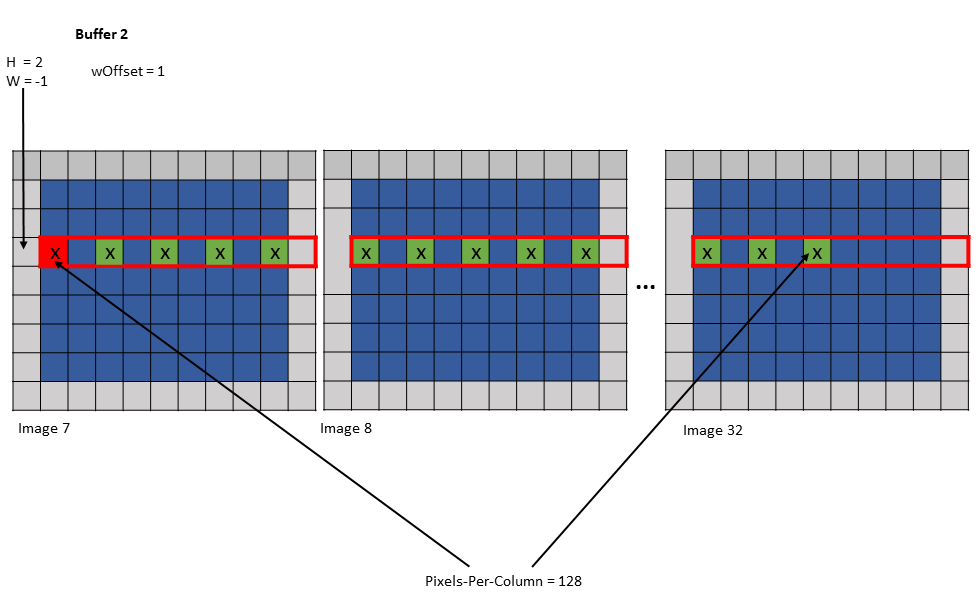
图 22 示例 1 中到缓冲区 2 的张量拷贝操作
示例 2:
Tensor Size [0] = 128
Tensor Size [1] = 7
Tensor Size [2] = 7
Tensor Size [3] = 64
Pixels-per-Column = 128
Channels-per-pixel = 64
Bounding Box Lower Corner W = -1
Bounding Box Upper Corner W = -1
Traversal Stride = 3
Tensor Coordinates in the instruction = (7, 2, -1, 0)
Shared memory buffer 1:
wHalo = 0
wOffset = 0
Shared memory buffer 2:
wHalo = 0
wOffset = 1
Shared memory buffer 3:
wHalo = 0
wOffset = 2
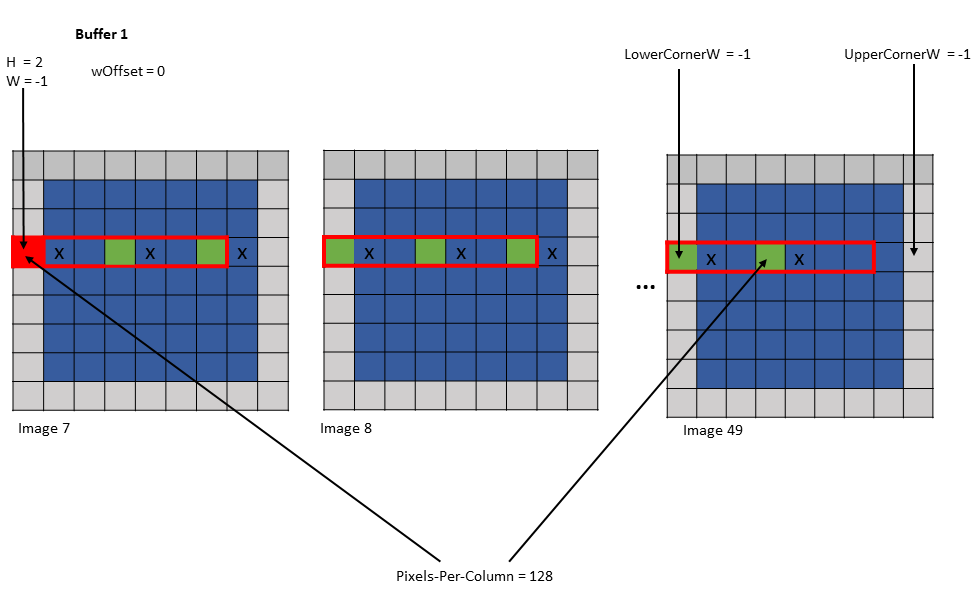
图 23 示例 2 中到缓冲区 1 的张量拷贝操作
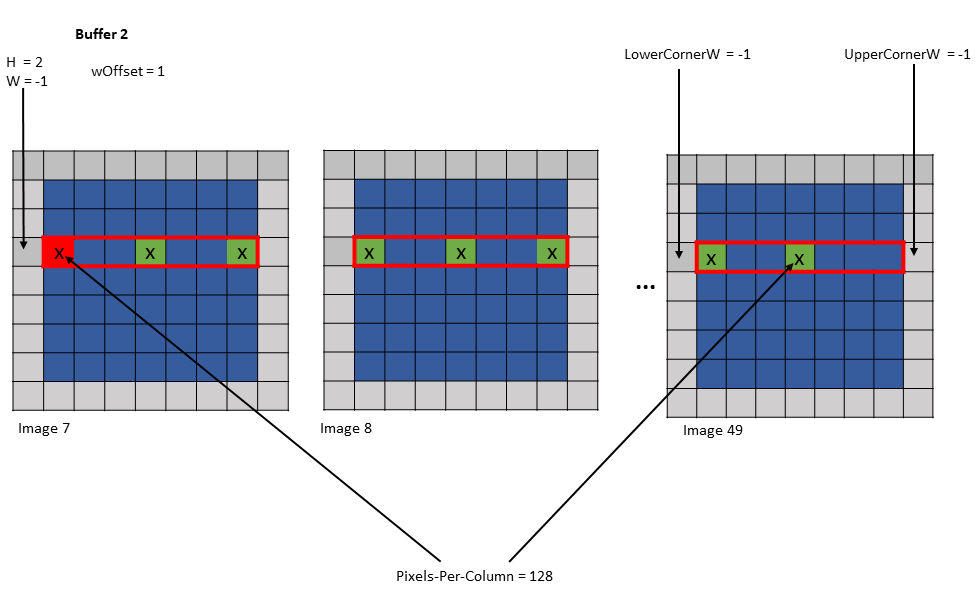
图 24 示例 2 中到缓冲区 2 的张量拷贝操作
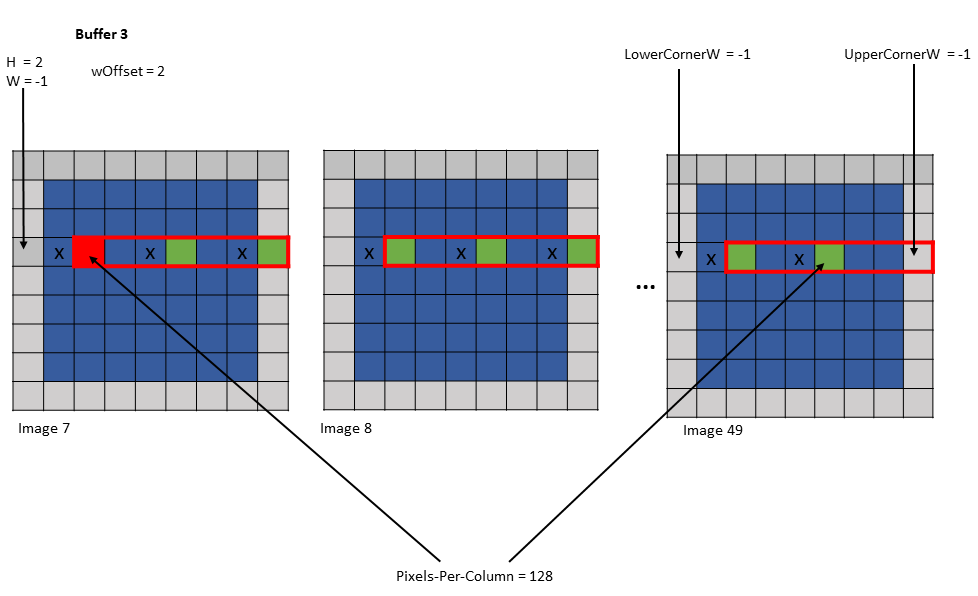
图 25 示例 2 中到缓冲区 3 的张量拷贝操作
5.5.6. 交错布局#
张量可以进行交错,支持以下交错布局:
无交错(NDHWC)
8 字节交错(NC/8DHWC8):假定每通道 2B,C8 在内存中占用 16 字节。
16 字节交错(NC/16HWC16):假定每通道 4B,C16 在内存中占用 32 字节。
C 信息按切片组织,其中连续的 C 元素以 16 字节或 32 字节的量进行分组。
如果通道总数不是每切片通道数的整数倍,则最后一个切片必须用零填充,以构成完整的 16B 或 32B 切片。
交错布局仅支持以下维度:3D、4D 和 5D。
.im2col::w 和 .im2col::w::128 模式不支持交错布局。
5.5.7. 重排模式#
出于访问性能的考虑,共享内存中数据的布局可以与全局内存中的布局不同。下面描述各种重排模式:
-
无重排模式:
此模式下不进行任何重排,目标数据布局与源数据布局完全相同。
0
1
2
3
4
5
6
7
0
1
2
3
4
5
6
7
… 模式重复 …
-
32 字节重排模式:
下表(每个元素即带编号的单元格为 16 字节,起始地址按 256 字节对齐)展示了目标数据布局的模式:
0
1
2
3
4
5
6
7
1
0
3
2
5
4
7
6
… 模式重复 …
下图所示为 32 字节重排模式的一个示例:维度为 1x2x10x10xC16 的 NC/(32B)HWC(32B) 张量,最内层 维度存放 16 个通道的切片、每通道 2 字节,见图 26。
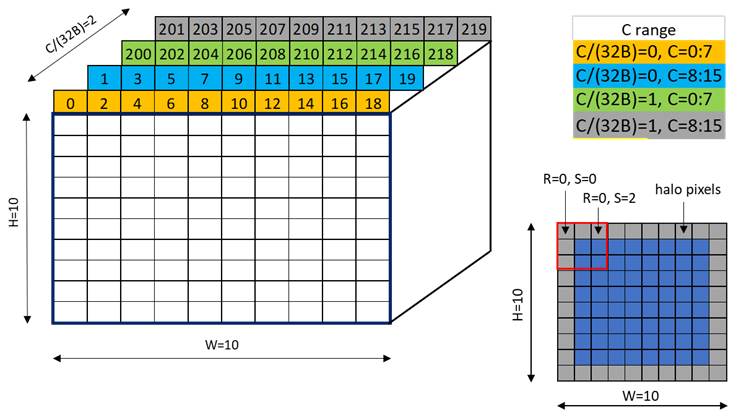
图 26 32 字节重排模式示例
图 27 展示了该张量的两个 fragment:一个对应 C/(32B) = 0,另一个对应 C/(32B) = 1。
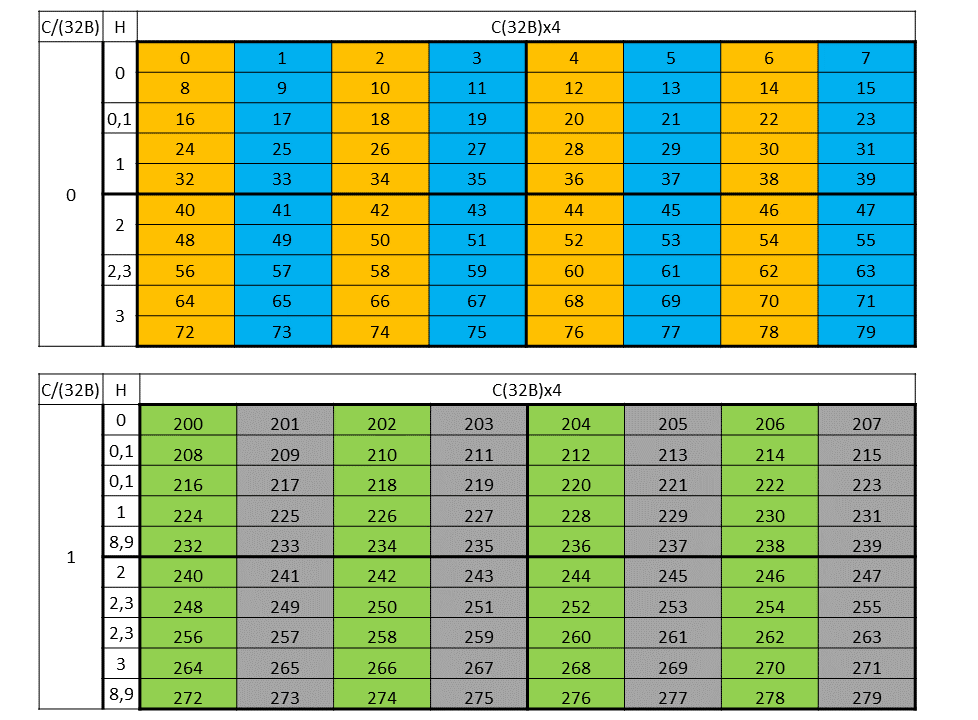
图 27 32 字节重排模式 fragment
图 28 展示了带 32 字节重排的目标数据布局。
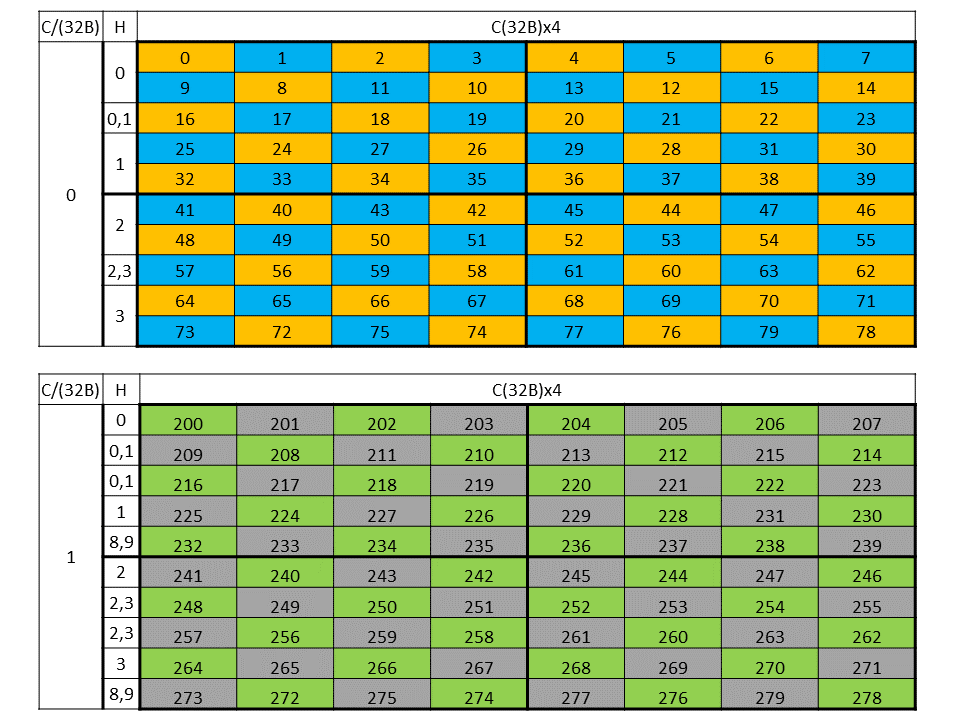
图 28 32 字节重排模式目标数据布局
-
64 字节重排模式:
下表(每个元素即带编号的单元格为 16 字节,起始地址按 512 字节对齐)展示了目标数据布局的模式:
0
1
2
3
4
5
6
7
1
0
3
2
5
4
7
6
2
3
0
1
6
7
4
5
3
2
1
0
7
6
5
4
… 模式重复 …
下图所示为 64 字节重排模式的一个示例:维度为 1x10x10x64 的 NHWC 张量,每通道 2 字节、共 32 个通 道,见图 29。
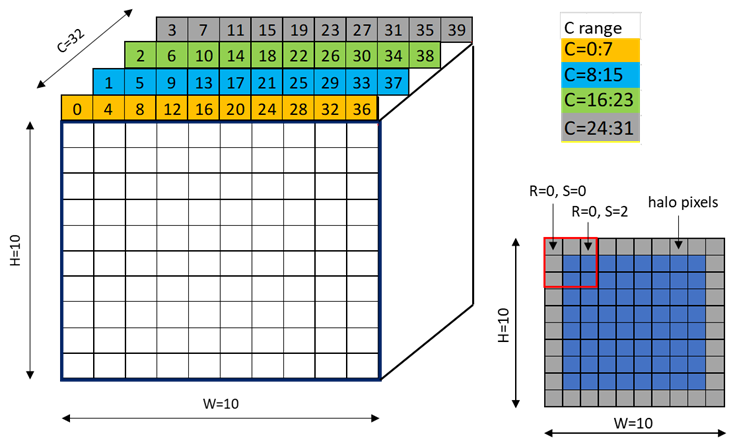
图 29 64 字节重排模式示例
每个带颜色的单元格表示 8 个通道。图 30 展示了源数据布局。
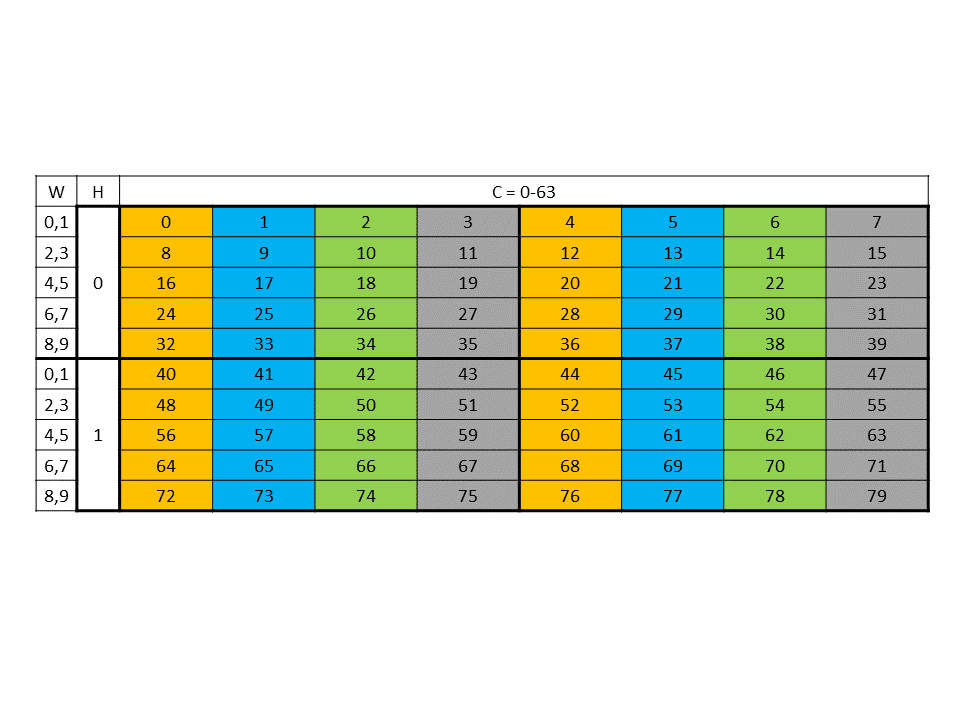
图 30 64 字节重排模式源数据布局
图 31 展示了带 64 字节重排的目标数据布局。
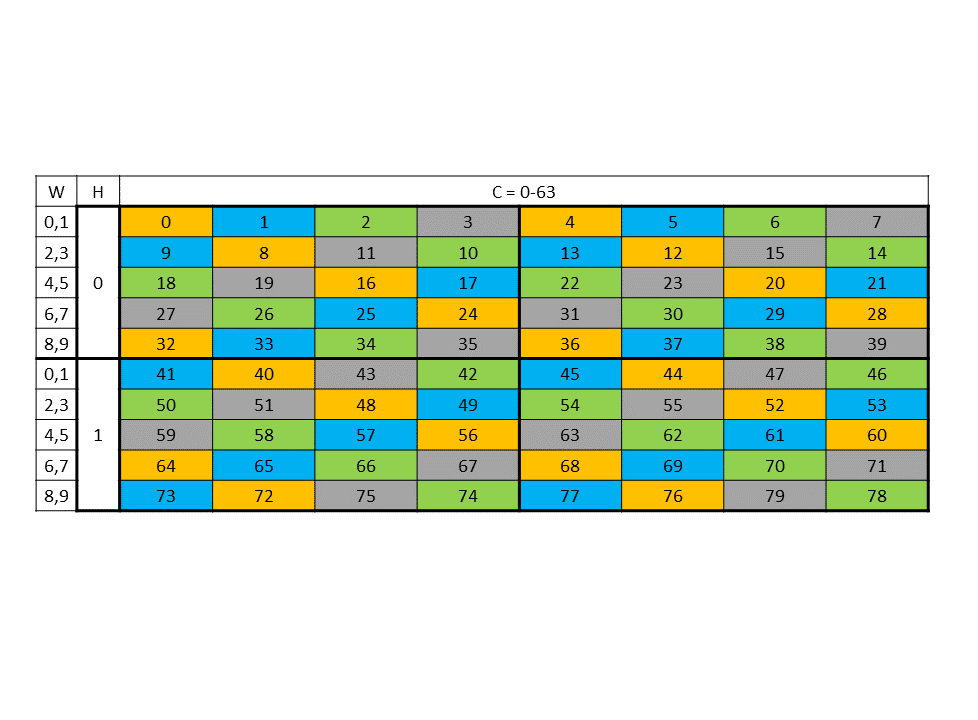
图 31 64 字节重排模式目标数据布局
-
96 字节重排模式:
下表(每个元素即带编号的单元格为 16 字节)展示了目标数据布局中的重排模式:
0
1
2
3
4
5
6
7
1
0
3
2
5
4
7
6
… 模式重复 …
下图所示为全局内存中的数据布局及其在共享内存中重排后的数据布局的示例:每个元素即带颜色的单元格为 16 字节,起始地址按 256 字节对齐,见图 32。
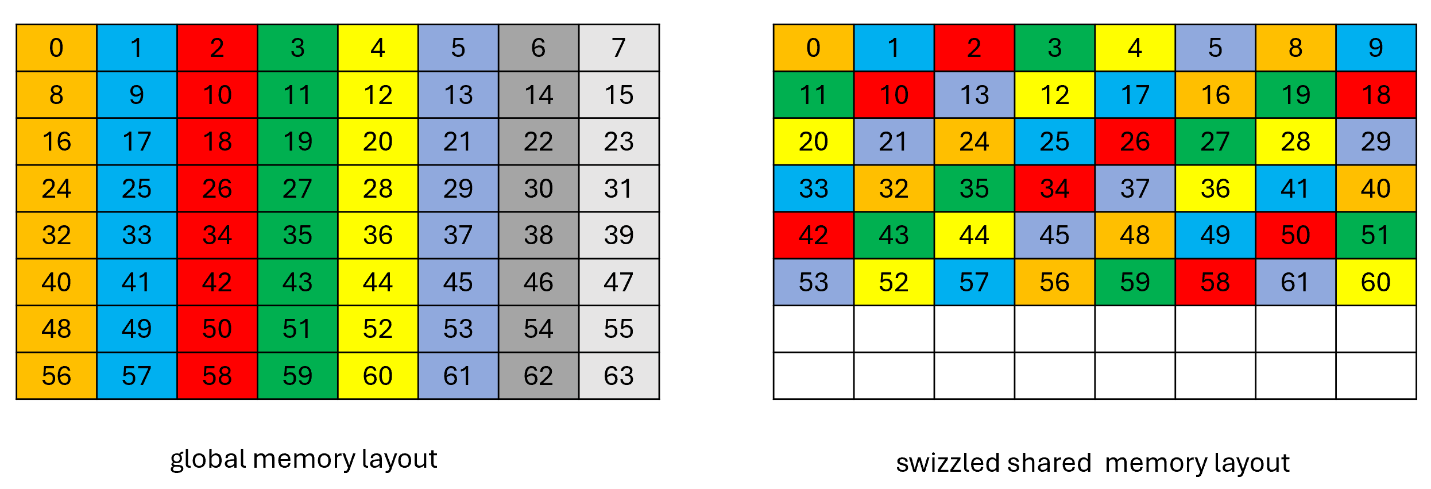
图 32 96 字节重排模式示例
-
128 字节重排模式:
128 字节重排模式支持以下子模式:
-
16 字节原子性子模式:
在此子模式下,重排时保持 16 字节的数据完整。
下表(每个元素即带编号的单元格为 16 字节,起始地址按 1024 字节对齐)展示了目标数据布局的模式:
0
1
2
3
4
5
6
7
1
0
3
2
5
4
7
6
2
3
0
1
6
7
4
5
3
2
1
0
7
6
5
4
4
5
6
7
0
1
2
3
5
4
7
6
1
0
3
2
6
7
4
5
2
3
0
1
7
6
5
4
3
2
1
0
… 模式重复 …
下图所示为 128 字节重排模式的一个示例:维度为 1x10x10x64 的 NHWC 张量,每通道 2 字节、共 64 个通 道,见图 33。
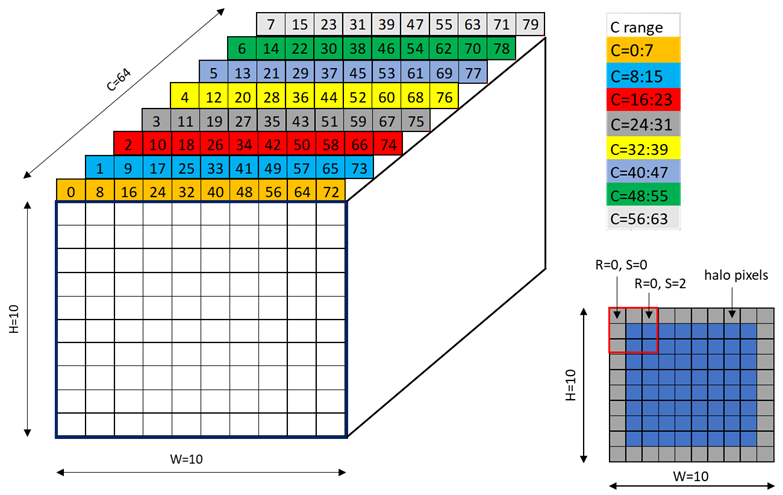
图 33 128 字节重排模式示例
每个带颜色的单元格表示 8 个通道。图 34 展示了源数据布局。
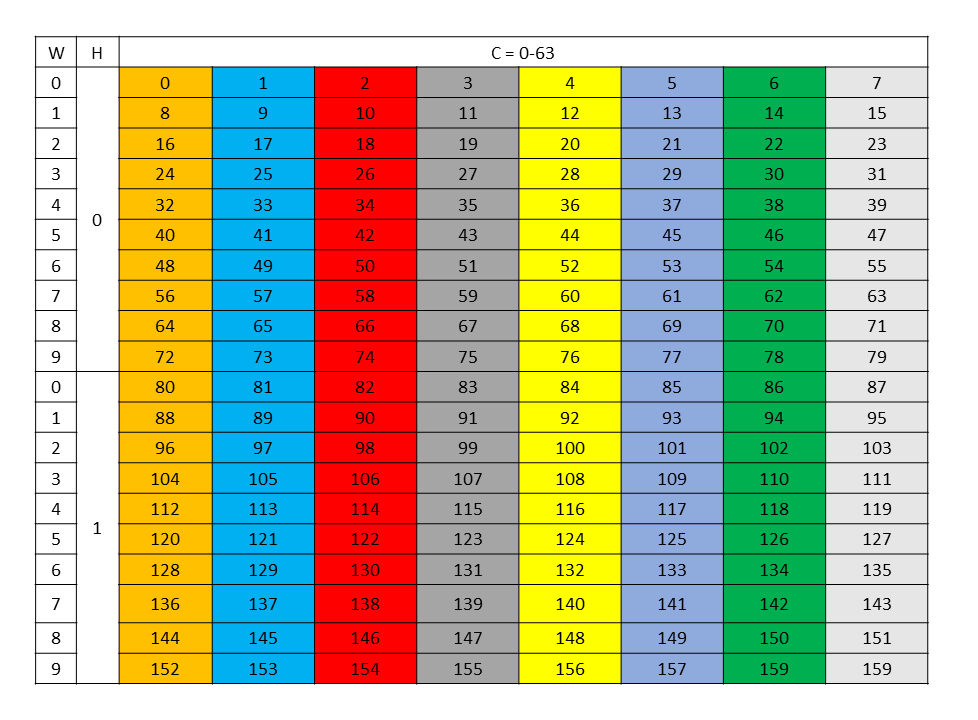
图 34 128 字节重排模式源数据布局
图 35 展示了带 128 字节重排的目标数据布局。
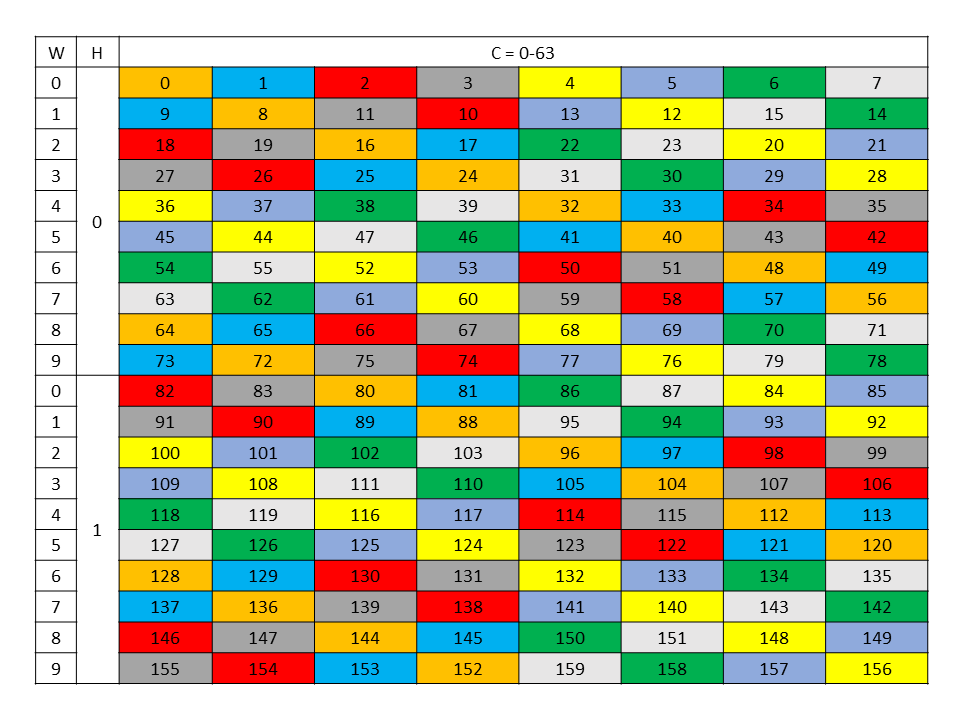
图 35 128 字节重排模式目标数据布局
-
32 字节原子性子模式:
在此子模式下,重排时保持 32 字节的数据完整。
下表(每个元素即带编号的单元格为 16 字节)展示了目标数据布局中的重排模式:
0 1
2 3
4 5
6 7
2 3
0 1
6 7
4 5
4 5
6 7
0 1
2 3
6 7
4 5
2 3
0 1
… 模式重复 …
此子模式要求共享内存按 32 字节对齐。
下图所示为全局内存中的数据布局及其在共享内存中重排后的数据布局的示例:每个元素即带颜色的单元格为 16 字 节,见图 36
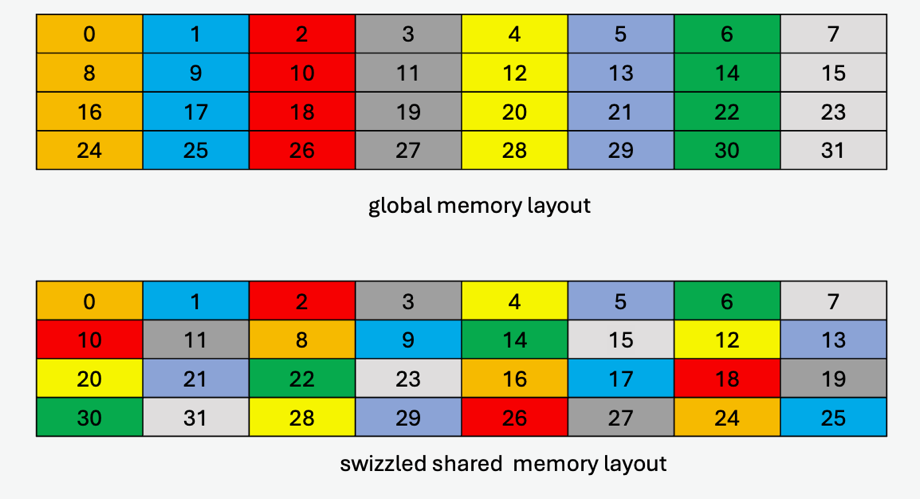
图 36 带 32 字节原子性的 128 字节重排模式示例
-
带 8 字节翻转的 32 字节原子性子模式:
此子模式的重排模式与 32 字节原子性子模式类似,不同之处在于每隔一条共享内存行,会在 16 字节数据内部对 相邻的 8 字节进行翻转。请注意,仅当
cp.async.bulk.tensor将复制方向指定为.shared::cluster.global或.shared::cta.global时,此模式才合法。下图所示为全局内存中的数据布局及其在共享内存中重排后的数据布局的示例:每个元素即带颜色的单元格为 16 字 节(为展示翻转,每个 16 字节带颜色的单元格都给出了两个 8 字节的子元素),见图 37
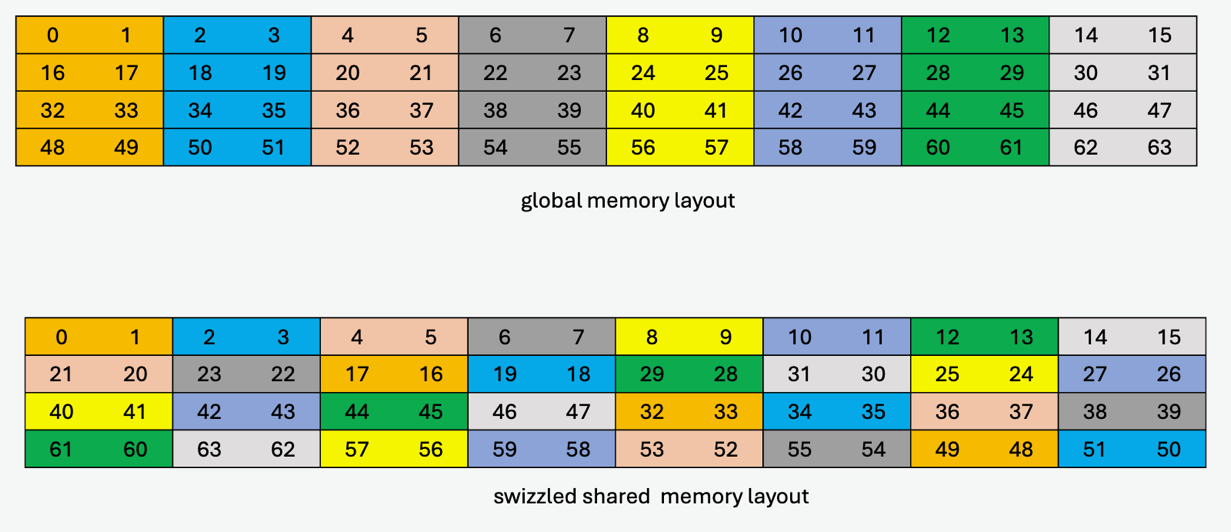
图 37 带 8 字节翻转的 32 字节原子性 128 字节重排模式示例
-
64 字节原子性子模式:
在此子模式下,重排时保持 64 字节的数据完整。
下表(每个元素即带编号的单元格为 16 字节)展示了目标数据布局中的重排模式:
0 1 2 3
4 5 6 7
4 5 6 7
0 1 2 3
… 模式重复 …
此子模式要求共享内存按 64 字节对齐。
下图所示为全局内存中的数据布局及其在共享内存中重排后的数据布局的示例:每个元素即带颜色的单元格为 16 字节,见图 38
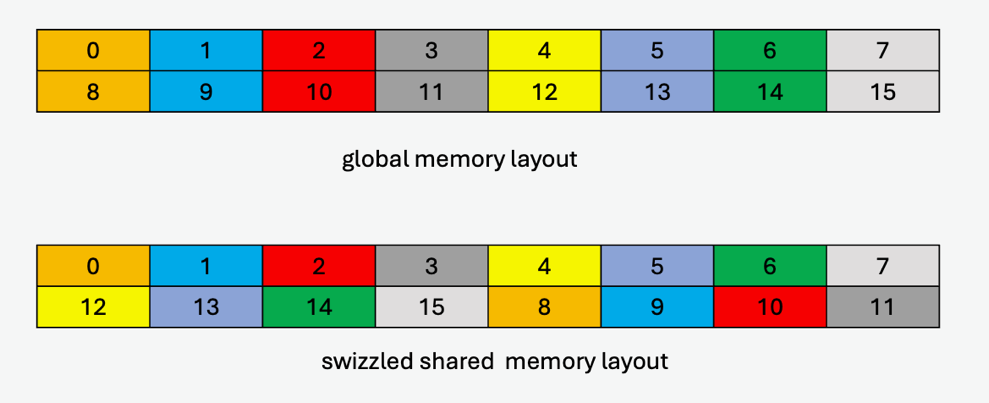
图 38 带 64 字节原子性的 128 字节重排模式示例
-
表 14 列出了重排原子性与重排模式的有效组合。
重排模式 |
重排原子性 |
|---|---|
无重排 |
– |
32B 重排模式 |
16B |
64B 重排模式 |
16B |
96B 重排模式 |
16B |
128B 重排模式 |
|
当 dstMem 共享内存地址位于以下边界时,重排基址偏移的值为 0:
重排模式 |
重复模式的起始地址 |
|---|---|
128 字节重排 |
1024 字节边界 |
96 字节重排 |
256 字节边界 |
64 字节重排 |
512 字节边界 |
32 字节重排 |
256 字节边界 |
否则,重排基址偏移为非零值,使用以下公式计算:
重排模式 |
公式 |
|---|---|
128 字节重排 |
基址偏移 = (dstMem / 128) % 8 |
96 字节重排 |
基址偏移 = (dstMem / 128) % 2 |
64 字节重排 |
基址偏移 = (dstMem / 128) % 4 |
32 字节重排 |
基址偏移 = (dstMem / 128) % 2 |
5.5.8. Tensor-map#
tensor-map 是一个 128 字节的不透明对象,位于 .const 空间、.param(kernel
函数参数)空间或 .global 空间中,用于描述前文各节所述张量数据的张量属性和访问属性。
Tensor-Map 可以使用 CUDA API 创建。更多细节请参阅CUDA 编程指南。