9.1. 指令描述的格式和语义#
本节描述每条 PTX 指令。除指令名称和格式外,还说明其语义,并给出若干示例,展示指令可能采用的不同写法。
9.2. PTX 指令#
PTX 指令通常有零至四个操作数,还可在操作码左侧的 @ 符号后使用可选的保护谓词:
@p opcode;@p opcode a;@p opcode d, a;@p opcode d, a, b;@p opcode d, a, b, c;
对于产生结果值的指令,d 是目标操作数,a、b 和 c 是源操作数。
setp 指令会写入两个目标寄存器。文档使用竖线 | 分隔多个目标寄存器。
setp.lt.s32 p|q, a, b; // p = (a < b); q = !(a < b);
部分指令的目标操作数可以省略。可以用下划线(_)表示的 bit bucket 操作数来代替目标寄存器。
9.3. 谓词执行#
在 PTX 中,谓词寄存器是虚拟寄存器,类型说明符为 .pred。因此,可以如下声明谓词寄存器:
.reg .pred p, q, r;
所有指令都可带有控制条件执行的可选保护谓词。指定条件执行的语法是在指令前加上 @{!}p,其中 p 是一个谓词变量,也可以选择对它取反。没有保护谓词的指令无条件执行。
谓词最常由 setp 指令的比较结果设置。
例如,考虑下面的高级语言代码:
if (i < n)
    j = j + 1;
在 PTX 中可写为:
      setp.lt.s32  p, i, n;    // p = (i < n)
@p    add.s32      j, j, 1;    // if i < n, add 1 to j
要实现条件分支或条件函数调用,可用谓词控制分支指令或调用指令的执行。若要将上述示例实现为真正的条件分支,可以使用以下 PTX 指令序列:
      setp.lt.s32  p, i, n;    // compare i to n
@!p   bra  L1;                 // if False, branch over
      add.s32      j, j, 1;
L1:     ...
9.3.1. 比较#
9.3.1.1. 整数和位宽类型比较#
有符号整数比较包括传统的 eq(等于)、ne(不等于)、lt(小于)、le(小于或等于)、gt(大于)和 ge(大于或等于)。无符号比较包括 eq、ne、lo(低于)、ls(低于或相同)、hi(高于)和 hs(高于或相同)。位宽类型只支持 eq 与 ne 比较;位宽类型未定义顺序比较。
表 22列出了有符号整数、无符号整数和位宽类型的比较运算符。
含义 |
有符号运算符 |
无符号运算符 |
位宽类型运算符 |
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
不适用 |
|
|
|
不适用 |
|
|
|
不适用 |
|
|
|
不适用 |
9.3.1.2. 浮点比较#
有序浮点比较包括 eq、ne、lt、le、gt 和 ge。如果任一操作数为 NaN,比较结果为 False。表 23列出了浮点比较运算符。
含义 |
浮点运算符 |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
为便于存在 NaN 值时进行比较,PTX 提供无序浮点比较:equ、neu、ltu、leu、gtu 和 geu。如果两个操作数都是数值(均非 NaN),比较结果与对应的有序比较相同。如果任一操作数为 NaN,比较结果为 True。
表 24列出了接受 NaN 值的浮点比较运算符。
含义 |
浮点运算符 |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
为检测 NaN 值,PTX 提供 num(numeric)和 nan(isNaN)两个运算符。当两个操作数都是数值(均非 NaN)时,num 返回 True;当任一操作数为 NaN 时,nan 返回 True。表 25列出了用于检测 NaN 值的浮点比较运算符。
含义 |
浮点运算符 |
|---|---|
|
|
|
|
9.3.2. 谓词操作#
可用以下指令计算和操作谓词值:and、or、xor、not 和 mov。
谓词值与整数值之间没有直接转换方式,也不能直接加载或存储谓词寄存器的值。不过,可使用 setp 从整数生成谓词,再使用基于谓词的选择指令 selp 根据谓词值生成整数值。例如:
selp.u32 %r1,1,0,%p; // convert predicate to 32-bit value
9.4. 指令和操作数的类型信息#
带类型的指令必须具有类型和宽度修饰符。例如,add 指令需要类型与宽度信息,才能正确执行加法运算(有符号、无符号、浮点以及不同宽度);这些信息必须作为后缀写在操作码之后。
示例
.reg .u16 d, a, b;
add.u16 d, a, b;    // perform a 16-bit unsigned add
有些指令需要多个类型和宽度修饰符,数据转换指令 cvt 尤其如此。它要求为结果和源分别指定类型与宽度修饰符,排列顺序与操作数相同。例如:
.reg .u16 a;
.reg .f32 d;
cvt.f32.u16 d, a;   // convert 16-bit unsigned to 32-bit float
通常,操作数类型必须与相应的指令类型修饰符一致。操作数与指令类型的匹配规则如下:
位宽类型可与任意相同宽度的类型匹配。
有符号整数类型与无符号整数类型在宽度相同时可以匹配;如有需要,整数操作数会隐式转换为指令类型。例如,有符号整数指令中的无符号整数操作数会被该指令按有符号整数解释。
浮点类型仅在宽度相同时匹配;也就是说,类型必须完全一致。
表 26汇总了这些类型检查规则。
操作数类型 |
|||||
|---|---|---|---|---|---|
.bX |
.sX |
.uX |
.fX |
||
指令类型 |
.bX |
合法 |
合法 |
合法 |
合法 |
.sX |
合法 |
合法 |
合法 |
无效 |
|
.uX |
合法 |
合法 |
合法 |
无效 |
|
.fX |
合法 |
无效 |
无效 |
合法 |
|
注
有些操作数的类型和宽度独立于指令的类型与宽度。例如,左移和右移指令的移位量操作数始终为 .u32 类型,而其他操作数的类型和宽度由指令类型决定。
示例
// 64-bit arithmetic right shift; shift amount 'b' is .u32
    shr.s64 d,a,b;
9.4.1. 操作数宽度超过指令类型宽度#
为便于使用常规宽度的寄存器加载、存储和转换较窄的值,ld、st 和 cvt 指令允许源数据操作数和目标数据操作数宽于指令类型的宽度。例如,加载、存储或转换为其他类型与宽度时,可以直接用 32 位或 64 位寄存器保存 8 位或 16 位值。对于位宽类型和整数类型(有符号及无符号)的指令,操作数类型检查规则有所放宽;浮点指令类型仍要求操作数的类型和宽度完全匹配,除非该操作数为位宽类型。
当源操作数的宽度超过指令类型的宽度时,源数据会截断(chop)至指令类型宽度所指定的位数。
表 27汇总了源操作数的宽松类型检查规则。注意,某些组合对于特定指令仍可能无效;例如,cvt 指令不支持 .bX 指令类型,因此表中这些行对于 cvt 无效。
源操作数类型 |
|||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
b8 |
b16 |
b32 |
b64 |
b128 |
s8 |
s16 |
s32 |
s64 |
u8 |
u16 |
u32 |
u64 |
f16 |
f32 |
f64 |
||
指令类型 |
b8 |
– |
chop |
chop |
chop |
chop |
– |
chop |
chop |
chop |
– |
chop |
chop |
chop |
chop |
chop |
chop |
b16 |
inv |
– |
chop |
chop |
chop |
inv |
– |
chop |
chop |
inv |
– |
chop |
chop |
– |
chop |
chop |
|
b32 |
inv |
inv |
– |
chop |
chop |
inv |
inv |
– |
chop |
inv |
inv |
– |
chop |
inv |
– |
chop |
|
b64 |
inv |
inv |
inv |
– |
chop |
inv |
inv |
inv |
– |
inv |
inv |
inv |
– |
inv |
inv |
– |
|
b128 |
inv |
inv |
inv |
inv |
– |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
|
s8 |
– |
chop |
chop |
chop |
chop |
– |
chop |
chop |
chop |
– |
chop |
chop |
chop |
inv |
inv |
inv |
|
s16 |
inv |
– |
chop |
chop |
chop |
inv |
– |
chop |
chop |
inv |
– |
chop |
chop |
inv |
inv |
inv |
|
s32 |
inv |
inv |
– |
chop |
chop |
inv |
inv |
– |
chop |
inv |
inv |
– |
chop |
inv |
inv |
inv |
|
s64 |
inv |
inv |
inv |
– |
chop |
inv |
inv |
inv |
– |
inv |
inv |
inv |
– |
inv |
inv |
inv |
|
u8 |
– |
chop |
chop |
chop |
chop |
– |
chop |
chop |
chop |
– |
chop |
chop |
chop |
inv |
inv |
inv |
|
u16 |
inv |
– |
chop |
chop |
chop |
inv |
– |
chop |
chop |
inv |
– |
chop |
chop |
inv |
inv |
inv |
|
u32 |
inv |
inv |
– |
chop |
chop |
inv |
inv |
– |
chop |
inv |
inv |
– |
chop |
inv |
inv |
inv |
|
u64 |
inv |
inv |
inv |
– |
chop |
inv |
inv |
inv |
– |
inv |
inv |
inv |
– |
inv |
inv |
inv |
|
f16 |
inv |
– |
chop |
chop |
chop |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
– |
inv |
inv |
|
f32 |
inv |
inv |
– |
chop |
chop |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
– |
inv |
|
f64 |
inv |
inv |
inv |
– |
chop |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
– |
|
注 |
chop = 仅保留符合宽度的低位;“–” = 允许,且无需转换; inv = 无效,会产生解析错误。
|
||||||||||||||||
当目标操作数的宽度超过指令类型的宽度时,目标数据会通过零扩展或符号扩展达到目标寄存器的宽度。如果相应的指令类型是有符号整数,则进行符号扩展;否则进行零扩展。
表 28汇总了目标操作数的宽松类型检查规则。
目标操作数类型 |
|||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
b8 |
b16 |
b32 |
b64 |
b128 |
s8 |
s16 |
s32 |
s64 |
u8 |
u16 |
u32 |
u64 |
f16 |
f32 |
f64 |
||
指令类型 |
b8 |
– |
zext |
zext |
zext |
zext |
– |
zext |
zext |
zext |
– |
zext |
zext |
zext |
zext |
zext |
zext |
b16 |
inv |
– |
zext |
zext |
zext |
inv |
– |
zext |
zext |
inv |
– |
zext |
zext |
– |
zext |
zext |
|
b32 |
inv |
inv |
– |
zext |
zext |
inv |
inv |
– |
zext |
inv |
inv |
– |
zext |
inv |
– |
zext |
|
b64 |
inv |
inv |
inv |
– |
zext |
inv |
inv |
inv |
– |
inv |
inv |
inv |
– |
inv |
inv |
– |
|
b128 |
inv |
inv |
inv |
inv |
– |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
|
s8 |
– |
sext |
sext |
sext |
sext |
– |
sext |
sext |
sext |
– |
sext |
sext |
sext |
inv |
inv |
inv |
|
s16 |
inv |
– |
sext |
sext |
sext |
inv |
– |
sext |
sext |
inv |
– |
sext |
sext |
inv |
inv |
inv |
|
s32 |
inv |
inv |
– |
sext |
sext |
inv |
inv |
– |
sext |
inv |
inv |
– |
sext |
inv |
inv |
inv |
|
s64 |
inv |
inv |
inv |
– |
sext |
inv |
inv |
inv |
– |
inv |
inv |
inv |
– |
inv |
inv |
inv |
|
u8 |
– |
zext |
zext |
zext |
zext |
– |
zext |
zext |
zext |
– |
zext |
zext |
zext |
inv |
inv |
inv |
|
u16 |
inv |
– |
zext |
zext |
zext |
inv |
– |
zext |
zext |
inv |
– |
zext |
zext |
inv |
inv |
inv |
|
u32 |
inv |
inv |
– |
zext |
zext |
inv |
inv |
– |
zext |
inv |
inv |
– |
zext |
inv |
inv |
inv |
|
u64 |
inv |
inv |
inv |
– |
zext |
inv |
inv |
inv |
– |
inv |
inv |
inv |
– |
inv |
inv |
inv |
|
f16 |
inv |
– |
zext |
zext |
zext |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
– |
inv |
inv |
|
f32 |
inv |
inv |
– |
zext |
zext |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
– |
inv |
|
f64 |
inv |
inv |
inv |
– |
zext |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
inv |
– |
|
注 |
sext = 符号扩展;zext = 零扩展;“–” = 允许,且无需转换; inv = 无效,会产生解析错误。
|
||||||||||||||||
9.5. 控制结构中的线程分歧#
CTA 中的线程至少在表面上会一起执行,直到遇到条件分支、条件函数调用或条件返回等条件控制结构。如果线程沿不同的控制流路径执行,则称这些线程发生分歧(divergent)。如果所有线程一致行动并沿同一条控制流路径执行,则称这些线程一致(uniform)。这两种情况在程序中都很常见。
线程发生分歧的 CTA 可能比线程一致执行的 CTA 性能更低,因此让发生分歧的线程尽快重新汇合很重要。除非控制流指令使用 .uni 后缀标记为一致,否则所有控制结构都被视为可能发生分歧的点。对于分歧控制流,优化代码生成器会自动确定重新汇合的位置。因此,面向 PTX 的编译器或代码编写者可以不必处理线程分歧问题;但当编译器或编写者能够保证分支点不会发生分歧时,也可以将该分支点标记为一致,以改善性能。
9.6. 语义#
指令语义描述的目标,是尽可能用简洁的语言描述所有情况下的结果。语义首先使用 C 语言描述;当 C 语言的表达能力不足时,则使用其他方式描述。
9.6.1. 16 位代码的机器相关语义#
PTX 程序可能在具有 16 位或 32 位数据通路的 GPU 上执行。在 32 位数据通路上执行时,PTX 中的 16 位寄存器会映射到 32 位物理寄存器,16 位计算也会提升为 32 位计算。因此,同一段代码在 16 位机器和 32 位机器上运行时可能产生不同的计算结果:提升后的计算可能在寄存器高半字中保留额外的位,而 16 位物理寄存器中不存在这些位。这些额外的精度位可能在应用程序层面变得可见,例如通过右移指令。
在 PTX 语言层面,一种解决办法是为 16 位代码定义与 16 位数据通路上的执行一致的语义。但这种做法会使运行在 32 位数据通路上的 16 位代码付出性能代价,因为转换后的代码需要许多额外的掩码指令,以抑制 32 位寄存器高半字中的额外精度位。
为避免 16 位代码在 32 位 GPU 上运行时产生性能代价,PTX 中 16 位指令的语义取决于具体机器。编译器或程序员可以在程序的适当位置显式转换为 16 位值,以强制采用可移植、与机器无关的 16 位语义,并保证代码的可移植性。不过,对许多性能关键型应用而言,这样做并不可取;对许多应用而言,允许执行结果存在差异也比限制性能更合适。
9.7. 指令#
所有 PTX 指令都可以受谓词控制。下文的语法描述省略了可选的保护谓词。
9.7.1. 整数算术指令#
整数算术指令使用寄存器形式或常量立即数形式的整数类型操作数。整数算术指令包括:
addsubmulmadclmadmul24mad24saddivremabsnegminmaxpopcclzbfindfnsbrevbfebfibmskszextdp4adp2a
9.7.1.1. 整数算术指令:add#
add
将两个值相加。
语法
add.type1        d, a, b;
add{.sat}.type2  d, a, b;
.type1 = { .u16, .u64,
.s16, .s64 };
.type2 = { .u32, .u16x2, .u8x4,
.s32, .s16x2, .s8x4 };
说明
执行加法,并将结果写入目标寄存器。
对于 .u16x2 和 .s16x2 指令类型,从源操作数的半字值构成输入向量;随后并行地对半字操作数相加,在目标中产生 .u16x2 或 .s16x2 结果。
对于 .u8x4 和 .s8x4 指令类型,从源操作数的四分之一字值构成输入向量;随后并行地对这些操作数相加,在目标中产生 .u8x4 或 .s8x4 结果。
操作数 d、a 和 b 的类型与指令类型相同。对于 .u16x2、.s16x2、.u8x4 和 .s8x4 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == u16x2 || type == s16x2) {
    iA[0] = a[0:15];
    iA[1] = a[16:31];
    iB[0] = b[0:15];
    iB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = iA[i] + iB[i];
    }
} else if (type == u8x4 || type == s8x4) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
    iB[0] = b[0:7];
    iB[1] = b[8:15];
    iB[2] = b[16:23];
    iB[3] = b[24:31];
    for (i = 0; i < 4; i++) {
         d[i] = iA[i] + iB[i];
    }
} else {
    d = a + b;
}
示例
@p  add.u32     x,y,z;
    add.sat.s32 c,c,1;
    add.u16x2   u,v,w;
    add.s8x4.sat p, q, r;
9.7.1.2. 整数算术指令:sub#
sub
从一个值中减去另一个值。
语法
sub.type1        d, a, b;
sub{.sat}.type2  d, a, b;
.type1 = { .u16, .u32, .u64,
.s16, .s64 };
.type2 = { .s32, .u8x4, .s8x4 };
说明
执行减法,并将结果写入目标寄存器。
对于 .u8x4 和 .s8x4 指令类型,从源操作数的四分之一字值构成输入向量;随后并行地对这些操作数相减,在目标中产生 .u8x4 或 .s8x4 结果。
对于 .u8x4 和 .s8x4 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == u8x4 || type == s8x4) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
    iB[0] = b[0:7];
    iB[1] = b[8:15];
    iB[2] = b[16:23];
    iB[3] = b[24:31];
    for (i = 0; i < 4; i++) {
         d[i] = iA[i] - iB[i];
    }
} else {
    d = a - b;
}
示例
sub.s32 c,a,b;
sub.u8x4 p, q, r;
9.7.1.3. 整数算术指令:mul#
mul
将两个值相乘。
语法
mul.mode.type  d, a, b;
.mode = { .hi, .lo, .wide };
.type = { .u16, .u32, .u64,
.s16, .s32, .s64 };
说明
计算两个值的乘积。
语义
t = a * b;
n = bitwidth of type;
d = t;            // for .wide
d = t<2n-1..n>;   // for .hi variant
d = t<n-1..0>;    // for .lo variant
示例
mul.wide.s16 fa,fxs,fys;   // 16*16 bits yields 32 bits
mul.lo.s16 fa,fxs,fys;     // 16*16 bits, save only the low 16 bits
mul.wide.s32 z,x,y;        // 32*32 bits, creates 64 bit result
9.7.1.4. 整数算术指令:mad#
mad
将两个值相乘,可选择提取中间结果的高半部或低半部,然后加上第三个值。
语法
mad.mode.type  d, a, b, c;
mad.hi.sat.s32 d, a, b, c;
.mode = { .hi, .lo, .wide };
.type = { .u16, .u32, .u64,
.s16, .s32, .s64 };
说明
将两个值相乘,可选择提取中间结果的高半部或低半部,再加上第三个值,并将结果写入目标寄存器。
语义
t = a * b;
n = bitwidth of type;
d = t + c;           // for .wide
d = t<2n-1..n> + c;  // for .hi variant
d = t<n-1..0> + c;   // for .lo variant
示例
@p  mad.lo.s32 d,a,b,c;
    mad.lo.s32 r,p,q,r;
9.7.1.5. 整数算术指令:clmad#
clmad
执行无进位乘法和加法运算。
语法
clmad.mode.u64 d, a, b, c;
.mode = { .hi, .lo };
说明
对 a 和 b 执行无进位乘法,再与 c 执行无进位加法,并将结果写入目标寄存器 d。
clmad 的所有操作数都是无符号 64 位值。
修饰符 .mode 指定无进位乘积的哪一部分存入目标寄存器:
.lo-
生成乘积的低 64 位,并加上
c。 .hi-
生成乘积的高 64 位,并加上
c。
语义
tmp[127:0] = 0;  // 128-bit result of carryless multiplication.
for (i = 0; i < 64; i++) {
if ((a & (1 << i)) != 0) {
tmp ^= b << i;
}
}
// Select upper or lower 64 bits depending on the value of .mode.
if (.mode == .lo) {
d = tmp[63..0];
} else {
d = tmp[127..64];
}
d ^= c;  // carryless accumulation.
示例
.reg .u64 Rd, Ra, Rb, Rc;
// Carryless multiply-add producing lower 64 bits of result.
clmad.lo.u64 Rd, Ra, Rb, Rc;
// Carryless multiply-add producing higher 64 bits of result.
clmad.hi.u64 Rd, Ra, Rb, Rc;
9.7.1.6. 整数算术指令:mul24#
mul24
将两个 24 位整数值相乘。
语法
mul24.mode.type  d, a, b;
.mode = { .hi, .lo };
.type = { .u32, .s32 };
说明
计算保存在 32 位源寄存器中的两个 24 位整数值的乘积,并返回 48 位结果的高 32 位或低 32 位。
语义
t = a * b;
d = t<47..16>;    // for .hi variant
d = t<31..0>;     // for .lo variant
示例
mul24.lo.s32 d,a,b; // low 32-bits of 24x24-bit signed multiply.
9.7.1.7. 整数算术指令:mad24#
mad24
将两个 24 位整数值相乘,再加上第三个值。
语法
mad24.mode.type  d, a, b, c;
mad24.hi.sat.s32 d, a, b, c;
.mode = { .hi, .lo };
.type = { .u32, .s32 };
说明
计算保存在 32 位源寄存器中的两个 24 位整数值的乘积,并将第三个 32 位值加到 48 位结果的高 32 位或低 32 位上。返回 48 位结果的高 32 位或低 32 位。
语义
t = a * b;
d = t<47..16> + c;   // for .hi variant
d = t<31..0> + c;    // for .lo variant
示例
mad24.lo.s32 d,a,b,c; // low 32-bits of 24x24-bit signed multiply.
9.7.1.8. 整数算术指令:sad#
sad
绝对差之和。
语法
sad.type  d, a, b, c;
.type = { .u16, .u32, .u64,
.s16, .s32, .s64 };
说明
将 a-b 的绝对值加到 c,并将结果写入 d。
语义
d = c + ((a<b) ? b-a : a-b);
示例
sad.s32  d,a,b,c;
sad.u32  d,a,b,d;  // running sum
9.7.1.9. 整数算术指令:div#
div
用一个值除以另一个值。
语法
div.type  d, a, b;
.type = { .u16, .u32, .u64,
.s16, .s32, .s64 };
说明
将 a 除以 b,把结果存入 d。
语义
d = a / b;
示例
div.s32 b,n,i;
9.7.1.10. 整数算术指令:rem#
rem
整数除法的余数。
语法
rem.type  d, a, b;
.type = { .u16, .u32, .u64,
.s16, .s32, .s64 };
说明
将 a 除以 b,把余数存入 d。
语义
d = a % b;
示例
rem.s32 x,x,8; // x = x%8;
9.7.1.11. 整数算术指令:abs#
abs
绝对值。
语法
abs.type  d, a;
.type = { .s16, .s32, .s64 };
说明
取 a 的绝对值并存入 d。
语义
d = |a|;
示例
abs.s32 r0,a;
9.7.1.12. 整数算术指令:neg#
neg
算术取负。
语法
neg.type  d, a;
.type = { .s8x4, .s16, .s32, .s64 };
说明
将 a 的符号取反,并把结果存入 d。
对于 .s8x4 指令类型,从源操作数的四分之一字值构成输入向量;随后并行地对这些操作数取负,在目标中产生 .s8x4 结果。
操作数 d 和 a 的类型与指令类型相同。对于 .s8x4 指令类型,操作数 d 和 a 的类型为 .b32。
语义
if (type == s8x4) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
    for (i = 0; i < 4; i++) {
         d[i] = -iA[i];
    }
} else {
    d = -a;
}
示例
neg.s32  r0,a;
neg.s8x4 p, q, r;
9.7.1.13. 整数算术指令:min#
min
求两个值中的最小值。
语法
min.type1         d, a, b;
min{.relu}.type2  d, a, b;
.type1 = { .u16, .u32, .u64,
.u16x2, .u8x4, .s16, .s64 };
.type2 = { .s16x2, .s32, .s8x4 };
说明
将 a 和 b 中的最小值存入 d。
对于 .u16x2 和 .s16x2 指令类型,使用源操作数中的半字值组成输入向量。然后并行处理各半字操作数,在目标操作数中生成 .u16x2 或 .s16x2 结果。
对于 .u8x4 和 .s8x4 指令类型,使用源操作数中的四分之一字值组成输入向量。然后并行处理各四分之一字操作数,将 .u8x4 或 .s8x4 结果存入目标操作数。
操作数 d、a 和 b 的类型与指令类型相同。对于 .u16x2、.s16x2、.u8x4 和 .s8x4 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == u16x2 || type == s16x2) {
    iA[0] = a[0:15];
    iA[1] = a[16:31];
    iB[0] = b[0:15];
    iB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = (iA[i] < iB[i]) ? iA[i] : iB[i];
    }
} else if (type == u8x4 || type == s8x4) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
    iB[0] = b[0:7];
    iB[1] = b[8:15];
    iB[2] = b[16:23];
    iB[3] = b[24:31];
    for (i = 0; i < 4; i++) {
         d[i] = (iA[i] < iB[i]) ? iA[i] : iB[i];
    }
} else {
    d = (a < b) ? a : b; // Integer (signed and unsigned)
}
示例
    min.s32  r0,a,b;
@p  min.u16  h,i,j;
    min.s16x2.relu u,v,w;
    min.u8x4 p, q, r;
9.7.1.14. 整数算术指令:max#
max
求两个值中的最大值。
语法
max.type1         d, a, b;
max{.relu}.type2  d, a, b;
.type1 = { .u16, .u32, .u64,
.u16x2, .u8x4, .s16, .s64 };
.type2 = { .s16x2, .s32, .s8x4 };
说明
将 a 和 b 中的最大值存入 d。
对于 .u16x2 和 .s16x2 指令类型,使用源操作数中的半字值组成输入向量。然后并行处理各半字操作数,在目标操作数中生成 .u16x2 或 .s16x2 结果。
对于 .u8x4 和 .s8x4 指令类型,使用源操作数中的四分之一字值组成输入向量。然后并行处理各四分之一字操作数,将 .u8x4 或 .s8x4 结果存入目标操作数。
操作数 d、a 和 b 的类型与指令类型相同。对于 .u16x2、.s16x2、.u8x4 和 .s8x4 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == u16x2 || type == s16x2) {
    iA[0] = a[0:15];
    iA[1] = a[16:31];
    iB[0] = b[0:15];
    iB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = (iA[i] > iB[i]) ? iA[i] : iB[i];
    }
} else if (type == u8x4 || type == s8x4) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
    iB[0] = b[0:7];
    iB[1] = b[8:15];
    iB[2] = b[16:23];
    iB[3] = b[24:31];
    for (i = 0; i < 4; i++) {
         d[i] = (iA[i] > iB[i]) ? iA[i] : iB[i];
    }
} else {
    d = (a > b) ? a : b; // Integer (signed and unsigned)
}
示例
max.u32  d,a,b;
max.s32  q,q,0;
max.relu.s16x2 t,t,u;
max.u8x4 p, q, r;
9.7.1.15. 整数算术指令:popc#
popc
计算置位位数。
语法
popc.type  d, a;
.type = { .b32, .b64 };
说明
计算 a 中值为 1 的位数,并将所得的population count存入 32 位目标寄存器 d。操作数 a 采用指令类型,目标操作数 d 的类型为 .u32。
语义
.u32  d = 0;
while (a != 0) {
   if (a & 0x1)  d++;
   a = a >> 1;
}
示例
popc.b32  d, a;
popc.b64  cnt, X;  // cnt is .u32
9.7.1.16. 整数算术指令:clz#
clz
计算前导零的个数。
语法
clz.type  d, a;
.type = { .b32, .b64 };
说明
从最高有效位开始计算 a 中前导零的个数,并将结果存入 32 位目标寄存器 d。操作数 a 采用指令类型,目标操作数 d 的类型为 .u32。对于 .b32 类型,前导零的个数为 0 到 32(含端点);对于 .b64 类型,为 0 到 64(含端点)。
语义
.u32  d = 0;
if (.type == .b32)   { max = 32; mask = 0x80000000; }
else                 { max = 64; mask = 0x8000000000000000; }
while (d < max && (a&mask == 0) ) {
d++;
a = a << 1;
}
示例
clz.b32  d, a;
clz.b64  cnt, X;  // cnt is .u32
9.7.1.17. 整数算术指令:bfind#
bfind
查找最高有效的非符号位。
语法
bfind.type           d, a;
bfind.shiftamt.type  d, a;
.type = { .u32, .u64,
.s32, .s64 };
说明
查找 a 中最高有效非符号位的位置,并将结果存入 d。操作数 a 采用指令类型,目标操作数 d 的类型为 .u32。对于无符号整数,bfind 返回最高有效的 1 位的位置。对于有符号整数,负值输入时 bfind 返回最高有效的 0 位的位置,非负值输入时返回最高有效的 1 位的位置。
如果指定 .shiftamt,bfind 返回将找到的位左移至最高有效位所需的移位量。
如果没有找到非符号位,bfind 返回 0xffffffff。
语义
msb = (.type==.u32 || .type==.s32) ? 31 : 63;
// negate negative signed inputs
if ( (.type==.s32 || .type==.s64) && (a & (1<<msb)) ) {
    a = ~a;
}
.u32  d = 0xffffffff;
for (.s32 i=msb; i>=0; i--) {
    if (a & (1<<i))  { d = i; break; }
}
if (.shiftamt && d != 0xffffffff)  { d = msb - d; }
示例
bfind.u32  d, a;
bfind.shiftamt.s64  cnt, X;  // cnt is .u32
9.7.1.18. 整数算术指令:fns#
fns
查找第 n 个置位位。
语法
fns.b32 d, mask, base, offset;
说明
给定 32 位值 mask 和整数值 base(范围为 0 至 31),从 base 指定的位开始,在 mask 中查找第 n 个(由 offset 给定)置位位,并将位位置存入 d。如果未找到,则将 0xffffffff 存入 d。
操作数 mask 为 32 位类型。操作数 base 的类型为 .b32、.u32 或 .s32。操作数 offset 的类型为 .s32。目标操作数 d 的类型为 .b32.。
操作数 base 必须不大于 31,否则行为未定义。
语义
d = 0xffffffff;
if (offset == 0) {
if (mask[base] == 1) {
d = base;
}
} else {
pos = base;
count = |offset| - 1;
inc = (offset > 0) ? 1 : -1;
while ((pos >= 0) && (pos < 32)) {
if (mask[pos] == 1) {
if (count == 0) {
d = pos;
break;
} else {
count = count - 1;
}
}
pos = pos + inc;
}
plaintext
}
示例
fns.b32 d, 0xaaaaaaaa, 3, 1;   // d = 3
fns.b32 d, 0xaaaaaaaa, 3, -1;  // d = 3
fns.b32 d, 0xaaaaaaaa, 2, 1;   // d = 3
fns.b32 d, 0xaaaaaaaa, 2, -1;  // d = 1
9.7.1.19. 整数算术指令:brev#
brev
位反转。
语法
brev.type  d, a;
.type = { .b32, .b64 };
说明
对输入进行逐位反转。
语义
msb = (.type==.b32) ? 31 : 63;
for (i=0; i<=msb; i++) {
d[i] = a[msb-i];
}
示例
brev.b32 d, a;
9.7.1.20. 整数算术指令:bfe#
bfe
位域提取。
语法
bfe.type  d, a, b, c;
.type = { .u32, .u64,
.s32, .s64 };
说明
从 a 提取位域,并将经零扩展或符号扩展的结果存入 d。源操作数 b 给出位域的起始位位置,源操作数 c 给出位域的长度(以位为单位)。
操作数 a 和 d 的类型与指令类型相同。操作数 b 和 c 的类型为 .u32,但取值限于 8 位范围 0..255。
提取位域的符号位定义如下:
-
.u32,.u64: -
零
-
.s32,.s64: -
如果提取的位域超出输入 a 的
msb,则为输入 a 的msb;否则为提取位域的msb。
如果位域长度为零,结果为零。
目标操作数 d 使用提取位域的符号位填充。如果起始位置超出输入的 msb,则目标操作数 d 使用重复的提取位域符号位填满。
语义
msb = (.type==.u32 || .type==.s32) ? 31 : 63;
pos = b & 0xff;  // pos restricted to 0..255 range
len = c & 0xff;  // len restricted to 0..255 range
if (.type==.u32 || .type==.u64 || len==0)
sbit = 0;
else
sbit = a[min(pos+len-1,msb)];
d = 0;
for (i=0; i<=msb; i++) {
d[i] = (i<len && pos+i<=msb) ? a[pos+i] : sbit;
}
示例
bfe.b32 d,a,start,len;
9.7.1.21. 整数算术指令:bfi#
bfi
位域插入。
语法
bfi.type  f, a, b, c, d;
.type = { .b32, .b64 };
说明
将 a 中的位域对齐并插入 b,然后将结果存入 f。源操作数 c 给出插入的起始位位置,源操作数 d 给出位域的长度(以位为单位)。
操作数 a、b 和 f 的类型与指令类型相同。操作数 c 和 d 的类型为 .u32,但取值限于 8 位范围 0..255。
如果位域长度为零,结果为 b。
如果起始位置超出输入的最高有效位,结果为 b。
语义
msb = (.type==.b32) ? 31 : 63;
pos = c & 0xff;  // pos restricted to 0..255 range
len = d & 0xff;  // len restricted to 0..255 range
f = b;
for (i=0; i<len && pos+i<=msb; i++) {
f[pos+i] = a[i];
}
示例
bfi.b32 d,a,b,start,len;
9.7.1.22. 整数算术指令:szext#
szext
符号扩展或零扩展。
语法
szext.mode.type  d, a, b;
.mode = { .clamp, .wrap };
.type = { .u32, .s32 };
说明
对操作数 a 中的 N 位值进行符号扩展或零扩展,其中 N 由操作数 b 指定。结果存入目标操作数 d。
对于 .s32 指令类型,a 中的值视为 N 位有符号值,并将该 N 位值的最高有效位复制到第 31 位。对于 .u32 指令类型,a 中的值视为 N 位无符号数,并零扩展至 32 位。操作数 b 是无符号 32 位值。
如果 N 的值为 0,szext 的结果为 0。如果 N 的值为 32 或更大,szext 的结果取决于 .mode 限定符的值,如下所述:
如果
.mode为.clamp,结果与源操作数a相同。如果
.mode为.wrap,则使用取模后的 N 值计算结果。
语义
b1        = b & 0x1f;
too_large = (b >= 32 && .mode == .clamp) ? true : false;
mask      = too_large ? 0 : (~0) << b1;
sign_pos  = (b1 - 1) & 0x1f;
if (b1 == 0 || too_large || .type != .s32) {
sign_bit = false;
} else {
sign_bit = (a >> sign_pos) & 1;
}
d = (a & ~mask) | (sign_bit ? mask | 0);
示例
szext.clamp.s32 rd, ra, rb;
szext.wrap.u32  rd, 0xffffffff, 0; // Result is 0.
9.7.1.23. 整数算术指令:bmsk#
bmsk
位域掩码。
语法
bmsk.mode.b32  d, a, b;
.mode = { .clamp, .wrap };
说明
从操作数 a 指定的位位置开始,生成宽度由操作数 b 指定的 32 位掩码。生成的位掩码存入目标操作数 d。
在以下情况下,所得位掩码为 0:
a的值为 32 或更大,且.mode为.clamp。指定的
b值或取模后的b值(当.mode指定为.wrap时)为 0。
语义
a1    = a & 0x1f;
mask0 = (~0) << a1;
b1    = b & 0x1f;
sum   = a1 + b1;
mask1 = (~0) << sum;
sum-overflow          = sum >= 32 ? true : false;
bit-position-overflow = false;
bit-width-overflow    = false;
if (.mode == .clamp) {
if (a >= 32) {
bit-position-overflow = true;
mask0 = 0;
}
if (b >= 32) {
bit-width-overflow = true;
}
}
if (sum-overflow || bit-position-overflow || bit-width-overflow) {
mask1 = 0;
} else if (b1 == 0) {
mask1 = ~0;
}
d = mask0 & ~mask1;
示例
bmsk.clamp.b32  rd, ra, rb;
bmsk.wrap.b32   rd, 1, 2; // Creates a bitmask of 0x00000006.
9.7.1.24. 整数算术指令:dp4a#
dp4a
四路字节点积累加。
语法
dp4a.atype.btype  d, a, b, c;
.atype = .btype = { .u32, .s32 };
说明
计算四路字节点积,并将其累加到 32 位结果中。
操作数 a 和 b 是 32 位输入,分别以打包形式保存用于点积的 4 个字节输入值。
如果 .atype 和 .btype 均为 .u32,操作数 c 的类型为 .u32;否则操作数 c 的类型为 .s32。
语义
d = c;
// Extract 4 bytes from a 32bit input and sign or zero extend
// based on input type.
Va = extractAndSignOrZeroExt_4(a, .atype);
Vb = extractAndSignOrZeroExt_4(b, .btype);
for (i = 0; i < 4; ++i) {
d += Va[i] * Vb[i];
}
示例
dp4a.u32.u32           d0, a0, b0, c0;
dp4a.u32.s32           d1, a1, b1, c1;
9.7.1.25. 整数算术指令:dp2a#
dp2a
双路点积累加。
语法
dp2a.mode.atype.btype  d, a, b, c;
.atype = .btype = { .u32, .s32 };
.mode = { .lo, .hi };
说明
计算双路 16 位值与 8 位值的点积,并将其累加到 32 位结果中。
操作数 a 和 b 是 32 位输入。操作数 a 以打包形式保存两个 16 位输入值,操作数 b 以打包形式保存用于点积的 4 个字节输入值。
根据指定的 .mode,点积使用操作数 b 的低半部分或高半部分。
如果 .atype 和 .btype 均为 .u32,操作数 c 的类型为 .u32;否则操作数 c 的类型为 .s32。
语义
d = c;
// Extract two 16-bit values from a 32-bit input and sign or zero extend
// based on input type.
Va = extractAndSignOrZeroExt_2(a, .atype);
// Extract four 8-bit values from a 32-bit input and sign or zer extend
// based on input type.
Vb = extractAndSignOrZeroExt_4(b, .btype);
b_select = (.mode == .lo) ? 0 : 2;
for (i = 0; i < 2; ++i) {
d += Va[i] * Vb[b_select + i];
}
示例
dp2a.lo.u32.u32           d0, a0, b0, c0;
dp2a.hi.u32.s32           d1, a1, b1, c1;
9.7.2. 扩展精度整数算术指令#
指令 add.cc、addc、sub.cc、subc、mad.cc 和 madc 引用一个隐式指定的条件码寄存器(CC)。该寄存器有一个进位标志位(CC.CF),用于保存输入/输出进位或输入/输出借位。这些指令支持扩展精度整数加法、减法和乘法。其他指令均不能访问条件码,也不支持设置、清除或测试条件码。条件码寄存器不会跨调用保留,主要用于计算扩展精度整数加法、减法和乘法的顺序执行代码。
扩展精度算术指令包括:
add.cc,addcsub.cc,subcmad.cc,madc
9.7.2.1. 扩展精度算术指令:add.cc#
add.cc
将两个值相加,并输出进位。
语法
add.cc.type  d, a, b;
.type = { .u32, .s32, .u64, .s64 };
说明
执行整数加法,并将输出进位值写入条件码寄存器。
语义
d = a + b;
将输出进位写入 CC.CF。
示例
@p  add.cc.u32   x1,y1,z1;   // extended-precision addition of
@p  addc.cc.u32  x2,y2,z2;   // two 128-bit values
@p  addc.cc.u32  x3,y3,z3;
@p  addc.u32     x4,y4,z4;
9.7.2.2. 扩展精度算术指令:addc#
addc
执行带输入进位的加法,并可选择输出进位。
语法
addc{.cc}.type  d, a, b;
.type = { .u32, .s32, .u64, .s64 };
说明
执行带输入进位的整数加法,并可选择将输出进位值写入条件码寄存器。
语义
d = a + b + CC.CF;
如果指定 .cc,则将输出进位写入 CC.CF。
示例
@p  add.cc.u32   x1,y1,z1;   // extended-precision addition of
@p  addc.cc.u32  x2,y2,z2;   // two 128-bit values
@p  addc.cc.u32  x3,y3,z3;
@p  addc.u32     x4,y4,z4;
9.7.2.3. 扩展精度算术指令:sub.cc#
sub.cc
从一个值中减去另一个值,并输出借位。
语法
sub.cc.type  d, a, b;
.type = { .u32, .s32, .u64, .s64 };
说明
执行整数减法,并将输出借位值写入条件码寄存器。
语义
d = a - b;
将输出借位写入 CC.CF。
示例
@p  sub.cc.u32   x1,y1,z1;   // extended-precision subtraction
@p  subc.cc.u32  x2,y2,z2;   // of two 128-bit values
@p  subc.cc.u32  x3,y3,z3;
@p  subc.u32     x4,y4,z4;
9.7.2.4. 扩展精度算术指令:subc#
subc
执行带输入借位的减法,并可选择输出借位。
语法
subc{.cc}.type  d, a, b;
.type = { .u32, .s32, .u64, .s64 };
说明
执行带输入借位的整数减法,并可选择将输出借位值写入条件码寄存器。
语义
d = a - (b + CC.CF);
如果指定 .cc,则将输出借位写入 CC.CF。
示例
@p  sub.cc.u32   x1,y1,z1;   // extended-precision subtraction
@p  subc.cc.u32  x2,y2,z2;   // of two 128-bit values
@p  subc.cc.u32  x3,y3,z3;
@p  subc.u32     x4,y4,z4;
9.7.2.5. 扩展精度算术指令:mad.cc#
mad.cc
将两个值相乘,取结果的高半部分或低半部分,再与第三个值相加,并输出进位。
语法
mad{.hi,.lo}.cc.type  d, a, b, c;
.type = { .u32, .s32, .u64, .s64 };
说明
将两个值相乘,取结果的高位部分或低位部分,再加上第三个值。将结果写入目标寄存器,并将加法的输出进位写入条件码寄存器。
语义
t = a * b;
d = t<63..32> + c;    // for .hi variant
d = t<31..0> + c;     // for .lo variant
将加法的输出进位写入 CC.CF。
示例
@p  mad.lo.cc.u32 d,a,b,c;
    mad.lo.cc.u32 r,p,q,r;
9.7.2.6. 扩展精度算术指令:madc#
madc
将两个值相乘,取结果的高半部分或低半部分,再与第三个值和输入进位相加,并可选择输出进位。
语法
madc{.hi,.lo}{.cc}.type  d, a, b, c;
.type = { .u32, .s32, .u64, .s64 };
说明
将两个值相乘,取结果的高位部分或低位部分,再加上第三个值及输入进位。将结果写入目标寄存器,并可选择将加法的输出进位写入条件码寄存器。
语义
t = a * b;
d = t<63..32> + c + CC.CF;     // for .hi variant
d = t<31..0> + c + CC.CF;      // for .lo variant
如果指定 .cc,则将加法的输出进位写入 CC.CF。
示例
// extended-precision multiply:  [r3,r2,r1,r0] = [r5,r4] * [r7,r6]
mul.lo.u32     r0,r4,r6;      // r0=(r4*r6).[31:0], no carry-out
mul.hi.u32     r1,r4,r6;      // r1=(r4*r6).[63:32], no carry-out
mad.lo.cc.u32  r1,r5,r6,r1;   // r1+=(r5*r6).[31:0], may carry-out
madc.hi.u32    r2,r5,r6,0;    // r2 =(r5*r6).[63:32]+carry-in,
                              // no carry-out
mad.lo.cc.u32   r1,r4,r7,r1;  // r1+=(r4*r7).[31:0], may carry-out
madc.hi.cc.u32  r2,r4,r7,r2;  // r2+=(r4*r7).[63:32]+carry-in,
                              // may carry-out
addc.u32        r3,0,0;       // r3 = carry-in, no carry-out
mad.lo.cc.u32   r2,r5,r7,r2;  // r2+=(r5*r7).[31:0], may carry-out
madc.hi.u32     r3,r5,r7,r3;  // r3+=(r5*r7).[63:32]+carry-in
9.7.3. 浮点指令#
浮点指令作用于 .f32 和 .f64 寄存器操作数以及常量立即数。浮点指令包括:
testpcopysignaddsubmulfmamaddivabsnegminmaxrcpsqrtrsqrtsincoslg2ex2tanh
支持舍入修饰符的指令符合 IEEE-754。双精度指令支持次正规数输入和结果。对于 sm_20 及后续目标架构,单精度指令默认支持次正规数输入和结果;对于 sm_1x 目标架构,则将次正规数输入和结果冲洗为保留符号的零。单精度指令的可选 .ftz 修饰符会将次正规数输入和结果冲洗为保留符号的零,而不论目标架构为何,从而兼容 sm_1x 目标架构。
单精度 add、sub、mul 和 mad 支持将结果饱和到 [0.0, 1.0] 范围,其中 NaN 会被冲洗为正零。双精度指令支持 NaN 的负载值(rcp.approx.ftz.f64 和 rsqrt.approx.ftz.f64 除外,这两条指令会将输入 NaN 映射为规范 NaN)。单精度指令返回未指定的 NaN。注意,未来的实现可能支持单精度指令的 NaN 负载值,因此 PTX 程序不应依赖生成的特定单精度 NaN。
表 29 汇总了 PTX 中的浮点指令。
指令 |
.rn |
.rz |
.rm |
.rp |
.ftz |
.sat |
说明 |
|---|---|---|---|---|---|---|---|
|
x |
x |
x |
x |
x |
x |
如果未指定舍入修饰符,则默认为 |
|
x |
x |
x |
x |
不适用 |
不适用 |
如果未指定舍入修饰符,则默认为 |
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
x |
无舍入修饰符。 |
|
x |
x |
x |
x |
x |
x |
|
|
x |
x |
x |
x |
不适用 |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
无舍入修饰符。 |
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
不适用 |
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
|
|
x |
x |
x |
x |
x |
不适用 |
|
|
x |
x |
x |
x |
不适用 |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
不适用 |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
不适用 |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
x |
不适用 |
|
|
不适用 |
不适用 |
不适用 |
不适用 |
不适用 |
不适用 |
|
9.7.3.1. 浮点指令:testp#
testp
测试浮点数的属性。
语法
testp.op.type  p, a;  // result is .pred
.op   = { .finite, .infinite,
.number, .notanumber,
.normal, .subnormal };
.type = { .f32, .f64 };
说明
testp 测试浮点数的常见属性:如果结果为 True,则返回谓词值 1;如果结果为 False,则返回 0。
testp.finite-
如果输入既不是无穷大也不是
NaN,则为True testp.infinite-
如果输入为正无穷大或负无穷大,则为
True testp.number-
如果输入不是
NaN,则为True testp.notanumber-
如果输入为
NaN,则为True testp.normal-
如果输入为正规数(不是
NaN,也不是无穷大),则为True testp.subnormal-
如果输入为次正规数(不是
NaN,也不是无穷大),则为True
作为特殊情况,正零和负零视为正规数。
示例
testp.notanumber.f32  isnan, f0;
testp.infinite.f64    p, X;
9.7.3.2. 浮点指令:copysign#
copysign
将一个输入的符号复制到另一个输入。
语法
copysign.type  d, a, b;
.type = { .f32, .f64 };
说明
将 a 的符号位复制到 b 的值中,并将结果作为 d 返回。
示例
copysign.f32  x, y, z;
copysign.f64  A, B, C;
9.7.3.3. 浮点指令:add#
add
将两个值相加。
语法
add{.rnd}{.ftz}{.sat}.f32  d, a, b;
add{.rnd}{.ftz}.f32x2      d, a, b;
add{.rnd}.f64              d, a, b;
.rnd = { .rn, .rz, .rm, .rp };
说明
执行加法,并将结果写入目标寄存器。
对于 .f32x2 指令类型,从源操作数中的单精度(.f32)值组成输入向量。然后并行对单精度(.f32)操作数进行加法,在目标操作数中生成 .f32x2 结果。
对于 .f32x2 指令类型,操作数 d、a 和 b 的类型为 .b64。
语义
if (type == f32 || type == f64) {
    d = a + b;
} else if (type == f32x2) {
    fA[0] = a[0:31];
    fA[1] = a[32:63];
    fB[0] = b[0:31];
    fB[1] = b[32:63];
    for (i = 0; i < 2; i++) {
        d[i] = fA[i] + fB[i];
    }
}
示例
@p  add.rz.ftz.f32  f1,f2,f3;
add.rp.ftz.f32x2    d, a, b;
9.7.3.4. 浮点指令:sub#
sub
从一个值中减去另一个值。
语法
sub{.rnd}{.ftz}{.sat}.f32  d, a, b;
sub{.rnd}{.ftz}.f32x2      d, a, b;
sub{.rnd}.f64              d, a, b;
.rnd = { .rn, .rz, .rm, .rp };
说明
执行减法,并将结果写入目标寄存器。
对于 .f32x2 指令类型,从源操作数中的单精度(.f32)值组成输入向量。然后并行对单精度(.f32)操作数进行减法,在目标操作数中生成 .f32x2 结果。
对于 .f32x2 指令类型,操作数 d、a 和 b 的类型为 .b64。
语义
if (type == f32 || type == f64) {
    d = a - b;
} else if (type == f32x2) {
    fA[0] = a[0:31];
    fA[1] = a[32:63];
    fB[0] = b[0:31];
    fB[1] = b[32:63];
    for (i = 0; i < 2; i++) {
        d[i] = fA[i] - fB[i];
    }
}
示例
sub.f32 c,a,b;
sub.rn.ftz.f32  f1,f2,f3;
9.7.3.5. 浮点指令:mul#
mul
将两个值相乘。
语法
mul{.rnd}{.ftz}{.sat}.f32  d, a, b;
mul{.rnd}{.ftz}.f32x2      d, a, b;
mul{.rnd}.f64              d, a, b;
.rnd = { .rn, .rz, .rm, .rp };
说明
计算两个值的乘积。
对于 .f32x2 指令类型,从源操作数中的单精度(.f32)值组成输入向量。然后并行对单精度(.f32)操作数进行乘法,在目标操作数中生成 .f32x2 结果。
对于 .f32x2 指令类型,操作数 d、a 和 b 的类型为 .b64。
语义
if (type == f32 || type == f64) {
    d = a * b;
} else if (type == f32x2) {
    fA[0] = a[0:31];
    fA[1] = a[32:63];
    fB[0] = b[0:31];
    fB[1] = b[32:63];
    for (i = 0; i < 2; i++) {
        d[i] = fA[i] * fB[i];
    }
}
示例
mul.ftz.f32 circumf,radius,pi // a single-precision multiply
9.7.3.6. 浮点指令:fma#
fma
融合乘加。
语法
fma.rnd{.ftz}{.sat}.f32  d, a, b, c;
fma.rnd{.ftz}.f32x2      d, a, b, c;
fma.rnd.f64              d, a, b, c;
.rnd = { .rn, .rz, .rm, .rp };
说明
执行融合乘加,中间乘积和加法均不损失精度。
对于 .f32x2 指令类型,从源操作数中的单精度(.f32)值组成输入向量。然后并行处理单精度(.f32)操作数,在目标操作数中生成 .f32x2 结果。
对于 .f32x2 指令类型,操作数 d、a、b 和 c 的类型为 .b64。
语义
if (type == f32 || type == f64) {
    d = a * b + c;
} else if (type == f32x2) {
    fA[0] = a[0:31];
    fA[1] = a[32:63];
    fB[0] = b[0:31];
    fB[1] = b[32:63];
    fC[0] = c[0:31];
    fC[1] = c[32:63];
    for (i = 0; i < 2; i++) {
        d[i] = fA[i] * fB[i] + fC[i];
    }
}
示例
    fma.rn.ftz.f32  w,x,y,z;
@p  fma.rn.f64      d,a,b,c;
    fma.rp.ftz.f32x2 p,q,r,s;
9.7.3.7. 浮点指令:mad#
mad
将两个值相乘,再加上第三个值。
语法
mad{.ftz}{.sat}.f32      d, a, b, c;    // .target sm_1x
mad.rnd{.ftz}{.sat}.f32  d, a, b, c;    // .target sm_20
mad.rnd.f64              d, a, b, c;    // .target sm_13 and higher
.rnd = { .rn, .rz, .rm, .rp };
说明
将两个值相乘并加上第三个值,然后将结果写入目标寄存器。
语义
d = a*b + c;
示例
@p mad.f32 d,a,b,c;
9.7.3.8. 浮点指令:div#
div
将一个值除以另一个值。
语法
div.approx{.ftz}.f32  d, a, b;  // fast, approximate divide
div.full{.ftz}.f32    d, a, b;  // full-range approximate divide
div.rnd{.ftz}.f32     d, a, b;  // IEEE 754 compliant rounding
div.rnd.f64           d, a, b;  // IEEE 754 compliant rounding
.rnd = { .rn, .rz, .rm, .rp };
说明
用 b 除 a,并将结果存入 d。
语义
d = a / b;
快速的近似单精度除法:
div.approx.f32实现快速的近似除法,按d = a * (1/b)计算。当|b|位于 [2-126, 2126] 范围内时,最大ulp误差为 2。当 2126 <|b|< 2128 时,如果a为无穷大,div.approx.f32返回NaN;否则返回保留符号的零。div.full.f32实现相对快速的全范围近似除法,通过缩放操作数提高精度,但并不完全符合 IEEE 754,且不支持舍入修饰符。在整个输入范围内,最大ulp误差为 2。
符合 IEEE 754 舍入规则的除法:
舍入修饰符(无默认值):
.rn-
尾数最低有效位按就近偶数舍入
.rz-
尾数最低有效位向零舍入
.rm-
尾数最低有效位向负无穷大舍入
.rp-
尾数最低有效位向正无穷大舍入
次正规数:
sm_20+-
默认支持次正规数。
div.ftz.f32将次正规数输入和结果冲洗为保留符号的零。 sm_1x-
div.f64支持次正规数。div.f32将次正规数输入和结果冲洗为保留符号的零。
示例
div.approx.ftz.f32  diam,circum,3.14159;
div.full.ftz.f32    x, y, z;
div.rn.f64          xd, yd, zd;
9.7.3.9. 浮点指令:abs#
abs
绝对值。
语法
abs{.ftz}.f32  d, a;
abs.f64        d, a;
说明
取 a 的绝对值,并将结果存入 d。
语义
d = |a|;
示例
abs.ftz.f32 x,f0;
9.7.3.10. 浮点指令:neg#
neg
算术取负。
语法
neg{.ftz}.f32  d, a;
neg.f64        d, a;
说明
对 a 的符号取反,并将结果存入 d。
语义
d = -a;
示例
neg.ftz.f32 x,f0;
9.7.3.11. 浮点指令:min#
min
求给定值中的最小值。
语法
min{.ftz}{.NaN}{.xorsign.abs}.f32  d, a, b;
min{.ftz}{.NaN}{.abs}.f32          d, a, b, c;
min.f64                            d, a, b;
说明
将 a、b 以及可选的 c 中的最小值存入 d。
如果指定 .NaN 修饰符,且任一输入为 NaN,则结果为规范 NaN。
如果指定 .abs 修饰符,则目标操作数 d 的大小为输入参数绝对值中的最小值。
如果指定 .xorsign 修饰符,则目标操作数 d 的符号位等于两个输入 a 和 b 的符号位异或结果。三输入操作不能指定 .xorsign 限定符。
限定符 .xorsign 要求同时指定限定符 .abs。在这种情况下,.xorsign 会在应用 .abs 操作之前考虑两个输入的符号位。
如果 min 的结果为 NaN,则忽略 .xorsign 和 .abs 修饰符。
语义
def min_num (z, x, y) {
    if (isNaN(x) && isNaN(y))
        z = NaN;
    else if (isNaN(x))
        z = y;
    else if (isNaN(y))
        z = x;
    else
        // note: -0.0 < +0.0 here
        z = (x < y) ? x : y;
    return z;
}
def min_nan (z, x, y) {
if (isNaN(x) || isNaN(y))
z = NaN;
else
// note: -0.0 < +0.0 here
z = (x < y) ? x : y;
return z;
}
def two_inputs_min (z, x, y) {
if (.NaN)
z = min_nan(z, x, y);
else
z = min_num(z, x, y);
return z;
}
if (.xorsign && !isPresent(c)) {
xorsign = getSignBit(a) ^ getSignBit(b);
}
if (.abs) {
a = |a|;
b = |b|;
if (isPresent(c)) {
c = |c|;
}
}
d = two_inputs_min(d, a, b)
if (isPresent(c)) {
d = two_inputs_min(d, d, c)
}
if (.xorsign && !isPresent(c) && !isNaN(d)) {
setSignBit(d, xorsign);
}
示例
@p  min.ftz.f32  z,z,x;
    min.f64      a,b,c;
    // fp32 min with .NaN
    min.NaN.f32  f0,f1,f2;
    // fp32 min with .xorsign.abs
    min.xorsign.abs.f32 Rd, Ra, Rb;
9.7.3.12. 浮点指令:max#
max
求给定值中的最大值。
语法
max{.ftz}{.NaN}{.xorsign.abs}.f32  d, a, b;
max{.ftz}{.NaN}{.abs}.f32          d, a, b, c;
max.f64                            d, a, b;
说明
将 a、b 以及可选的 c 中的最大值存入 d。
如果指定 .NaN 修饰符,且任一输入为 NaN,则结果为规范 NaN。
如果指定 .abs 修饰符,则目标操作数 d 的大小为输入参数绝对值中的最大值。
如果指定 .xorsign 修饰符,则目标操作数 d 的符号位等于两个输入 a 和 b 的符号位异或结果。三输入操作不能指定 .xorsign 限定符。
限定符 .xorsign 要求同时指定限定符 .abs。在这种情况下,.xorsign 会在应用 .abs 操作之前考虑两个输入的符号位。
如果 max 的结果为 NaN,则忽略 .xorsign 和 .abs 修饰符。
语义
def max_num (z, x, y) {
    if (isNaN(x) && isNaN(y))
        z = NaN;
    else if (isNaN(x))
        z = y;
    else if (isNaN(y))
        z = x;
    else
        // note: +0.0 > -0.0 here
        z = (x > y) ? x : y;
    return z;
}
def max_nan (z, x, y) {
if (isNaN(x) || isNaN(y))
z = NaN;
else
// note: +0.0 > -0.0 here
z = (x > y) ? x : y;
return z;
}
def two_inputs_max (z, x, y) {
if (.NaN)
z = max_nan(z, x, y);
else
z = max_num(z, x, y);
return z;
}
if (.xorsign && !isPresent(c)) {
xorsign = getSignBit(a) ^ getSignBit(b);
}
if (.abs) {
a = |a|;
b = |b|;
if (isPresent(c)) {
c = |c|;
}
}
d = two_inputs_max (d, a, b)
if (isPresent(c)) {
d = two_inputs_max (d, d, c)
}
if (.xorsign && !isPresent(c) !isNaN(d)) {
setSignBit(d, xorsign);
}
示例
max.ftz.f32  f0,f1,f2;
max.f64      a,b,c;
// fp32 max with .NaN
max.NaN.f32  f0,f1,f2;
// fp32 max with .xorsign.abs
max.xorsign.abs.f32 Rd, Ra, Rb;
9.7.3.13. 浮点指令:rcp#
rcp
求一个值的倒数。
语法
rcp.approx{.ftz}.f32  d, a;  // fast, approximate reciprocal
rcp.rnd{.ftz}.f32     d, a;  // IEEE 754 compliant rounding
rcp.rnd.f64           d, a;  // IEEE 754 compliant rounding
.rnd = { .rn, .rz, .rm, .rp };
说明
计算 1/a,并将结果存入 d。
语义
d = 1 / a;
快速的近似单精度倒数:
rcp.approx.f32 实现快速的近似倒数。在整个输入范围内,最大 ulp 误差为 1。
输入 |
结果 |
|---|---|
-Inf |
-0.0 |
-0.0 |
-Inf |
+0.0 |
+Inf |
+Inf |
+0.0 |
NaN |
NaN |
符合 IEEE 754 舍入规则的倒数:
舍入修饰符(无默认值):
.rn-
尾数最低有效位按就近偶数舍入
.rz-
尾数最低有效位向零舍入
.rm-
尾数最低有效位向负无穷大舍入
.rp-
尾数最低有效位向正无穷大舍入
次正规数:
sm_20+-
默认支持次正规数。
rcp.ftz.f32将次正规数输入和结果冲洗为保留符号的零。 sm_1x-
rcp.f64支持次正规数。rcp.f32将次正规数输入和结果冲洗为保留符号的零。
示例
rcp.approx.ftz.f32  ri,r;
rcp.rn.ftz.f32      xi,x;
rcp.rn.f64          xi,x;
9.7.3.14. 浮点指令:rcp.approx.ftz.f64#
rcp.approx.ftz.f64
快速计算一个值倒数的粗略近似值。
语法
rcp.approx.ftz.f64 d, a;
说明
按以下步骤快速计算倒数的粗略近似值:
从
.f64操作数a中提取最高有效的 32 位,采用 1.11.20 IEEE 浮点格式(即忽略a的最低有效 32 位);使用操作数
a尾数的最高有效 20 位,计算该值的近似.f64倒数;将按 1.11.20 IEEE 浮点格式得到的 32 位结果放入目标操作数
d的最高有效 32 位;并且将
.f64目标操作数d的最低有效 32 个尾数位清零。
语义
tmp = a[63:32]; // upper word of a, 1.11.20 format
d[63:32] = 1.0 / tmp;
d[31:0] = 0x00000000;
示例
rcp.approx.ftz.f64 xi,x;
9.7.3.15. 浮点指令:sqrt#
sqrt
求一个值的平方根。
语法
sqrt.approx{.ftz}.f32  d, a; // fast, approximate square root
sqrt.rnd{.ftz}.f32     d, a; // IEEE 754 compliant rounding
sqrt.rnd.f64           d, a; // IEEE 754 compliant rounding
.rnd = { .rn, .rz, .rm, .rp };
说明
计算 sqrt(a),并将结果存入 d。
语义
d = sqrt(a);
符合 IEEE 754 舍入规则的平方根:
舍入修饰符(无默认值):
.rn-
尾数最低有效位按就近偶数舍入
.rz-
尾数最低有效位向零舍入
.rm-
尾数最低有效位向负无穷大舍入
.rp-
尾数最低有效位向正无穷大舍入
次正规数:
sm_20+-
默认支持次正规数。
sqrt.ftz.f32将次正规数输入和结果冲洗为保留符号的零。 sm_1x-
sqrt.f64支持次正规数。sqrt.f32将次正规数输入和结果冲洗为保留符号的零。
示例
sqrt.approx.ftz.f32  r,x;
sqrt.rn.ftz.f32      r,x;
sqrt.rn.f64          r,x;
9.7.3.16. 浮点指令:rsqrt#
rsqrt
求一个值平方根的倒数。
语法
rsqrt.approx{.ftz}.f32  d, a;
rsqrt.approx.f64        d, a;
说明
计算 1/sqrt(a),并将结果存入 d。
语义
d = 1/sqrt(a);
示例
rsqrt.approx.ftz.f32  isr, x;
rsqrt.approx.f64      ISR, X;
9.7.3.17. 浮点指令:rsqrt.approx.ftz.f64#
rsqrt.approx.ftz.f64
计算一个值倒数平方根的近似值。
语法
rsqrt.approx.ftz.f64 d, a;
说明
计算一个值倒数平方根的双精度(.f64)近似值。双精度(.f64)目标操作数 d 的最低有效 32 位全部为零。
语义
tmp = a[63:32]; // upper word of a, 1.11.20 format
d[63:32] = 1.0 / sqrt(tmp);
d[31:0] = 0x00000000;
示例
rsqrt.approx.ftz.f64 xi,x;
9.7.3.18. 浮点指令:sin#
sin
求一个值的正弦。
语法
sin.approx{.ftz}.f32 d, a;
说明
求角度 a(以弧度为单位)的正弦。
语义
d = sin(a);
示例
sin.approx.ftz.f32 sa, a;
9.7.3.19. 浮点指令:cos#
cos
求一个值的余弦。
语法
cos.approx{.ftz}.f32 d, a;
说明
求角度 a(以弧度为单位)的余弦。
语义
d = cos(a);
示例
cos.approx.ftz.f32 ca, a;
9.7.3.20. 浮点指令:lg2#
lg2
求一个值以 2 为底的对数。
语法
lg2.approx{.ftz}.f32 d, a;
说明
求 a 的以 2 为底的对数。
语义
d = log(a) / log(2);
示例
lg2.approx.ftz.f32 la, a;
9.7.3.21. 浮点指令:ex2#
ex2
求 2 的指定次幂。
语法
ex2.approx{.ftz}.f32 d, a;
说明
求 2 的 a 次幂。
语义
d = 2 ^ a;
示例
ex2.approx.ftz.f32 xa, a;
9.7.3.22. 浮点指令:tanh#
tanh
求一个值的双曲正切(以弧度为单位)。
语法
tanh.approx.f32 d, a;
说明
求 a 的双曲正切值。
操作数 d 和 a 的类型为 .f32。
语义
d = tanh(a);
示例
tanh.approx.f32 ta, a;
9.7.4. 半精度浮点指令#
半精度浮点指令作用于 .f16 和 .f16x2 寄存器操作数。半精度浮点指令包括:
addsubmulfmanegabsminmaxtanhex2
半精度 add、sub、mul 和 fma 支持将结果饱和到 [0.0, 1.0] 范围,其中 NaN 被冲洗为正零。半精度指令返回未指定的 NaN。
9.7.4.1. 半精度浮点指令:add#
add
将两个值相加。
语法
add{.rnd}{.ftz}{.sat}.f16   d, a, b;
add{.rnd}{.ftz}{.sat}.f16x2 d, a, b;
add{.rnd}.bf16   d, a, b;
add{.rnd}.bf16x2 d, a, b;
.rnd = { .rn };
说明
执行加法,并将结果写入目标寄存器。
对于 .f16x2 和 .bf16x2 指令类型,从源操作数的半字值组成输入向量。然后并行对各半字操作数执行加法,在目标操作数中生成 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d、a 和 b 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d、a 和 b 的类型为 .b32。对于 .bf16 指令类型,操作数 d、a 和 b 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == f16 || type == bf16) {
    d = a + b;
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = fA[i] + fB[i];
    }
}
示例
// scalar f16 additions
add.f16        d0, a0, b0;
add.rn.f16     d1, a1, b1;
add.bf16       bd0, ba0, bb0;
add.rn.bf16    bd1, ba1, bb1;
// SIMD f16 addition
cvt.rn.f16.f32 h0, f0;
cvt.rn.f16.f32 h1, f1;
cvt.rn.f16.f32 h2, f2;
cvt.rn.f16.f32 h3, f3;
mov.b32  p1, {h0, h1};   // pack two f16 to 32bit f16x2
mov.b32  p2, {h2, h3};   // pack two f16 to 32bit f16x2
add.f16x2  p3, p1, p2;   // SIMD f16x2 addition
// SIMD bf16 addition
cvt.rn.bf16x2.f32 p4, f4, f5; // Convert two f32 into packed bf16x2
cvt.rn.bf16x2.f32 p5, f6, f7; // Convert two f32 into packed bf16x2
add.bf16x2  p6, p4, p5;       // SIMD bf16x2 addition
// SIMD fp16 addition
ld.global.b32   f0, [addr];     // load 32 bit which hold packed f16x2
ld.global.b32   f1, [addr + 4]; // load 32 bit which hold packed f16x2
add.f16x2       f2, f0, f1;     // SIMD f16x2 addition
ld.global.b32   f3, [addr + 8];  // load 32 bit which hold packed bf16x2
ld.global.b32   f4, [addr + 12]; // load 32 bit which hold packed bf16x2
add.bf16x2      f5, f3, f4;      // SIMD bf16x2 addition
9.7.4.2. 半精度浮点指令:sub#
sub
从一个值中减去另一个值。
语法
sub{.rnd}{.ftz}{.sat}.f16   d, a, b;
sub{.rnd}{.ftz}{.sat}.f16x2 d, a, b;
sub{.rnd}.bf16   d, a, b;
sub{.rnd}.bf16x2 d, a, b;
.rnd = { .rn };
说明
执行减法,并将结果写入目标寄存器。
对于 .f16x2 和 .bf16x2 指令类型,从源操作数的半字值组成输入向量。然后并行对各半字操作数执行减法,在目标操作数中生成 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d、a 和 b 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d、a 和 b 的类型为 .b32。对于 .bf16 指令类型,操作数 d、a 和 b 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == f16 || type == bf16) {
    d = a - b;
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = fA[i] - fB[i];
    }
}
示例
// scalar f16 subtractions
sub.f16        d0, a0, b0;
sub.rn.f16     d1, a1, b1;
sub.bf16       bd0, ba0, bb0;
sub.rn.bf16    bd1, ba1, bb1;
// SIMD f16 subtraction
cvt.rn.f16.f32 h0, f0;
cvt.rn.f16.f32 h1, f1;
cvt.rn.f16.f32 h2, f2;
cvt.rn.f16.f32 h3, f3;
mov.b32  p1, {h0, h1};   // pack two f16 to 32bit f16x2
mov.b32  p2, {h2, h3};   // pack two f16 to 32bit f16x2
sub.f16x2  p3, p1, p2;   // SIMD f16x2 subtraction
// SIMD bf16 subtraction
cvt.rn.bf16x2.f32 p4, f4, f5; // Convert two f32 into packed bf16x2
cvt.rn.bf16x2.f32 p5, f6, f7; // Convert two f32 into packed bf16x2
sub.bf16x2  p6, p4, p5;       // SIMD bf16x2 subtraction
// SIMD fp16 subtraction
ld.global.b32   f0, [addr];     // load 32 bit which hold packed f16x2
ld.global.b32   f1, [addr + 4]; // load 32 bit which hold packed f16x2
sub.f16x2       f2, f0, f1;     // SIMD f16x2 subtraction
// SIMD bf16 subtraction
ld.global.b32   f3, [addr + 8];  // load 32 bit which hold packed bf16x2
ld.global.b32   f4, [addr + 12]; // load 32 bit which hold packed bf16x2
sub.bf16x2      f5, f3, f4;      // SIMD bf16x2 subtraction
9.7.4.3. 半精度浮点指令:mul#
mul
将两个值相乘。
语法
mul{.rnd}{.ftz}{.sat}.f16   d, a, b;
mul{.rnd}{.ftz}{.sat}.f16x2 d, a, b;
mul{.rnd}.bf16   d, a, b;
mul{.rnd}.bf16x2 d, a, b;
.rnd = { .rn };
说明
执行乘法,并将结果写入目标寄存器。
对于 .f16x2 和 .bf16x2 指令类型,从源操作数的半字值组成输入向量。然后并行对各半字操作数执行乘法,在目标操作数中生成 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d、a 和 b 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d、a 和 b 的类型为 .b32。对于 .bf16 指令类型,操作数 d、a 和 b 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d、a 和 b 的类型为 .b32。
语义
if (type == f16 || type == bf16) {
    d = a * b;
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = fA[i] * fB[i];
    }
}
示例
// scalar f16 multiplications
mul.f16        d0, a0, b0;
mul.rn.f16     d1, a1, b1;
mul.bf16       bd0, ba0, bb0;
mul.rn.bf16    bd1, ba1, bb1;
// SIMD f16 multiplication
cvt.rn.f16.f32 h0, f0;
cvt.rn.f16.f32 h1, f1;
cvt.rn.f16.f32 h2, f2;
cvt.rn.f16.f32 h3, f3;
mov.b32  p1, {h0, h1};   // pack two f16 to 32bit f16x2
mov.b32  p2, {h2, h3};   // pack two f16 to 32bit f16x2
mul.f16x2  p3, p1, p2;   // SIMD f16x2 multiplication
// SIMD bf16 multiplication
cvt.rn.bf16x2.f32 p4, f4, f5; // Convert two f32 into packed bf16x2
cvt.rn.bf16x2.f32 p5, f6, f7; // Convert two f32 into packed bf16x2
mul.bf16x2  p6, p4, p5;       // SIMD bf16x2 multiplication
// SIMD fp16 multiplication
ld.global.b32   f0, [addr];     // load 32 bit which hold packed f16x2
ld.global.b32   f1, [addr + 4]; // load 32 bit which hold packed f16x2
mul.f16x2       f2, f0, f1;     // SIMD f16x2 multiplication
// SIMD bf16 multiplication
ld.global.b32   f3, [addr + 8];  // load 32 bit which hold packed bf16x2
ld.global.b32   f4, [addr + 12]; // load 32 bit which hold packed bf16x2
mul.bf16x2      f5, f3, f4;      // SIMD bf16x2 multiplication
9.7.4.4. 半精度浮点指令:fma#
fma
融合乘加。
语法
fma.rnd{.ftz}{.sat}.f16     d, a, b, c;
fma.rnd{.ftz}{.sat}.f16x2   d, a, b, c;
fma.rnd{.ftz}.relu.f16      d, a, b, c;
fma.rnd{.ftz}.relu.f16x2    d, a, b, c;
fma.rnd{.relu}.bf16         d, a, b, c;
fma.rnd{.relu}.bf16x2       d, a, b, c;
fma.rnd.oob.{relu}.type     d, a, b, c;
.rnd = { .rn };
说明
执行融合乘加,中间乘积和加法均不损失精度。
对于 .f16x2 和 .bf16x2 指令类型,从源操作数的半字值组成输入向量。然后并行处理各半字操作数,在目标操作数中生成 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d、a、b 和 c 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d、a、b 和 c 的类型为 .b32。对于 .bf16 指令类型,操作数 d、a、b 和 c 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d、a、b 和 c 的类型为 .b32。
语义
if (type == f16 || type == bf16) {
    d = a * b + c;
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    fC[0] = c[0:15];
    fC[1] = c[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = fA[i] * fB[i] + fC[i];
    }
}
示例
// scalar f16 fused multiply-add
fma.rn.f16         d0, a0, b0, c0;
fma.rn.f16         d1, a1, b1, c1;
fma.rn.relu.f16    d1, a1, b1, c1;
fma.rn.oob.f16      d1, a1, b1, c1;
fma.rn.oob.relu.f16 d1, a1, b1, c1;
// scalar bf16 fused multiply-add
fma.rn.bf16        d1, a1, b1, c1;
fma.rn.relu.bf16   d1, a1, b1, c1;
fma.rn.oob.bf16       d1, a1, b1, c1;
fma.rn.oob.relu.bf16  d1, a1, b1, c1;
// SIMD f16 fused multiply-add
cvt.rn.f16.f32 h0, f0;
cvt.rn.f16.f32 h1, f1;
cvt.rn.f16.f32 h2, f2;
cvt.rn.f16.f32 h3, f3;
mov.b32  p1, {h0, h1}; // pack two f16 to 32bit f16x2
mov.b32  p2, {h2, h3}; // pack two f16 to 32bit f16x2
fma.rn.f16x2  p3, p1, p2, p2;   // SIMD f16x2 fused multiply-add
fma.rn.relu.f16x2  p3, p1, p2, p2; // SIMD f16x2 fused multiply-add with relu saturation mode
fma.rn.oob.f16x2  p3, p1, p2, p2; // SIMD f16x2 fused multiply-add with oob modifier
fma.rn.oob.relu.f16x2 p3, p1, p2, p2; // SIMD f16x2 fused multiply-add with oob modifier and relu saturation mode
// SIMD fp16 fused multiply-add
ld.global.b32   f0, [addr];     // load 32 bit which hold packed f16x2
ld.global.b32   f1, [addr + 4]; // load 32 bit which hold packed f16x2
fma.rn.f16x2    f2, f0, f1, f1; // SIMD f16x2 fused multiply-add
// SIMD bf16 fused multiply-add
fma.rn.bf16x2       f2, f0, f1, f1; // SIMD bf16x2 fused multiply-add
fma.rn.relu.bf16x2  f2, f0, f1, f1; // SIMD bf16x2 fused multiply-add with relu saturation mode
fma.rn.oob.bf16x2  f2, f0, f1, f1; // SIMD bf16x2 fused multiply-add with oob modifier
fma.rn.oob.relu.bf16x2  f2, f0, f1, f1; // SIMD bf16x2 fused multiply-add with oob modifier and relu saturation mode
9.7.4.5. 半精度浮点指令:neg#
neg
算术取负。
语法
neg{.ftz}.f16    d, a;
neg{.ftz}.f16x2  d, a;
neg.bf16         d, a;
neg.bf16x2       d, a;
说明
将 a 的符号取反,并将结果存入 d。
对于 .f16x2 和 .bf16x2 指令类型,通过从源操作数中提取半字值组成输入向量。然后并行地对各半字操作数取负,在目标操作数中生成 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d 和 a 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d 和 a 的类型为 .b32。对于 .bf16 指令类型,操作数 d 和 a 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d 和 a 的类型为 .b32。
语义
if (type == f16 || type == bf16) {
    d = -a;
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = -fA[i];
    }
}
示例
neg.ftz.f16  x,f0;
neg.bf16     x,b0;
neg.bf16x2   x1,b1;
9.7.4.6. 半精度浮点指令:abs#
abs
绝对值
语法
abs{.ftz}.f16    d, a;
abs{.ftz}.f16x2  d, a;
abs.bf16         d, a;
abs.bf16x2       d, a;
说明
取 a 的绝对值,并将结果存入 d。
对于 .f16x2 和 .bf16x2 指令类型,通过从源操作数中提取半字值组成输入向量。然后并行计算各半字操作数的绝对值,在目标操作数中生成 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d 和 a 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d 和 a 的类型为 .f16x2 或 .b32。对于 .bf16 指令类型,操作数 d 和 a 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d 和 a 的类型为 .b32。
语义
if (type == f16 || type == bf16) {
    d = |a|;
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = |fA[i]|;
    }
}
示例
abs.ftz.f16  x,f0;
abs.bf16     x,b0;
abs.bf16x2   x1,b1;
9.7.4.7. 半精度浮点指令:min#
min
求两个值的最小值。
语法
min{.ftz}{.NaN}{.xorsign.abs}.f16      d, a, b;
min{.ftz}{.NaN}{.xorsign.abs}.f16x2    d, a, b;
min{.NaN}{.xorsign.abs}.bf16           d, a, b;
min{.NaN}{.xorsign.abs}.bf16x2         d, a, b;
说明
将 a 和 b 中的最小值存入 d。
对于 .f16x2 和 .bf16x2 指令类型,由源操作数的半字值组成输入向量。然后并行处理各半字操作数,在目标操作数中存入 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d 和 a 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d 和 a 的类型为 .f16x2 或 .b32。对于 .bf16 指令类型,操作数 d 和 a 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d 和 a 的类型为 .b32。
如果指定了 .NaN 修饰符,那么当任一输入为 NaN 时,结果为规范 NaN。
如果指定了 .abs 修饰符,则目标操作数 d 的幅度为两个输入参数绝对值中的最小值。
如果指定了 .xorsign 修饰符,则目标操作数 d 的符号位等于两个输入符号位的异或。
修饰符 .abs 和 .xorsign 必须一起指定,并且 .xorsign 在应用 .abs 运算之前考虑两个输入的符号位。
如果 min 的结果为 NaN,则 .xorsign 和 .abs 修饰符将被忽略。
语义
if (type == f16 || type == bf16) {
    if (.xorsign) {
        xorsign = getSignBit(a) ^ getSignBit(b);
        if (.abs) {
            a = |a|;
            b = |b|;
        }
    }
    if (isNaN(a) && isNaN(b))              d = NaN;
    if (.NaN && (isNaN(a) || isNaN(b)))    d = NaN;
    else if (isNaN(a))                     d = b;
    else if (isNaN(b))                     d = a;
    else                                   d = (a < b) ? a : b;
    if (.xorsign && !isNaN(d)) {
         setSignBit(d, xorsign);
    }
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
        if (.xorsign) {
            xorsign = getSignBit(fA[i]) ^ getSignBit(fB[i]);
            if (.abs) {
               fA[i] = |fA[i]|;
               fB[i] = |fB[i]|;
           }
        }
        if (isNaN(fA[i]) && isNaN(fB[i]))              d[i] = NaN;
        if (.NaN && (isNaN(fA[i]) || isNaN(fB[i])))    d[i] = NaN;
        else if (isNaN(fA[i]))                         d[i] = fB[i];
        else if (isNaN(fB[i]))                         d[i] = fA[i];
        else                                           d[i] = (fA[i] < fB[i]) ? fA[i] : fB[i];
        if (.xorsign && !isNaN(d[i])) {
            setSignBit(d[i], xorsign);
        }
    }
}
示例
min.ftz.f16       h0,h1,h2;
min.f16x2         b0,b1,b2;
// SIMD fp16 min with .NaN
min.NaN.f16x2     b0,b1,b2;
min.bf16          h0, h1, h2;
// SIMD bf16 min with NaN
min.NaN.bf16x2    b0, b1, b2;
// scalar bf16 min with xorsign.abs
min.xorsign.abs.bf16 Rd, Ra, Rb
9.7.4.8. 半精度浮点指令:max#
max
求两个值的最大值。
语法
max{.ftz}{.NaN}{.xorsign.abs}.f16      d, a, b;
max{.ftz}{.NaN}{.xorsign.abs}.f16x2    d, a, b;
max{.NaN}{.xorsign.abs}.bf16           d, a, b;
max{.NaN}{.xorsign.abs}.bf16x2         d, a, b;
说明
将 a 和 b 中的最大值存入 d。
对于 .f16x2 和 .bf16x2 指令类型,由源操作数的半字值组成输入向量。然后并行处理各半字操作数,在目标操作数中存入 .f16x2 或 .bf16x2 结果。
对于 .f16 指令类型,操作数 d 和 a 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d 和 a 的类型为 .f16x2 或 .b32。对于 .bf16 指令类型,操作数 d 和 a 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d 和 a 的类型为 .b32。
如果指定了 .NaN 修饰符,那么当任一输入为 NaN 时,结果为规范 NaN。
如果指定了 .abs 修饰符,则目标操作数 d 的幅度为两个输入参数绝对值中的最大值。
如果指定了 .xorsign 修饰符,则目标操作数 d 的符号位等于两个输入符号位的异或。
修饰符 .abs 和 .xorsign 必须一起指定,并且 .xorsign 在应用 .abs 运算之前考虑两个输入的符号位。
如果 max 的结果为 NaN,则 .xorsign 和 .abs 修饰符将被忽略。
语义
if (type == f16 || type == bf16) {
    if (.xorsign) {
        xorsign = getSignBit(a) ^ getSignBit(b);
        if (.abs) {
            a = |a|;
            b = |b|;
        }
    }
    if (isNaN(a) && isNaN(b))              d = NaN;
    if (.NaN && (isNaN(a) || isNaN(b)))    d = NaN;
    else if (isNaN(a))                     d = b;
    else if (isNaN(b))                     d = a;
    else                                   d = (a > b) ? a : b;
    if (.xorsign && !isNaN(d)) {
         setSignBit(d, xorsign);
    }
} else if (type == f16x2 || type == bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
        if (.xorsign) {
            xorsign = getSignBit(fA[i]) ^ getSignBit(fB[i]);
            if (.abs) {
                fA[i] = |fA[i]|;
                fB[i] = |fB[i]|;
            }
        }
        if (isNaN(fA[i]) && isNaN(fB[i]))              d[i] = NaN;
        if (.NaN && (isNaN(fA[i]) || isNaN(fB[i])))    d[i] = NaN;
        else if (isNaN(fA[i]))                         d[i] = fB[i];
        else if (isNaN(fB[i]))                         d[i] = fA[i];
        else                                           d[i] = (fA[i] > fB[i]) ? fA[i] : fB[i];
        if (.xorsign && !isNaN(fA[i])) {
            setSignBit(d[i], xorsign);
        }
    }
}
示例
max.ftz.f16       h0,h1,h2;
max.f16x2         b0,b1,b2;
// SIMD fp16 max with NaN
max.NaN.f16x2     b0,b1,b2;
// scalar f16 max with xorsign.abs
max.xorsign.abs.f16 Rd, Ra, Rb;
max.bf16          h0, h1, h2;
// scalar bf16 max and NaN
max.NaN.bf16x2    b0, b1, b2;
// SIMD bf16 max with xorsign.abs
max.xorsign.abs.bf16x2 Rd, Ra, Rb;
9.7.4.9. 半精度浮点指令:tanh#
tanh
求某值(以弧度为单位)的双曲正切
语法
tanh.approx.type d, a;
.type = {.f16, .f16x2, .bf16, .bf16x2}
说明
取 a 的双曲正切值。
操作数 d 和 a 的类型由 .type 指定。
对于 .f16x2 或 .bf16x2 指令类型,各半字操作数并行运算,结果按相应方式打包为 .f16x2 或 .bf16x2。
对于 .f16 指令类型,操作数 d 和 a 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d 和 a 的类型为 .f16x2 或 .b32。对于 .bf16 指令类型,操作数 d 和 a 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d 和 a 的类型为 .b32。
语义
if (.type == .f16 || .type == .bf16) {
  d = tanh(a)
} else if (.type == .f16x2 || .type == .bf16x2) {
  fA[0] = a[0:15];
  fA[1] = a[16:31];
  d[0] = tanh(fA[0])
  d[1] = tanh(fA[1])
}
示例
tanh.approx.f16    h1, h0;
tanh.approx.f16x2  hd1, hd0;
tanh.approx.bf16   b1, b0;
tanh.approx.bf16x2 hb1, hb0;
9.7.4.10. 半精度浮点指令:ex2#
ex2
求输入的以 2 为底的指数。
语法
ex2.approx.atype     d, a;
ex2.approx.ftz.btype d, a;
.atype = { .f16,  .f16x2}
.btype = { .bf16, .bf16x2}
说明
求 2 的 a 次幂。
操作数 d 和 a 的类型由 .type 指定。
对于 .f16x2 或 .bf16x2 指令类型,各半字操作数并行运算,结果按相应方式打包为 .f16x2 或 .bf16x2。
对于 .f16 指令类型,操作数 d 和 a 的类型为 .f16 或 .b16。对于 .f16x2 指令类型,操作数 d 和 a 的类型为 .f16x2 或 .b32。对于 .bf16 指令类型,操作数 d 和 a 的类型为 .b16。对于 .bf16x2 指令类型,操作数 d 和 a 的类型为 .b32。
语义
if (.type == .f16 || .type == .bf16) {
  d = 2 ^ a
} else if (.type == .f16x2 || .type == .bf16x2) {
  fA[0] = a[0:15];
  fA[1] = a[16:31];
  d[0] = 2 ^ fA[0]
  d[1] = 2 ^ fA[1]
}
示例
ex2.approx.f16         h1, h0;
ex2.approx.f16x2       hd1, hd0;
ex2.approx.ftz.bf16    b1, b2;
ex2.approx.ftz.bf16x2  hb1, hb2;
9.7.5. 混合精度浮点指令#
混合精度浮点指令处理具有不同浮点精度的数据。在执行指定操作之前,需要先转换精度不同的操作数,使所有指令操作数都能以一致的浮点精度表示。用于保存特定操作数的寄存器变量取决于各指令类型的组合。关于给定数据类型应使用的具体寄存器操作数,请参见基本类型(Fundamental Types)和其他浮点数据格式(Alternate Floating-Point Data Formats)。
混合精度浮点指令包括:
addsubfmamul
混合精度的 add、sub 和 fma 支持将结果饱和到 [0.0, 1.0] 范围,NaN 会被冲洗为正零。
9.7.5.1. 混合精度浮点指令:add#
add
将两个值相加。
语法
add{.rnd}{.sat}.cdtype.atype  d, a, c;
add{.rnd}.dtype2.atype2.ctype2   d, a, c;
add.rz.ftz.dtype3.atype3.ctype2  d, a, c;
add.rz.dtype4.atype3.ctype2      d, a, c;
.atype = { .f16, .bf16 };
.cdtype = { .f32 };
.atype2 = { .f16x2, .bf16x2 };
.dtype2 = .ctype2 = .atype3 = { .f32x2 };
.dtype3 = { .f16x2 };
.dtype4 = { .bf16x2 };
.rnd   = { .rn, .rz, .rm, .rp };
说明
将输入操作数 a 和 c 转换为 cdtype/dtype,并执行加法。结果值存储在目标操作数 d 中。
语义
if (cdtype == .f32) {  // atype = .f16/.bf16, upconvert
    d = convert(a) + c;
} else if (dtype = .f32x2) {  // atype = .f16x2/.bf16x2, upconvert
    d[0:31] = convert(a[0:15]) + c[0:31];
    d[32:63] = convert(a[16:31]) + c[32:63];
} else if (dtype == .f16x2 || dtype == .bf16x2) { // atype = ctype = .f32x2, downconvert
    d[0:15] = convert(a[0:31] + c[0:31]);  // Apply rz for output
    d[16:31] = convert(a[32:63] + c[32:63]);  // Apply rz for output
}
示例
.reg .f32 fc, fd;
.reg .b16 ba;
add.rz.f32.bf16.sat   fd, fa, fc;
9.7.5.2. 混合精度浮点指令:sub#
sub
用一个值减去另一个值。
语法
sub{.rnd}{.sat}.cdtype.atype  d, a, c;
sub{.rnd}.dtype2.atype2.ctype2   d, a, c;
sub.rz.ftz.dtype3.atype3.ctype2  d, a, c;
sub.rz.dtype4.atype3.ctype2      d, a, c;
.atype = { .f16, .bf16 };
.rnd   = { .rn, .rz, .rm, .rp };
.cdtype = { .f32 };
.atype2 = { .f16x2, .bf16x2 };
.dtype2 = .ctype2 = .atype3 = { .f32x2 };
.dtype3 = { .f16x2 };
.dtype4 = { .bf16x2 };
说明
将输入操作数 a 和 c 转换为 cdtype/dtype,并执行减法。结果值存储在目标操作数 d 中。
语义
if (cdtype == .f32) {  // atype = .f16/.bf16, upconvert
    d = convert(a) - c;
} else if (dtype == .f32x2) {  // atype = .f16x2/.bf16x2, upconvert
    d[0:31]   = convert(a[0:15]) - c[0:31];
    d[32:63]  = convert(a[16:31]) - c[32:63];
} else if (dtype == .f16x2 || dtype == .bf16x2) { // atype = ctype = .f32x2, downconvert
    d[0:15]   = convert(a[0:31] - c[0:31]);   // Apply rz for output
    d[16:31]  = convert(a[32:63] - c[32:63]);  // Apply rz for output
}
示例
.reg .f32 fc, fd;
.reg .f16 ha;
sub.rz.f32.f16.sat   fd, ha, fc;
9.7.5.3. 混合精度浮点指令:fma#
fma
融合乘加。
语法
fma{.rnd}{.sat}.cdtype.abtype  d, a, b, c;
fma{.rnd}.dtype.atype.btype.ctype d, a, b, c;
.abtype = { .f16, .bf16 };
.cdtype = { .f32 };
.atype  = { .f16x2, .bf16x2 };
.btype  = .ctype = .dtype = { .f32x2 };
.rnd    = { .rn, .rz, .rm, .rp };
说明
将输入操作数 a、b 和 c 转换为 .cdtype/.dtype 类型。转换后的值用于执行融合乘加操作,中间乘积和加法过程均无精度损失。结果值存储在目标操作数 d 中。
语义
if (cdtype == .f32) {  // abtype = .f16/.bf16, upconvert
    d = convert(a) * convert(b) + c;
} else if (dtype == .f32x2) {  // atype = .f16x2/.bf16x2, upconvert
    d[0:31] = convert(a[0:15]) * convert(b[0:15]) + c[0:31];
    d[32:63] = convert(a[16:31]) * convert(b[16:31]) + c[32:63];
}
示例
.reg .f32 fc, fd;
.reg .f16 ha, hb;
fma.rz.sat.f32.f16.sat   fd, ha, hb, fc;
9.7.5.4. 混合精度浮点指令:mul#
mul
将两个值相乘。
语法
mul.ftz.rz.dtype1.atype1.ctype1 d, a, c;
mul.rz.dtype2.atype1.ctype1 d, a, c;
mul.dtype3.atype2.ctype2 d, a, c;
mul.dtype4.atype3.ctype3 d, a, c;
.dtype1 = { .f16x2 }
.dtype2 = { .bf16x2 }
.atype1 = .ctype1 = { .f32x2 }
.dtype3 = .atype2 = { .bf16x2 }
.ctype2 = { .f16x2 }
.dtype4 = .atype3 = { .f16x2 }
.ctype3 = { .bf16x2 }
说明
在对输入操作数 a 和 c 执行乘法的同时,将它们转换为 dtype。结果值存储在目标操作数 d 中。
语义
if (dtype == .f16x2 || dtype == .bf16x2) {
    if (atype/ctype == .f32x2) { // downconvert
        d[0:15] = convert(a[0:31] * c[0:31]); // Apply rz for output
        d[16:31] = convert(a[32:63] * c[32:63]); // Apply rz for output
    } else if (atype/ctype == .f16x2 || atype/ctype == .bf16x2) { // convert to dtype
        d[0:15] = a[0:15] * convert(c[0:15]);
        d[16:31] = a[16:31] * convert(c[16:31]);
    }
}
示例
.reg .f16x2 rd;
.reg .f32x2 ra, rc;
mul.ftz.rz.f16x2.f32x2.f32x2 rd, ra, rc;
9.7.6. 其他浮点指令#
其他浮点指令处理 FP8、FP6、FP4 数据类型。此类指令使用的寄存器变量因数据类型而异。关于受支持的数据类型及其寄存器表示,请参见打包浮点类型(Packed Floating Point Data Types)。
其他浮点指令包括:
addsubmulfma
9.7.6.1. 其他浮点指令:add#
add
将两个值相加。
语法
add{.rnd}{.satfinite}.cdtype.atype  d, a, c;
.cdtype = { .e5m2x4, .e4m3x4 };
.atype  = { .e5m2x4, .e4m3x4, .e3m2x4, .e2m3x4, .e2m1x4, .e2m1p4x4, .ue8m0x4 };
.rnd    = { .rn };
说明
执行加法,并将结果值写入目标寄存器。
首先从打包的源操作数中提取四个指定类型的值,构成输入向量。随后以无限精度并行地对这些输入向量执行加法。最后使用 .rnd 指定的舍入模式将结果值舍入到目标类型。
操作数 d 和 c 的类型必须为 .b32。当 .atype 为 .e2m1x4 时,操作数 a 的类型必须为 .b16;否则操作数 a 的类型必须为 .b32。
语义
if (isF8x4(atype) || isUE8M0x4(atype)) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
} else if (isF6x4(atype)) {
    iA[0] = a[0:5];
    iA[1] = a[8:13];
    iA[2] = a[16:21];
    iA[3] = a[24:29];
} else if (isE2M1P4x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[8:11];
    iA[2] = a[16:19];
    iA[3] = a[24:27];
} else if (isE2M1x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[4:7];
    iA[2] = a[8:11];
    iA[3] = a[12:15];
}
iC[0] = c[0:7];
iC[1] = c[8:15];
iC[2] = c[16:23];
iC[3] = c[24:31];
for (i = 0; i < 4; i++) {
d[i] = iA[i] + iC[i];
}
示例
.reg .b32 rd, ra, rc;
// f8x4 addition
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four f8 as f8x4
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
add.rn.e5m2x4.e4m3x4.satfinite   rd, ra, rc;   // SIMD addition
// f4x4 and f8x4 addition
.reg .b16 ra16;
mov.b16 ra16, {ba0, ba1};         // pack four f4 as f4x4 in b16 operand
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
add.rn.e4m3x4.e2m1x4 rd, ra16, rc; // SIMD addition
// f4x4 (padded) and f8x4 addition
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four f4 as f4x4 in b32. Each f4 resides within lower half of a byte
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
add.rn.e4m3x4.e2m1p4x4 rd, ra, rc;
9.7.6.2. 其他浮点指令:sub#
sub
用一个值减去另一个值。
语法
sub{.rnd}{.satfinite}.cdtype.atype  d, a, c;
.cdtype = { .e5m2x4, .e4m3x4 };
.atype  = { .e5m2x4, .e4m3x4, .e3m2x4, .e2m3x4, .e2m1x4, .e2m1p4x4, .ue8m0x4 };
.rnd    = { .rn };
说明
执行减法,并将结果值写入目标寄存器。
首先从打包的源操作数中提取四个指定类型的值,构成输入向量。随后以无限精度并行地对这些输入向量执行减法。最后使用 .rnd 指定的舍入模式将结果值舍入到目标类型。
操作数 d 和 c 的类型必须为 .b32。当 .atype 为 .e2m1x4 时,操作数 a 的类型必须为 .b16;否则操作数 a 的类型必须为 .b32。
语义
if (isF8x4(atype) || isUE8M0x4(atype)) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
} else if (isF6x4(atype)) {
    iA[0] = a[0:5];
    iA[1] = a[8:13];
    iA[2] = a[16:21];
    iA[3] = a[24:29];
} else if (isE2M1P4x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[8:11];
    iA[2] = a[16:19];
    iA[3] = a[24:27];
} else if (isE2M1x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[4:7];
    iA[2] = a[8:11];
    iA[3] = a[12:15];
}
iC[0] = c[0:7];
iC[1] = c[8:15];
iC[2] = c[16:23];
iC[3] = c[24:31];
for (i = 0; i < 4; i++) {
d[i] = iA[i] - iC[i];
}
示例
.reg .b32 rd, ra, rc;
// subtraction of f8x4 from ue8m0x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four ue8m0 values
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
sub.rn.e5m2x4.ue8m0x4.satfinite rd, ra, rc;
// subtraction of f6x4 from f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four f6 as f6x4
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
sub.rn.e5m2x4.e2m3x4.satfinite   rd, ra, rc; // SIMD subtraction
// subtraction of f8x4 from f4x4
.reg .b16 ra16;
mov.b16 ra16, {ba0, ba1};         // pack four f4 as f4x4 in b16 operand
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
sub.rn.e4m3x4.e2m1x4 rd, ra16, rc; // SIMD subtraction
9.7.6.3. 其他浮点指令:mul#
mul
将两个值相乘。
语法
mul{.rnd}{.satfinite}.dtype.atype.ctype  d, a, c;
.dtype  = { .e5m2x4, .e4m3x4 };
.atype  = .ctype = { .e5m2x4, .e4m3x4, .e3m2x4, .e2m3x4, .e2m1x4, .e2m1p4x4, .ue8m0x4 };
.rnd    = { .rn };
说明
执行乘法,并将结果值写入目标寄存器。
首先从打包的源操作数中提取四个指定类型的值,构成输入向量。随后以无限精度并行地对这些输入向量执行乘法。最后使用 .rnd 指定的舍入模式将结果值舍入到目标类型。
操作数 d 的类型必须为 .b32。当 .atype 为 .e2m1x4 时,操作数 a 的类型必须为 .b16;否则操作数 a 的类型必须为 .b32。同样,当 .ctype 为 .e2m1x4 时,操作数 c 的类型必须为 .b16;否则其类型必须为 .b32。
语义
if (isF8x4(atype) || isUE8M0x4(atype)) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
} else if (isF6x4(atype)) {
    iA[0] = a[0:5];
    iA[1] = a[8:13];
    iA[2] = a[16:21];
    iA[3] = a[24:29];
} else if (isE2M1P4x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[8:11];
    iA[2] = a[16:19];
    iA[3] = a[24:27];
} else if (isE2M1x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[4:7];
    iA[2] = a[8:11];
    iA[3] = a[12:15];
}
if (isF8x4(ctype) || isUE8M0x4(ctype)) {
iC[0] = c[0:7];
iC[1] = c[8:15];
iC[2] = c[16:23];
iC[3] = c[24:31];
} else if (isF6x4(ctype)) {
iC[0] = c[0:5];
iC[1] = c[8:13];
iC[2] = c[16:21];
iC[3] = c[24:29];
} else if (isE2M1P4x4(ctype)) {
iC[0] = c[0:3];
iC[1] = c[8:11];
iC[2] = c[16:19];
iC[3] = c[24:27];
} else if (isE2M1x4(ctype)) {
iC[0] = c[0:3];
iC[1] = c[4:7];
iC[2] = c[8:11];
iC[3] = c[12:15];
}
for (i = 0; i < 4; i++) {
d[i] = iA[i] * iC[i];
}
示例
.reg .b32 rd, ra, rc;
// multiplication of f6x4 with f4x4 to obtain f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four f6 as f6x4
.reg .b16 rc16;
mov.b16 rc16, {bc0, bc1};         // pack four f4 as f4x4 in .b16 operand
mul.rn.e5m2x4.e3m2x4.e2m1x4.satfinite rd, ra, rc16; // SIMD multiplication
// multiplication of ue8m0x4 with f8x4 to obtain f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four ue8m0 values
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f8 as f8x4
mul.rn.e4m3x4.ue8m0x4.e5m2x4 rd, ra, rc; // SIMD multiplication
// multiplication of f6x4 with f6x4 to obtain f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four f6 as f6x4
mov.b32 rc, {bc0, bc1, bc2, bc3}; // pack four f6 as f6x4
mul.rn.e5m2x4.e3m2x4.e2m3x4.satfinite rd, ra, rc; // SIMD multiplication
9.7.6.4. 其他浮点指令:fma#
fma
融合乘加。
语法
fma{.rnd}{.satfinite}.cdtype.atype.btype  d, a, b, c;
.cdtype = { .e5m2x4, .e4m3x4 };
.atype  = .btype = { .e5m2x4, .e4m3x4, .e3m2x4, .e2m3x4, .e2m1x4, .e2m1p4x4, .ue8m0x4 };
.rnd    = { .rn };
说明
执行融合乘加操作,中间乘积和加法过程均无精度损失。
首先从打包的源操作数中提取四个指定类型的值,构成输入向量。随后以无限精度并行处理这些输入向量。最后使用 .rnd 指定的舍入模式将结果值舍入到目标类型。
操作数 d 和 c 的类型必须为 .b32。当 .atype 为 .e2m1x4 时,操作数 a 的类型必须为 .b16;否则操作数 a 的类型必须为 .b32。同样,当 .btype 为 .e2m1x4 时,操作数 b 的类型必须为 .b16;否则其类型必须为 .b32。
语义
if (isF8x4(atype) || isUE8M0x4(atype)) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
} else if (isF6x4(atype)) {
    iA[0] = a[0:5];
    iA[1] = a[8:13];
    iA[2] = a[16:21];
    iA[3] = a[24:29];
} else if (isE2M1P4x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[8:11];
    iA[2] = a[16:19];
    iA[3] = a[24:27];
} else if (isE2M1x4(atype)) {
    iA[0] = a[0:3];
    iA[1] = a[4:7];
    iA[2] = a[8:11];
    iA[3] = a[12:15];
}
if (isF8x4(btype) || isUE8M0x4(btype)) {
iB[0] = b[0:7];
iB[1] = b[8:15];
iB[2] = b[16:23];
iB[3] = b[24:31];
} else if (isF6x4(btype)) {
iB[0] = b[0:5];
iB[1] = b[8:13];
iB[2] = b[16:21];
iB[3] = b[24:29];
} else if (isE2M1P4x4(btype)) {
iB[0] = b[0:3];
iB[1] = b[8:11];
iB[2] = b[16:19];
iB[3] = b[24:27];
} else if (isE2M1x4(btype)) {
iB[0] = b[0:3];
iB[1] = b[4:7];
iB[2] = b[8:11];
iB[3] = b[12:15];
}
iC[0] = c[0:7];
iC[1] = c[8:15];
iC[2] = c[16:23];
iC[3] = c[24:31];
for (i = 0; i < 4; i++) {
d[i] = iA[i] * iB[i] + iC[i];
}
示例
.reg .b32 rd, ra, rb, rc;
// multiply ue8m0x4 with f4x4 and add f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3};   // pack four ue8m0
mov.b32 rb, {bb0, bb1, ba2, ba3};   // pack four f4 as f4x4 in b32 operand. Each f4 resides within lower half of a byte.
mov.b32 rc, {ba0, ba1, ba2, ba3};   // pack four f8 as f8x4
fma.rn.e5m2x4.ue8m0x4.e2m1p4x4.satfinite rd, ra, rb, rc;
// multiply f6x4 with f4x4 and add f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four f6 as f6x4
.reg .b16 rb16;
mov.b16 rb16, {bb0, bb1};         // pack four f4 as f4x4 in .b16 operand
mov.b32 rc, {ba0, ba1, ba2, ba3}; // pack four f8 as f8x4
fma.rn.e4m3x4.e3m2x4.e2m1x4.satfinite rd, ra, rb16, rc; // SIMD fused-multiply-add
// multiply ue8m0x4 with f8x4 and add f8x4
mov.b32 ra, {ba0, ba1, ba2, ba3}; // pack four ue8m0 values
mov.b32 rb, {bb0, bb1, bb2, bb3}; // pack four f8 as f8x4
mov.b32 rc, {ba0, ba1, ba2, ba3}; // pack four f8 as f8x4
fma.rn.e4m3x4.ue8m0x4.e5m2x4 rd, ra, rb, rc; // SIMD fused-multiply-add
9.7.7. 比较和选择指令#
比较和选择指令包括:
setsetpselpslct
与单精度浮点指令一样,set、setp 和 slct 指令在 sm_20 及更高目标架构上支持次正规数,并在 sm_1x 目标架构上将单精度次正规数输入冲洗为保留符号的零。可选的 .ftz 修饰符无论目标架构为何,都会将次正规数输入和结果冲洗为保留符号的零,从而向后兼容 sm_1x 目标架构。
9.7.7.1. 比较和选择指令:set#
set
使用关系运算符比较两个数值,并可通过施加布尔运算选择性地将该结果与一个谓词值组合。
语法
set.CmpOp{.ftz}.dtype.stype         d, a, b;
set.CmpOp.BoolOp{.ftz}.dtype.stype  d, a, b, {!}c;
.CmpOp  = { eq, ne, lt, le, gt, ge, lo, ls, hi, hs,
equ, neu, ltu, leu, gtu, geu, num, nan };
.BoolOp = { and, or, xor };
.dtype  = { .u32, .s32, .f32 };
.stype  = { .b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64,
.f32, .f64 };
set.CmpOp.type                      d, a, b;
.CmpOp = { eq, ne, lt, le, gt, ge, lo, ls, hi, hs};
.type  = { .u8x4, .s8x4, .u16x2, .s16x2 };
说明
比较两个数值,并可通过施加布尔运算选择性地将该结果与另一个谓词值组合。如果该结果为 True,则对浮点目标类型写入 1.0f,对整数目标类型写入 0xffffffff;否则写入 0x00000000。
对于 .u16x2、.s16x2 指令类型,使用源操作数中的半字值组成输入向量,然后并行地比较各半字操作数。如果结果为 True,则在对应于输入半字值的位位置上向目标寄存器写入 0xffff;否则写入 0x0000。此时所有操作数必须为 .b32 类型。
对于 .u8x4、.s8x4 指令类型,使用源操作数中的四分之一字值组成输入向量,然后并行地比较各四分之一字操作数。如果结果为 True,则在对应于输入四分之一字值的位位置上向目标寄存器写入 0xff;否则写入 0x00。此时所有操作数必须为 .b32 类型。
操作数 d 的类型为 .dtype;操作数 a 和 b 的类型为 .stype;操作数 c 的类型为 .pred。
语义
if (type == u16x2 || type == s16x2) {
    iA[0] = a[0:15];
    iA[1] = a[16:31];
    iB[0] = b[0:15];
    iB[1] = b[16:31];
    for (i = 0; i < 2; i++) {
         d[i] = (iA[i] CmpOp iB[i]) ? 0xffff : 0x0000;
    }
} else if (type == u8x4 || type == s8x4) {
    iA[0] = a[0:7];
    iA[1] = a[8:15];
    iA[2] = a[16:23];
    iA[3] = a[24:31];
    iB[0] = b[0:7];
    iB[1] = b[8:15];
    iB[2] = b[16:23];
    iB[3] = b[24:31];
    for (i = 0; i < 4; i++) {
         d[i] = (iA[i] CmpOp iB[i]) ? 0xff : 0x00;
    }
} else {
    t = (a CmpOp b) ? 1 : 0;
    if (isFloat(dtype))
        d = BoolOp(t, c) ? 1.0f : 0x00000000;
    else
        d = BoolOp(t, c) ? 0xffffffff : 0x00000000;
}
示例
@p  set.lt.and.f32.s32  d,a,b,r;
    set.eq.u32.u32      d,i,n;
    set.ge.s16x2        bd, ba, bb;
9.7.7.2. 比较和选择指令:setp#
setp
使用关系运算符比较两个数值,并(可选择性地)通过施加布尔运算将该结果与一个谓词值组合。
语法
setp.CmpOp{.ftz}.type         p[|q], a, b;
setp.CmpOp.BoolOp{.ftz}.type  p[|q], a, b, {!}c;
.CmpOp  = { eq, ne, lt, le, gt, ge, lo, ls, hi, hs,
equ, neu, ltu, leu, gtu, geu, num, nan };
.BoolOp = { and, or, xor };
.type   = { .b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64,
.f32, .f64 };
说明
比较两个值,并通过施加布尔运算将该结果与另一个谓词值组合。该结果写入第一个目标操作数。利用比较结果的取反值计算得到的相关值写入第二个目标操作数。
适用于所有数值类型。操作数 a 和 b 的类型为 .type;操作数 p、q 和 c 的类型为 .pred。任一目标操作数均可用汇聚符号 ‘_’ 代替。
语义
t = (a CmpOp b) ? 1 : 0;
p = BoolOp(t, c);
q = BoolOp(!t, c);
示例
    setp.lt.and.s32  p|q,a,b,r;
@q  setp.eq.u32      p,i,n;
9.7.7.3. 比较和选择指令:selp#
selp
根据谓词源操作数的值,在源操作数之间进行选择。
语法
selp.type d, a, b, c;
.type = { .b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64,
.f32, .f64 };
说明
条件选择。如果 c 为 True,则将 a 存入 d;否则存入 b。操作数 d、a 和 b 必须为相同类型。操作数 c 是一个谓词。
语义
d = (c == 1) ? a : b;
示例
    selp.s32  r0,r,g,p;
@q  selp.f32  f0,t,x,xp;
9.7.7.4. 比较和选择指令:slct#
slct
根据第三个操作数的符号选择一个源操作数。
语法
slct.dtype.s32        d, a, b, c;
slct{.ftz}.dtype.f32  d, a, b, c;
.dtype = { .b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64,
.f32, .f64 };
说明
条件选择。如果 c >= 0,则将 a 存入 d;否则将 b 存入 d。操作数 d、a 和 b 被视为与第一个指令类型宽度相同的位宽类型;操作数 c 必须与第二个指令类型(.s32 或 .f32)匹配。所选输入未经修改地复制到输出。
语义
d = (c >= 0) ? a : b;
示例
slct.u32.s32  x, y, z, val;
slct.ftz.u64.f32  A, B, C, fval;
9.7.8. 半精度比较指令#
比较指令包括:
setsetp
9.7.8.1. 半精度比较指令:set#
set
使用关系运算符比较两个数值,并可通过施加布尔运算选择性地将该结果与一个谓词值组合。
语法
set.CmpOp{.ftz}.f16.stype            d, a, b;
set.CmpOp.BoolOp{.ftz}.f16.stype     d, a, b, {!}c;
set.CmpOp.bf16.stype                 d, a, b;
set.CmpOp.BoolOp.bf16.stype          d, a, b, {!}c;
set.CmpOp{.ftz}.dtype.f16            d, a, b;
set.CmpOp.BoolOp{.ftz}.dtype.f16     d, a, b, {!}c;
.dtype  = { .u16, .s16, .u32, .s32}
set.CmpOp.dtype.bf16                 d, a, b;
set.CmpOp.BoolOp.dtype.bf16          d, a, b, {!}c;
.dtype  = { .u16, .s16, .u32, .s32}
set.CmpOp{.ftz}.dtype.f16x2          d, a, b;
set.CmpOp.BoolOp{.ftz}.dtype.f16x2   d, a, b, {!}c;
.dtype  = { .f16x2, .u32, .s32}
set.CmpOp.dtype.bf16x2               d, a, b;
set.CmpOp.BoolOp.dtype.bf16x2        d, a, b, {!}c;
.dtype  = { .bf16x2, .u32, .s32}
.CmpOp  = { eq, ne, lt, le, gt, ge,
equ, neu, ltu, leu, gtu, geu, num, nan };
.BoolOp = { and, or, xor };
.stype  = { .b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64,
.f16, .f32, .f64};
说明
比较两个数值,并可通过施加布尔运算选择性地将该结果与另一个谓词值组合。
该计算结果按如下方式写入目标寄存器:
-
如果结果为
True,对目标类型
.u32/.s32写入0xffffffff。对目标类型
.u16/.s16写入0xffff。对目标类型
.f16、.bf16以目标精度的浮点格式写入1.0。
-
如果结果为
False,对所有整数目标类型写入
0x0。对目标类型
.f16、.bf16以目标精度的浮点格式写入0.0。
如果源类型为 .f16x2 或 .bf16x2,则各单独操作的结果以打包形式存入 32 位目标操作数中。
操作数 c 的类型为 .pred。
语义
if (stype == .f16x2 || stype == .bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    t[0]   = (fA[0] CmpOp fB[0]) ? 1 : 0;
    t[1]   = (fA[1] CmpOp fB[1]) ? 1 : 0;
    if (dtype == .f16x2 || stype == .bf16x2) {
        for (i = 0; i < 2; i++) {
            d[i] = BoolOp(t[i], c) ? 1.0 : 0.0;
        }
    } else {
        for (i = 0; i < 2; i++) {
            d[i] = BoolOp(t[i], c) ? 0xffff : 0;
        }
    }
} else if (dtype == .f16 || stype == .bf16) {
    t = (a CmpOp b) ? 1 : 0;
    d = BoolOp(t, c) ? 1.0 : 0.0;
} else  { // Integer destination type
    trueVal = (isU16(dtype) || isS16(dtype)) ?  0xffff : 0xffffffff;
    t = (a CmpOp b) ? 1 : 0;
    d = BoolOp(t, c) ? trueVal : 0;
}
示例
set.lt.and.f16.f16  d,a,b,r;
set.eq.f16x2.f16x2  d,i,n;
set.eq.u32.f16x2    d,i,n;
set.lt.and.u16.f16  d,a,b,r;
set.ltu.or.bf16.f16    d,u,v,s;
set.equ.bf16x2.bf16x2  d,j,m;
set.geu.s32.bf16x2     d,j,m;
set.num.xor.s32.bf16   d,u,v,s;
9.7.8.2. 半精度比较指令:setp#
setp
使用关系运算符比较两个数值,并可通过施加布尔运算选择性地将该结果与一个谓词值组合。
语法
setp.CmpOp{.ftz}.f16           p, a, b;
setp.CmpOp.BoolOp{.ftz}.f16    p, a, b, {!}c;
setp.CmpOp{.ftz}.f16x2         p|q, a, b;
setp.CmpOp.BoolOp{.ftz}.f16x2  p|q, a, b, {!}c;
setp.CmpOp.bf16                p, a, b;
setp.CmpOp.BoolOp.bf16         p, a, b, {!}c;
setp.CmpOp.bf16x2              p|q, a, b;
setp.CmpOp.BoolOp.bf16x2       p|q, a, b, {!}c;
.CmpOp  = { eq, ne, lt, le, gt, ge,
equ, neu, ltu, leu, gtu, geu, num, nan };
.BoolOp = { and, or, xor };
说明
比较两个值,并通过施加布尔运算将该结果与另一个谓词值组合。该结果写入目标操作数。
操作数 c、p 和 q 的类型为 .pred。
对于指令类型 .f16,操作数 a 和 b 的类型为 .b16 或 .f16。
对于指令类型 .f16x2,操作数 a 和 b 的类型为 .b32。
对于指令类型 .bf16,操作数 a 和 b 的类型为 .b16。
对于指令类型 .bf16x2,操作数 a 和 b 的类型为 .b32。
语义
if (type == .f16 || type == .bf16) {
     t = (a CmpOp b) ? 1 : 0;
     p = BoolOp(t, c);
} else if (type == .f16x2 || type == .bf16x2) {
    fA[0] = a[0:15];
    fA[1] = a[16:31];
    fB[0] = b[0:15];
    fB[1] = b[16:31];
    t[0] = (fA[0] CmpOp fB[0]) ? 1 : 0;
    t[1] = (fA[1] CmpOp fB[1]) ? 1 : 0;
    p = BoolOp(t[0], c);
    q = BoolOp(t[1], c);
}
示例
setp.lt.and.f16x2  p|q,a,b,r;
@q  setp.eq.f16    p,i,n;
setp.gt.or.bf16x2  u|v,c,d,s;
@q  setp.eq.bf16   u,j,m;
9.7.9. 逻辑与移位指令#
逻辑与移位指令本质上是无类型的,可对任意类型的操作数执行按位运算,只要这些操作数大小相同。这使得无需为访问位而定义联合体即可对浮点值执行按位运算。指令 and、
or、xor 和 not 也可作用于谓词。
逻辑与移位指令包括:
andorxornotcnotlop3shfshlshr
9.7.9.1. 逻辑与移位指令:and#
and
按位与。
语法
and.type d, a, b;
.type = { .pred, .b16, .b32, .b64 };
说明
对 a 和 b 中的位执行按位与运算。
语义
d = a & b;
示例
and.b32  x,q,r;
and.b32  sign,fpvalue,0x80000000;
9.7.9.2. 逻辑与移位指令:or#
or
按位或。
语法
or.type d, a, b;
.type = { .pred, .b16, .b32, .b64 };
说明
对 a 和 b 中的位执行按位或运算。
语义
d = a | b;
示例
or.b32  mask mask,0x00010001
or.pred  p,q,r;
9.7.9.3. 逻辑与移位指令:xor#
xor
按位异或(不等)。
语法
xor.type d, a, b;
.type = { .pred, .b16, .b32, .b64 };
说明
对 a 和 b 中的位执行按位异或运算。
语义
d = a ^ b;
示例
xor.b32  d,q,r;
xor.b16  d,x,0x0001;
9.7.9.4. 逻辑与移位指令:not#
not
按位取反;反码。
语法
not.type d, a;
.type = { .pred, .b16, .b32, .b64 };
说明
对 a 中的位取反。
语义
d = ~a;
示例
not.b32  mask,mask;
not.pred  p,q;
9.7.9.5. 逻辑与移位指令:cnot#
cnot
C/C++ 风格的逻辑非。
语法
cnot.type d, a;
.type = { .b16, .b32, .b64 };
说明
使用 C/C++ 语义计算逻辑非。
语义
d = (a==0) ? 1 : 0;
示例
cnot.b32 d,a;
9.7.9.6. 逻辑与移位指令:lop3#
lop3
对 3 个输入执行任意逻辑运算。
语法
lop3.b32 d, a, b, c, immLut;
lop3.BoolOp.b32 d|p, a, b, c, immLut, q;
.BoolOp   = { .or , .and };
说明
对输入 a、b、c 执行按位逻辑运算,并将结果存入目标
d。
可选择指定 .BoolOp,通过按如下方式对目标操作数 d 与谓词 q 执行布尔运算来计算谓词结果 p:
p = (d != 0) BoolOp q;
指定 .BoolOp 限定符时,可用汇聚符号 ‘_’ 代替目标操作数 d。
该逻辑运算由查找表定义;对于 3 个输入,如下文所述,该表可表示为由操作数 immLut 指定的 8 位值。immLut 是取值范围为 0 到 255 的整数常量,
因此可对输入 a、b、c 支持多达 256 种不同的逻辑运算。
对于逻辑运算 F(a, b, c),可通过将同一运算应用于三个预定义常量值来计算 immLut 的值,如下所示:
ta = 0xF0;
tb = 0xCC;
tc = 0xAA;
immLut = F(ta, tb, tc);
示例:
If F = (a & b & c);
immLut = 0xF0 & 0xCC & 0xAA = 0x80
If F = (a | b | c);
immLut = 0xF0 | 0xCC | 0xAA = 0xFE
If F = (a & b & ~c);
immLut = 0xF0 & 0xCC & (~0xAA) = 0x40
If F = ((a & b | c) ^ a);
immLut = (0xF0 & 0xCC | 0xAA) ^ 0xF0 = 0x1A
下表展示了各种逻辑运算的 immLut 计算方式:
ta |
tb |
tc |
运算 0(False) |
运算 1 (ta & tb & tc) |
运算 2 (ta & tb & ~tc) |
… |
运算 254 (ta | tb | tc) |
运算 255(True) |
|---|---|---|---|---|---|---|---|---|
0 |
0 |
0 |
0 |
0 |
0 |
… |
0 |
1 |
0 |
0 |
1 |
0 |
0 |
0 |
1 |
1 |
|
0 |
1 |
0 |
0 |
0 |
0 |
1 |
1 |
|
0 |
1 |
1 |
0 |
0 |
0 |
1 |
1 |
|
1 |
0 |
0 |
0 |
0 |
0 |
1 |
1 |
|
1 |
0 |
1 |
0 |
0 |
0 |
1 |
1 |
|
1 |
1 |
0 |
0 |
0 |
1 |
1 |
1 |
|
1 |
1 |
1 |
0 |
1 |
0 |
1 |
1 |
|
immLut |
0x0 |
0x80 |
0x40 |
… |
0xFE |
0xFF |
||
语义
F = GetFunctionFromTable(immLut); // returns the function corresponding to immLut value
d = F(a, b, c);
if (BoolOp specified) {
    p = (d != 0) BoolOp q;
}
示例
lop3.b32       d, a, b, c, 0x40;
lop3.or.b32  d|p, a, b, c, 0x3f, q;
lop3.and.b32 _|p, a, b, c, 0x3f, q;
9.7.9.7. 逻辑与移位指令:shf#
shf
漏斗移位。
语法
shf.l.mode.b32 d, a, b, c; // left shift
shf.r.mode.b32 d, a, b, c; // right shift
.mode = { .clamp, .wrap };
说明
将由操作数 a 和 b 拼接而成的 64 位值,按 c 中无符号 32 位值指定的量向左或向右
移位。对于该 64 位源值,操作数 b 保存位 63:32,操作数 a 保存位 31:0。源值按 c 中经钳制或回绕后的值向左或向右
移位。对于 shf.l,将结果的最高有效 32 位写入 d;对于 shf.r,将结果的最低有效 32 位写入 d。
语义
u32 n = (.mode == .clamp) ? min(c, 32) : c & 0x1f;
switch (shf.dir) { // shift concatenation of [b, a]
case shf.l: // extract 32 msbs
u32 d = (b << n) | (a >> (32-n));
case shf.r: // extract 32 lsbs
u32 d = (b << (32-n)) | (a >> n);
}
示例
shf.l.clamp.b32 r3,r1,r0,16;
// 128-bit left shift; n < 32
// [r7,r6,r5,r4] = [r3,r2,r1,r0] << n
shf.l.clamp.b32 r7,r2,r3,n;
shf.l.clamp.b32 r6,r1,r2,n;
shf.l.clamp.b32 r5,r0,r1,n;
shl.b32 r4,r0,n;
// 128-bit right shift, arithmetic; n < 32
// [r7,r6,r5,r4] = [r3,r2,r1,r0] >> n
shf.r.clamp.b32 r4,r0,r1,n;
shf.r.clamp.b32 r5,r1,r2,n;
shf.r.clamp.b32 r6,r2,r3,n;
shr.s32 r7,r3,n; // result is sign-extended
shf.r.clamp.b32 r1,r0,r0,n; // rotate right by n; n < 32
shf.l.clamp.b32 r1,r0,r0,n; // rotate left by n; n < 32
// extract 32-bits from [r1,r0] starting at position n < 32
shf.r.clamp.b32 r0,r0,r1,n;
9.7.9.8. 逻辑与移位指令:shl#
shl
左移各位,右侧补零。
语法
shl.type d, a, b;
.type = { .b16, .b32, .b64 };
说明
将 a 向左移位,移位量由 b 中的无符号 32 位值指定。
语义
d = a << b;
示例
shl.b32 q,a,2;
9.7.9.9. 逻辑与移位指令:shr#
shr
右移各位,左侧补符号位或补零。
语法
shr.type d, a, b;
.type = { .b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64 };
说明
将 a 向右移位,移位量由 b 中的无符号 32 位值指定。有符号移位补符号位,无符号与无类型移位补
0。
语义
d = a >> b;
示例
shr.u16 c,a,2;
shr.s32 i,i,1;
shr.b16 k,i,j;
9.7.10. 数据移动与转换指令#
这些指令将数据从一个位置复制到另一个位置,并在各状态空间之间复制,必要时可能将数据从一种格式转换为另一种格式。mov、ld、ldu 和 st 同时作用于标量
和向量类型。提供 isspacep 指令用于查询某个通用地址是否落在特定状态空间窗口内。cvta 指令在
generic 与 const、global、local 或 shared 状态空间之间转换地址。
指令 ld、st、suld 和 sust 支持可选的缓存操作。
数据移动与转换指令包括:
movshfl.syncprmtldldustst.asyncst.bulkmultimem.ld_reduce,multimem.st,multimem.redmultimem.st.asyncprefetch,prefetchuisspacepcvtacvtcvt.packcp.asynccp.async.commit_groupcp.async.wait_group,cp.async.wait_allcp.async.bulkcp.reduce.async.bulkcp.async.bulk.prefetchmultimem.cp.async.bulkmultimem.cp.reduce.async.bulkcp.async.bulk.tensorcp.reduce.async.bulk.tensorcp.async.bulk.prefetch.tensorcp.async.bulk.commit_groupcp.async.bulk.wait_grouptensormap.replacespcompressspdecompress
9.7.10.1. 缓存运算符#
PTX ISA 2.0 版在加载和存储指令上引入了可选的缓存运算符。缓存运算符要求目标架构为 sm_20 或更高。
加载或存储指令上的缓存运算符仅被视为性能提示。在 ld 或 st 指令上使用缓存运算符不会改变程序的内存一致性行为。
对于 sm_20 及更高架构,缓存运算符具有如下定义和行为。
运算符 |
含义 |
|---|---|
|
在所有层级缓存,可能再次被访问。 默认的加载指令缓存操作是 ld.ca,它以正常逐出策略在所有层级(L1 和 L2)分配缓存行。全局数据在 L2 层级保持一致,但多个 L1 缓存对全局数据并不一致。若一个线程经由某个 L1 缓存向全局内存存储,而第二个线程用 |
|
在全局层级缓存(缓存在 L2 及更低层级,不缓存 L1)。 使用 |
|
缓存流式,可能仅访问一次。
|
|
最后一次使用。 编译器/程序员可在恢复溢出寄存器和弹出函数栈帧时使用 |
|
不缓存并重新取回(认为已缓存的系统内存行已过期,重新取回)。 应用于全局 System Memory 地址的 ld.cv 加载操作会使匹配的 L2 缓存行无效(丢弃),并在每次新加载时重新取回该行。 |
运算符 |
含义 |
|---|---|
|
写回缓存至所有一致的层级。 默认的存储指令缓存操作是 若一个线程绕过其 L1 缓存向全局内存存储,而位于不同 SM 中的第二个线程稍后用 驱动程序必须在相互依赖的线程数组网格之间使全局 L1 缓存行无效。此后,第一个网格程序的存储会在 L1 中正确地未命中,并由发出默认
|
|
在全局层级缓存(缓存在 L2 及更低层级,不缓存 L1)。 使用 |
|
缓存流式,可能仅访问一次。
|
|
写穿缓存(写至系统内存)。 应用于全局 System Memory 地址的 |
9.7.10.2. 缓存逐出优先级提示#
PTX ISA 7.4 版在加载和存储指令上增加了可选的缓存逐出优先级提示。缓存逐出优先级要求目标架构 sm_70 或更高。
加载或存储指令上的缓存逐出优先级被视为性能提示。它对 .global 状态空间以及指向 .global
状态空间的通用地址受支持。
缓存逐出优先级 |
含义 |
|---|---|
|
以正常逐出优先级缓存数据。这是默认的逐出优先级。 |
|
以此优先级缓存的数据在逐出优先级顺序中排最前,当需要逐出缓存时很可能最先被逐出。此优先级适用于流式数据。 |
|
以此优先级缓存的数据在逐出优先级顺序中排最后,只有在其他具有 |
|
在此操作中不改变逐出优先级顺序。 |
|
不为数据分配缓存。此优先级适用于流式数据。 |
9.7.10.3. 数据移动与转换指令:mov#
mov
用一个寄存器变量或立即数的值设置寄存器变量。取 global、local 或 shared 状态空间中变量的非通用地址。
语法
mov.type d, a;
mov.type d, sreg;
mov.type d, avar; // get address of variable
mov.type d, avar+imm; // get address of variable with offset
mov.u32 d, fname; // get address of device function
mov.u64 d, fname; // get address of device function
mov.u32 d, kernel; // get address of entry function
mov.u64 d, kernel; // get address of entry function
.type = { .pred,
.b16, .b32, .b64,
.u16, .u32, .u64,
.s16, .s32, .s64,
.f32, .f64 };
说明
将 a 的值写入寄存器 d。
操作数 a 可以是寄存器、特殊寄存器、可寻址内存空间中带可选偏移的变量,或函数名。
对于在 .const、.global、.local 和 .shared 状态空间中声明的变量,mov
将该变量的非通用地址(即变量在其状态空间中的地址)放入目标寄存器。const、global、local 或 shared
状态空间中变量的通用地址,可先用 mov 取该状态空间内的地址,再用 cvta 指令转换为通用地址来生成;
也可以直接用 cvta 指令取在 const、global、local 或 shared 状态空间中声明的变量的通用地址。
注意,若将设备函数参数的地址移入寄存器,则该参数会被复制到栈上,其地址位于 local 状态空间中。
语义
d = a;
d = sreg;
d = &avar; // address is non-generic; i.e., within the variable's declared state space
d = &avar+imm;
示例
mov.f32 d,a;
mov.u16 u,v;
mov.f32 k,0.1;
mov.u32 ptr, A; // move address of A into ptr
mov.u32 ptr, A[5]; // move address of A[5] into ptr
mov.u32 ptr, A+20; // move address with offset into ptr
mov.u32 addr, myFunc; // get address of device function 'myFunc'
mov.u64 kptr, main; // get address of entry function 'main'
9.7.10.4. 数据移动与转换指令:mov#
mov
执行向量到标量(打包)或标量到向量(解包)的移动。
语法
mov.type d, a;
.type = { .b16, .b32, .b64, .b128 };
说明
将向量寄存器 a 打包后的值写入标量寄存器 d,或将标量寄存器
a 解包出的值写入向量寄存器 d。
当目标操作数 d 是向量寄存器时,一个或多个元素可用汇聚符号 '_' 表示,只要至少有一个元素是标量寄存器。
对于位宽类型,mov 可用于将向量元素打包进标量寄存器,或将标量寄存器的子字段解包进向量。向量的总体大小与标量的大小都必须与指令类型的大小匹配。
语义
// pack two 8-bit elements into .b16
d = a.x | (a.y << 8)
// pack four 8-bit elements into .b32
d = a.x | (a.y << 8) | (a.z << 16) | (a.w << 24)
// pack two 16-bit elements into .b32
d = a.x | (a.y << 16)
// pack four 16-bit elements into .b64
d = a.x | (a.y << 16) | (a.z << 32) | (a.w << 48)
// pack two 32-bit elements into .b64
d = a.x | (a.y << 32)
// pack four 32-bit elements into .b128
d = a.x | (a.y << 32) | (a.z << 64) | (a.w << 96)
// pack two 64-bit elements into .b128
d = a.x | (a.y << 64)
// unpack 8-bit elements from .b16
{ d.x, d.y } = { a[0..7], a[8..15] }
// unpack 8-bit elements from .b32
{ d.x, d.y, d.z, d.w }
{ a[0..7], a[8..15], a[16..23], a[24..31] }
// unpack 16-bit elements from .b32
{ d.x, d.y } = { a[0..15], a[16..31] }
// unpack 16-bit elements from .b64
{ d.x, d.y, d.z, d.w } =
{ a[0..15], a[16..31], a[32..47], a[48..63] }
// unpack 32-bit elements from .b64
{ d.x, d.y } = { a[0..31], a[32..63] }
// unpack 32-bit elements from .b128
{ d.x, d.y, d.z, d.w } =
{ a[0..31], a[32..63], a[64..95], a[96..127] }
// unpack 64-bit elements from .b128
{ d.x, d.y } = { a[0..63], a[64..127] }
示例
mov.b32 %r1,{a,b}; // a,b have type .u16
mov.b64 {lo,hi}, %x; // %x is a double; lo,hi are .u32
mov.b32 %r1,{x,y,z,w}; // x,y,z,w have type .b8
mov.b32 {r,g,b,a},%r1; // r,g,b,a have type .u8
mov.b64 {%r1, _}, %x; // %x is.b64, %r1 is .b32
mov.b128 {%b1, %b2}, %y; // %y is.b128, %b1 and % b2 are .b64
mov.b128 %y, {%b1, %b2}; // %y is.b128, %b1 and % b2 are .b64
9.7.10.5. 数据移动与转换指令:shfl(已弃用)#
shfl(已弃用)
在一个 warp 的线程之间进行寄存器数据洗牌。
语法
shfl.mode.b32 d[|p], a, b, c;
.mode = { .up, .down, .bfly, .idx };
说明
在一个 warp 的线程之间交换寄存器数据。
当前执行 warp 中的每个线程都会根据输入操作数 b、c 以及模式计算一个源通道索引 j。若计算出的源通道索引 j 在范围内,
该线程就把通道 j 的输入操作数 a 复制到自身的目标寄存器 d;否则该线程只将自身的输入 a 复制到目标 d。可选
的目标谓词 p 在计算出的源通道位于范围内时置为 True,否则置为 False。
注意,超出范围的 b 值仍可能计算出有效的源通道索引 j。此时会发生数据传输,且目标谓词 p 为 True。
注意,在一个 warp 内的发散控制流中,若活动线程从非活动线程取寄存器,结果未定义。
操作数 b 指定源通道或源通道偏移,具体取决于模式。
操作数 c 包含两个打包值,分别指定用于将 warp 在逻辑上划分为子段的掩码,以及用于钳制源通道索引的上界。
语义
lane[4:0] = [Thread].laneid; // position of thread in warp
bval[4:0] = b[4:0]; // source lane or lane offset (0..31)
cval[4:0] = c[4:0]; // clamp value
mask[4:0] = c[12:8];
// get value of source register a if thread is active and
// guard predicate true, else unpredictable
if (isActive(Thread) && isGuardPredicateTrue(Thread)) {
SourceA[lane] = a;
} else {
// Value of SourceA[lane] is unpredictable for
// inactive/predicated-off threads in warp
}
maxLane = (lane[4:0] & mask[4:0]) | (cval[4:0] & ~mask[4:0]);
minLane = (lane[4:0] & mask[4:0]);
switch (.mode) {
case .up: j = lane - bval; pval = (j >= maxLane); break;
case .down: j = lane + bval; pval = (j <= maxLane); break;
case .bfly: j = lane ^ bval; pval = (j <= maxLane); break;
case .idx: j = minLane | (bval[4:0] & ~mask[4:0]);
pval = (j <= maxLane); break;
}
if (!pval) j = lane; // copy from own lane
d = SourceA[j]; // copy input a from lane j
if (dest predicate selected)
p = pval;
示例
// Warp-level INCLUSIVE PLUS SCAN:
//
// Assumes input in following registers:
// - Rx = sequence value for this thread
//
shfl.up.b32 Ry|p, Rx, 0x1, 0x0;
@p add.f32 Rx, Ry, Rx;
shfl.up.b32 Ry|p, Rx, 0x2, 0x0;
@p add.f32 Rx, Ry, Rx;
shfl.up.b32 Ry|p, Rx, 0x4, 0x0;
@p add.f32 Rx, Ry, Rx;
shfl.up.b32 Ry|p, Rx, 0x8, 0x0;
@p add.f32 Rx, Ry, Rx;
shfl.up.b32 Ry|p, Rx, 0x10, 0x0;
@p add.f32 Rx, Ry, Rx;
// Warp-level INCLUSIVE PLUS REVERSE-SCAN:
//
// Assumes input in following registers:
// - Rx = sequence value for this thread
//
shfl.down.b32 Ry|p, Rx, 0x1, 0x1f;
plaintext
@p add.f32 Rx, Ry, Rx;
shfl.down.b32 Ry|p, Rx, 0x2, 0x1f;
@p add.f32 Rx, Ry, Rx;
shfl.down.b32 Ry|p, Rx, 0x4, 0x1f;
@p add.f32 Rx, Ry, Rx;
shfl.down.b32 Ry|p, Rx, 0x8, 0x1f;
@p add.f32 Rx, Ry, Rx;
shfl.down.b32 Ry|p, Rx, 0x10, 0x1f;
@p add.f32 Rx, Ry, Rx;
// BUTTERFLY REDUCTION:
//
// Assumes input in following registers:
// - Rx = sequence value for this thread
//
shfl.bfly.b32 Ry, Rx, 0x10, 0x1f; // no predicate dest
add.f32 Rx, Ry, Rx;
shfl.bfly.b32 Ry, Rx, 0x8, 0x1f;
add.f32 Rx, Ry, Rx;
shfl.bfly.b32 Ry, Rx, 0x4, 0x1f;
add.f32 Rx, Ry, Rx;
shfl.bfly.b32 Ry, Rx, 0x2, 0x1f;
add.f32 Rx, Ry, Rx;
shfl.bfly.b32 Ry, Rx, 0x1, 0x1f;
add.f32 Rx, Ry, Rx;
//
// All threads now hold sum in Rx
plaintext
9.7.10.6. 数据移动与转换指令:shfl.sync#
shfl.sync
在一个 warp 的线程之间进行寄存器数据洗牌。
语法
shfl.sync.mode.b32 d[|p], a, b, c, membermask;
.mode = { .up, .down, .bfly, .idx };
说明
在一个 warp 的线程之间交换寄存器数据。
shfl.sync 会使执行线程等待,直到与 membermask 对应的所有未退出线程都以相同的限定符和相同的 membermask 值
执行 shfl.sync 后,才恢复执行。
操作数 membermask 指定一个 32 位整数,它是指示参与屏障的线程的掩码,其中位位置对应线程的 laneid。
shfl.sync 在 membermask 中的线程之间交换寄存器数据。
当前执行 warp 中的每个线程都会根据输入操作数 b、c 以及模式计算一个源通道索引 j。若计算出的源通道索引 j 在范围内,
该线程就把通道 j 的输入操作数 a 复制到自身的目标寄存器 d;否则该线程只将自身的输入 a 复制到目标 d。可选
的目标谓词 p 在计算出的源通道位于范围内时置为 True,否则置为 False。
注意,超出范围的 b 值仍可能计算出有效的源通道索引 j。此时会发生数据传输,且目标谓词 p 为 True。
注意,若线程从非活动线程或不属于 membermask 的线程取寄存器,结果未定义。
操作数 b 指定源通道或源通道偏移,具体取决于模式。
操作数 c 包含两个打包值,分别指定用于将 warp 在逻辑上划分为子段的掩码,以及用于钳制源通道索引的上界。
若执行线程不属于 membermask,则 shfl.sync 的行为未定义。
注
对于 .target sm_6x 或更低版本,membermask 中的所有线程必须在收敛状态下执行同一条 shfl.sync
指令,且执行该 shfl.sync 指令时,只有属于某个 membermask 的线程可以处于活动状态。否则,行为未定义。
语义
// wait for all threads in membermask to arrive
wait_for_specified_threads(membermask);
lane[4:0] = [Thread].laneid; // position of thread in warp
bval[4:0] = b[4:0]; // source lane or lane offset (0..31)
cval[4:0] = c[4:0]; // clamp value
segmask[4:0] = c[12:8];
// get value of source register a if thread is active and
// guard predicate true, else unpredictable
if (isActive(Thread) && isGuardPredicateTrue(Thread)) {
SourceA[lane] = a;
} else {
// Value of SourceA[lane] is unpredictable for
// inactive/predicated-off threads in warp
}
maxLane = (lane[4:0] & segmask[4:0]) | (cval[4:0] & ~segmask[4:0]);
minLane = (lane[4:0] & segmask[4:0]);
switch (.mode) {
case .up: j = lane - bval; pval = (j >= maxLane); break;
case .down: j = lane + bval; pval = (j <= maxLane); break;
case .bfly: j = lane ^ bval; pval = (j <= maxLane); break;
case .idx: j = minLane | (bval[4:0] & ~segmask[4:0]);
pval = (j <= maxLane); break;
}
if (!pval) j = lane; // copy from own lane
d = SourceA[j]; // copy input a from lane j
if (dest predicate selected)
p = pval;
示例
shfl.sync.up.b32 Ry|p, Rx, 0x1, 0x0, 0xffffffff;
9.7.10.7. 数据移动与转换指令:prmt#
prmt
对寄存器对中的字节进行置换。
语法
prmt.b32{.mode} d, a, b, c;
.mode = { .f4e, .b4e, .rc8, .ecl, .ecr, .rc16 };
说明
从两个 32 位寄存器中任意选取 4 个字节,并将它们重新组合为一个 32 位目标寄存器。
在通用形式(未指定 mode)下,置换控制由 4 个 4 位选择值组成。两个源寄存器中的字节按 0 到 7 编号:{b, a} = {{b7, b6, b5,
b4}, {b3, b2, b1, b0}}。对目标寄存器中的每个字节,都定义了一个 4 位选择值。
选择值的 3 个最低有效位(lsb)指定应将 8 个源字节中的哪一个移入目标位置。最高有效位(msb)决定是复制该字节的值,还是将该字节的符号(字节的 msb)复制到目标位置的全部 8 位(即对该字节值做符号扩展);
msb=0 表示复制字面值;msb=1 表示复制符号。注意,符号扩展仅在通用形式下执行。
因此,这 4 个 4 位值以 16b 置换码的形式完整指定了任意字节置换。
默认模式 |
源选择 |
源选择 |
源选择 |
源选择 |
|---|---|---|---|---|
索引 |
|
|
|
|
更专用的置换控制形式利用操作数 c(通常是一个地址指针)的 2 个最低有效位来控制字节提取。
模式 |
选择器
|
源 |
源 |
源 |
源 |
|---|---|---|---|---|---|
|
0 |
3 |
2 |
1 |
0 |
1 |
4 |
3 |
2 |
1 |
|
2 |
5 |
4 |
3 |
2 |
|
3 |
6 |
5 |
4 |
3 |
|
|
0 |
5 |
6 |
7 |
0 |
1 |
6 |
7 |
0 |
1 |
|
2 |
7 |
0 |
1 |
2 |
|
3 |
0 |
1 |
2 |
3 |
|
|
0 |
0 |
0 |
0 |
0 |
1 |
1 |
1 |
1 |
1 |
|
2 |
2 |
2 |
2 |
2 |
|
3 |
3 |
3 |
3 |
3 |
|
|
0 |
3 |
2 |
1 |
0 |
1 |
3 |
2 |
1 |
1 |
|
2 |
3 |
2 |
2 |
2 |
|
3 |
3 |
3 |
3 |
3 |
|
|
0 |
0 |
0 |
0 |
0 |
1 |
1 |
1 |
1 |
0 |
|
2 |
2 |
2 |
1 |
0 |
|
3 |
3 |
2 |
1 |
0 |
|
|
0 |
1 |
0 |
1 |
0 |
1 |
3 |
2 |
3 |
2 |
|
2 |
1 |
0 |
1 |
0 |
|
3 |
3 |
2 |
3 |
2 |
语义
tmp64 = (b<<32) | a; // create 8 byte source
if ( ! mode ) {
ctl[0] = (c >> 0) & 0xf;
ctl[1] = (c >> 4) & 0xf;
ctl[2] = (c >> 8) & 0xf;
ctl[3] = (c >> 12) & 0xf;
} else {
ctl[0] = ctl[1] = ctl[2] = ctl[3] = (c >> 0) & 0x3;
}
tmp[07:00] = ReadByte( mode, ctl[0], tmp64 );
tmp[15:08] = ReadByte( mode, ctl[1], tmp64 );
tmp[23:16] = ReadByte( mode, ctl[2], tmp64 );
tmp[31:24] = ReadByte( mode, ctl[3], tmp64 );
示例
prmt.b32 r1, r2, r3, r4;
prmt.b32.f4e r1, r2, r3, r4;
9.7.10.8. 数据移动与转换指令:ld#
ld
从可寻址的状态空间变量加载寄存器变量。
语法
ld{.weak}{.ss}{.cop}{.level::cache_hint}{.level::prefetch_size}{.vec}.type d, [a]{.unified}{, cache_policy};
ld{.weak}{.ss}{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.level::prefetch_size}{.vec}.type d, [a]{.unified}{, cache_policy};
ld.volatile{.ss}{.level::prefetch_size}{.vec}.type d, [a];
ld.relaxed.scope{.ss}{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.level::prefetch_size}{.vec}.type d, [a]{, cache_policy};
ld.acquire.scope{.ss}{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.level::prefetch_size}{.vec}.type d, [a]{, cache_policy};
ld.mmio.sem.sys{.global}.type d, [a];
ld{.ss}.type.proxy::readonly d, [a];
.ss = { .const, .global, .local, .param{::entry, ::func}, .shared{::cta, ::cluster} };
.cop = { .ca, .cg, .cs, .lu, .cv };
.sem = { .acquire, .relaxed };
.level1::eviction_priority = { .L1::evict_normal, .L1::evict_unchanged,
.L1::evict_first, .L1::evict_last, .L1::no_allocate };
.level2::eviction_priority = {.L2::evict_normal, .L2::evict_first, .L2::evict_last};
.level::cache_hint = { .L2::cache_hint };
.level::prefetch_size = { .L2::64B, .L2::128B, .L2::256B }
.scope = { .cta, .cluster, .gpu, .sys };
.vec = { .v2, .v4, .v8 };
.type = { .b8, .b16, .b32, .b64, .b128,
.u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.f32, .f64 };
说明
从指定状态空间中由源地址操作数 a 所指定位置加载寄存器变量 d。若未给定状态空间,则使用通用寻址执行加载。
若未为 .shared 状态空间指定子限定符,则默认假定为 ::cta。
操作数 a 支持的寻址模式及对
齐要求见 作为操作数的地址
若未为 .param 状态空间指定子限定符,则:
当访问发生在设备函数内部时,假定为
::func。当从入口函数访问内核函数参数时,假定为
::entry。否则,当从入口函数访问设备函数参数或任何其他.param变量时,默认假定为::func。
对于 ld.param::entry 指令,操作数 a 必须是内核参数地址,否则行为未定义。对于 ld.param::func 指令,操作数 a 必须是设备函数参数地址,
否则行为未定义。
用于读取设备函数调用返回值的指令 ld.param{::func} 不可加谓词。关于 ld.param 的正确用法说明,参见
参数状态空间 和
函数声明与定义。
.relaxed 和 .acquire 限定符表示如内存一致性模型 中所述的内存同步。.scope 限定符
指示 ld.relaxed 或 ld.acquire 指令可以与之直接同步的一组线程1。.weak 限定符表示一条不做同步的内存指令。
该指令的效果仅在其他手段建立的同步下才对其他线程可见。
可选限定符 .proxy::readonly 可用于指示该内存操作使用只读代理执行。指定该限定符时,源操作数 a 所引用的内存在内核的生命周期内
被视为只读。proxy::readonly 限定符只能与 global 状态空间一起使用,或用于指向 global 或 const 状态空间的通用寻址。
若通用地址不落在 global 或 const 内存的地址窗口内,则行为未定义。
.mmio 限定符的语义细节见 内存一致性模型。
对 ld.mmio 操作,仅 .sys 线程作用域有效。
.volatile 限定符的语义细节见 内存一致性模型。
.weak、.volatile、.relaxed 和 .acquire 限定符互斥。当这些限定
符都未指定时,默认假定为 .weak 限定符。
.relaxed 和 .acquire:
可与
.global、.shared空间一起使用,或用于指向.global或.shared空间的通用寻址。不允许缓存操作。
.volatile:
可与
.global、.shared、.local空间一起使用,或用于指向.global、.shared或.local空间的通用寻址。不允许缓存操作。
.mmio:
仅可与
.global空间一起使用,或用于指向.global空间的通用寻址。
若 a 是以 .unified 属性声明的变量地址,如变量与函数属性指令:.attribute 所述,则必须在操作数 a 上指定可选限定符 .unified。
.v8(.vec)限定符受支持的条件为:
.type为.b32或.s32或.u32或.f32,且状态空间为
.global,或用于指向.global状态空间的通用寻址
类型为 .b64 或 .s64 或 .u64 或 .f64 的 .v4(.vec)限定符受支持的条件为:
状态空间为
.global,或用于指向.global状态空间的通用寻址
限定符 .level1::eviction_priority 和 .level2::eviction_priority 分别指定可在内存访问期间应用的 L1 和 L2 缓存逐出策略。
限定符 .level2::eviction_priority 受支持的条件为:
-
.vec为.v8且.type为.b32或.s32或.u32或.f32且操作数
d是由 8 个寄存器组成的向量,其类型由.type指定
-
或
.vec为.v4且.type为.b64或.s64或.u64或.f64且操作数
d是由 4 个寄存器组成的向量,其类型由.type指定
另外,当满足下列条件时,可在向量表达式 d 中使用汇聚符号 ‘_’:
.vec为.v8且.type为.b32或.s32或.u32或.f32,或.vec为.v4且.type为.b64或.s64或.u64或.f64
这表示不读取对应内存位置的数据。
.level::prefetch_size 限定符是一个提示,用于将指定大小的额外数据预取到相应缓存层级。子限定符 prefetch_size 可设为 64B、
128B、256B 之一,从而允许预取大小分别为 64 字节、128 字节或 256 字节。
限定符 .level::prefetch_size 只能与 .global 状态空间一起使用,或用于指向 .global 状态空间的通用寻址。若通用地址
不落在全局内存的地址窗口内,则预取行为未定义。
.level::prefetch_size 限定符仅被视为性能提示。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可
使用的缓存逐出策略。
限定符 .unified 和 .level::cache_hint 仅对 .global 状态空间以及对指向 .global 状态空间的通用寻址受支持。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
1 如内存一致性模型所述,此同步通过因果序的传递性进一步扩展到其他线程。
语义
d = a; // named variable a
d = *(&a+immOff) // variable-plus-offset
d = *a; // register
d = *(a+immOff); // register-plus-offset
d = *(immAddr); // immediate address
示例
ld.global.f32 d,[a];
ld.shared.v4.b32 Q,[p];
ld.const.s32 d,[p+4];
ld.local.b32 x,[p+-8]; // negative offset
ld.local.b64 x,[240]; // immediate address
ld.global.b16 %r,[fs]; // load .f16 data into 32-bit reg
cvt.f32.f16 %r,%r; // up-convert f16 data to f32
ld.global.b32 %r0, [fs]; // load .f16x2 data in 32-bit reg
ld.global.b32 %r1, [fs + 4]; // load .f16x2 data in 32-bit reg
add.rn.f16x2 %d0, %r0, %r1; // addition of f16x2 data
ld.global.relaxed.gpu.u32 %r0, [gbl];
ld.shared.acquire.gpu.u32 %r1, [sh];
ld.global.relaxed.cluster.u32 %r2, [gbl];
ld.shared::cta.acquire.gpu.u32 %r2, [sh + 4];
ld.shared::cluster.u32 %r3, [sh + 8];
ld.global.mmio.relaxed.sys.u32 %r3, [gbl];
ld.local.volatile.u32 %r4, [lcl];
ld.global.f32 d,[ugbl].unified;
ld.b32 %r0, [%r1].unified;
ld.global.L1::evict_last.u32 d, [p];
ld.global.L2::64B.b32 %r0, [gbl]; // Prefetch 64B to L2
ld.L2::128B.f64 %r1, [gbl]; // Prefetch 128B to L2
ld.global.L2::256B.f64 %r2, [gbl]; // Prefetch 256B to L2
createpolicy.fractional.L2::evict_last.L2::evict_unchanged.b64 cache_policy, 1.0;
ld.global.L2::cache_hint.b64 x, [p], cache_policy;
ld.param::entry.b32 %rp1, [kparam1];
ld.global.b128 %r0, [gbl]; // 128-bit load
ld.global.acquire.mmio.sys.u32 %r0, [gbl];
// 256-bit load
ld.global.L2::evict_last.v8.f32 { %reg0, _, %reg2, %reg3, %reg4, %reg5, %reg6, %reg7}, [addr];
ld.global.L2::evict_last.L1::evict_last.v4.u64 { %reg0, %reg1, %reg2, %reg3}, [addr];
ld.global.u32.proxy::readonly %r0, [%rd0];
ld.u32.proxy::readonly %r1, [%rd1];
9.7.10.9. 数据移动与转换指令:ld.global.nc#
ld.global.nc
经由非一致性缓存从全局状态空间加载寄存器变量。
语法
ld.global{.cop}.nc{.level::cache_hint}{.level::prefetch_size}.type d, [a]{, cache_policy};
ld.global{.cop}.nc{.level::cache_hint}{.level::prefetch_size}.vec.type d, [a]{, cache_policy};
ld.global.nc{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.level::prefetch_size}.type d, [a]{, cache_policy};
ld.global.nc{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.level::prefetch_size}.vec.type d, [a]{, cache_policy};
.cop = { .ca, .cg, .cs }; // cache operation
.level1::eviction_priority = { .L1::evict_normal, .L1::evict_unchanged,
.L1::evict_first, .L1::evict_last, .L1::no_allocate};
.level2::eviction_priority = {.L2::evict_normal, .L2::evict_first, .L2::evict_last};
.level::cache_hint = { .L2::cache_hint };
.level::prefetch_size = { .L2::64B, .L2::128B, .L2::256B }
.vec = { .v2, .v4, .v8 };
.type = { .b8, .b16, .b32, .b64, .b128,
.u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.f32, .f64 };
说明
从全局状态空间中由源地址操作数 a 所指定位置加载寄存器变量 d,并可选择性地缓存到非一致性只读缓存中。
注
在某些架构上,纹理缓存比全局内存缓存更大、带宽更高、延迟也更高。对于有足够并行度以掩盖较长延迟的应用,在这些架构上 ld.global.nc 相比 ld.global
应能提供更好的性能。
地址操作数 a 应包含一个全局地址。
操作数 a 支持的寻址模式及对齐要求见 作为操作数的地址。
.v8(.vec)限定符受支持的条件为:
.type为.b32、.s32、.u32或.f32,且状态空间为
.global,或用于指向.global状态空间的通用寻址
类型为 .b64 或 .s64 或 .u64 或 .f64 的 .v4(.vec)限定符受支持的条件为:
状态空间为
.global,或用于指向.global状态空间的通用寻址
限定符 .level1::eviction_priority 和 .level2::eviction_priority 分别指定可在内存访问期间应用的 L1 和 L2 缓存逐出策略。
限定符 .level2::eviction_priority 受支持的条件为:
-
.vec为.v8且.type为.b32或.s32或.u32或.f32且操作数
d是由 8 个寄存器组成的向量,其类型由.type指定
-
或
.vec为.v4且.type为.b64或.s64或.u64或.f64且操作数
d是由 4 个寄存器组成的向量,其类型由.type指定
另外,当满足下列条件时,可在向量表达式 d 中使用汇聚符号 ‘_’:
.vec为.v8且.type为.b32或.s32或.u32或.f32,或.vec为.v4且.type为.b64或.s64或.u64或.f64
这表示不读取对应内存位置的数据。
.level::prefetch_size 限定符是一个提示,用于将指定大小的额外数据预取到相应缓存层级。子限定符 prefetch_size 可设为 64B、
128B、256B 之一,从而允许预取大小分别为 64 字节、128 字节或 256 字节。
.level::prefetch_size 限定符仅被视为性能提示。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可
使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
语义
d = a; // named variable a
d = *(&a+immOff) // variable-plus-offset
d = *a; // register
d = *(a+immOff); // register-plus-offset
d = *(immAddr); // immediate address
示例
ld.global.nc.f32 d, [a];
ld.gloal.nc.L1::evict_last.u32 d, [a];
createpolicy.fractional.L2::evict_last.b64 cache_policy, 0.5;
ld.global.nc.L2::cache_hint.f32 d, [a], cache_policy;
ld.global.nc.L2::64B.b32 d, [a]; // Prefetch 64B to L2
ld.global.nc.L2::256B.f64 d, [a]; // Prefetch 256B to L2
ld.global.nc.b128 d, [a];
ld.global.nc.L2::evict_first.v4.f64 {%reg0, %reg1. %reg2, %reg3}. [a]; // 256-bit load
9.7.10.10. 数据移动与转换指令:ldu#
ldu
从一个在 warp 中各线程共有的地址加载只读数据。
语法
ldu{.ss}.type d, [a]; // load from address
ldu{.ss}.vec.type d, [a]; // vec load from address
.ss = { .global }; // state space
.vec = { .v2, .v4 };
.type = { .b8, .b16, .b32, .b64, .b128,
.u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.f32, .f64 };
说明
将只读数据加载到寄存器变量 d,其来源为全局状态空间中由源地址操作数 a 所指定位置,且该地址保证在 warp 中的所有线程上相同。若未给定状态空间,则使用通用寻址执行加载。
操作数 a 支持的寻址模式及对齐要求见
作为操作数的地址。
语义
d = a; // named variable a
d = *(&a+immOff) // variable-plus-offset
d = *a; // register
d = *(a+immOff); // register-plus-offset
d = *(immAddr); // immediate address
示例
ldu.global.f32 d,[a];
ldu.global.b32 d,[p+4];
ldu.global.v4.f32 Q,[p];
ldu.global.b128 d,[a];
9.7.10.11. 数据移动与转换指令:st#
st
将数据存储到可寻址的状态空间变量。
语法
st{.weak}{.ss}{.cop}{.level::cache_hint}{.vec}.type [a], b{, cache_policy};
st{.weak}{.ss}{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.vec}.type
[a], b{, cache_policy};
st.volatile{.ss}{.vec}.type [a], b;
st.relaxed.scope{.ss}{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.vec}.type
[a], b{, cache_policy};
st.release.scope{.ss}{.level1::eviction_priority}{.level2::eviction_priority}{.level::cache_hint}{.vec}.type
[a], b{, cache_policy};
st.mmio.sem.sys{.global}.type [a], b;
.ss = { .global, .local, .param{::func}, .shared{::cta, ::cluster} };
.sem = { .release, .relaxed };
.level1::eviction_priority = { .L1::evict_normal, .L1::evict_unchanged,
.L1::evict_first, .L1::evict_last, .L1::no_allocate };
.level2::eviction_priority = { .L2::evict_normal, .L2::evict_first, .L2::evict_last };
.level::cache_hint = { .L2::cache_hint };
.cop = { .wb, .cg, .cs, .wt };
.sem = { .relaxed, .release };
.scope = { .cta, .cluster, .gpu, .sys };
.vec = { .v2, .v4, .v8 };
.type = { .b8, .b16, .b32, .b64, .b128,
.u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.f32, .f64 };
说明
将操作数 b 的值存储到指定状态空间中由目标地址操作数 a 所指定的位置。若未给定状态空间,则使用
通用寻址 执行存储。向 const 内存的存储是非法的。
若未为 .shared 状态空间指定子限定符,则默认假定为 ::cta。
操作数 a 支持的寻址模式及对齐要求见
作为操作数的地址。
若指定 .param 而未带任何子限定符,则默认为 .param::func。
用于向设备函数传递参数的指令 st.param{::func} 不可加谓词。关于 st.param 的正确用法说明,参见
参数状态空间 和 函数声明与定义。
限定符 .relaxed 和 .release 表示如内存一致性模型 中所述的内存同步。.scope 限定符
指示 st.relaxed 或 st.release 指令可以与之直接同步的一组线程1。.weak 限定符表示一条不做同步的内存指令。
该指令的效果仅在其他手段建立的同步下才对其他线程可见。
.mmio 限定符的语义细节见 内存一致性模型。
对 st.mmio 操作,仅 .sys 线程作用域有效。
.volatile 限定符的语义细节见
内存一致性模型。
.weak、.volatile、.relaxed 和 .release 限定符互斥。当这些
限定符都未指定时,默认假定为 .weak 限定符。
.relaxed 和 .release:
可与
.global、.shared空间一起使用,或用于指向.global或.shared空间的通用寻址。不允许缓存操作。
.volatile:
可与
.global、.shared、.local空间一起使用,或用于指向.global、.shared或.local空间的通用寻址。不允许缓存操作。
.mmio:
仅可与
.global空间一起使用,或用于指向.global空间的通用寻址。
.v8(.vec)限定符受支持的条件为:
.type为.b32、.s32、.u32或.f32,且状态空间为
.global,或用于指向.global状态空间的通用寻址
类型为 .b64 或 .s64 或 .u64 或 .f64 的 .v4(.vec)限定符受支持的条件为:
状态空间为
.global,或用于指向.global状态空间的通用寻址
限定符 .level1::eviction_priority 和 .level2::eviction_priority 分别指定可在内存访问期间应用的 L1 和 L2 缓存逐出策略。
限定符 .level2::eviction_priority 受支持的条件为:
-
.vec为.v8且.type为.b32或.s32或.u32或.f32且操作数
d是由 8 个寄存器组成的向量,其类型由.type指定
-
或
.vec为.v4且.type为.b64或.s64或.u64或.f64且操作数
d是由 4 个寄存器组成的向量,其类型由.type指定
另外,当满足下列条件时,可在向量表达式 b 中使用汇聚符号 ‘_’:
.vec为.v8且.type为.b32或.s32或.u32或.f32,或.vec为.v4且.type为.b64或.s64或.u64或.f64
这表示不在对应的目标地址写入数据。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可
使用的缓存逐出策略。
限定符 .level::cache_hint 仅对 .global 状态空间以及对指向 .global 状态空间的通用寻址受支持。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
1 如内存一致性模型所述,此同步通过因果序的传递性进一步扩展到其他线程。
语义
d = a; // named variable d
*(&a+immOffset) = b; // variable-plus-offset
*a = b; // register
*(a+immOffset) = b; // register-plus-offset
*(immAddr) = b; // immediate address
示例
st.global.f32 [a],b;
st.local.b32 [q+4],a;
st.global.v4.s32 [p],Q;
st.local.b32 [q+-8],a; // negative offset
st.local.s32 [100],r7; // immediate address
cvt.f16.f32 %r,%r; // %r is 32-bit register
st.b16 [fs],%r; // store lower
st.global.relaxed.sys.u32 [gbl], %r0;
st.shared.release.cta.u32 [sh], %r1;
st.global.relaxed.cluster.u32 [gbl], %r2;
st.shared::cta.release.cta.u32 [sh + 4], %r1;
st.shared::cluster.u32 [sh + 8], %r1;
st.global.mmio.relaxed.sys.u32 [gbl], %r1;
st.local.volatile.u32 [lcl], %r2;
st.global.L1::no_allocate.f32 [p], a;
createpolicy.fractional.L2::evict_last.b64 cache_policy, 0.25;
st.global.L2::cache_hint.b32 [a], b, cache_policy;
st.param::func.b64 [param1], %rp1;
st.global.b128 [a], b; // 128-bit store
st.global.release.mmio.sys.u32 [gbl], %r0;
// 256-bit store
st.global.L2::evict_last.v8.f32 [addr], { %reg0, _, %reg2, %reg3, %reg4, %reg5, %reg6, %reg7};
9.7.10.12. 数据移动与转换指令:st.async#
st.async
异步存储操作。
语法
st.async{.weak}{.ss}.completion_mechanism{.vec}.type [a], b, [mbar];
.ss = { .shared::cluster };
.type = { .b32, .b64, .b128,
.u32, .u64,
.s32, .s64,
.f32, .f64 };
.vec = { .v2, .v4 };
.completion_mechanism = { .mbarrier::complete_tx::bytes };
st.async{.mmio}.sem.scope{.ss}.type [a], b;
.sem = { .release };
.scope = { .gpu, .sys };
.ss = { .global };
.type = { .b8, .b16, .b32, .b64,
.u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.f32, .f64 };
说明
st.async 是一条非阻塞指令,它发起一次异步存储操作,将由源操作数 b 指定的值存储到由操作数 a
指定的目标内存位置。
st.async 在通用代理中执行。
操作数
a是目标地址,必须是寄存器,或形如register + immOff的形式,如 作为操作数的地址 所述。b是源值,其类型由限定符.type指示。mbar是 mbarrier 对象地址。
限定符
.mmio指示这是否为一次 mmio 操作。-
.sem指定如内存一致性模型 所述的内存排序语义。若未指定
.sem,则默认为.weak。
.scope指定该指令可与之直接同步的一组线程。-
.ss指定目标操作数a和 mbarrier 操作数mbar的状态空间。若未指定
.ss,则使用 通用寻址。
-
.completion_mechanism指定观察异步操作完成的机制。当
.completion_mechanism为.mbarrier::complete_tx::bytes时:异步操作完成后,将在由操作数mbar指定的 mbarrier 对象上执行一次 complete-tx 操作,其completeCount参数等于所存储数据的字节量。该指令使用通用代理访问其mbarrier操作数。
.type指定源操作数b的类型。
条件
当 .sem 为 .weak 时:
这是一次对共享内存的弱存储,通过 mbarrier 对象发出其完成信号。
该存储操作被视为弱内存操作。
-
要求:
目标操作数
a与mbarrier 对象mbar的共享内存地址属于执行线程所在同一 cluster 内的同一 CTA。cluster 内的 CTA 数目严格大于 1;
%cluster_nctarank > 1为真。
否则,行为未定义。
不得指定
.mmio。若指定
.ss,则必须为.shared::cluster。若未指定
.ss,则对操作数a和mbar使用通用寻址。若所指定的通用地址不落在.shared::cluster状态空间的地址窗口内,则行为未定义。必须指定
.completion_mechanism且必须为.mbarrier::complete_tx::bytes。
当 .sem 为 .release 时:
这是一次对全局内存的释放存储。
该存储操作是一次强内存操作,在
.scope所指定作用域上具有.release语义。若指定
.mmio,则.scope必须为.sys。若指定
.ss,则必须为.global。若未指定
.ss,则对操作数a使用通用寻址。若所指定的通用地址不落在.global状态空间的地址窗口内,则行为未定义。-
对于
.vec限定符:.v2支持.b32、.b64、.s32、.s64、.u32、.u64、.f32和.f64类型。.v4限定符支持.b32、.s32、.u32和.f32类型。
示例
st.async.shared::cluster.mbarrier::complete_tx::bytes.u32 [addr], b, [mbar_addr];
st.async.sys.release.global.u32 [addr], b;
st.async.mbarrier::complete_tx::bytes.b128 [addr], b, [mbar_addr];
st.async.shared::cluster.mbarrier::complete_tx::bytes.b128 [addr], b, [mbar_addr];
9.7.10.13. 数据移动与转换指令:multimem.st.async#
multimem.st.async
对 multimem 地址执行具有释放顺序的异步存储。
语法
multimem.st.async.sem.scope{.ss}.type [a], b;
.sem = { .release };
.scope = { .gpu, .sys };
.ss = { .global };
.type = { .b8, .b16, .b32, .b64,
.u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.f32, .f64 };
说明
multimem.st.async 是一条非阻塞指令,它发起一次异步存储操作,将由源操作数 b 指定的值存储到由目标 multimem 地址操作数 a
所引用的、位于各 GPU 内存上的存储位置。
地址操作数 a 必须是 multimem 地址。否则,行为未定义。
操作数
a是目标地址,必须是寄存器,或形如register + immOff的形式,如 作为操作数的地址 所述。b是源值,其类型由限定符.type指示。
限定符
必需的
.sem修饰符指定如内存一致性模型 所述的内存排序语义。必需的
.scope修饰符指定该指令可与之直接同步的一组线程。这里的存储操作是一次强内存操作,在.scope所指定作用域上具有.release语义。.ss指定目标操作数a的状态空间。若指定.ss,则必须为.global。若未指定.ss,则对操作数a使用 通用寻址。若所指定的通用地址不落在.global状态空间的地址窗口内,则行为未定义。.type指定源操作数b的类型。
示例
// Release store to multimem address, GPU scope, explicit .global state space.
multimem.st.async.release.gpu.global.u32 [mm_addr], src_u32;
// Release store, system scope, generic addressing for multimem operand.
multimem.st.async.release.sys.f64 [mm_addr], src_f64;
9.7.10.14. 数据移动与转换指令:st.bulk#
st.bulk
按状态空间指定初始化一片内存区域。
语法
st.bulk{.weak}{.shared::cta} [a], size, initval; // initval must be zero
说明
st.bulk 指令初始化一片共享内存区域,起始位置由目标地址操作数 a 指定。
32 位或 64 位整数操作数 size 以字节数指定要初始化的内存量。size 必须是 8 的倍数。若该值不是 8 的倍数,则行为未定义。size 操作数的最大值可为 16777216。
整数常量操作数 initval 指定各内存位置的初始化值。操作数 initval 唯一允许的数值是 0。
若未指定状态空间,则使用 通用寻址。若由 a 指定的地址不落在 .shared 状态空间的地址窗口内,
则行为未定义。
可选限定符 .weak 指定 st.bulk 指令的内存同步效果,如 内存一致性模型 所述。
示例
st.bulk.weak.shared::cta [dst], n, 0;
st.bulk [gdst], 4096, 0;
9.7.10.15. 数据移动与转换指令:multimem.ld_reduce 、 multimem.st 、 multimem.red#
multimem.* 操作作用于 multimem 地址,并访问该 multimem 地址所指向的全部多个内存位置。
multimem 地址只能由 multimem.* 操作访问。使用 ld、st 或任何其他内存操作访问 multimem 地址会导致未定义行为。
有关 multimem 地址的创建与管理,请参见 CUDA programming guide。
multimem.ld_reduce, multimem.st, multimem.red
对 multimem 地址执行内存操作。
语法
// Integer type:
multimem.ld_reduce{.ldsem}{.scope}{.ss}.op.type d, [a];
multimem.ld_reduce.weak{.ss}.op.type d, [a];
multimem.st{.stsem}{.scope}{.ss}.type [a], b;
multimem.st.weak{.ss}.type [a], b;
multimem.red{.redsem}{.scope}{.ss}.op.type [a], b;
.ss = { .global }
.ldsem = { .relaxed, .acquire }
.stsem = { .relaxed, .release }
.redsem = { .relaxed, .release }
.scope = { .cta, .cluster, .gpu, .sys }
.op = { .min, .max, .add, .and, .or, .xor }
.type = { .b32, .b64, .u32, .u64, .s32, .s64 }
// Floating point type:
multimem.ld_reduce{.ldsem}{.scope}{.ss}.op{.acc_prec}{.vec}.type d, [a];
multimem.ld_reduce.weak{.ss}.op{.acc_prec}{.vec}.type d, [a];
multimem.st{.stsem}{.scope}{.ss}{.vec}.type [a], b;
multimem.st.weak{.ss}{.vec}.type [a], b;
multimem.red{.redsem}{.scope}{.ss}.redop{.vec}.redtype [a], b;
.ss = { .global }
.ldsem = { .relaxed, .acquire }
.stsem = { .relaxed, .release }
.redsem = { .relaxed, .release }
.scope = { .cta, .cluster, .gpu, .sys }
.op = { .min, .max, .add }
.redop = { .add }
.acc_prec = { .acc::f32, .acc::f16 }
.vec = { .v2, .v4, .v8 }
.type= { .f16, .f16x2, .bf16, .bf16x2, .f32, .f64, .e5m2, .e5m2x2, .e5m2x4, .e4m3, .e4m3x2, .e4m3x4 }
.redtype = { .f16, .f16x2, .bf16, .bf16x2, .f32, .f64 }
说明
指令 multimem.ld_reduce 执行以下操作:
对 multimem 地址
a的加载操作,即从该 multimem 地址a所指向的全部多个内存位置加载数据,由
.op指定的归约操作,作用于从该 multimem 地址a加载的多个数据。
归约操作的结果在寄存器 d 中返回。
指令 multimem.st 将输入操作数 b 执行一次存储操作,存储到该 multimem 地址 a 所指向的全部内存位置。
指令 multimem.red 使用该 multimem 地址 a 所指向的全部内存位置,配合操作数 b 执行一次归约操作。
指令 multimem.ld_reduce 对 multimem 地址所指向的全部内存位置加载而来的值执行归约。相比之下,multimem.red 对 multimem 地址所指向的全部内存位置执行归约。
地址操作数 a 必须是 multimem 地址。否则,行为未定义。操作数 a 支持的寻址模式及对齐要求见
作为操作数的地址。
若未指定状态空间,则使用 通用寻址。若由 a 指定的地址不落在 .global 状态空间
的地址窗口内,则行为未定义。
对于浮点类型多操作,指定类型连同 .vec 的大小必须等于 32 位、64 位或 128 位。不允许其他 .vec 与类型的组合。类型 .f64 不能与 .vec 限定符一起使用。
下表描述了 .vec 与基础浮点类型的合法用法:
.vec |
支持的基础浮点类型 |
|---|---|
未指定 |
|
|
|
|
|
|
|
下表描述了 .op 与基础类型的合法组合:
op |
基础类型 |
|---|---|
|
|
|
|
|
|
对于 multimem.ld_reduce,中间累加的默认精度与指定类型相同。
可选择指定 .acc_prec 限定符,按下表更改中间累加的精度:
.type |
.acc::prec |
精度改为 |
|---|---|---|
|
|
|
|
|
|
可选限定符 .ldsem、.stsem 和 .redsem 分别指定 multimem.ld_reduce、multimem.st 和
multimem.red 的内存同步效果,如 内存一致性模型 所述。若未指定显式的语义限定符,则
multimem.ld_reduce 和 multimem.st 默认为 .weak,而 multimem.red 默认为 .relaxed。
可选的 .scope 限定符指定能够直接观察到本操作内存同步效果的一组线程,如 内存一致性模型 所述。若未为
multimem.red 指定 .scope 限定符,则默认假定为 .sys 作用域。
示例
multimem.ld_reduce.and.b32 val1_b32, [addr1];
multimem.ld_reduce.acquire.gpu.global.add.u32 val2_u32, [addr2];
multimem.st.relaxed.gpu.b32 [addr3], val3_b32;
multimem.st.release.cta.global.u32 [addr4], val4_u32;
multimem.red.relaxed.gpu.max.f64 [addr5], val5_f64;
multimem.red.release.cta.global.add.v4.f32 [addr6], {val6, val7, val8, val9};
multimem.ld_reduce.add.acc::f32.v2.f16x2 {val_10, val_11}, [addr7];
multimem.ld_reduce.relaxed.cta.min.v2.e4m3x2 {val_12, val_13}, [addr8];
multimem.ld_reduce.relaxed.cta.add.v4.e4m3 {val_14, val_15, val_16, val_17}, [addr9];
multimem.ld_reduce.add.acc::f16.v4.e5m2 {val_18, val_19, val_20, val_21}, [addr10];
9.7.10.16. 数据移动与转换指令:prefetch 、 prefetchu#
prefetch, prefetchu
在指定的存储层次层级、指定的状态空间中,预取包含某个通用地址的缓存行。
语法
prefetch{.space}.level [a]; // prefetch to data cache
prefetch{.global}.level::prefetch_size.valid_addr [a]; // prefetch to L1 data cache
prefetch.global.level::eviction_priority [a]; // prefetch to data cache
prefetchu.L1 [a]; // prefetch to uniform cache
prefetch{.tensormap_space}.tensormap [a]; // prefetch the tensormap
.space = { .global, .local };
.level = { .L1, .L2 };
.level::prefetch_size = { .L1::32B };
.level::eviction_priority = { .L2::evict_last, .L2::evict_normal };
.tensormap_space = { .const, .param };
说明
prefetch 指令将包含指定地址(位于全局或局部内存状态空间)的缓存行载入指定的缓存层级。
可指定可选限定符 .L1::32B 以表示至少 32 字节的有效预取。若指定,则该指令必须满足以下条件:
必须指定限定符
.valid_addr;.valid_addr限定符要求地址a所引用的至少 1 字节宽的内存位置对本次访问有效。 否则,行为未定义。若指定限定符
.space,则必须设为.global。若未指定地址,则使用通用寻址,且该通用地址必须落在global状态空间内。
若指定 .tensormap 限定符,则 prefetch 指令将包含指定地址(位于 .const 或 .param 内存状态空间)的缓存行载入,
以供后续的 cp.async.bulk.tensor 指令使用。
若未给定状态空间,则 prefetch 使用 通用寻址。
可选择通过修饰符 .level::eviction_priority 指定要应用于被预取缓存行的逐出优先级。
操作数 a 支持的寻址模式及对齐要求见
作为操作数的地址
prefetchu 指令将包含指定通用地址的缓存行载入指定的统一缓存层级。
对共享内存位置的 prefetch 不执行任何操作。
对统一缓存的一次 prefetch 需要一个通用地址;若该地址映射到 const、local 或 shared 内存位置,则不执行任何操作。
示例
prefetch.global.L1 [ptr];
prefetch.global.L1::32B.valid_addr [ptr];
prefetch.global.L2::evict_last [ptr];
prefetchu.L1 [addr];
prefetch.const.tensormap [ptr];
9.7.10.17. 数据移动与转换指令:applypriority#
applypriority
将缓存逐出优先级应用于指定缓存层级中的指定地址。
语法
applypriority{.global}.level::eviction_priority [a], size;
.level::eviction_priority = { .L2::evict_normal };
说明
applypriority 指令将 .level::eviction_priority 限定符所指定的缓存逐出优先级应用于指定缓存层级中的地址范围
[a..a+size)。
若未指定状态空间,则使用 通用寻址。若指定的地址不落在 .global 状态空间的地址窗口内,则行为未定义。
操作数 size 是一个整数常量,以字节为单位指定在其中应用优先级的、位于指定缓存层级的数据量。size 操作数唯一支持的值为 128。
操作数 a 支持的寻址模式见 作为操作数的地址。
a 必须 128 字节对齐。
示例
applypriority.global.L2::evict_normal [ptr], 128;
9.7.10.18. 数据移动与转换指令:applypriority.async.bulk#
applypriority.async.bulk
将缓存逐出优先级应用于指定缓存层级中的指定地址。
语法
applypriority.async.bulk{.src}.completion_mechanism.level::eviction_priority [a], size;
.level::eviction_priority = { .L2::evict_normal };
.src = { .global };
.completion_mechanism = { .bulk_group };
说明
applypriority.async.bulk 指令将 .level::eviction_priority 限定符所指定的缓存逐出优先级应用于指定缓存层级中的地址范围 [a..a+size)。
若未指定状态空间,则使用 通用寻址。若指定的地址不落在 .global 状态空间的地址窗口内,则行为未定义。
操作数 size 是一个 32 位整数,以字节为单位指定在其中应用优先级的、位于指定缓存层级的数据量。size 操作数的值
必须是 16 的倍数。
操作数 a 支持的寻址模式见 作为操作数的地址。
a 必须 128 字节对齐。
限定符 .bulk_group 指定该 applypriority.async.bulk 变体使用基于 bulk 异步组的完成机制。
在内存一致性模型 中,applypriority.async.bulk 指令被视为弱内存操作。
示例
applypriority.async.bulk.global.bulk_group.L2::evict_normal [ptr], 128;
9.7.10.19. 数据移动与转换指令:applypriority.async.bulk.tensor#
applypriority.async.bulk.tensor
将缓存逐出优先级应用于指定缓存层级中的指定张量地址。
语法
applypriority.async.bulk.tensor.dim{.src}.completion_mechansim{.load_mode}
.level::eviction_priority{.override::global_address}{.override_attribute}
[tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords]{, im2colInfo};
.dim = { .1d, .2d, .3d, .4d, .5d };
.level::eviction_priority = { .L2::evict_normal };
.src = { .global };
.override_attribute = { .override::global_dim_stride, .override::global_dim };
.completion_mechanism = { .bulk_group };
.load_mode = { .tile, .tile::gather4, .im2col,
.im2col::w, .im2col::w::128 };
说明
applypriority.async.bulk.tensor 指令将缓存逐出优先级应用于该张量。限定符 .level::eviction_priority 指定优先级和缓存层级。
若未指定状态空间,则使用 通用寻址。若指定的地址不落在 .global 状态空间的地址窗口内,则行为未定义。
各种张量属性(例如张量的基地址和大小)在 张量映射 中指定。
可选限定符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。
更多细节参见 覆盖张量属性值。
限定符 .bulk_group 指定该 applypriority.async.bulk.tensor 变体使用基于 bulk 异步组的完成机制。
在内存一致性模型 中,applypriority.async.bulk.tensor 指令被视为弱内存操作。
示例
applypriority.async.bulk.tensor.1d.global.bulk_group.L2::evict_normal [tensorDesc,{u}];
applypriority.async.bulk.tensor.2d.global.bulk_group.tile.L2::evict_normal [tensorDesc, {u, v}];
9.7.10.20. 数据移动与转换指令:discard#
discard
丢弃指定地址范围和缓存层级处的数据。
语法
discard{.global}.level [a], size;
.level = { .L2 };
说明
从语义上看,其行为类似于对不稳定的不确定值的一次弱写入:在内存被覆盖之前,对含有不稳定不确定值的内存位置的读取每次可能返回不同的位模式。
本操作向实现发出提示:指定缓存 .level 中的数据可以被破坏性地丢弃,而无需写回内存。
操作数 size 是一个整数常量,以字节为单位指定要写入不稳定不确定值的地址范围 [a, a + size) 的长度。
size 操作数唯一支持的值为 128。
若未指定状态空间,则使用 通用寻址。若指定的地址不落在 .global 状态空间的地址窗口内,则行为未定义。
地址操作数 a 支持的寻址模式见 作为操作数的地址。
a 必须 128 字节对齐。
示例
discard.global.L2 [ptr], 128;
ld.weak.u32 r0, [ptr];
ld.weak.u32 r1, [ptr];
// The values in r0 and r1 may differ!
9.7.10.21. 数据移动与转换指令:createpolicy#
createpolicy
为指定的缓存层级创建缓存逐出策略。
语法
// Range-based policy
createpolicy.range{.global}.level::primary_priority{.level::secondary_priority}.b64
cache_policy, [a], primary-size, total-size;
// Fabric range-based policy
createpolicy.range.fabric.level::primary_priority{.level::secondary_priority}.b64
cache_policy, [aLe, aOff], primary-size, total-size;
// Fraction-based policy
createpolicy.fractional.level::primary_priority{.level::secondary_priority}.b64
cache_policy{, fraction};
// Converting the access property from CUDA APIs
createpolicy.cvt.L2.b64 cache_policy, access-property;
.level::primary_priority = { .L2::evict_last, .L2::evict_normal,
.L2::evict_first, .L2::evict_unchanged };
.level::secondary_priority = { .L2::evict_first, .L2::evict_unchanged };
说明
createpolicy 指令为指定的缓存层级创建一个缓存逐出策略,并存入由目标操作数 cache_policy 指定的不透明 64 位寄存器。该缓存逐出
策略规定了:对于使用 .level::cache_hint 限定符的内存操作所使用的全局内存地址,如何应用缓存逐出优先级。
缓存逐出策略有两种类型:
-
基于范围的策略
使用
createpolicy.range创建的缓存逐出策略,为以下三个地址范围规定缓存逐出行为:[a .. a + (primary-size - 1)],称为主范围。[a + primary-size .. a + (total-size - 1)],称为后置次范围。[a - (total-size - primary-size) .. (a - 1)],称为前置次范围。
使用
createpolicy.range.fabric创建的缓存逐出策略,为某个 fabric 句柄内的以下三个地址范围规定缓存逐出行为:[aOff .. aOff + (primary-size - 1)],称为主范围。[aOff + primary-size .. aOff + (total-size - 1)],称为后置次范围。[aOff - (total-size - primary-size) .. (aOff - 1)],称为前置次范围。
当基于范围的缓存逐出策略用于带
.level::cache_hint限定符的内存操作时,逐出优先级按如下方式应用:若内存地址落在主范围内,则应用
.level::primary_priority指定的逐出优先级。若内存落在两个次范围中的任意一个内,则应用
.level::secondary_priority指定的逐出优先级。若内存地址不落在上述任何范围内,则所应用的逐出优先级未指定。
32 位操作数
primary-size以字节为单位指定主范围的大小。32 位操作数total-size以字节为单位指定包含主范围与次范围在内的地址范围的合计大小。primary-size的值必须小于或等于total-size的值。total-size允许的最大值为 4GB。若未指定
.level::secondary_priority,则它默认为.L2::evict_unchanged。若未指定状态空间,则使用 通用寻址。若指定的地址不落在
.global状态空间的地址窗口内,则行为未定义。 -
基于比例的策略
带
.level::cache_hint限定符的内存操作可使用基于比例的缓存逐出策略,请求将.level::primary_priority指定的缓存逐出优先级应用于由 32 位浮点操作数fraction所指定比例的那部分缓存访问;其余的缓存访问则获得.level::secondary_priority指定的逐出优先级。这意味着,在使用基于比例的缓存策略的内存操作中, 该内存访问以操作数fraction所指定的概率获得.level::primary_priority指定的缓存逐出优先级。操作数
fraction的有效取值范围为(0.0,.., 1.0]。若未指定操作数fraction,则默认为 1.0。若未指定
.level::secondary_priority,则它默认为.L2::evict_unchanged。
由 CUDA API 创建的访问属性可由指令 createpolicy.cvt 转换为缓存逐出策略。源操作数 access-property 是一个 64 位不透明寄存器。更多细节请参见 CUDA programming guide。
示例
createpolicy.fractional.L2::evict_last.b64 policy, 1.0;
createpolicy.fractional.L2::evict_last.L2::evict_unchanged.b64 policy, 0.5;
createpolicy.range.L2::evict_last.L2::evict_first.b64
policy, [ptr], 0x100000, 0x200000;
createpolicy.range.fabric.L2::evict_last.L2::evict_first.b64
policy, [leid, off], 0x100000, 0x200000;
// access-prop is created by CUDA APIs.
createpolicy.cvt.L2.b64 policy, access-prop;
9.7.10.22. 数据移动与转换指令:isspacep#
isspacep
查询某个通用地址是否落在指定状态空间窗口内。
语法
isspacep.space p, a; // result is .pred
.space = { const, .global, .local, .shared{::cta, ::cluster}, .param{::entry} };
说明
若通用地址 a 落在指定状态空间窗口内,则向谓词寄存器 p 写入 1,否则写入 0。目标 p 的类型为 .pred;源地址
操作数必须为 .u32 或 .u64 类型。
isspacep.param{::entry} 在通用地址落在内核函数参数 窗口内时返回 1,否则返回 0。若指定 .param
而未带任何子限定符,则默认为 .param::entry。
由于 .param 窗口包含在 .global 窗口之内,isspacep.global 对内核函数参数
返回 1。
若未为 .shared 状态空间指定子限定符,则默认假定为 ::cta。
注
对 cluster 中线程可访问的每一个共享内存地址,ispacep.shared::cluster 都会返回 1;而仅当地址属于执行 CTA 中声明的变量时,ispacep.shared::cta 才返回 1。
示例
isspacep.const iscnst, cptr;
isspacep.global isglbl, gptr;
isspacep.local islcl, lptr;
isspacep.shared isshrd, sptr;
isspacep.param::entry isparam, pptr;
isspacep.shared::cta isshrdcta, sptr;
isspacep.shared::cluster ishrdany sptr;
9.7.10.23. 数据移动与转换指令:cvta#
cvta
将地址从 .const、
内核函数参数(.param)、.global、.local 或 .shared
状态空间转换为通用地址,或反之。取在 .const、内核函数参数(.param)、
.global、.local 或 .shared 状态空间中声明的变量的通用地址。
语法
// convert const, global, local, or shared address to generic address
cvta.space.size p, a; // source address in register a
cvta.space.size p, var; // get generic address of var
cvta.space.size p, var+imm; // generic address of var+offset
// convert generic address to const, global, local, or shared address
cvta.to.space.size p, a;
.space = { .const, .global, .local, .shared{::cta, ::cluster}, .param{::entry} };
.size = { .u32, .u64 };
说明
将 const、内核函数参数
(.param)、global、local 或 shared 地址转换为通用地址,或反之。源地址与目标地址必须大小相同。使用 cvt.u32.u64 或 cvt.u64.u32
对地址进行截断或零扩展。
对于在 .const、
内核函数参数(.param)、.global、.local 或 .shared
状态空间中声明的变量,其通用地址可用 cvta 取得。源要么是一个寄存器,要么是在 const、
内核函数参数(.param)、global、local 或 shared 内存中定义、
可带可选偏移的变量。
将通用地址转换为 const、
内核函数参数(.param)、global、local 或 shared 地址时,
若该通用地址不落在指定状态空间的地址窗口内,则所得地址未定义。程序可用 isspacep 来防止此类不正确行为。
对于使用 .shared 状态空间的 cvta,该地址必须属于由 ::cta 或 ::cluster 子限定符所指定的空间,否则行为未定义。若未为 .shared
状态空间指定子限定符,则默认假定为 ::cta。
若指定 .param 而未带任何子限定符,则默认为 .param::entry。对于 .param{::entry} 状态空间,操作数 a 必须是内核参数地址,否则
行为未定义。
示例
cvta.const.u32 ptr,cvar;
cvta.local.u32 ptr,lptr;
cvta.shared::cta.u32 p,As+4;
cvta.shared::cluster.u32 ptr, As;
cvta.to.global.u32 p,gptr;
cvta.param.u64 ptr,pvar;
cvta.to.param::entry.u64 epptr, ptr;
9.7.10.24. 数据移动与转换指令:cvt#
cvt
将一个值从一种类型转换为另一种类型。
语法
cvt{.irnd}{.ftz}{.sat}.dtype.atype d, a; // integer rounding
cvt{.frnd}{.ftz}{.sat}.dtype.atype d, a; // fp rounding
cvt.frnd2{.relu}{.satfinite}{.pzo}.f16.f32 d, a;
cvt.frnd2{.relu}{.satfinite}{.pzo}.f16x2.f32 d, a, b;
cvt.rs{.relu}{.satfinite}.f16x2.f32 d, a, b, rbits;
cvt.frnd2{.relu}{.satfinite}{.pzo}.bf16.f32 d, a;
cvt.frnd2{.relu}{.satfinite}{.pzo}.bf16x2.f32 d, a, b;
cvt.rs{.relu}{.satfinite}.bf16x2.f32 d, a, b, rbits;
cvt.rna{.satfinite}.tf32.f32 d, a;
cvt.frnd2{.satfinite}{.relu}{.pzo}.tf32.f32 d, a;
cvt.frnd2.satfinite{.relu}{.pzo}{.scaled::n1::ue8m0}.f8x2type.f32 d, a, b{, scale-factor};
cvt.frnd2.satfinite{.relu}{.pzo}{.scaled::n1::ue8m0}.f8x2type.fp16x2 d, a{, scale-factor};
cvt.rn{.relu}.f16x2.f8x2type d, a;
cvt.rn{.relu}{.satfinite}{.scaled::n2::ue8m0}.bf16x2.f8x2type d, a{, scale-factor};
cvt.rs{.relu}.satfinite.f8x4type.f32 d, {a, b, e, f}, rbits;
cvt.frnd2.satfinite{.relu}{.pzo}{.scaled::n1::ue8m0}.f4x2type.f32 d, a, b{, scale-factor};
cvt.frnd2.satfinite{.relu}{.pzo}{.scaled::n1::ue8m0}.f4x2type.fp16x2type d, a{, scale-factor};
cvt.rn{.relu}.f16x2.f4x2type d, a;
cvt.rn{.relu}{.satfinite}{.scaled::n2::ue8m0}.bf16x2.f4x2type d, a{, scale-factor};
cvt.rs{.relu}.satfinite.f4x4type.f32 d, {a, b, e, f}, rbits;
cvt.frnd2.satfinite{.relu}{.pzo}{.scaled::n1::ue8m0}.f6x2type.f32 d, a, b{, scale-factor};
cvt.frnd2.satfinite{.relu}{.pzo}{.scaled::n1::ue8m0}.f6x2type.fp16x2type d, a{, scale-factor};
cvt.rn{.relu}.f16x2.f6x2type d, a;
cvt.rn{.relu}{.satfinite}{.scaled::n2::ue8m0}.bf16x2.f6x2type d, a{, scale-factor};
cvt.rs{.relu}.satfinite.f6x4type.f32 d, {a, b, e, f}, rbits;
cvt.frnd3{.satfinite}.ue8m0x2.f32 d, a, b;
cvt.frnd3{.satfinite}.ue8m0x2.bf16x2 d, a;
cvt.rn.bf16x2.ue8m0x2 d, a;
cvt.frnd2.satfinite{.relu}{.scaled::n2::ue8m0}.s2f6x2.f32 d, a, b{, scale-factor};
cvt.frnd2.satfinite{.relu}{.scaled::n2::ue8m0}.s2f6x2.bf16x2 d, a{, scale-factor};
cvt.rn{.satfinite}{.relu}{.scaled::n2::ue8m0}.bf16x2.s2f6x2 d, a{, scale-factor};
cvt.frnd4{.satfinite}.ue5m3x2.f32 d, a, b;
cvt.frnd2{.satfinite}.scaled::n1::ue8m0.ue5m3x2.f32 d, a, b, scale-factor;
cvt.frnd4{.satfinite}.ue5m3x2.fp16x2type d, a;
cvt.frnd2{.satfinite}.scaled::n1::ue8m0.ue5m3x2.fp16x2type d, a, scale-factor;
cvt.rn.f16x2.ue5m3x2 d, a;
cvt.rn{.satfinite}{.scaled::n2::ue8m0}.bf16x2.ue5m3x2 d, a{, scale-factor};
.irnd = { .rni, .rzi, .rmi, .rpi };
.frnd = { .rn, .rz, .rm, .rp };
.frnd2 = { .rn, .rz };
.frnd3 = { .rz, .rp };
.frnd4 = { .rn, .rz, .rp };
.dtype = .atype = { .u8, .u16, .u32, .u64,
.s8, .s16, .s32, .s64,
.bf16, .f16, .f32, .f64 };
.f8x2type = { .e4m3x2, .e5m2x2 };
.f4x2type = { .e2m1x2 };
.f6x2type = { .e2m3x2, .e3m2x2 };
.f4x4type = { .e2m1x4 };
.f8x4type = { .e4m3x4, .e5m2x4 };
.f6x4type = { .e2m3x4, .e3m2x4 };
.fp16x2type = { .f16x2, .bf16x2 };
说明
在不同类型和大小之间进行转换。
对于 .f16x2 和 .bf16x2 指令类型,两个 .f32 类型的输入 a 和 b 被转换为
.f16 或 .bf16 类型,且转换后的值被打包进目标寄存器 d,使得由输入 a 转换而来的值存储在 d 的上半部,
由输入 b 转换而来的值存储在 d 的下半部。
对于 .f16x2 指令类型,目标操作数 d 具有 .f16x2 或 .b32 类型。对于
.bf16 指令类型,操作数 d 具有 .b16 类型。对于 .bf16x2 指令类型,
操作数 d 具有 .b32 类型。对于 .tf32 指令类型,操作数 d 具有 .b32 类型。
当转换为 .e4m3x2/.e5m2x2/.ue5m3x2 数据格式时,目标操作数 d 具有 .b16
类型。当将两个 .f32 输入转换为 .e4m3x2/.e5m2x2/.ue5m3x2 时,每个输入都被转换为指定格式,且转换后的值被打包进目标操作数 d,
使得由输入 a 转换而来的值存储在 d 的高 8 位,由输入 b 转换而来的值存储在 d 的低 8 位。当将 .f16x2/.bf16x2 输入转换为
.e4m3x2/ .e5m2x2/.ue5m3x2 时,操作数 a 中的每个 .f16/.bf16 输入都被转换为指定格式。转换后的值被打包进目标操作数 d,
使得由输入 a 的高 16 位转换而来的值存储在 d 的高 8 位,由输入 a 的低 16 位转换而来的值存储在 d 的低 8 位。
当从 .e4m3x2/.e5m2x2/.ue5m3x2 转换为 .f16x2/.bf16x2 时,源操作数 a 具有 .b16
类型。操作数 a 中的每个 8 位输入值都被转换为 .f16/.bf16 类型。转换后的值被打包进目标操作数 d,使得由 a
的高 8 位转换而来的值存储在 d 的高 16 位,由 a 的低 8 位转换而来的值存储在 d 的低 16 位。
对于 .bf16x2 目标类型,可与 .scaled::n2::ue8m0 限定符一起指定类型为 .b16 的可选 scale-factor 操作数。
操作数 scale-factor 存储两个打包的、类型为 .ue8m0 的缩放因子。输入先被转换为目标类型,再乘以 scale-factor。a
的高 8 位的缩放因子存储在操作数 scale-factor 的高 8 位,a 的低 8 位的缩放因子存储在操作数 scale-factor 的低 8 位。若未显式指定,
scale-factor 的值将被假定为 0x7f7f,即两个输入缩放因子均被假定为值 1。
当转换为 .e2m1x2 数据格式时,目标操作数 d 具有 .b8 类型。当将两个 .f32 输入转换为 .e2m1x2 时,
每个输入都被转换为指定格式,且转换后的值被打包进目标操作数 d,使得由输入 a 转换而来的值存储在 d 的高 4 位,由输入 b 转换而来的值
存储在 d 的低 4 位。当将 .f16x2/.bf16x2 输入转换为 .e2m1x2 时,操作数 a 中的每个 .f16/.bf16 输入都被转换为指定格式。
转换后的值被打包进 d,使得来自 a 高 16 位的值存储在 d 的高 4 位,来自 a 低 16 位的值存储在 d 的低 4 位。
当从 .e2m1x2 转换为 .f16x2/.bf16x2 时,源操作数 a 具有 .b8 类型。操作数 a 中的每个 4 位
输入值都被转换为 .f16/.bf16 类型。转换后的值被打包进目标操作数 d,使得由 a 的高 4 位转换而来的值存储在
d 的高 16 位,由 a 的低 4 位转换而来的值存储在 d 的低 16 位。
对于 .bf16x2 目标类型,可与 .scaled::n2::ue8m0 限定符一起指定类型为 .b16 的可选 scale-factor 操作数。操作数 scale-factor 存储两个打包的、类型为 .ue8m0
的缩放因子。输入先被转换为目标类型,再乘以 scale-factor。a 的高 4 位的缩放因子存储在操作数 scale-factor 的高 8 位,a 的低 4 位
的缩放因子存储在操作数 scale-factor 的低 8 位。若未显式指定,scale-factor 的值将被假定为 0x7f7f,即两个输入缩放因子均被假定为值 1。
当转换为 .e2m1x4 数据格式时,目标操作数 d 具有 .b16 类型。当将四个 .f32 输入转换为 .e2m1x4 时,
每个输入都被转换为指定格式,且转换后的值被打包进目标操作数 d,使得由输入 a、b、e、f 转换而来的值依次存储在从 d 高位开始的每个 4 位中。
当转换为 .e2m3x2/.e3m2x2 数据格式时,目标操作数 d 具有 .b16
类型。当将两个 .f32 输入转换为 .e2m3x2/.e3m2x2 时,每个输入都被转换为指定格式,且转换后的值被打包进目标操作数 d,使得由输入 a 转换而来的值
存储在 d 的高 8 位且其 2 个最高有效位(MSB)用零填充,由输入 b 转换而来的值存储在 d 的低 8 位且其 2 个 MSB 用零填充。当将 .f16x2/.bf16x2 输入转换为 .e2m3x2/.e3m2x2 时,
操作数 a 中的每个 .f16/.bf16 输入都被转换为指定格式。转换后的值被打包进目标操作数 d,使得来自输入 a 高 16 位的值
存储在 d 的高 8 位且其 2 个 MSB 用零填充,来自输入 a 低 16 位的值存储在 d 的低 8 位且其 2 个 MSB 用零填充。
当从 .e2m3x2/.e3m2x2 转换为 .f16x2/.bf16x2 时,源操作数 a 具有 .b16 类型。操作数 a 中每个带 2 个为 0 的 MSB 的 8 位输入值
都被转换为 .f16/.bf16 类型。转换后的值被打包进目标操作数 d,使得由 a 的高 8 位转换而来的值存储在 d 的高 16 位,由 a
的低 8 位转换而来的值存储在 d 的低 16 位。
对于 .bf16x2 目标类型,可与 .scaled::n2::ue8m0 限定符一起指定类型为 .b16 的可选 scale-factor 操作数。操作数 scale-factor 存储两个打包的、类型为 .ue8m0
的缩放因子。输入先被转换为目标类型,再乘以 scale-factor。a 的高 8 位的缩放因子存储在操作数 scale-factor 的高 8 位,a 的低 8 位
的缩放因子存储在操作数 scale-factor 的低 8 位。若未显式指定,scale-factor 的值将被假定为 0x7f7f,即两个输入缩放因子均被假定为值 1。
当转换为 .e5m2x4/.e4m3x4/.e3m2x4/.e2m3x4 数据格式时,目标
操作数 d 具有 .b32 类型。当将四个 .f32 输入转换为
.e5m2x4/.e4m3x4/.e3m2x4/.e2m3x4 时,每个输入都被转换为指定格式,
且转换后的值被打包进目标操作数 d,使得由输入 a、b、e、f 转换而来的值依次存储在从 d 高位开始的每个 8 位中。
对于 .e3m2x4/.e2m3x4,每个 8 位输出的 2 个 MSB 都用零填充。
当转换为 .ue8m0x2 数据格式时,目标操作数 d 具有 .b16 类型。当将两个 .f32 或两个打包的 .bf16 输入转换为 .ue8m0x2 时,
每个输入都被转换为指定格式,且转换后的值被打包进目标操作数 d,使得由输入 a 转换而来的值存储在 d 的高 8 位,由输入 b 转换而来的值存储在 d 的低 8 位。
当从 .ue8m0x2/.ue5m3x2 转换为 .bf16x2 时,源操作数 a 具有 .b16 类型。操作数 a 中的每个 8 位
输入值都被转换为 .bf16 类型。转换后的值被打包进目标操作数 d,使得由 a 的高 8 位转换而来的值存储在 d 的高 16 位,由 a 的低 8 位转换而来的值存储在
d 的低 16 位。
当转换为 .s2f6x2 数据格式时,目标操作数 d 具有 .b16 类型。当将两个 .f32 输入转换为 .s2f6x2 时,
每个输入都被转换为 .s2f6 值,且转换后的值被打包进目标操作数 d,使得由输入 a 转换而来的值存储在 d 的高 8 位,由输入 b 转换而来的值
存储在 d 的低 8 位。当从 .bf16x2 转换时,打包进操作数 a 的每个输入都被转换为 .s2f6 值,且转换后的值被打包进目标操作数
d,使得由输入 a 的高 8 位转换而来的值存储在操作数 d 的高 8 位,由输入 a 的低 8 位转换而来的值存储在操作数 d 的低 8 位。
可选操作数 scale-factor 具有 .b16 类型,存储两个打包的、类型为 .ue8m0 的缩放因子。对于下转换,输入先除以 scale-factor,再执行转换。a 的高 16 位的输入 a/.bf16
的缩放因子存储在操作数 scale-factor 的高 8 位,a 的低 16 位的输入 b/.bf16 的缩放因子存储在操作数 scale-factor 的低 8 位。
若未显式指定,scale-factor 的值将被假定为 0x7f7f,即两个输入缩放因子均被假定为值 1。
当从 .s2f6x2 转换为 .bf16x2 时,源操作数 a 具有 .b16 类型。操作数 a 中的每个 8 位
输入值都被转换为 .bf16 类型。转换后的值被打包进目标操作数 d,使得由 a 的高 8 位转换而来的值存储在 d 的高 16 位,由 a 的低 8 位转换而来的值存储在
d 的低 16 位。可选操作数 scale-factor 具有 .b16 类型,存储两个打包的、类型为 .ue8m0 的缩放因子。对于上转换,输入先被转换为目标类型,
再乘以 scale-factor。来自 a 的高 8 位的 .s2f6 输入的缩放因子存储在操作数 scale-factor 的高 8 位,来自 a 的低 8 位的 .s2f6 输入
的缩放因子存储在操作数 scale-factor 的低 8 位。若未显式指定,scale-factor 的值将被假定
为 0x7f7f,即两个输入缩放因子均被假定为值 1。
可选限定符 .scaled::n1::ue8m0 或 .scaled::n2::ue8m0 可用于指定该指令使用带有 1 个缩放值或 2 个打包缩放值(均为 ue8m0 类型)的 scale-factor。
操作数 scale-factor 必须与 .scaled::n1::ue8m0 或 .scaled::n2::ue8m0 两个限定符之一一起使用。
操作数 scale-factor:
与
.scaled::n2::ue8m0限定符一起使用时具有.b16类型。此时若未显式指定,scale-factor 的默认值为0x7f7f。与
.scaled::n1::ue8m0限定符一起使用时具有.b8类型。此时若未显式指定,scale-factor 的默认值为0x7f。
rbits 是一个 .b32 类型的寄存器操作数,用于为 .rs 舍入模式提供随机位。
当转换为 .f16x2 时,从 rbits 提供两个 16 位值:高 16 位的低 13 位用作操作数 a 的随机位(其 3 个 MSB 为 0),低 16 位的低 13 位用作操作数 b 的随机位(其 3 个 MSB 为 0)。
当转换为 .bf16x2 时,从 rbits 提供两个 16 位值:高 16 位用作操作数 a 的随机位,低 16 位用作操作数 b 的随机位。
当转换为 .e4m3x4/.e5m2x4/.e2m3x4/.e3m2x4 时,从 rbits 提供
两个 16 位值:低 16 位用于操作数 e、f,高 16 位用于操作数 a、b。
当转换为 .e2m1x4 时,从 rbits 提供两个 16 位值:rbits 两个 16 位半部各自的低 8 位用于操作数 e、f,
rbits 两个 16 位半部各自的高 8 位用于操作数 a、b。
在下列所有情形中,舍入修饰符都是必需的:
浮点到浮点转换,当目标类型小于源类型时
所有浮点到整数的转换
所有整数到浮点的转换
所有涉及
.f16x2、.e4m3x2, .e5m2x2,、.ue5m3x2、.bf16x2、.tf32、.e2m1x2、.e2m3x2、.e3m2x2、.e4m3x4、.e5m2x4、.e2m1x4、.e2m3x4、.e3m2x4、.s2f6x2和.ue8m0x2指令类型的转换。
.satfinite 修饰符仅支持涉及以下类型的转换:
.e4m3x2、.e5m2x2、.e2m1x2、.e2m3x2、.e3m2x2、.e4m3x4、.e5m2x4、.e2m1x4、.e2m3x4、.e3m2x4、.s2f6x2目标类型。对于此类转换,.satfinite修饰符是必需的。.f16、.bf16、.f16x2、.bf16x2、.tf32、.ue8m0x2、.ue5m3x2作为目标类型。
.pzo 限定符仅支持目标类型严格小于源类型的浮点到浮点转换。指定该限定符时,它强制输出中只生成正零。换言之,若转换结果产生 -0.0,它将被
强制为 +0.0。注意,.pzo 限定符仅作用于数据格式转换的结果。换言之,.pzo 限定符不影响 rbits 等其他附加操作数。
语义
if (/* inst type is .f16x2 or .bf16x2 */) {
d[31:16] = convert(a);
d[15:0] = convert(b);
} else if (/* inst destination type is .e5m2x2 or .e4m3x2 or .ue8m0x2 or .ue5m3x2 */) {
if (/* inst source type is .f32 */) {
d[15:8] = convert(a / scale-factor[7:0]); // scale-factor if present
d[7:0] = convert(b / scale-factor[7:0]); // scale-factor if present
} else {
d[15:8] = convert(a[31:16] / scale-factor[7:0]); // scale-factor if present
d[7:0] = convert(a[15:0] / scale-factor[7:0]); // scale-factor if present
}
} else if (/* inst destination type is .s2f6x2 */) {
if (/* inst source type is .f32 */) {
d[15:8] = convert(a / scale-factor[15:8]);
d[7:0] = convert(b / scale-factor[7:0]);
} else {
d[15:8] = convert(a[15:8] / scale-factor[15:8]);
d[7:0] = convert(a[7:0] / scale-factor[7:0]);
}
} else if (/* inst source type is .s2f6x2 */) {
d[31:16] = convert(a[15:8]) * scale-factor[15:8];
d[15:0] = convert(a[7:0]) * scale-factor[7:0];
} else if (/* inst destination type is .e2m1x2 */) {
if (/* inst source type is .f32 */) {
d[7:4] = convert(a / scale-factor[7:0]); // scale-factor if present
d[3:0] = convert(b / scale-factor[7:0]); // scale-factor if present
} else {
d[7:4] = convert(a[31:16] / scale-factor[7:0]); // scale-factor if present
d[3:0] = convert(a[15:0] / scale-factor[7:0]); // scale-factor if present
}
} else if (/* inst destination type is .e2m3x2 or .e3m2x2 */) {
if (/* inst source type is .f32 */) {
d[15:14] = 0;
d[13:8] = convert(a / scale-factor[7:0]); // scale-factor if present
d[7:6] = 0;
d[5:0] = convert(b / scale-factor[7:0]); // scale-factor if present
} else {
d[15:14] = 0;
d[13:8] = convert(a[31:16] / scale-factor[7:0]); // scale-factor if present
d[7:6] = 0;
d[5:0] = convert(a[15:0] / scale-factor[7:0]); // scale-factor if present
}
} else if (/* inst destination type is .e2m1x4 */) {
d[15:12] = convert(a);
d[11:8] = convert(b);
d[7:4] = convert(e);
d[3:0] = convert(f);
} else if (/* inst destination type is .e4m3x4 or .e5m2x4 */) {
d[31:24] = convert(a);
d[23:16] = convert(b);
d[15:8] = convert(e);
d[7:0] = convert(f);
} else if (/* inst destination type is .e2m3x4 or .e3m2x4 */) {
d[31:30] = 0;
d[29:24] = convert(a);
d[23:22] = 0;
d[21:16] = convert(b);
d[15:14] = 0;
d[13:8] = convert(e);
d[7:6] = 0;
d[5:0] = convert(f);
} else if (/* inst source type is .e4m3x2 or .e5m2x2 or .e3m2x2 or .e2m3x2 or .ue5m3x2 */) {
d[31:16] = convert(a[15:8]) * scale-factor[15:8]; // scale-factor if present for .bf16x2 dest type
d[15:0] = convert(a[7:0]) * scale-factor[7:0]; // scale-factor if present for .bf16x2 dest type
} else if (/* inst source type is .e2m1x2 */) {
d[31:16] = convert(a[7:4]) * scale-factor[15:8]; // scale-factor if present for .bf16x2 dest type
d[15:0] = convert(a[3:0]) * scale-factor[7:0]; // scale-factor if present for .bf16x2 dest type
} else {
d = convert(a);
}
// 用于 .rs 舍入的随机位 rbits 语义:
-
目标类型
.f16: 随机位布局细节参见 图 39。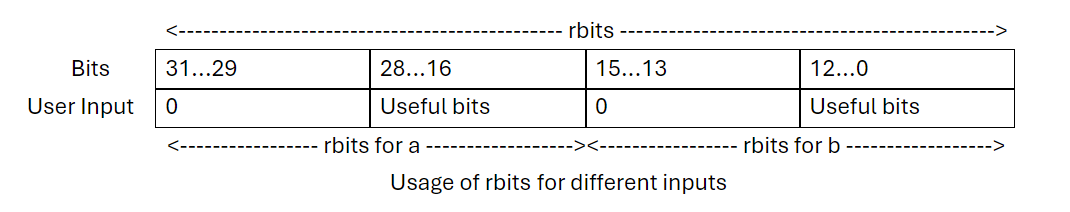
图 39 目标类型为
.f16时用于.rs舍入的随机位布局 -
目标类型
.bf16: 随机位布局细节参见 图 40。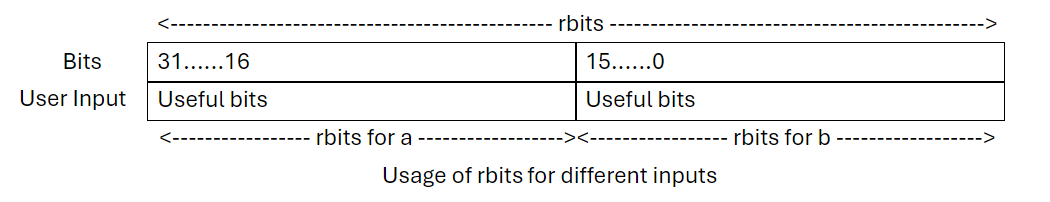
图 40 目标类型为
.bf16时用于.rs舍入的随机位布局 -
目标类型
.e2m1x4: 随机位布局细节参见 图 41。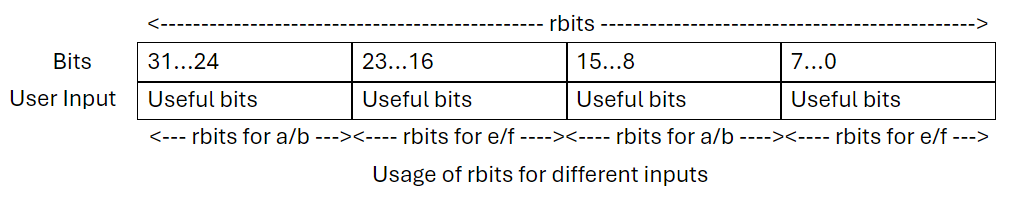
图 41 目标类型为
.e2m1x4时用于.rs舍入的随机位布局 -
目标类型
.e5m2x4、.e4m3x4、.e3m2x4、.e2m3x4: 随机位布局细节参见 图 42。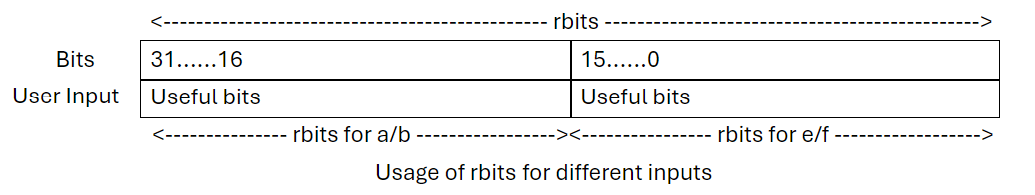
图 42 目标类型为
.e5m2x4/.e4m3x4/.e3m2x4/.e2m3x4时用于.rs舍入的随机位布局
示例
cvt.f32.s32 f,i;
cvt.s32.f64 j,r; // float-to-int saturates by default
cvt.rni.f32.f32 x,y; // round to nearest int, result is fp
cvt.f32.f32 x,y; // note .ftz behavior for sm_1x targets
cvt.rn.relu.f16.f32 b, f; // result is saturated with .relu saturation mode
cvt.rz.f16x2.f32 b1, f, f1; // convert two fp32 values to packed fp16 outputs
cvt.rn.relu.satfinite.f16x2.f32 b1, f, f1; // convert two fp32 values to packed fp16 outputs with .relu saturation on each output
cvt.rn.bf16.f32 b, f; // convert fp32 to bf16
cvt.rz.relu.satfinite.bf16.f3 2 b, f; // convert fp32 to bf16 with .relu and .satfinite saturation
cvt.rz.satfinite.bf16x2.f32 b1, f, f1; // convert two fp32 values to packed bf16 outputs
cvt.rn.relu.bf16x2.f32 b1, f, f1; // convert two fp32 values to packed bf16 outputs with .relu saturation on each output
cvt.rna.satfinite.tf32.f32 b1, f; // convert fp32 to tf32 format
cvt.rn.relu.tf32.f32 d, a; // convert fp32 to tf32 format
cvt.f64.bf16.rp f, b; // convert bf16 to f64 format
cvt.bf16.f16.rz b, f // convert f16 to bf16 format
cvt.bf16.u64.rz b, u // convert u64 to bf16 format
cvt.s8.bf16.rpi s, b // convert bf16 to s8 format
cvt.bf16.bf16.rpi b1, b2 // convert bf16 to corresponding int represented in bf16 format
cvt.rn.satfinite.e4m3x2.f32 d, a, b; // convert a, b to .e4m3 and pack as .e4m3x2 output
cvt.rn.relu.satfinite.e5m2x2.f16x2 d, a; // unpack a and convert the values to .e5m2 outputs with .relu
// saturation on each output and pack as .e5m2x2
cvt.rn.f16x2.e4m3x2 d, a; // unpack a, convert two .e4m3 values to packed f16x2 output
cvt.rn.satfinite.tf32.f32 d, a; // convert fp32 to tf32 format
cvt.rn.relu.f16x2.e2m1x2 d, a; // unpack a, convert two .e2m1 values to packed f16x2 output
cvt.rn.satfinite.e2m3x2.f32 d, a, b; // convert a, b to .e2m3 and pack as .e2m3x2 output
cvt.rn.relu.f16x2.e3m2x2 d, a; // unpack a, convert two .e3m2 values to packed f16x2 output
cvt.rs.f16x2.f32 d, a, b, rbits; // convert 2 fp32 values to packed fp16 with applying .rs rounding
cvt.rs.satfinite.e2m1x4.f32 d, {a, b, e, f}, rbits; // convert 4 fp32 values to packed 4 e2m1 values with applying .rs rounding
cvt.rn.satfinite.relu.e2m1x2.f16x2 d, a; // unpack a and convert to two .e2m1 values
cvt.rn.satfinite.e2m3x2.bf16x2 d, a; // unpack a and convert to two .e2m3 values
// Convert 2 f32 values to s2f6 after applying scale factor for dividing the value
cvt.rn.satfinite.scaled::n2::ue8m0.s2f6x2.f32 d, a, b, scale-factor;
cvt.rz.satfinite.e2m3x2.f32 d, a, b; // convert a, b to .e2m3 and pack as .e2m3x2 with round towards zero mode
cvt.rn.bf16.f32.pzo b, f; // convert fp32 to bf16 with positive zero’s only
cvt.rn.relu.satfinite.f16x2.f32.pzo b1, f, f1; // convert two fp32 values to packed fp16 outputs with .relu saturation on each output and produce positive zero’s only
cvt.rn.satfinite.scaled::n1::ue8m0.e4m3x2.bf16x2 b16_0, b32_0, b8_0;
cvt.bf16x2.e5m2x2.rn.relu.scaled::n2::ue8m0.satfinite d, a, scale-factor;
9.7.10.25. 数据移动与转换指令:cvt.pack#
cvt.pack
将两个整数值从一种整数类型转换为另一种整数类型,并打包结果。
语法
cvt.pack.sat.convertType.abType d, a, b;
.convertType = { .u16, .s16 }
.abType = { .s32 }
cvt.pack.sat.convertType.abType.cType d, a, b, c;
.convertType = { .u2, .s2, .u4, .s4, .u8, .s8 }
.abType = { .s32 }
.cType = { .b32 }
说明
将两个 32 位整数 a 和 b 转换为指定类型,并将结果打包进 d。
目标 d 是一个无符号 32 位整数。源操作数 a 和 b 是 .abType 类型的整数,源操作数 c 是 .cType 类型的整数。
输入 a 和 b 带饱和地被转换为 .convertType 所指定类型的值,且转换后的结果被打包进 d 的低位。
若指定操作数 c,则 d 的其余位从 c 的低位复制而来。
语义
ta = a < MIN(convertType) ? MIN(convertType) : a;
ta = a > MAX(convertType) ? MAX(convertType) : a;
tb = b < MIN(convertType) ? MIN(convertType) : b;
tb = b > MAX(convertType) ? MAX(convertType) : b;
size = sizeInBits(convertType);
td = tb ;
for (i = size; i <= 2 * size - 1; i++) {
td[i] = ta[i - size];
}
if (isU16(convertType) || isS16(convertType)) {
d = td;
} else {
for (i = 0; i < 2 * size; i++) {
d[i] = td[i];
}
for (i = 2 * size; i <= 31; i++) {
d[i] = c[i - 2 * size];
}
}
当相应输入不在 .convertType 所指定的数据类型范围内时,.sat 修饰符将转换后的值限制在 MIN(convertType).. MAX(convertedType) 范围内(无溢出)。
示例
cvt.pack.sat.s16.s32 %r1, %r2, %r3; // 32-bit to 16-bit conversion
cvt.pack.sat.u8.s32.b32 %r4, %r5, %r6, 0; // 32-bit to 8-bit conversion
cvt.pack.sat.u8.s32.b32 %r7, %r8, %r9, %r4; // %r7 = { %r5, %r6, %r8, %r9 }
cvt.pack.sat.u4.s32.b32 %r10, %r12, %r13, %r14; // 32-bit to 4-bit conversion
cvt.pack.sat.s2.s32.b32 %r15, %r16, %r17, %r18; // 32-bits to 2-bit conversion
9.7.10.26. 数据移动与转换指令:mapa#
mapa
将共享变量的地址映射到目标 CTA。
语法
mapa{.space}.type d, a, b;
// Maps shared memory address in register a into CTA b.
mapa.shared::cluster.type d, a, b;
// Maps shared memory variable into CTA b.
mapa.shared::cluster.type d, sh, b;
// Maps shared memory variable into CTA b.
mapa.shared::cluster.type d, sh + imm, b;
// Maps generic address in register a into CTA b.
mapa.type d, a, b;
.space = { .shared::cluster }
.type = { .u32, .u64 }
说明
获取与操作数 a 所指定地址相对应的、位于操作数 b 所指定 CTA 中的地址。
指令类型 .type 指示目标操作数 d 和源操作数 a 的类型。
当空间为 .shared::cluster 时,源 a 是一个共享内存变量,或是一个包含有效共享内存地址的寄存器,而寄存器 d 包含一个共享内存地址。当未指定可选限定符 .space 时,a 和 d 均为包含指向共享内存的通用地址的寄存器。
b 是一个 32 位整数操作数,表示目标 CTA 的秩。
目标寄存器 d 将保存与操作数 a 相对应的、位于 CTA b 中的地址。
示例
mapa.shared::cluster.u64 d1, %reg1, cta;
mapa.shared::cluster.u32 d2, sh, 3;
mapa.u64 d3, %reg2, cta;
9.7.10.27. 数据移动与转换指令:getctarank#
getctarank
生成该地址的 CTA 秩。
语法
getctarank{.space}.type d, a;
// Get cta rank from source shared memory address in register a.
getctarank.shared::cluster.type d, a;
// Get cta rank from shared memory variable.
getctarank.shared::cluster.type d, var;
// Get cta rank from shared memory variable+offset.
getctarank.shared::cluster.type d, var + imm;
// Get cta rank from generic address of shared memory variable in register a.
getctarank.type d, a;
.space = { .shared::cluster }
.type = { .u32, .u64 }
说明
将包含操作数 a 所指定地址的 CTA 的秩写入目标寄存器 d。
指令类型 .type 指示源操作数 a 的类型。
当空间为 .shared::cluster 时,源 a 是一个共享内存变量,或是一个包含有效共享内存地址的寄存器。当未指定可选限定符 .space 时,a 是一个包含指向共享内存的通用地址的寄存器。目标 d
始终是一个保存 CTA 秩的 32 位寄存器。
示例
getctarank.shared::cluster.u32 d1, addr;
getctarank.shared::cluster.u64 d2, sh + 4;
getctarank.u64 d3, src;
9.7.10.28. 数据移动与转换指令:异步拷贝#
异步拷贝操作在后台异步执行其底层操作,从而允许发起线程执行后续任务。
异步拷贝操作可以是处理大量数据的批量操作,也可以是处理较小数据的非批量操作。批量异步操作所处理的数据量必须是 16 字节的倍数。
异步拷贝操作通常包含以下顺序:
可选地,从 tensormap 读取。
从源位置读取数据。
将数据写入目标位置。
使写入对执行线程或其他线程可见。
9.7.10.28.1. 异步拷贝操作的完成机制#
线程必须显式等待异步拷贝操作完成,才能访问该操作的结果。异步拷贝操作一旦发起,在异步操作完成之前修改源内存位置或张量描述符,或从目标内存位置读取,都将表现未定义行为。
本节介绍 PTX 中支持的两种异步拷贝操作完成机制:异步组机制和基于 mbarrier 的机制。
异步操作可由上述任一完成机制跟踪,也可由两种机制同时跟踪。跟踪机制取决于具体的指令/指令变体。
9.7.10.28.1.1. 异步组机制#
使用异步组完成机制时,发起线程用一个提交操作指定一组异步操作(称为异步组),并用一个等待操作跟踪该组的完成。发起异步操作的线程必须为批量和非批量异步操作分别创建独立的异步组。
一个提交操作会创建一个每线程的异步组,其中包含由异步组完成机制跟踪、由执行线程发起、且在该提交操作之前的所有异步操作,但不包含提交操作之后的任何异步操作。一个已提交的异步操作只属于单个异步组。
当一个异步组完成时,属于该组的所有异步操作都已完成,发起这些异步操作的执行线程即可读取异步操作的结果。执行线程提交的所有异步组总是按其提交的顺序完成。异步组内部的各异步操作之间没有顺序关系。
将异步组用作完成机制的典型模式如下:
发起异步操作。
用一个提交操作将这些异步操作归入一个异步组。
用等待操作等待该异步组完成。
一旦异步组完成,即可访问该异步组中所有异步操作的结果。
9.7.10.28.1.2. 基于 mbarrier 的机制#
线程可以使用mbarrier 对象的当前阶段来跟踪一个或多个异步操作的完成。当mbarrier 对象的当前阶段完成时,意味着由该阶段跟踪的所有异步操作都已完成,且参与该mbarrier 对象的所有线程都可以访问异步操作的结果。
用于跟踪异步操作完成的mbarrier 对象,既可以作为其语法的一部分与异步操作一起指定,也可以作为一个独立操作指定。对于批量异步操作和 fabric 操作,必须在异步操作中指定mbarrier 对象;而对于非批量操作,可以在异步操作之后再指定它。
使用基于 mbarrier 的完成机制的典型模式如下:
发起异步操作。
设置一个mbarrier 对象,在其当前阶段跟踪这些异步操作,可作为异步操作的一部分,也可作为独立操作。
使用
mbarrier.test_wait或mbarrier.try_wait等待该mbarrier 对象完成其当前阶段。一旦
mbarrier.test_wait或mbarrier.try_wait操作返回True,即可访问由该mbarrier 对象跟踪的异步操作的结果。
9.7.10.28.1.3. 异步拷贝操作的报告机制#
拷贝方向为从 .global 到 .shared::cta 或 .shared::cluster 的异步拷贝操作,支持通过 mbarrier 对象报告数据有效性。
当指定限定符 .report_mechanism 时,拷贝操作会检查被拷贝的数据,并在数据符合限定符所指定模式时,在 mbarrier 上发出一次
report-on
操作。为避免数据检查,报告机制必须设为 .mbarrier::report::disabled。当未指定报告机制时,默认为 .mbarrier::report::disabled。
数据检查的粒度也作为限定符的一部分指定。注意,当为数据检查指定 .report_mechanism 时,相关联的 mbarrier 操作数必须已用布局 .layout::v1 初始化,否则行为未定义。有关 mbarrier 布局的更多细节,参见
mbarrier 对象的布局。
表 33 列出了所有支持的报告机制。
报告机制
|
元素 格式 |
匹配 位模式 |
被写入 源数据的粒度 |
数据检查 细节 |
检查结果 |
|
|---|---|---|---|---|---|---|
|
N/A |
N/A |
N/A |
无检查 |
N/A |
|
|
|
FP32 |
-0 |
4 个 FP32 元素的 16 字节 |
从源全局内存的对齐 16 字节块中采样的元素,与匹 排位模式相匹配 |
若模式匹配,则在 mbarrier 上发出一份 report-on 操作, 将负载报告更新为非零值。 具体而言,报告谓词被修改 为非零值;而报告值以幂等 方式被改动(与 0 按位原子 或运算) |
|
FP16 |
8 个 FP16 元素的 16 字节 |
||||
|
FP8 |
16 个 FP8 元素的 16 字节 |
||||
|
FP4 |
32 个 FP4 元素 的 16 字节 |
||||
|
|
8bit/ 4bit |
NaN / 0xF |
1 字节 |
每个元素都与匹 排位模式相匹配 |
|
9.7.10.28.2. 异步代理#
cp{.reduce}.async.bulk 操作在异步代理(或async 代理)中执行。
跨多个代理访问同一内存位置需要一道跨代理栅栏。对于async 代理,应使用 fence.proxy.async 在通用代理与 async 代理 之间同步内存。
cp{.reduce}.async.bulk 操作完成之后会跟随一道隐式的通用-异步代理栅栏。因此一旦观察到该异步操作的完成,其结果即对通用代理可见。必须使用异步组或基于 mbarrier 的完成机制来等待 cp{.reduce}.async.bulk 指令的完成。
9.7.10.28.3. 数据移动与转换指令:非批量拷贝#
9.7.10.28.3.1. 数据移动与转换指令:cp.async#
cp.async
发起一次从一个状态空间到另一个状态空间的异步拷贝操作。
语法
cp.async.ca.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
[dst], [src], cp-size{, src-size}{, cache_policy} ;
cp.async.cg.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
[dst], [src], 16{, src-size}{, cache_policy} ;
cp.async.ca.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
[dst], [src], cp-size{, ignore-src}{, cache_policy} ;
cp.async.cg.shared{::cta}.global{.level::cache_hint}{.level::prefetch_size}
[dst], [src], 16{, ignore-src}{, cache_policy} ;
.level::cache_hint = { .L2::cache_hint }
.level::prefetch_size = { .L2::64B, .L2::128B, .L2::256B }
cp-size = { 4, 8, 16 }
说明
cp.async 是一条非阻塞指令,它发起一次异步拷贝操作,将数据从源地址操作数 src 所指定的位置复制到目标地址操作数 dst 所指定的位置。操作数 src 指定全局状态空间中的一个位置,dst 指定共享状态空间中的一个位置。
操作数 cp-size 是一个整数常量,指定要复制到目标 dst 的数据字节大小。cp-size 只能为 4、8 或 16。
指令 cp.async 可选择性地指定一个 32 位整数操作数 src-size。操作数 src-size 表示要从 src 复制到 dst 的数据字节大小,且必须小于 cp-size。在这种情况下,目标 dst 中剩余的字节会被填充为零。指定大于 cp-size 的 src-size 会导致未定义行为。
可选的、非立即数的谓词参数 ignore-src 指定是否完全忽略来自源位置 src 的数据。若忽略源数据,则会将零复制到目标 dst。若未指定参数 ignore-src,则默认为 False。
操作数 src 和 dst 支持的对齐要求与寻址模式见 作为操作数的地址。
必需的 .async 限定符表示该 cp 指令将异步发起内存拷贝操作,并在拷贝操作完成之前就返回控制权给执行线程。随后,执行线程可使用
基于异步组的完成机制
或 基于 mbarrier 的完成机制
来等待异步拷贝操作完成。没有其他同步机制能保证这些异步拷贝操作的完成。
若两个 cp.async 操作未使用 cp.async.wait_all、cp.async.wait_group 或 mbarrier 指令 显式同步,则它们之间没有顺序保证。
如缓存运算符 所述,.cg 限定符表示仅在全局层级缓存 L2 中缓存数据而不在 L1 中缓存,而 .ca 限定符表示在所有层级(包括 L1 缓存)缓存数据。缓存运算符仅被视为性能提示。
在内存一致性模型 中,cp.async 被视为在通用代理中执行的一次弱内存操作。
.level::prefetch_size 限定符是一个提示,用于将指定大小的额外数据预取到相应缓存层级。子限定符 prefetch_size 可设为 64B、128B、256B 之一,从而允许预取大小分别为 64 字节、128 字节或 256 字节。
限定符 .level::prefetch_size 只能与 .global 状态空间一起使用,或用于指向 .global 状态空间的通用寻址。若通用地址不落在全局内存的地址窗口内,则预取行为未定义。
.level::prefetch_size 限定符仅被视为性能提示。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
限定符 .level::cache_hint 仅对 .global 状态空间以及对指向 .global 状态空间的通用寻址受支持。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
示例
cp.async.ca.shared.global [shrd], [gbl + 4], 4;
cp.async.ca.shared::cta.global [%r0 + 8], [%r1], 8;
cp.async.cg.shared.global [%r2], [%r3], 16;
cp.async.cg.shared.global.L2::64B [%r2], [%r3], 16;
cp.async.cg.shared.global.L2::128B [%r0 + 16], [%r1], 16;
cp.async.cg.shared.global.L2::256B [%r2 + 32], [%r3], 16;
createpolicy.fractional.L2::evict_last.L2::evict_unchanged.b64 cache_policy, 0.25;
cp.async.ca.shared.global.L2::cache_hint [%r2], [%r1], 4, cache_policy;
cp.async.ca.shared.global [shrd], [gbl], 4, p;
cp.async.cg.shared.global.L2::cache_hint [%r0], [%r2], 16, q, cache_policy;
9.7.10.28.3.2. 数据移动与转换指令:cp.async.commit_group#
cp.async.commit_group
将所有先前已发起但未提交的 cp.async 指令提交进一个 cp.async 组。
语法
cp.async.commit_group ;
说明
cp.async.commit_group 指令会为每个线程创建一个新的 cp.async 组,并将执行线程先前发起、但尚未提交到任何 cp.async 组 的所有 cp.async 指令一并归入这个新的 cp.async 组。若没有未提交的 cp.async 指令,则 cp.async.commit_group 产生一个空的 cp.async 组。
执行线程可使用 cp.async.wait_group 等待某个 cp.async 组 中所有 cp.async 操作完成。
同一 cp.async 组 内任意两个 cp.async 操作之间不提供任何内存顺序保证。因此,cp.async 组 内两个或多个 cp.async 操作向同一位置复制数据会导致未定义行为。
示例
// Example 1:
cp.async.ca.shared.global [shrd], [gbl], 4;
cp.async.commit_group ; // Marks the end of a cp.async group
// Example 2:
cp.async.ca.shared.global [shrd1], [gbl1], 8;
cp.async.ca.shared.global [shrd1+8], [gbl1+8], 8;
cp.async.commit_group ; // Marks the end of cp.async group 1
cp.async.ca.shared.global [shrd2], [gbl2], 16;
cp.async.cg.shared.global [shrd2+16], [gbl2+16], 16;
cp.async.commit_group ; // Marks the end of cp.async group 2
9.7.10.28.3.3. 数据移动与转换指令:cp.async.wait_group / cp.async.wait_all#
cp.async.wait_group, cp.async.wait_all
等待先前的异步拷贝操作完成。
语法
cp.async.wait_group N;
cp.async.wait_all ;
说明
cp.async.wait_group 指令会使执行线程等待,直到最近若干个 cp.async 组 中仅剩 N 个或更少仍处于挂起状态,且执行线程先前提交的所有 cp.async 组 都已完成。例如,当 N 为 0 时,执行线程等待所有先前的 cp.async 组 完成。操作数 N 是一个整数常量。
cp.async.wait_all 等价于:
cp.async.commit_group;
cp.async.wait_group 0;
空的 cp.async 组 被视为即时完成。
由 cp.async 操作执行的写入,仅会在以下情况之后才对执行线程可见:
cp.async.wait_all完成,或对该
cp.async所属的 cp.async 组 执行cp.async.wait_group完成,或mbarrier.test_wait 和 mbarrier.try_wait 在一个正跟踪该
cp.async操作完成的 mbarrier 对象 上返回True。
未与 cp.async.wait_all、cp.async.wait_group 或 mbarrier 对象 同步的两个 cp.async 操作之间没有顺序关系。
cp.async.wait_group 和 cp.async.wait_all 不会为 cp.async 以外的任何其他内存操作提供任何顺序与可见性保证。
示例
// Example of .wait_all:
cp.async.ca.shared.global [shrd1], [gbl1], 4;
cp.async.cg.shared.global [shrd2], [gbl2], 16;
cp.async.wait_all; // waits for all prior cp.async to complete
// Example of .wait_group :
cp.async.ca.shared.global [shrd3], [gbl3], 8;
cp.async.commit_group; // End of group 1
cp.async.cg.shared.global [shrd4], [gbl4], 16;
cp.async.commit_group; // End of group 2
cp.async.cg.shared.global [shrd5], [gbl5], 16;
cp.async.commit_group; // End of group 3
cp.async.wait_group 1; // waits for group 1 and group 2 to complete
9.7.10.28.4. 数据移动与转换指令:批量拷贝#
9.7.10.28.4.1. 数据移动与转换指令:cp.async.bulk#
cp.async.bulk
发起一次从一个状态空间到另一个状态空间的异步拷贝操作。
语法
// global -> shared::cta
cp.async.bulk{.sem}.dst.src.completion_mechanism{.level::cache_hint}{.ignore_oob}
[dstMem], [srcMem], size{, ignoreBytesLeft, ignoreBytesRight}, [mbar] {, cache_policy}
.sem = { .weak }
.dst = { .shared::cta }
.src = { .global }
.completion_mechanism = { .mbarrier::complete_tx::bytes{.report_mechanism} }
.level::cache_hint = { .L2::cache_hint }
.report_mechanism = { .mbarrier::report::disabled,
.mbarrier::report::validity::per_16bytes::80000000,
.mbarrier::report::validity::per_16bytes::8000,
.mbarrier::report::validity::per_16bytes::80,
.mbarrier::report::validity::per_16bytes::8,
.mbarrier::report::validity::per_element::ff
}
cp.async.bulk.sem.scope.dst.src.completion_mechanism{.level::cache_hint}{.ignore_oob}.type
[dstMem], [srcMem], size{, ignoreBytesLeft, ignoreBytesRight}, [mbar] {, cache_policy};
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .shared::cta }
.src = { .global }
.completion_mechanism = { .mbarrier::complete_tx::bytes{.report_mechanism} }
.level::cache_hint = { .L2::cache_hint }
.type = { .b128 }
.report_mechanism = { .mbarrier::report::disabled,
.mbarrier::report::validity::per_16bytes::80000000,
.mbarrier::report::validity::per_16bytes::8000,
.mbarrier::report::validity::per_16bytes::80,
.mbarrier::report::validity::per_16bytes::8,
.mbarrier::report::validity::per_element::ff
}
// global -> shared::cluster
cp.async.bulk{.sem}.dst.src.completion_mechanism{.multicast}{.level::cache_hint}
[dstMem], [srcMem], size, [mbar] {, ctaMask} {, cache_policy}
.sem = { .weak }
.dst = { .shared::cluster }
.src = { .global }
.completion_mechanism = { .mbarrier::complete_tx::bytes{.report_mechanism} }
.level::cache_hint = { .L2::cache_hint }
.multicast = { .multicast::cluster{::16b, ::32b} }
.report_mechanism = { .mbarrier::report::disabled,
.mbarrier::report::validity::per_16bytes::80000000,
.mbarrier::report::validity::per_16bytes::8000,
.mbarrier::report::validity::per_16bytes::80,
.mbarrier::report::validity::per_16bytes::8,
.mbarrier::report::validity::per_element::ff
}
cp.async.bulk.sem.scope.dst.src.completion_mechanism{.multicast}{.level::cache_hint}.type
[dstMem], [srcMem], size, [mbar] {, ctaMask} {, cache_policy};
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .shared::cluster }
.src = { .global }
.completion_mechanism = { .mbarrier::complete_tx::bytes{.report_mechanism} }
.level::cache_hint = { .L2::cache_hint }
.type = { .b128 }
.multicast = { .multicast::cluster{::16b, ::32b} }
.report_mechanism = { .mbarrier::report::disabled,
.mbarrier::report::validity::per_16bytes::80000000,
.mbarrier::report::validity::per_16bytes::8000,
.mbarrier::report::validity::per_16bytes::80,
.mbarrier::report::validity::per_16bytes::8,
.mbarrier::report::validity::per_element::ff
}
// shared::cta -> shared::cluster
cp.async.bulk{.sem}.dst.src.completion_mechanism [dstMem], [srcMem], size, [mbar]
.sem = { .weak }
.dst = { .shared::cluster }
.src = { .shared::cta }
.completion_mechanism = { .mbarrier::complete_tx::bytes }
cp.async.bulk.sem.scope.dst.src.completion_mechanism.type [dstMem], [srcMem], size, [mbar];
.sem = { .relaxed }
.scope = { .cta, .cluster }
.dst = { .shared::cluster }
.src = { .shared::cta }
.completion_mechanism = { .mbarrier::complete_tx::bytes }
.type = { .b128 }
// shared::cta -> global
cp.async.bulk{.sem}.dst.src.completion_mechanism{.level::cache_hint}{.cp_mask}
[dstMem], [srcMem], size {, cache_policy} {, byteMask}
.sem = { .weak }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.level::cache_hint = { .L2::cache_hint }
cp.async.bulk.sem.scope.dst.src.completion_mechanism{.level::cache_hint}{.cp_mask}.type
[dstMem], [srcMem], size {, cache_policy} {, byteMask};
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.level::cache_hint = { .L2::cache_hint }
.type = { .b128 }
说明
cp.async.bulk 是一条非阻塞指令,它发起一次异步批量拷贝操作,将数据从源地址操作数 srcMem 所指定的位置复制到目标地址操作数 dstMem 所指定的位置。
批量拷贝的方向是由 .src 修饰符所指定的状态空间到 .dst 修饰符所指定的状态空间。
32 位操作数 size 以字节数为单位指定要复制的内存量。size 必须是 16 的倍数。若该值不是 16 的倍数,则行为未定义。内存范围 [dstMem, dstMem + size - 1] 不得溢出目标内存空间,且内存范围 [srcMem, srcMem + size - 1] 不得溢出源内存空间。否则行为未定义。地址 dstMem 和 srcMem 必须 16 字节对齐。
可选限定符 .ignore_oob 表示 [srcMem .. srcMem+size) 的起始或结尾处最多 15 个字节可能越出某个全局内存分配的边界,且目标共享内存 [dstMem .. dstMem+size) 中相应字节的值不确定。32 位操作数 ignoreBytesLeft 和 ignoreBytesRight 用于指定 size 所界定的拷贝块起始与结尾处可能越界的字节数。ignoreBytesLeft 和 ignoreBytesRight 唯一有效的取值为 [0..15],任何其他取值都可能导致未定义行为。即便使用了 .ignore_oob 限定符,srcMem 和 dstMem 地址仍必须 16 字节对齐,且 size 操作数必须是 16 的倍数。限定符 .ignore_oob 仅适用于从全局到 .shared::cta 的拷贝方向。存在 .ignore_oob 时,若指定了限定符 .report_mechanism,则必须设为 .mbarrier::report::disabled。
当拷贝目标为 .shared::cta 时,目标地址必须位于执行线程所在 CTA 在 cluster 内的共享内存中,否则行为未定义。
当拷贝源为 .shared::cta 而目标为 .shared::cluster 时,目标必须位于 cluster 内另一个 CTA 的共享内存中。
修饰符 .completion_mechanism 指定该指令变体所支持的完成机制。各变体所支持的完成机制汇总于下表:
.completion-mechanism |
|
|
完成机制 |
|---|---|---|---|
|
|
|
基于 mbarrier |
|
|
||
|
|
||
|
|
|
批量异步组 基于 |
修饰符 .mbarrier::complete_tx::bytes 指定该 cp.async.bulk 变体使用基于 mbarrier 的完成机制。将以 completeCount 参数(等于所复制数据的字节量)在由操作数 mbar 指定的 mbarrier 对象上执行一次 complete-tx 操作。
该指令使用通用代理访问其 mbarrier 操作数。
修饰符 .bulk_group 指定该 cp.async.bulk 变体使用批量异步组完成机制。
可选限定符 .multicast::cluster 允许将数据从全局内存多播到 cluster 内多个 CTA 的共享内存。操作数 ctaMask 指定 cluster 内的目标 CTA,使得该 16 位(或 32 位)ctaMask 操作数中的每个位位置对应目标 CTA 的 %cluster_ctarank。可指定额外子限定符 ::16b 或 ::32b 以对应 ctaMask 参数的宽度。默认情况下,ctaMask 被假定为 16 位宽。源数据被多播到每个目标 CTA 共享内存中与 dstMem 相同的 CTA 相对偏移处。mbarrier 信号也被多播到目标 CTA 共享内存中与 mbar 相同的 CTA 相对偏移处。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。限定符 .level::cache_hint 仅在 .src 或 .dst 状态空间中至少有一个为 .global 状态空间时受支持。
可选限定符 .report_mechanism 指定 mbarrier 报告机制,如异步拷贝操作的报告机制 中所述。
当指定可选限定符 .cp_mask 时,参数 byteMask 是必需的。16 位宽的 byteMask 操作数中的第 i 位指定源数据每个 16 字节宽块的相应第 i 个字节是否被复制到目标。若该位置位,则复制该字节。
可选的 .sem 修饰符指定如内存一致性模型 所述的内存排序语义。
未指定
.sem时,默认为.weak。当
.sem为.weak时,数据拷贝操作以弱内存操作访问内存。当
.sem为.relaxed时,数据拷贝以自然对齐的强内存操作访问内存,其逐元素原子大小由.type指定,线程作用域由.scope指定。
如内存一致性模型 所述,在 mbarrier 上执行的
complete-tx 操作在 .cluster 作用域上具有 .release 语义。
示例
// .global -> .shared::cta (strictly non-remote):
cp.async.bulk.shared::cta.global.mbarrier::complete_tx::bytes [dstMem], [srcMem], size, [mbar];
cp.async.bulk.shared::cta.global.mbarrier::complete_tx::bytes.L2::cache_hint
[dstMem], [srcMem], size, [mbar], cache_policy;
// .global -> .shared::cluster:
cp.async.bulk.shared::cluster.global.mbarrier::complete_tx::bytes [dstMem], [srcMem], size, [mbar];
cp.async.bulk.shared::cluster.global.mbarrier::complete_tx::bytes.multicast::cluster
[dstMem], [srcMem], size, [mbar], ctaMask;
cp.async.bulk.shared::cluster.global.mbarrier::complete_tx::bytes.L2::cache_hint
[dstMem], [srcMem], size, [mbar], cache_policy;
cp.async.bulk.shared::cluster.global.mbarrier::complete_tx::bytes.multicast::cluster::32b
[dstMem], [srcMem], size, [mbar], ctaMask32;
// Validity check using 0x8000 pattern on every 16B
cp.async.bulk.shared::cluster.global.mbarrier::complete_tx::bytes.mbarrier::report::validity::per_16bytes::8000
[dstMem], [srcMem], size, [mbar];
// .shared::cta -> .shared::cluster (strictly remote):
cp.async.bulk.shared::cluster.shared::cta.mbarrier::complete_tx::bytes [dstMem], [srcMem], size, [mbar];
// .shared::cta -> .global:
cp.async.bulk.global.shared::cta.bulk_group [dstMem], [srcMem], size;
cp.async.bulk.global.shared::cta.bulk_group.L2::cache_hint} [dstMem], [srcMem], size, cache_policy;
// .shared::cta -> .global with .cp_mask:
cp.async.bulk.global.shared::cta.bulk_group.L2::cache_hint.cp_mask [dstMem], [srcMem], size, cache_policy, byteMask;
// ignore_oob
cp.async.bulk.shared::cta.global.mbarrier::complete_tx::bytes.ignore_oob [dstMem], [srcMem], size, ignoreBytesLeft, ignoreBytesRight, [mbar];
// .global -> .shared::cta with .relaxed scope and .b128 type
cp.async.bulk.relaxed.shared::cta.global.mbarrier::complete_tx::bytes.b128 [dstMem], [srcMem], size, [mbar];
cp.async.bulk.relaxed.shared::cta.global.mbarrier::complete_tx::bytes.L2::cache_hint.b128
[dstMem], [srcMem], size, [mbar], cache_policy;
9.7.10.28.4.2. 数据移动与转换指令:cp.reduce.async.bulk#
cp.reduce.async.bulk
发起一次异步归约操作。
语法
cp.reduce.async.bulk{.sem.scope}.dst.src.completion_mechanism.redOp.type
[dstMem], [srcMem], size, [mbar]
.sem = { .relaxed }
.scope = { .cta, .cluster }
.dst = { .shared::cluster }
.src = { .shared::cta }
.completion_mechanism = { .mbarrier::complete_tx::bytes }
.redOp= { .and, .or, .xor,
.add, .inc, .dec,
.min, .max }
.type = { .b32, .u32, .s32, .b64, .u64 }
cp.reduce.async.bulk{.sem.scope}.dst.src.completion_mechanism{.level::cache_hint}.redOp.type
[dstMem], [srcMem], size{, cache_policy}
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.level::cache_hint = { .L2::cache_hint }
.redOp= { .and, .or, .xor,
.add, .inc, .dec,
.min, .max }
.type = { .f16, .bf16, .b32, .u32, .s32, .b64, .u64, .s64, .f32, .f64 }
cp.reduce.async.bulk{.sem.scope}.dst.src.completion_mechanism{.level::cache_hint}.add.noftz.type
[dstMem], [srcMem], size{, cache_policy}
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.type = { .f16, .bf16, .f32 }
说明
cp.reduce.async.bulk 是一条非阻塞指令,它发起一次异步归约操作:以源地址操作数 srcMem 所指定的位置的数组为源,对目标地址操作数 dstMem 所指定的一组内存位置构成的数组执行归约。源数组与目标数组的大小必须相同,均由操作数 size 指定。
目标数组中的每个数据元素都与源数组中的相应数据元素就地执行归约,归约运算由修饰符 .redOp 指定。源数组与目标数组中每个数据元素的类型由修饰符 .type 指定。
源地址操作数 srcMem 位于 .src 所指定的状态空间中,目标地址操作数 dstMem 位于 .dst 所指定的状态空间中。
32 位操作数 size 以字节数为单位指定要从源位置复制并用于归约操作的内存量。size 必须是 16 的倍数。若该值不是 16 的倍数,则行为未定义。内存范围 [dstMem,
dstMem + size - 1] 不得溢出目标内存空间,且内存范围 [srcMem,
srcMem + size - 1] 不得溢出源内存空间。否则行为未定义。地址 dstMem 和 srcMem 必须 16 字节对齐。
.redOp 所支持的运算分类如下:
位宽运算为
.and、.or和.xor。整数运算为
.add、.inc、.dec、.min和.max。.inc和.dec运算在范围[0..x]内返回结果,其中x是源状态空间处的值。浮点运算
.add就近偶数舍入。cp.reduce.async.bulk.add.f16和cp.reduce.async.bulk.add.bf16运算需要.noftz限定符。它保留输入和结果的次正规数,不将其冲洗为零。cp.reduce.async.bulk.add.f32的默认行为等价于指定可选的.noftz限定符,后者保留输入和结果的次正规数,不将其冲洗为零。
下表描述了 .redOp 与元素类型的合法组合:
|
|
元素类型 |
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
修饰符 .completion_mechanism 指定该指令变体所支持的完成机制。各变体所支持的完成机制汇总于下表:
.completion-mechanism |
|
|
完成机制 |
|---|---|---|---|
|
|
|
基于 mbarrier |
|
|
||
|
|
|
批量异步组 基于 |
修饰符 .mbarrier::complete_tx::bytes 指定该 cp.reduce.async.bulk 变体使用基于 mbarrier 的完成机制。将以 completeCount 参数(等于所复制数据的字节量)在由操作数 mbar 指定的 mbarrier 对象上执行一次 complete-tx 操作。
该指令使用通用代理访问其 mbarrier 操作数。
修饰符 .bulk_group 指定该 cp.reduce.async.bulk 变体使用批量异步组完成机制。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。限定符 .level::cache_hint 仅在 .src 或 .dst 状态空间中至少有一个为 .global 状态空间时受支持。
可选的 .sem.scope 限定符指定本操作在 dstMem 中执行的每个单独逐元素归约的内存排序语义,如内存一致性模型 所述。这些归约在指定作用域上是逐元素原子的。源位置的访问是 .weak 的,即非原子的。未指定 .sem.scope 时,默认为 .relaxed.sys。
在内存一致性模型 中,cp.reduce.async.bulk 从 srcMem 执行的加载操作被视为弱内存操作,而在 mbarrier 上执行的 complete-tx
操作在 .cluster 作用域上具有 .release 语义。这些内存操作在异步代理中执行。
示例
cp.reduce.async.bulk.shared::cluster.shared::cta.mbarrier::complete_tx::bytes.add.u64
[dstMem], [srcMem], size, [mbar];
cp.reduce.async.bulk.shared::cluster.shared::cta.mbarrier::complete_tx::bytes.min.s32
[dstMem], [srcMem], size, [mbar];
cp.reduce.async.bulk.global.shared::cta.bulk_group.min.f16 [dstMem], [srcMem], size;
cp.reduce.async.bulk.global.shared::cta.bulk_group.L2::cache_hint.xor.s32 [dstMem], [srcMem], size, policy;
cp.reduce.async.bulk.global.shared::cta.bulk_group.add.noftz.f16 [dstMem], [srcMem], size;
cp.reduce.async.bulk.global.shared::cta.bulk_group.add.noftz.f32 [dstMem], [srcMem], size;
cp.reduce.async.bulk.relaxed.cta.global.bulk_group.add.u64 [dstMem], [srcMem], size, [mbar];
9.7.10.28.4.3. 数据移动与转换指令:cp.async.bulk.prefetch#
cp.async.bulk.prefetch
向系统提供提示,发起将数据异步预取到缓存的操作。
语法
cp.async.bulk.prefetch.L2.src{.level::cache_hint} [srcMem], size {, cache_policy};
cp.async.bulk.prefetch.L2.src{.level::eviction_priority} [srcMem], size;
.src = { .global }
.level::cache_hint = { .L2::cache_hint }
.level::eviction_priority = { .L2::evict_last }
说明
cp.async.bulk.prefetch 是一条非阻塞指令,它可能发起一次异步预取,将从 .src 状态空间中由源地址操作数 srcMem 所指定的位置的数据预取到 L2 缓存。
32 位操作数 size 以字节数为单位指定要预取的内存量。size 必须是 16 的倍数。若该值不是 16 的倍数,则行为未定义。地址 srcMem 必须 16 字节对齐。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
在内存一致性模型 中,cp.async.bulk.prefetch 被视为弱内存操作。
限定符 .level::eviction_priority 指定要应用于被预取缓存行的逐出优先级。
示例
cp.async.bulk.prefetch.L2.global [srcMem], size;
cp.async.bulk.prefetch.L2.global.L2::cache_hint [srcMem], size, policy;
cp.async.bulk.prefetch.L2.global.L2::evict_last [srcMem], size;
9.7.10.28.4.4. 数据移动与转换指令:multimem.cp.async.bulk#
multimem.cp.async.bulk
发起一次到某个 multimem 地址范围的异步拷贝操作。
语法
multimem.cp.async.bulk{.sem}.dst.src.completion_mechanism{.cp_mask}
[dstMem], [srcMem], size{, byteMask};
.sem = { .weak }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
plaintext
multimem.cp.async.bulk.sem.scope.dst.src.completion_mechanism{.cp_mask}.type
[dstMem], [srcMem], size{, byteMask};
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.type = { .b128 }
plaintext
说明
指令 multimem.cp.async.bulk 发起一次异步批量拷贝操作,从源地址范围 [srcMem, srcMem + size) 复制到由目标 multimem 地址范围 [dstMem, dstMem + size) 所引用的、位于各 GPU 内存上的存储位置。批量拷贝的方向是由 .src 修饰符所指定的状态空间到 .dst 修饰符所指定的状态空间。
32 位操作数 size 以字节数为单位指定要复制的内存量。操作数 size 必须是 16 的倍数。内存范围 [dstMem, dstMem + size) 不得溢出目标 multimem 内存空间。内存范围 [srcMem, srcMem + size) 不得溢出源内存空间。地址 dstMem 和 srcMem 必须 16 字节对齐。若不满足上述任一前提条件,则行为未定义。
修饰符 .completion_mechanism 指定该指令所支持的完成机制。修饰符 .bulk_group 指定 multimem.cp.async.bulk 指令使用基于批量异步组的完成机制。
当指定可选修饰符 .cp_mask 时,参数 byteMask 是必需的。16 位宽的 byteMask 操作数中的第 i 位指定源数据每个 16 字节宽块的相应第 i 个字节是否被复制到目标。若该位置位,则复制该字节。
可选的 .sem 限定符指定如内存一致性模型 所述的内存排序语义。
未指定
.sem时,默认为.weak。当
.sem为.weak时,数据拷贝操作以弱内存操作访问内存。当
.sem为.relaxed时,数据拷贝以自然对齐的强内存操作访问内存,其逐元素原子大小由.type指定,线程作用域由.scope指定。
示例
multimem.cp.async.bulk.global.shared::cta.bulk_group [dstMem], [srcMem], size;
multimem.cp.async.bulk.global.shared::cta.bulk_group [dstMem], [srcMem], 512;
multimem.cp.async.bulk.global.shared::cta.bulk_group.cp_mask [dstMem], [srcMem], size, byteMask;
multimem.cp.async.bulk.relaxed.cta.global.bulk_group.b128 [dstMem], [srcMem], size;
9.7.10.28.4.5. 数据移动与转换指令:multimem.cp.reduce.async.bulk#
multimem.cp.reduce.async.bulk
发起一次到某个 multimem 地址范围的异步归约操作。
语法
multimem.cp.reduce.async.bulk{.sem.scope}.dst.src.completion_mechanism.redOp.type [dstMem], [srcMem], size;
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.redOp = { .and, .or, .xor,
.add, .inc, .dec,
.min, .max }
.type = { .f16, .bf16,
.b32, .u32, .s32,
.b64, .u64, .s64,
.f32, .f64 }
plaintext
multimem.cp.reduce.async.bulk{.sem.scope}.dst.src.completion_mechanism.add.noftz.type [dstMem], [srcMem], size;
.sem = { .relaxed }
.scope = { .cta, .cluster, .gpu, .sys }
.dst = { .global }
.src = { .shared::cta }
.completion_mechanism = { .bulk_group }
.type = { .f16, .bf16, .f32 }
plaintext
说明
指令 multimem.cp.reduce.async.bulk 发起一次逐元素的异步归约操作:以源内存地址范围 [srcMem, srcMem + size) 中的元素,对由 multimem 目标地址范围 [dstMem, dstMem + size) 所引用的、位于各 GPU 内存上的存储位置执行归约。
目标数组中的每个数据元素都与源数组中的相应数据元素就地执行归约,归约运算由修饰符 .redOp 指定。源数组与目标数组中每个数据元素的类型由修饰符 .type 指定。
源地址操作数 srcMem 位于 .src 所指定的状态空间中,目标地址操作数 dstMem 位于 .dst 所指定的状态中。
32 位操作数 size 以字节数为单位指定要从源位置复制并用于归约操作的内存量。操作数 size 必须是 16 的倍数。内存范围 [dstMem, dstMem + size) 不得溢出目标 multimem 内存空间。内存范围 [srcMem, srcMem + size) 不得溢出源内存空间。地址 dstMem 和 srcMem 必须 16 字节对齐。若不满足上述任一前提条件,则行为未定义。
.redOp 所支持的运算分类如下:
位宽运算为 .and、.or 和 .xor。
整数运算为 .add、.inc、.dec、.min 和 .max。.inc 和
.dec 运算在范围 [0..x] 内返回结果,其中 x 是源状态空间处的值。
浮点运算 .add 就近偶数舍入,保留输入和结果的次正规数,不将其冲洗为零。
multimem.cp.reduce.async.bulk.add.f16 和 multimem.cp.reduce.async.bulk.add.bf16
运算需要 .noftz 限定符。它保留输入和结果的次正规数,不将
其冲洗为零。multimem.cp.reduce.async.bulk.add.f32 的默认行为等价于指定可选的
.noftz 限定符,后者保留输入和结果的次正规数,不将其冲洗为零。
下表描述了 .redOp 与元素类型的合法组合:
.redOp |
元素类型 |
|---|---|
.add |
.u32, .s32, .u64, .f32, .f64, .f16, .bf16 |
.min, .max |
.u32, .s32, .u64, .s64, .f16, .bf16 |
.inc, .dec |
.u32 |
.and, .or, .xor |
.b32, .b64 |
修饰符 .completion_mechanism 指定该指令所支持的完成机制。修饰符 .bulk_group 指定 multimem.cp.reduce.async.bulk 使用基于批量异步组的完成机制。
可选的 .sem.scope 限定符指定本操作在 dstMem 中执行的每个单独逐元素归约的内存排序语义,如内存一致性模型 所述。这些归约在指定作用域上是逐元素原子的。源位置的访问是 .weak 的,即非原子的。未指定 .sem.scope 时,默认为 .relaxed.sys。
在内存一致性模型 中,multimem.cp.reduce.async.bulk 从 srcMem 执行的加载操作被视为弱内存操作。
示例
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.add.u32 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.xor.b64 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.inc.u32 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.dec.u32 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.max.s32 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.add.noftz.f16 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.min.bf16 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.add.noftz.bf16 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.global.shared::cta.bulk_group.add.noftz.f32 [dstMem], [srcMem], size;
multimem.cp.reduce.async.bulk.relaxed.cta.global.bulk_group.add.u64 [dstMem], [srcMem], size, [mbar];
9.7.10.28.5. 数据移动与转换指令:张量拷贝#
9.7.10.28.5.1. 张量拷贝指令的限制#
以下是对类型 .b4x16、.b4x16_p64、.b6x16_p32 和
.b6p2x16 的限制:
cp.reduce.async.bulk不支持类型.b4x16、.b4x16_p64、.b6x16_p32和.b6p2x16。方向为
.global.shared::cta的cp.async.bulk.tensor不支持 类型.b4x16_p64。方向为
.shared::cluster.global的cp.async.bulk.tensor在sm_120a上不支持 亚字节类型。OOB-NaN 填充模式不支持类型
.b4x16、.b4x16_p64、.b6x16_p32和.b6p2x16。-
Box-Size[0] 必须恰为:
-
对于
b6x16_p32和.b6p2x16:在
sm_107f上,对.shared::cluster.global和.shared::cta.global方向为 128B。在
sm_107f上,对.global.shared::cta方向为 64B 或 128B。在
sm_100f上为 96B。
对于
b4x16_p64为 64B。
-
-
Tensor-Size[0] 必须是以下值的倍数:
-
对于
b6x16_p32和.b6p2x16:在
sm_107f上,对.shared::cluster.global和.shared::cta.global方向为 128B。在
sm_107f上,对.global.shared::cta方向为 64B 或 128B。在
sm_100f上为 96B。
对于
b4x16_p64为 64B。
-
对于
.b4x16_p64、.b6x16_p32和.b6p2x16,tensorCoords 参数向量中的第一个坐标必须是 128 的倍数。对于
.b4x16_p64、.b6x16_p32和.b6p2x16,全局内存地址必须 32B 对齐。 此外,每个维度的张量步幅必须 32B 对齐。-
对于
.b6x16_p32和.b6p2x16:在
sm_107f上,对.shared::cluster.global和.shared::cta.global方向, 全局内存地址必须 32B 对齐。此外,每个维度的张量步幅必须 32B 对齐。在
sm_100f上,全局内存地址必须 32B 对齐。此外,每个维度的张量步幅 必须 32B 对齐。
-
对于
.b6x16_p32和.b6p2x16:在
sm_107f上,对.global.shared::cta方向,全局内存地址必须 16B 对齐。 此外,每个维度的张量步幅必须 16B 对齐。在
sm_100f上,全局内存地址必须 32B 对齐。此外,每个维度的张量步幅必须 32B 对齐。
-
.b4x16_p64支持以下 swizzle 模式:无。
128B(涵盖所有可能的 swizzle 原子性取值,以下除外:32B 配 8B flip)
-
.b6x16_p32和.b6p2x16支持以下 swizzle 模式:无。
在
sm_107f上,带 16B 原子性的 64-Byte swizzle。在
sm_107f上,带 16B、32B 和 64B 原子性的 128-Byte swizzle。在
sm_100f上,128-Byte(涵盖所有可能的 swizzle 原子性取值,以下除外:32B 配 8B flip)。
-
.b6x16_p32和.b6p2x16不支持以下 swizzle 模式:带 16B 原子性的 32-Byte swizzle
带 32B 原子性并含 8B flip 的 128-Byte swizzle
以下是对 96B swizzle 模式的限制:
.swizzle_atomicity必须为 16B。不得设置
.interleave_layout。Box-Size[0] 必须小于或等于 96B。
类型不得为以下之一:
.b4x16_p64、.b6x16_p32和.b6p2x16。.load_mode不得设为.im2col::w::128。
以下是对具有「32 字节原子性配 8 字节 flip」子模式的 128 字节 swizzle 模式的限制:
拷贝方向必须为
.shared::cluster.global或.shared::cta.global。.load_mode不得设为.im2col::w、.im2col::w::128。
以下是对 .global.shared::cta 方向的限制:
-
边界框(
tensorCoords)的起始坐标必须非负,但以下情形除外:在
sm_107f上,对.tile::scatter4模式,边界框(tensorCoords)的起始坐标 可为负。
-
沿 D、W、H 维度的边界框必须保持在张量边界之内。这意味着:
边界框下角必须非负。
边界框上角必须非正。
以下是针对 sm_120a 的限制:
-
方向为
.shared::cluster.global的cp.async.bulk.tensor不支持:亚字节类型
限定符
.swizzle_atomicity
以下是针对 sm_103a 的限制(在方向为 .global.shared::cta 的
cp.async.bulk.tensor 上使用类型 .b6p2x16 时):
Box-Size[0] 必须恰为 48B 或 96B 之一。
全局内存地址必须 16B 对齐。
每个维度的张量步幅必须 16B 对齐。
tensorCoords 参数向量中的第一个坐标必须是 64 的倍数。
Tensor-Size[0] 必须是 48B 的倍数。
-
支持以下 swizzle 模式:
无。
128B(涵盖所有可能的 swizzle 原子性取值,以下除外:32B 配 8B flip)
带 16B swizzle 原子性的 64B swizzle
9.7.10.28.5.2. 覆盖张量属性值#
操作张量数据的 PTX 指令需要一个不透明的张量映射对象。
张量映射(tensor-map)指定了与张量相关的各种属性。
某些 PTX 指令在用 .override::* 限定符修饰时,会忽略张量映射中的某个特定属性;转而使用该属性的显式指令操作数值。
以下小节介绍覆盖张量映射对象中各种属性相关的语义。
9.7.10.28.5.2.1. 张量基地址覆盖#
可选限定符 .override::global_address 允许覆盖张量基地址。当指定
.override::global_address 时,不透明 tensorMap 对象中存在的全局内存地址被忽略,转而使用显式 64 位操作数
gAddrToOverride 所指定的地址。gAddrToOverride 地址必须 16B 对齐;否则将引发运行时错误。
此外,内存地址范围 [gAddrToOverride, gAddrToOverride + 128 KiB) 必须已分配且在执行期间可访问;否则行为未定义。
9.7.10.28.5.2.2. 张量属性覆盖#
可选限定符 .override_attribute 允许覆盖张量属性。
唯一允许被覆盖的属性是全局维度(global_dim)和全局步幅(global_stride)。当指定限定符
.override_attribute 时,tensorMap 对象中的属性值被忽略,转而使用通过额外操作数 attributeOverrideInfo 指定的值。
有效使用 .override_attribute 限定符必须满足以下条件:
作为张量属性覆盖的一部分,张量基地址覆盖也必须随之进行。换言之,在使用
.override_attribute限定符时,必须同时指定.override::global_address限定符。张量数据访问模式必须为 tile。即若指定
.load_mode,必须设为.tile。若指定可选的
.multicast限定符,则必须为.multicast::cluster::32b。由操作数
tensorCoords指定的张量起始坐标必须为零,否则行为未定义。
.override_attribute 限定符可取以下两个值:.override::global_dim 和 .override::global_dim_stride。
对于 .1d 张量,由于不存在步幅,因此只有 .override::global_dim 有效。
对于维数至少为 2 的张量,维度和步幅必须一起覆盖,因此只有 .override::global_dim_stride 有效。
attributeOverrideInfo 操作数的形式取决于 .override_attribute 限定符所取的值,汇总于
表 34。
|
有效的 |
|
|---|---|---|
|
|
|
|
|
|
使用 .override::global_dim 时,操作数 tensorSizeToOverride 指定维度的新值。此时,操作数 tensorSizeToOverride 是一个花括号包围的向量表达式,由一个单元素的 8 位或 16 位寄存器组成。注意,当指定 .b16 寄存器时,8 位值必须置于寄存器操作数的低半部。
当指定 .override::global_dim_stride 时,操作数 tensorSizeToOverride 必须是一个向量表达式,其 8 位或 16 位寄存器元素个数与限定符 .dim 所指定的张量维数完全一致。注意,当指定包含 .b16 寄存器的向量时,8 位值必须置于每个寄存器操作数的低半部。此时,额外的操作数
tensorLowerStrideToOverride 和 tensorUpperStrideToOverride 分别指定用于张量低步幅和张量高步幅的新值。tensorLowerStrideToOverride 是一个花括号包围、由 32 位寄存器组成的向量表达式。tensorLowerStrideToOverride 的向量大小必须比 .dim 给出的张量维数少一。
tensorUpperStrideToOverride 操作数必须是单个 .b16 寄存器,其中至多容纳四个 4 位张量高步幅值。tensorUpperStrideToOverride 操作数内打包的 4 位张量高步幅值总数必须比 .dim 给出的张量维数少一,否则行为未定义。tensorUpperStrideToOverride 中任何未使用的位可填零。例如,当 .dim 设为 .4d 时,tensorUpperStrideToOverride 操作数的低 12 位指定张量高步幅值,而高 4 位可置零。
|
操作数的性质 |
|---|---|
|
由 |
|
大小为 |
|
单个 |
对每个张量维度,按下方等式对 tensorLowerStrideToOverride 和
tensorUpperStrideToOverride 所指定的值进行运算,以计算出实际使用的有效全局步幅(global_stride)值,取代 tensorMap 对象中原本存在的值。
tensorGlobalStride[i] = ((tensorLowerStrideToOverride[i] + (tensorUpperStrideToOverride[i] << 32)) << 4);
9.7.10.28.5.3. 数据移动与转换指令:cp.async.bulk.tensor#
cp.async.bulk.tensor
发起一次在张量数据上、从一个状态空间到另一个状态空间的异步拷贝操作。
语法
// global -> shared::cta
cp.async.bulk.tensor.dim.dst.src{.load_mode}.completion_mechanism{.cta_group}{.level::cache_hint}{.override::global_address}{.override_attribute}
[dstMem], [tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords], [mbar]{, im2colInfo} {, cache_policy}
.dst = { .shared::cta }
.src = { .global }
.dim = { .1d, .2d, .3d, .4d, .5d }
.completion_mechanism = { .mbarrier::complete_tx::bytes{.report_mechanism} }
.cta_group = { .cta_group::1, .cta_group::2 }
.load_mode = { .tile, .tile::gather4, .im2col, .im2col::w, .im2col::w::128 }
.level::cache_hint = { .L2::cache_hint }
.override_attribute = { .override::global_dim, .override::global_dim_stride }
.report_mechanism = { .mbarrier::report::disabled,
.mbarrier::report::validity::per_16bytes::80000000,
.mbarrier::report::validity::per_16bytes::8000,
.mbarrier::report::validity::per_16bytes::80,
.mbarrier::report::validity::per_16bytes::8,
.mbarrier::report::validity::per_element::ff
}
// global -> shared::cluster
cp.async.bulk.tensor.dim.dst.src{.load_mode}.completion_mechanism{.multicast}{.cta_group}{.level::cache_hint}{.override::global_address}{.override_attribute}
[dstMem], [tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords], [mbar]{, im2colInfo}
{, ctaMask} {, cache_policy}
.dst = { .shared::cluster }
.src = { .global }
.dim = { .1d, .2d, .3d, .4d, .5d }
.completion_mechanism = { .mbarrier::complete_tx::bytes{.report_mechanism} }
.cta_group = { .cta_group::1, .cta_group::2 }
.load_mode = { .tile, .tile::gather4, .im2col, .im2col::w, .im2col::w::128 }
.level::cache_hint = { .L2::cache_hint }
.multicast = { .multicast::cluster{::16b, ::32b} }
.override_attribute = { .override::global_dim, .override::global_dim_stride }
.report_mechanism = { .mbarrier::report::disabled,
.mbarrier::report::validity::per_16bytes::80000000,
.mbarrier::report::validity::per_16bytes::8000,
.mbarrier::report::validity::per_16bytes::80,
.mbarrier::report::validity::per_16bytes::8,
.mbarrier::report::validity::per_element::ff
}
// shared::cta -> global
cp.async.bulk.tensor.dim.dst.src{.load_mode}.completion_mechanism{.level::cache_hint}{.override::global_address}{.override_attribute}
[tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords], [srcMem] {, cache_policy}
.dst = { .global }
.src = { .shared::cta }
.dim = { .1d, .2d, .3d, .4d, .5d }
.completion_mechanism = { .bulk_group }
.load_mode = { .tile, .tile::scatter4, .im2col_no_offs, .im2col_no_offs::w }
.level::cache_hint = { .L2::cache_hint }
.override_attribute = { .override::global_dim, .override::global_dim_stride }
说明
cp.async.bulk.tensor 是一条非阻塞指令,它发起一次张量数据的异步拷贝操作,从 .src 状态空间中的位置复制到 .dst 状态空间中的位置。
操作数 dstMem 指定 .dst 状态空间中张量数据要被复制入的位置,srcMem 指定 .src 状态空间中张量数据要被复制出的位置。
当 .dst 指定为 .shared::cta 时,地址 dstMem 必须位于 cluster 内执行线程所在 CTA 的共享内存中,否则行为未定义。当 .dst 为
.shared::cta 时,mbarrier 对象 mbar 也必须位于执行 CTA 的共享内存中,否则行为未定义。若 mbarrier 对象 mbar 位于 cluster 内另一个 CTA 的共享内存中(远程屏障),则 .dst 必须指定为 .shared::cluster,否则行为未定义。
当 .dst 指定为 .shared::cluster 时,地址 dstMem 可位于当前 cluster 内任一 CTA 的共享内存中。
操作数 tensorMap 是不透明张量映射对象的通用地址,该对象位于 .param 空间、.const 空间或 .global 空间中。操作数 tensorMap 指定张量拷贝操作的属性,如张量映射 所述。
tensorMap 在 tensormap 代理中被访问。有关在主机侧创建张量映射对象的内容,请参考 CUDA programming guide。
张量数据的维度由 .dim 修饰符指定。
向量操作数 tensorCoords 指定全局内存中张量数据的起始坐标,拷贝操作由此处执行或复制至此。各张量坐标在 tensorCoords 中类型为 .s32。向量参数 tensorCoords 的格式取决于所指定的 .load_mode,如下:
.load_mode |
tensorCoords |
语义 |
|---|---|---|
|
{col_idx, row_idx0, row_idx1, row_idx2, row_idx3} |
长度为 5 的定长向量。 五个元素共同指定四行的起始 坐标。 |
|
||
其余全部 |
{d0, .., dn} for n = .dim |
n 个元素组成的向量,其中 n = .dim。 各元素指示在每一个维度上的 偏移。 |
修饰符 .completion_mechanism 指定该指令变体所支持的完成机制。各变体所支持的完成机制汇总于下表:
.completion-mechanism |
|
|
完成机制 |
|
|---|---|---|---|---|
完成整个异步操作 所需 |
可选地用于读取 tensormap 对象完成的场合 |
|||
|
|
|
基于 mbarrier |
批量异步组 基于 |
|
|
|||
|
|
|
批量异步组 基于 |
|
修饰符 .mbarrier::complete_tx::bytes 指定该 cp.async.bulk.tensor 变体使用基于 mbarrier 的完成机制。在异步拷贝操作完成后,将以 completeCount 参数(等于所复制数据的字节量)在由操作数 mbar 指定的 mbarrier 对象上执行一次
complete-tx 操作。
该指令使用通用代理访问其 mbarrier 操作数。
当 mbarrier 对象 mbar 位于 cluster 内另一个 CTA 的共享内存中(远程屏障)时,.dst 必须指定为 .shared::cluster;在此情形下将
.shared::cta 用作 .dst 不会向远程屏障发出信号,并导致未定义行为。
修饰符 .cta_group 只能与基于 mbarrier 的完成机制一起使用。修饰符 .cta_group 用于在CTA 对中向奇数号 CTA 或偶数号 CTA 发出信号。当指定 .cta_group::1 时,所指定的 mbarrier 对象 mbar
必须与共享内存目标 dstMem 位于同一 CTA 的共享内存中。当指定 .cta_group::2 时,mbarrier 对象 mbar 可位于与共享内存目标 dstMem 相同的 CTA 的共享内存中,或位于其对等 CTA中。若未指定
.cta_group,则默认为 .cta_group::1。
修饰符 .bulk_group 指定该 cp.async.bulk.tensor 变体使用批量异步组完成机制。
限定符 .load_mode 指定源位置中的数据如何被复制到目标位置。若未指定 .load_mode,则默认为 .tile。
在 .tile 模式下,源张量的多维布局在目标处得以保持。在 .tile::gather4 模式下,二维源张量中的四行被组合成单个二维目标张量。在 .tile::scatter4 模式下,单个二维源张量被拆分为二维目标张量中的四行。.tile::scatter4/.tile::gather4 模式的细节见
.tile::scatter4 和 .tile::gather4 模式。
在 .im2col、.im2col::*、.im2col_no_offs 和 .im2col_no_offs::w 模式下,源张量的某些维度在目标处被展开为单一维的列。
各种 im2col 模式的细节见 im2col 模式。在每一种这些模式下,张量必须至少为 3 维。向量
操作数 im2colInfo 仅当 .load_mode 为 .im2col 或 .im2col::w 或 .im2col::w::128 时才能指定。向量参数 im2colInfo 的格式取决于确切的 im2col 模式,如下:
确切 im2col 模式 |
im2colInfo 参数 |
语义 |
|---|---|---|
|
{ i2cOffW , i2cOffH , i2cOffD }
for |
由 im2col 偏移组成的向量,其向量大小比维度数 .dim 小 二。 |
|
{ wHalo, wOffset } |
|
|
||
|
|
|
|
|
|
参数 wHalo 是一个 16 位无符号整数,其有效取值集合随 load-mode 而异,如下:- Im2col::w 模式:有效范围为 [0, 512)。- Im2col::w::128 模式:有效范围为 [0, 32)。
参数 wOffset 是一个 16 位无符号整数,其有效取值范围为 [0, 32)。
可选限定符 .multicast::cluster 允许将数据从全局内存复制到 cluster 内多个 CTA 的共享内存。操作数 ctaMask 指定 cluster 内的目标 CTA,使得该 16 位(或 32 位)ctaMask 操作数中的每个位位置对应目标 CTA 的 %cluster_ctarank。可指定额外子限定符 ::16b 或 ::32b 以对应 ctaMask 参数的宽度。默认情况下,ctaMask 被假定为 16 位宽。源数据被多播到每个目标 CTA 共享内存中与 dstMem 相同的偏移处。当 .cta_group 指定为:
.cta_group::1:mbarrier 信号被多播到目标 CTA 共享内存中与mbar相同的偏移处。.cta_group::2:mbarrier 信号被多播到 cluster 内所有可能CTA 对的奇数号 CTA 或偶数号 CTA。具体而言,对ctaMask所指定的每个目标 CTA,mbarrier 信号被发往目标 CTA 或其对等 CTA,具体取决于 mbarrier 对象mbar所在共享内存的%cluster_ctarank奇偶性。
可选修饰符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。更多细节参见
覆盖张量属性值 一节。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
可选限定符 .report_mechanism 指定 mbarrier 报告机制,如异步拷贝操作的报告机制 中所述。
在内存一致性模型 中,cp.async.bulk.tensor 中的拷贝操作被视为弱内存操作,而在 mbarrier 上执行的
complete-tx 操作在 .cluster 作用域上具有 .release 语义。
示例
.reg .b16 ctaMask;
.reg .u16 i2cOffW, i2cOffH, i2cOffD;
.reg .b64 l2CachePolicy;
.reg .b8 newTensorSize_<5>;
.reg .b32 newTensorLowerStrd_<4>;
.reg .b16 tensorUpperStrd;
.reg .u64 gAddrToOverride<3>;
cp.async.bulk.tensor.1d.shared::cta.global.mbarrier::complete_tx::bytes.tile [sMem0], [tensorMap0, {tc0}], [mbar0];
@p cp.async.bulk.tensor.5d.shared::cta.global.im2col.mbarrier::complete_tx::bytes
[sMem2], [tensorMap2, {tc0, tc1, tc2, tc3, tc4}], [mbar2], {i2cOffW, i2cOffH, i2cOffD};
cp.async.bulk.tensor.1d.shared::cluster.global.mbarrier::complete_tx::bytes.tile [sMem0], [tensorMap0, {tc0}], [mbar0];
@p cp.async.bulk.tensor.2d.shared::cluster.global.mbarrier::complete_tx::bytes.multicast::cluster
[sMem1], [tensorMap1, {tc0, tc1}], [mbar2], ctaMask;
@p cp.async.bulk.tensor.5d.shared::cluster.global.im2col.mbarrier::complete_tx::bytes
[sMem2], [tensorMap2, {tc0, tc1, tc2, tc3, tc4}], [mbar2], {i2cOffW, i2cOffH, i2cOffD};
@p cp.async.bulk.tensor.3d.im2col.shared::cluster.global.mbarrier::complete_tx::bytes.L2::cache_hint
[sMem3], [tensorMap3, {tc0, tc1, tc2}], [mbar3], {i2cOffW}, policy;
@p cp.async.bulk.tensor.1d.global.shared::cta.bulk_group [tensorMap3, {tc0}], [sMem3];
cp.async.bulk.tensor.2d.tile::gather4.shared::cluster.global.mbarrier::complete_tx::bytes
[sMem5], [tensorMap6, {x0, y0, y1, y2, y3}], [mbar5];
cp.async.bulk.tensor.3d.im2col::w.shared::cluster.global.mbarrier::complete_tx::bytes
[sMem4], [tensorMap5, {t0, t1, t2}], [mbar4], {im2colwHalo, im2colOff};
cp.async.bulk.tensor.1d.shared::cluster.global.tile.cta_group::2
[sMem6], [tensorMap7, {tc0}], [peerMbar];
cp.async.bulk.tensor.mbarrier::complete_tx::bytes.shared::cta.global.1d.override::global_address
[sMem7], [tensorMap8, gAddrToOverride1, {tc0}], [peerMbar];
cp.async.bulk.tensor.mbarrier::complete_tx::bytes.shared::cta.global.5d.tile.override::global_address.cta_group::1.override::global_dim_stride
[sMem8], [tensorMap9, gAddrToOverride2, {newTensorSize_0, newTensorSize_1, newTensorSize_2, newTensorSize_3, newTensorSize_4}, {newTensorLowerStrd_0, newTensorLowerStrd_1, newTensorLowerStrd_2, newTensorLowerStrd_3}, tensorUpperStrd, {0, 0, 0, 0, 0}], [mbar];
cp.async.bulk.tensor.global.shared::cta.1d.bulk_group.tile.override::global_address.override::global_dim
[tensorMap10, gAddrToOverride3, {newTensorSize_0}, {0}], [sMem9];
cp.async.bulk.tensor.mbarrier::complete_tx::bytes.shared::cluster.global.4d.im2col::w::128.override::global_address.cta_group::1
[sMem10], [tensorMap11, gAddrToOverride4, {tc0, tc1, tc2, tc3}], [mbar5], {im2col_0, im2col_1};
cp.async.bulk.tensor.3d.global.shared::cta.bulk_group.im2col_no_offs::w [tensorMap6, {tc0, tc1, tc2}], [sMem11];
// Validity check using 0x8 pattern on every 16B
cp.async.bulk.tensor.1d.shared::cluster.global.mbarrier::complete_tx::bytes.mbarrier::report::validity::per_16bytes::8 [sMem], [tensorDesc, {u}], [mbar];
// Validity check using 0xff pattern on per element
cp.async.bulk.tensor.2d.shared::cluster.global.tile::gather4.mbarrier::complete_tx::bytes.mbarrier::report::validity::per_element::ff
[sMem], [tensorDesc, {u, v, w, x, y}], [mbar];
9.7.10.28.5.4. 数据移动与转换指令:cp.reduce.async.bulk.tensor#
cp.reduce.async.bulk.tensor
在张量数据上发起一次异步归约操作。
语法
// shared::cta -> global:
cp.reduce.async.bulk.tensor.dim.dst.src.redOp{.load_mode}.completion_mechanism{.level::cache_hint}{.override::global_address}{.override_attribute}
[tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords], [srcMem] {,cache_policy}
.dst = { .global }
.src = { .shared::cta }
.dim = { .1d, .2d, .3d, .4d, .5d }
.completion_mechanism = { .bulk_group }
.load_mode = { .tile, .im2col_no_offs, .im2col_no_offs::w }
.redOp = { .add, .min, .max, .inc, .dec, .and, .or, .xor}
.override_attribute = { .override::global_dim, .override::global_dim_stride }
说明
cp.reduce.async.bulk.tensor 是一条非阻塞指令,它发起一次异步归约操作:将 .dst 状态空间中的张量数据与 .src 状态空间中的张量数据进行归约。
操作数 srcMem 指定 .src 状态空间中用于执行归约操作的张量数据位置。
操作数 tensorMap 是不透明张量映射对象的通用地址,该对象位于 .param 空间、.const 空间或 .global 空间中。操作数 tensorMap 指定张量拷贝操作的属性,如张量映射 所述。
tensorMap 在 tensormap 代理中被访问。有关在主机侧创建张量映射对象的内容,请参考 CUDA programming guide。
.dst 状态空间中张量数据的每个元素都与 .src 状态空间张量数据中的相应元素就地执行归约。修饰符 .redOp 指定用于就地归约的归约运算。源张量与目标张量中每个数据元素的类型见
张量映射。
张量的维度由 .dim 修饰符指定。
向量操作数 tensorCoords 指定全局内存中要执行归约操作的张量数据的起始坐标。向量参数 tensorCoords 中张量坐标的个数应等于修饰符 .dim 所指定的维度数。各张量坐标的类型为 .s32。
下表描述了 .redOp 与元素类型的合法组合:
|
元素类型 |
|---|---|
|
|
|
|
|
|
|
|
修饰符 .completion_mechanism 指定该指令变体所支持的完成机制。修饰符 .completion_mechanism 取值 .bulk_group 表示 cp.reduce.async.bulk.tensor 指令使用批量异步组完成机制。
限定符 .load_mode 指定源位置中的数据如何被复制到目标位置。若未指定 .load_mode,则默认为 .tile。在 .tile 模式下,源张量的多维布局在目标处得以保持。在 .im2col_no_offs 和 .im2col_no_offs::w 模式下,源张量的某些维度在目标处被展开为单一维的列。im2col 模式的细节见
im2col 模式。在 .im2col 模式下,张量必须至少为 3 维。
可选限定符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。更多细节参见
覆盖张量属性值 一节。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。限定符 .level::cache_hint 仅在 .src 或 .dst 状态空间中至少有一个为 .global 状态空间时受支持。
cp.reduce.async.bulk.tensor 执行的每个归约操作各自具有 .relaxed.gpu 内存排序语义,且为逐元素原子操作。在内存一致性模型 中,cp.reduce.async.bulk.tensor 的加载操作被视为弱内存操作,而在 mbarrier 上执行的 complete-tx
操作在 .cluster 作用域上具有 .release 语义。
示例
.reg .b8 newTensorSize_<2>;
.reg .u64 gAddrToOverride<3>;
cp.reduce.async.bulk.tensor.1d.global.shared::cta.add.tile.bulk_group
[tensorMap0, {tc0}], [sMem0];
cp.reduce.async.bulk.tensor.2d.global.shared::cta.and.bulk_group.L2::cache_hint
[tensorMap1, {tc0, tc1}], [sMem1] , policy;
cp.reduce.async.bulk.tensor.3d.global.shared::cta.xor.im2col.bulk_group
[tensorMap2, {tc0, tc1, tc2}], [sMem2];
cp.reduce.async.bulk.tensor.global.shared::cta.bulk_group.2d.tile.min.override::global_address
[tensorMap3, gAddrToOverride1, {tc0, tc1}], [sMem3];
cp.reduce.async.bulk.tensor.global.shared::cta.bulk_group.1d.max.L2::cache_hint.override::global_address.override::global_dim
[tensorMap4, gAddrToOverride2, {newTensorSize_0}, {0}], [sMem4], policy;
cp.reduce.async.bulk.tensor.3d.global.shared::cta.or.im2col_no_offs::w.bulk_group
[tensorMap5, {tc0, tc1, tc2}], [sMem5];
9.7.10.28.5.5. 数据移动与转换指令:cp.async.bulk.prefetch.tensor#
cp.async.bulk.prefetch.tensor
向系统提供提示,发起将张量数据异步预取到缓存的操作。
语法
// global -> L2:
cp.async.bulk.prefetch.tensor.dim.L2.src{.load_mode}{.level::cache_hint}{.override::global_address}{.override_attribute}
[tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords]
{, im2colInfo } {, cache_policy}
cp.async.bulk.prefetch.tensor.dim.L2.src{.load_mode}{.level::eviction_priority}{.override::global_address}{.override_attribute}
[tensorMap{, gAddrToOverride}{, attributeOverrideInfo}, tensorCoords]
{, im2colInfo }
.src = { .global }
.dim = { .1d, .2d, .3d, .4d, .5d }
.load_mode = { .tile, .tile::gather4, .im2col, .im2col::w, .im2col::w::128 }
.level::cache_hint = { .L2::cache_hint }
.level::eviction_priority = { .L2::evict_last }
.override_attribute = { .override::global_dim, .override::global_dim_stride }
说明
cp.async.bulk.prefetch.tensor 是一条非阻塞指令,它可能发起一次张量数据的异步预取,将 .src 状态空间中的位置的数据预取到 L2 缓存。
操作数 tensorMap 是不透明张量映射对象的通用地址,该对象位于 .param 空间、.const 空间或 .global 空间中。操作数 tensorMap 指定张量拷贝操作的属性,如张量映射 所述。
tensorMap 在 tensormap 代理中被访问。有关在主机侧创建张量映射对象的内容,请参考 CUDA programming guide。
张量数据的维度由 .dim 修饰符指定。
向量操作数 tensorCoords 指定全局内存中张量数据的起始坐标,拷贝操作由此处执行。各张量坐标在 tensorCoords 中类型为 .s32。向量参数 tensorCoords 的格式取决于所指定的 .load_mode,如下:
.load_mode |
tensorCoords |
语义 |
|---|---|---|
|
{col_idx, row_idx0, row_idx1, row_idx2, row_idx3} |
长度为 5 的定长向量。 五个元素共同指定四行的起始 坐标。 |
其余全部 |
{d0, .., dn} for n = .dim |
n 个元素组成的向量,其中 n = .dim。 各元素指示在每一个维度上的 偏移。 |
限定符 .load_mode 指定源位置中的数据如何被复制到目标位置。若未指定 .load_mode,则默认为 .tile。
在 .tile 模式下,源张量的多维布局在目标处得以保持。在 .tile::gather4 模式下,二维源张量中的四行被取到 L2 缓存。.tile::gather4 模式的细节见
.tile::scatter4 和 .tile::gather4 模式。
在 .im2col 和 .im2col::* 模式下,源张量的某些维度在目标处被展开为单一维的列。im2col 和 .im2col::* 模式的细节分别见
im2col 模式 和 im2col::w、im2col_no_offs::w 与 im2col::w::128 模式。在 .im2col 和 .im2col::* 模式下,张量必须至少为 3 维。向量
操作数 im2colInfo 仅当 .load_mode 为 .im2col 或 .im2col::w 或 .im2col::w::128 时才能指定。向量参数 im2colInfo 的格式取决于确切的 im2col 模式,如下:
确切 im2col 模式 |
im2colInfo 参数 |
语义 |
|---|---|---|
|
{ i2cOffW , i2cOffH , i2cOffD }
for |
由 im2col 偏移组成的向量,其向量大小比维度数 .dim 小 二。 |
|
{ wHalo, wOffset } |
|
|
可选限定符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。更多细节参见
覆盖张量属性值 一节。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
限定符 .level::eviction_priority 指定要应用于被预取缓存行的逐出优先级。
在内存一致性模型 中,cp.async.bulk.prefetch.tensor 被视为弱内存操作。
示例
.reg .b16 ctaMask, im2colwHalo, im2colOff;
.reg .u16 i2cOffW, i2cOffH, i2cOffD;
.reg .b64 l2CachePolicy;
.reg .b8 newTensorSize_<5>;
.reg .b32 newTensorLowerStrd_<4>;
.reg .b16 tensorUpperStrd;
.reg .u64 gAddrToOverride<3>;
cp.async.bulk.prefetch.tensor.1d.L2.global.tile [tensorMap0, {tc0}];
@p cp.async.bulk.prefetch.tensor.2d.L2.global [tensorMap1, {tc0, tc1}];
@p cp.async.bulk.prefetch.tensor.5d.L2.global.im2col
[tensorMap2, {tc0, tc1, tc2, tc3, tc4}], {i2cOffW, i2cOffH, i2cOffD};
@p cp.async.bulk.prefetch.tensor.3d.L2.global.im2col.L2::cache_hint
[tensorMap3, {tc0, tc1, tc2}], {i2cOffW}, policy;
cp.async.bulk.prefetch.tensor.2d.L2.global.tile::gather4 [tensorMap5, {col_idx, row_idx0, row_idx1, row_idx2, row_idx3}];
cp.async.bulk.prefetch.tensor.4d.L2.global.im2col::w::128
[tensorMap4, {t0, t1, t2, t3}], {im2colwHalo, im2colOff};
cp.async.bulk.prefetch.tensor.3d.L2.global.tile::gather4.L2::evict_last
[tensorMap5, {t0, t1, t2}], {i2cOffW};
cp.async.bulk.prefetch.tensor.2d.L2.global.tile.override::global_address
[tensorMap6, gAddrToOverride1, {t0, t1}];
cp.async.bulk.prefetch.tensor.3d.L2.global.override::global_address.override::global_dim_stride.L2::cache_hint
[tensorMap7, gAddrToOverride2, {newTensorSize_0, newTensorSize_1, newTensorSize_2}, {newTensorLowerStrd_0, newTensorLowerStrd_1}, tensorUpperStrd, {0, 0, 0}], policy;
9.7.10.28.6. 数据移动与转换指令:批量与张量拷贝完成指令#
9.7.10.28.6.1. 数据移动与转换指令:cp.async.bulk.commit_group#
cp.async.bulk.commit_group
将所有先前已发起但未提交的 cp.async.bulk 指令提交进一个 cp.async.bulk 组。
语法
cp.async.bulk.commit_group;
说明
cp.async.bulk.commit_group 指令会创建一个新的每线程批量异步组,并将满足以下条件的、先前的所有 cp{.reduce}.async.bulk{.prefetch}{.tensor}/applypriority.async.bulk{.tensor} 指令一并归入这个新的批量异步组:
先前的
cp{.reduce}.async.bulk{.prefetch}{.tensor}/applypriority.async.bulk{.tensor}指令使用 bulk_group 完成机制,且它们由执行线程发起,但尚未提交到任何批量异步组。
若没有未提交的 cp{.reduce}.async.bulk{.prefetch}{.tensor}/applypriority.async.bulk{.tensor}
指令,则 cp.async.bulk.commit_group 产生一个空的批量异步组。
执行线程可使用 cp.async.bulk.wait_group 等待某个批量异步组中所有
cp{.reduce}.async.bulk{.prefetch}{.tensor}/applypriority.async.bulk{.tensor} 操作完成。
同一批量异步组内任意两个
cp{.reduce}.async.bulk{.prefetch}{.tensor}/applypriority.async.bulk{.tensor} 操作之间不提供任何内存顺序保证。
示例
cp.async.bulk.commit_group;
9.7.10.28.6.2. 数据移动与转换指令:cp.async.bulk.wait_group#
cp.async.bulk.wait_group
等待批量异步组完成。
语法
cp.async.bulk.wait_group{.read} N;
说明
cp.async.bulk.wait_group 指令会使执行线程等待,直到最近若干个批量异步组中仅剩 N 个或更少仍处于挂起状态,且执行线程先前提交的所有批量异步组都已完成。例如,当 N 为 0 时,执行线程等待所有先前的批量异步组完成。操作数 N 是一个整数常量。
默认情况下,cp.async.bulk.wait_group 指令会使执行线程等待,直到指定批量异步组中的所有批量异步操作完成。一次批量异步操作包括以下内容:
可选地,从 tensormap 读取。
从源位置读取。
写入各自的目标位置。
使写入对执行线程可见。
可选的 .read 修饰符表示等待须持续到指定批量异步组中的所有批量异步操作的以下部分均已完成:
从 tensormap 读取
从各自源位置读取。
示例
cp.async.bulk.wait_group.read 0;
cp.async.bulk.wait_group 2;
9.7.10.29. 数据移动与转换指令:tensormap.replace#
tensormap.replace
修改张量映射对象的字段。
语法
tensormap.replace.mode.field1{.ss}.b1024.type [addr], new_val;
tensormap.replace.mode.field2{.ss}.b1024.type [addr], ord, new_val;
tensormap.replace.mode.field3{.ss}.b1024.type [addr], new_val;
.mode = { .tile }
.field1 = { .global_address, .rank }
.field2 = { .box_dim, .global_dim, .global_stride, .element_stride }
.field3 = { .elemtype, .interleave_layout, .swizzle_mode, .swizzle_atomicity, .fill_mode }
.ss = { .global, .shared::cta }
.type = { .b32, .b64 }
说明
tensormap.replace 指令用一个新值替换位于地址操作数 addr 所指定位置的张量映射对象中由 .field 限定符所指定的字段。新值由参数 new_val 指定。
限定符 .mode 指定位于地址操作数 addr 处的张量映射对象的模式。
指令类型 .b1024 表示张量映射对象的大小,为 1024 位。
操作数 new_val 的类型为 .type。当 .field 指定为 .global_address 或 .global_stride 时,.type 必须为 .b64。否则,.type 必须为 .b32。
立即整数操作数 ord 指定在张量各秩上需要被替换于张量映射对象中的字段序号。ord 唯一有效的取值为 [0..4]。
对于字段 .rank,操作数 new_val 必须比期望的张量秩小一,因为该字段采用从零开始的编号。
当指定 .field3 时,操作数 new_val 必须是立即数,且表 36 给出了操作数 new_val 在各字段上的映射。
new_val |
.field3 |
||||
|---|---|---|---|---|---|
.elemtype |
.interleave_layout |
.swizzle_mode |
.swizzle_atomicity |
.fill_mode |
|
0 |
|
无交织 |
无 swizzle |
16B |
零填充 |
1 |
|
16B 交织 |
32B swizzle |
32B |
OOB-NaN 填充 |
2 |
|
32B 交织 |
64B swizzle |
32B + 8B flip |
x |
3 |
|
x |
128B swizzle |
64B |
x |
4 |
|
x |
96B swizzle |
x |
x |
5 |
|
x |
x |
x |
x |
6 |
|
x |
x |
x |
x |
7 |
|
x |
x |
x |
x |
8 |
|
x |
x |
x |
x |
9 |
|
x |
x |
x |
x |
10 |
|
x |
x |
x |
x |
11 |
|
x |
x |
x |
x |
12 |
|
x |
x |
x |
x |
13 |
|
x |
x |
x |
x |
14 |
|
x |
x |
x |
x |
15 |
|
x |
x |
x |
x |
注
.elemtype 的取值与驱动 API 中使用的 CUtensorMapDataType 枚举的取值并不对应。
若未指定状态空间,则使用 通用寻址。若由 addr 指定的地址不落在 .global
或 .shared::cta 状态空间的地址窗口内,则行为未定义。
在内存一致性模型 中,tensormap.replace 被视为对整个 1024 位不透明张量映射对象的一次弱内存操作。
示例
tensormap.replace.tile.global_address.shared::cta.b1024.b64 [sMem], new_val;
9.7.10.30. 数据移动与转换指令:spcompress#
spcompress
压缩稠密向量以构成结构化稀疏向量
语法
spcompress.elemsize.idxsize.spfactor.num mdata, cdata, data, spdesc;
.elemsize = { .b8, .b16 }
.idxsize = { .b2, .b4 }
.spfactor = { .sp::2:4 }
.num = { .x1, .x2, .x4, .x8, .x16, .x32, .x64 }
说明
spcompress 指令从稠密向量 data 复制元素以构成结构化稀疏压缩向量 cdata。所得的元数据被写入向量操作数 mdata。
压缩因子通过限定符 .spfactor 指定。.spfactor 唯一允许的取值为 .sp::2:4,对稠密输入向量产生 2:4 压缩。
在这种情况下,会从 data 的每 4 个元素一组中选出 2 个元素并复制到 cdata。输出向量 mdata 存储每组 4 个元素中所选 2 个元素的索引。
这些元素的选择标准由稀疏性描述符 spdesc 中的某个字段指定。
限定符 .elemsize 指定输入向量 data 中每个元素的位宽。每个元素的确切数据类型由稀疏性描述符 spdesc 中的某个字段指定。限定符 .idxsize 指定每个被选元素的元数据索引大小。
鉴于压缩因子为 2:4,.idxsize 只能为 .b2 或 .b4。
.num 限定符表示本操作的重复因子。操作数 data、cdata、mdata 是花括号包围的向量表达式,由一个或多个 32 位寄存器组成。向量操作数
data、cdata、mdata 之间的任何寄存器重叠或以任何方式复用寄存器都会导致未定义行为。对于 data 和 cdata 操作数,向量大小取决于 .num 限定符。对于 mdata 操作数,向量大小取决于
.num、.idxsize、.elemsize 限定符的取值。例如,当 .num 限定符指定为 .x1 时,操作数 data 必须由 2 个 .b32 寄存器组成,而所得的 cdata、mdata
是各含一个单元素 .b32 寄存器的向量操作数。类似地,当 .num 设为 .x64 时,输入操作数 data 是由 128 个 .b32 寄存器组成的向量,而所得的 cdata 由 64 个 .b32 寄存器组成。
各操作数的期望向量大小可依据表 37 计算。注意,所有操作数的向量大小总和不应超过 253,即 vecSize(data) + vecSize(cdata) + vecSize(mdata) <= 253。
操作数 |
向量大小 |
|---|---|
|
|
|
|
|
|
32 位寄存器操作数 spdesc 是指令描述符参数。该指令描述符编码了 data 操作数中输入元素的确切数据类型。它还指定了为从每 4 个元素一组中选出 2 个元素所需应用的运算。
表 38 列出了描述符参数 spdesc 的确切布局。
位 |
大小 |
描述 |
取值 |
|---|---|---|---|
0-1 |
2 |
这些位表示在从每 4 个元素一组中选出 2 个元素时所要使用的运算。 MAX 与 MIN 分别选择值最大与最小的两个元素。 而 MAXABS 与 MINABS 分别选择幅值最大与最小的 两个元素。 |
0: MAX, 1: MAXABS, 2: MIN, 3: MINABS |
2-4 |
3 |
这些位表示源操作数 |
0: |
5-31 |
26 |
保留 |
0 |
图 43 以图示形式展示了一条简单的 spcompress 指令。
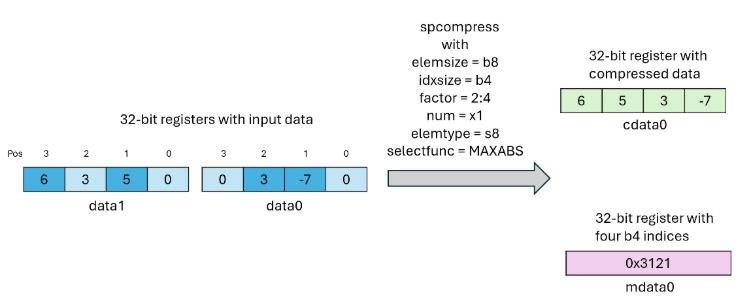
图 43 spcompress 指令示意。
示例
.reg .b32 mdata_<2>, cdata_<4>, data_<8>, spdesc;
mov.b32 spdesc, 0x5; // MAXABS op, .s8 datatype
spcompress.b8.b2.sp::2:4.x4 {mdata_0},
{cdata_0, cdata_1, cdata_2, cdata_3},
{data_0, data_1, data_2, data_3, data_4, data_5, data_6, data_7},
spdesc;
9.7.10.31. 数据移动与转换指令:spdecompress#
spdecompress
解压缩结构化稀疏向量以构成稠密向量
语法
spdecompress.elemsize.idxsize.spfactor.num data, mdata, cdata;
.elemsize = { .b8, .b16 }
.idxsize = { .b2, .b4 }
.spfactor = { .sp::1:2, .sp::1:4, .sp::1:8, .sp::1:16,
.sp::2:4, .sp::2:8, .sp::2:16,
.sp::4:8, .sp::4:16 }
.num = { .x1, .x2, .x4, .x8, .x16, .x32, .x64 }
说明
spdecompress 指令从结构化稀疏压缩向量 cdata 复制元素以构成稠密向量 data。与结构化稀疏压缩向量 cdata 对应的元数据信息由向量操作数 mdata 给出。
解压因子由限定符 .spfactor 导出。该限定符形如 .sp::num_src:num_target,意味着该指令将每 num_src 个元素的一个序列解压为含有 num_target 个元素的序列。
给定解压操作,自然可知 num_src 值必须严格小于 num_target 值。
spdecompress 指令从 cdata 中 num_src 个元素的一个序列里逐个复制元素,从而将其变换为所得 data 操作数中 num_target 个元素的一个序列。num_src 序列中每个元素所对应的目标索引由 mdata 操作数给出。若 num_src 序列中没有元素被复制到 num_target 个元素序列中的某个位置,则该位置被置为零。类似地,输出操作数 data 中所有空置且未填充的位都被置为零。
.num 限定符表示本操作的重复因子。每个元素的目标索引大小由 .idxsize 指定。限定符 .elemsize 表示属于 num_src 与 num_target 序列的每个元素的大小。操作数 mdata、cdata 和 data
是花括号包围的向量表达式,由一个或多个 .b32 寄存器组成。向量操作数 mdata、cdata、data 之间的任何寄存器重叠或以任何方式复用寄存器都会导致未定义行为。各操作数的向量大小取决于限定符取值。
各操作数的期望向量大小可依据表 39 计算。
操作数 |
向量大小 |
|---|---|
|
|
|
|
|
|
有效的 spdecompress 指令必须满足以下条件:
对应于
.num限定符单次迭代的输入跨度必须能容纳于单个.b32寄存器内,即num_src * .elemsize <= 32。.idxsize应足以完整索引num_target个元素的序列。换言之,若.idxsize为.b2,则num_target必须<= 4。data 操作数的大小至少为 1,即
num_target * .elemsize * .num >= 32。data 操作数的大小至多为 128,即
num_target * .elemsize * .num <= 4096。所有操作数的向量大小总和不应超过 253,即
vecSize(mdata) + vecSize(cdata) + vecSize(data) <= 253。
图 44 以图示形式展示了一条简单的 spdecompress 指令。
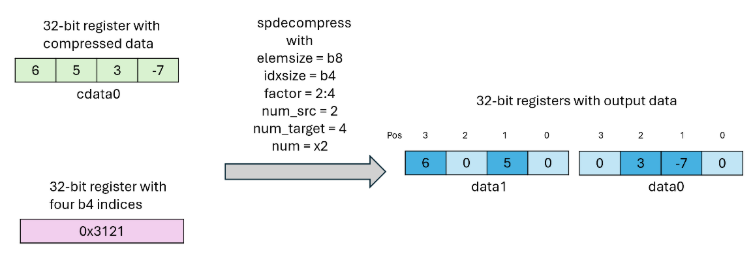
图 44 spdecompress 指令示意。
语义
for N in .num:
for S in num_source:
data[mdata[N][S]] = cdata[N][S];
示例
.reg .b32 mdata_<4>, cdata_<32>, data_<32>;
spdecompress.b8.b2.sp::2:4.x32 {data_0, data_1, data_2, data_3, data_4, data_5, data_6, data_7, data_8,
data_9, data_10, data_11, data_12, data_13, data_14, data_15, data_17,
data_18, data_19, data_20, data_21, data_22, data_23, data_24, data_25,
data_26, data_27, data_28, data_29, data_30, data_31},
{mdata_0, mdata_1, mdata_2, mdata_3},
{cdata_0, cdata_1, cdata_2, cdata_3, cdata_4, cdata_5, cdata_6, cdata_7,
cdata_8, cdata_9, cdata_10, cdata_11, cdata_12, cdata_13, cdata_14, cdata_15};
9.7.11. Fabric 指令#
基于指针地址的内存操作所遇到的 NVLink 故障对应用而言是致命的。 CUDA Compute Fabric Transport(CUDA CFT)编程模型引入了一批 fabric 操作,它们直接向应用报告故障,从而使应用能够抵御 NVLink 故障。如何处理这些故障完全由应用决定,可能包括中止或干净地拆除进程,或尝试通过重试该操作从瞬时故障中恢复。
主机侧编程模型请参阅 CUDA Driver API 的 Logical Endpoint 一节。
9.7.11.1. CFT 句柄#
一个 CUDA Fabric Transport 句柄由两个对象组成:
leId,逻辑端点标识符:对某个逻辑端点的 32 位无符号整数引用off,资源偏移:对该逻辑端内某个资源的 64 位无符号整数引用。
9.7.11.2. CFT 句柄概述#
所有 fabric 操作:
可能失败并报告一个用于标识成功或潜在失败的状态,从而使应用能够据此作出反应。
都是异步操作,使该操作能在后台推进。
通过 fabric-proxy 执行某些 CFT 句柄资源访问。多数 fabric 操作会执行多次访问:经由 fabric-proxy 的 CFT 句柄资源访问,以及经由往往多个不同代理的多次基于指针的访问。
9.7.11.2.1. Fabric 代理#
对 CFT 句柄资源的 fabric 操作访问通过 fabric-proxy 执行。fabric-proxy 与 generic-proxy 之间的跨代理栅栏是可用的。
9.7.11.3. Fabric 操作的一生#
句柄的生命周期在主机侧开始并在主机侧结束:CUDA 应用的主机侧检测系统是否支持 fabric 操作、创建逻辑端点、将资源绑定到逻辑端点,并与其他 GPU 在 NVLink 域中共享这些资源。要启用远程源访问,应当查询逻辑端点的就绪状态。fabric 操作的生命周期在设备侧开始并在设备侧结束。本节仅涵盖 fabric 操作的 PTX 设备侧编程模型;有关跨越主机代码与设备代码、端到端的 fabric 操作编程模型,请参阅 CUDA Driver API 的 Logical Endpoint 一节。
fabric 操作的生命周期包括:
线程发起一个或多个由
mbarrier.layout::v1跟踪的 fabric 操作。每个线程在相关的 mbarrier 阶段完成之前提交这些 fabric 操作。
线程在该 mbarrier 阶段上执行 arrive-on 与 expect-tx,以确保该阶段在 fabric 操作完成后推进。
线程等待直到该 mbarrier 阶段完成。
线程检查谓词报告中的错误并加以处理。状态报告中可能包含关于这些错误的更多信息。
9.7.11.3.1. 发起一次 Fabric 操作#
线程通过执行以下任一 fabric 指令来发起 fabric 操作:
fabric.try_get:从 CFT 句柄读取fabric.try_put:写入 CFT 句柄fabric.try_red:对 CFT 句柄执行归约fabric.try_pullred:从 CFT 句柄执行拉取归约(等价于multimem.ld_reduce)。fabric.try_get.async.tensor:从 CFT 句柄异步读取张量数据fabric.try_put.async.tensor:向 CFT 句柄异步写入张量数据fabric.try_red.async.tensor:对 CFT 句柄异步归约张量数据fabric.try_atom:对 CFT 句柄执行异步原子操作
9.7.11.3.2. 提交随后在 mbarrier 上 arrive#
要使任何线程都能经由 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。否则,行为未定义。
针对由同一栅栏跟踪的多种、多类 fabric 操作,可以发出单次 arrive expect_tx 操作。
9.7.11.3.3. 等待完成#
已提交的 fabric 操作保证最终会完成,线程可以在 mbarrier 上阻塞,以观察它们的完成及其报告状态。
9.7.11.3.4. 检查状态并处理错误#
单次像 fabric.try_put 这样的操作可能发出许多请求,且每个请求都可能因不同原因失败。这些失败会 report-on 到 mbarrier 对象上。
多种不同的 fabric 操作也可能被同一 mbarrier 对象跟踪,并因不同原因失败。
向程序通知完成的 mbarrier.try_wait.phase_type::primary 操作在存在任何错误时会置位报告谓词;不透明的报告值可能包含更多信息。详情参见 fabric 报告机制。随后应用可根据错误的严重程度决定如何处理。
9.7.11.4. fabric 操作的完成机制#
fabric 操作的完成可由类型为 layout::v1 的 mbarrier 对象跟踪。详情参见 基于 mbarrier 的完成机制。观察 fabric 操作的完成为该操作所执行的全部内存访问及 CFT 句柄资源访问提供顺序,无论是否报告了错误。
除跟踪 fabric 操作的整体完成外,一部分操作效果(例如等待对共享内存的读取、等待计数器值的变化等)也可独立于操作的完整完成而被跟踪。
9.7.11.4.1. Fabric 报告机制#
由 mbarrier 跟踪的 fabric 操作使用 report::fabric 报告机制,其语义如下:
若操作成功,则负载报告(mbarrier 对象的内容)不被修改。换言之,报告谓词与报告值均保持不变。
否则操作失败,置位 mbarrier 报告谓词,且不透明的报告值可能包含更多信息,可通过 cudaFabricOpErrorStatusGet/Count API 解码。
将指定 report::fabric 的 fabric 操作与指定其他报告机制的操作混用的程序,其行为未定义。
9.7.11.4.2. Fabric 读取完成机制#
所有从共享内存读取数据的 fabric 操作都支持跟踪该读取操作的完成。这使得应用无需等待整个操作完成,即可复用被这些操作读取的共享内存。这是一种部分完成机制,即它并不跟踪整个异步操作的完成。
注意,由于 fabric.try_get 并不从共享内存读取——它写入共享内存——因此该完成机制不会为 try_get 操作提供任何顺序。
9.7.11.4.3. 计数完成机制#
fabric 操作支持使用一个全局内存计数器来跟踪 try_put 和 try_red 所执行的目标数据访问的完成。它使程序能够通过观察计数器更新来等待数据修改。多个 fabric 操作可并发共享同一计数器。由于并发操作彼此之间没有顺序,程序必须等待计数器达到最终值。
该机制为所访问的每个数据字节将计数器加一。计数器更新的粒度未指定;更新可能每字节发生一次、在操作结束时整体发生一次,或介于两者之间的任意粒度。8B 宽的计数器必须 256B 对齐,且计数器递增是一次系统作用域的原子操作。
若计数器与数据重叠,则行为未定义。若该逻辑端点不支持计数完成,则行为未定义(详情参见 CUDA Driver API 的 Logical Endpoint 一节)。
这是一种供程序等待目标数据访问的部分完成机制。对于带计数完成的 .multimem fabric 操作,计数器仅在其目标设备处跟踪访问。
9.7.11.5. Fabric 操作#
9.7.11.5.1. Fabric 指令:fabric.try_get#
fabric.try_get
从 fabric 句柄异步拷贝。
语法
fabric.try_get.async.dst.completion_mechanism{.level::cache_hint}.sem.scope.b128 [dst], [srcLeId, srcDataOff], size, [bar] {, cache_policy};
.dst = { .shared::cta }
.completion_mechanism = { .mbarrier::complete_tx::bytes.mbarrier::report::fabric }
.sem = { .relaxed }
.scope = { .sys }
.level::cache_hint = { .L2::cache_hint }
说明
从 fabric 句柄 [srcLeId, srcDataOff] 异步复制 size 字节到目标内存 [dst],其中 srcLeId 是表示逻辑端点标识符的 32 位无符号值,而 srcDataOff 是表示在与 srcLeId 关联的逻辑端点内要访问的资源的基偏移的 64 位无符号值。
与 srcLeId 关联的逻辑端点必须是单播(unicast)逻辑端点。
size 操作数为 32 位,指定要复制的字节数。它必须是 16 的倍数;否则行为未定义。范围 [dst, dst + size - 1] 必须在目标内存空间的边界之内。范围 [srcDataOff, srcDataOff + size - 1] 必须在与 srcLeId 关联的逻辑端点资源的边界之内。
源句柄偏移 srcDataOff 与目标指针 dst 必须 16 字节对齐。
若 .dst 为 .shared::cta,则:
拷贝的目标
[dst]与栅栏[bar]必须引用本地 CTA 的共享内存;否则行为未定义。完成机制必须为
.mbarrier::complete_tx::bytes.mbarrier::report::fabric。
mbarrier 对象 bar 必须用 .layout::v1 初始化(参见
mbarrier 对象的布局)。限定符
.mbarrier::complete_tx::bytes 指定该操作通过执行一次 complete-tx 操作 来完成,其完成计数为所复制的总字节数(size),施加在由地址操作数 bar 所指定位置的 mbarrier 对象上。.mbarrier::report::fabric 的说明参见
Fabric 报告机制。要使任何线程都能经由 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
本指令通过 fabric-proxy 读取由句柄操作数所指定位置的数据,通过 async-proxy 将其复制到目标 .shared::cta 内存,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
对源句柄的访问是 128 位宽、具有 .relaxed.sys 内存序语义的原子操作,如 内存一致性模型 所述。
示例
fabric.try_get.async.shared::cta.mbarrier::complete_tx::bytes.mbarrier::report::fabric.relaxed.sys.b128 [dstSmem], [srcLeId, srcLeOff], 0x100, [mbar];
fabric.try_get.async.shared::cta.relaxed.sys.L2::cache_hint.mbarrier::complete_tx::bytes.mbarrier::report::fabric.b128 [dstSmem], [srcLeId, srcLeOff], sizeBytes, [mbar], cachePolicy;
9.7.11.5.2. Fabric 指令:fabric.try_put#
fabric.try_put
向 fabric 句柄异步拷贝。
语法
fabric.try_put.async{.multimem}.src.completion_mechanism0{.level::cache_hint}.sem.scope.b128 [dstLeId, dstDataOff], [src], size, [bar] {, cache_policy};
fabric.try_put.async{.multimem}.src.completion_mechanism0{.level::cache_hint}.cp_mask.sem.scope.b128 [dstLeId, dstDataOff], [src], size, [bar], bytemask {, cache_policy};
fabric.try_put.async{.multimem}.src.completion_mechanism1{.level::cache_hint}.sem.scope.b128 [dstLeId, dstDataOff, dstCounterOff], [src], size, [bar] {, cache_policy};
.src = { .shared::cta }
.completion_mechanism0 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric }
.completion_mechanism1 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric.counted::bytes }
.sem = { .relaxed }
.scope = { .sys }
.level::cache_hint = { .L2::cache_hint }
说明
从 [src] 异步复制 size 字节到目标 fabric 句柄 [dstLeId, dstDataOff],其中 dstLeId 是表示逻辑端点标识符的 32 位无符号值,而 dstDataOff 是表示在与 dstLeId 关联的逻辑端点内要访问的资源的基偏移的 64 位无符号值。
size 操作数为 32 位,指定要复制的字节数。它必须是 16 的倍数;否则行为未定义。范围 [src, src + size - 1] 必须在源内存空间的边界之内。范围 [dstDataOff, dstDataOff + size - 1] 必须在当前设备上、与 dstLeId 关联的逻辑端点处资源的边界之内。
源指针 src 与目标句柄偏移 dstDataOff 必须 16 字节对齐。
若指定限定符 .multimem,则 dstLeId 必须关联到一个多播(multicast)逻辑端点,且发起该操作的设备必须是该端点的一个成员。在缺少 .multimem 限定符时,dstLeId 必须关联到一个单播逻辑端点。
若 .src 为 .shared::cta,则拷贝的源 [src] 与栅栏 [bar] 引用本地 CTA 的共享内存。
mbarrier 对象 bar 必须用 .layout::v1 初始化(参见
mbarrier 对象的布局)。限定符
.mbarrier::complete_tx::16B 指定 complete-tx 操作在 bar 上执行,其完成计数等于所复制字节数除以 16;即每复制 16 字节计数加一。注意,该完成机制与 fabric.try_get 不同,后者 complete-tx 操作使用的完成计数等于所复制的字节数。要使任何线程都能经由 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
若存在限定符 .counted::bytes(completion_mechanism1 形式),则:
dstLeId必须关联到支持计数完成的逻辑端点(计数完成机制),且计数器偏移
dstCounterOff必须 256 字节对齐,且本操作使用在
[dstLeId, dstCounterOff]处指定的、256 字节对齐、大小为 8 字节的计数器,为目标数据提供基于计数器的完成。
.counted::bytes 限定符与 .cp_mask 限定符不兼容。
.mbarrier::report::fabric 的说明参见 Fabric 报告机制。
若指定 .cp_mask,则 bytemask 操作数是必需的,且必须包含一个 16 位宽的掩码,以选择每个 16 字节块中哪些字节被写入目标。
本指令通过 fabric-proxy 访问由句柄操作数所指定位置的数据和计数器,通过 async-proxy 从源 .shared::cta 读取,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
本操作具有如 内存一致性模型 所述的 .relaxed.sys 内存序语义。
示例
fabric.try_put.async.shared::cta.mbarrier::complete_tx::16B.mbarrier::report::fabric.relaxed.sys.b128 [dstLeId, dstLeOffData], [srcSmem], 0x100, [mbar];
fabric.try_put.async.counted::bytes.shared::cta.L2::cache_hint.mbarrier::complete_tx::16B.mbarrier::report::fabric.relaxed.sys.b128 [dstLeId, dstLeOffData, dstLeOffCntr], [srcSmem], size, [mbar], cachePolicy;
9.7.11.5.3. Fabric 指令:fabric.try_red#
fabric.try_red
带归约的、向 fabric 句柄的异步拷贝。
语法
fabric.try_red.async{.multimem}.src.completion_mechanism0{.level::cache_hint}.sem.scope.redOpBit.typeBit [dstLeId, dstDataOff], [src], size, [bar] {, cache_policy};
fabric.try_red.async{.multimem}.src.completion_mechanism0{.level::cache_hint}.sem.scope.redOpMinMax.typeMinMax [dstLeId, dstDataOff], [src], size, [bar] {, cache_policy};
fabric.try_red.async{.multimem}.src.completion_mechanism0{.level::cache_hint}.sem.scope.redOpArith.typeArith [dstLeId, dstDataOff], [src], size, [bar] {, cache_policy};
fabric.try_red.async{.multimem}.src.completion_mechanism1{.level::cache_hint}.sem.scope.redOpBit.typeBit [dstLeId, dstDataOff, dstCounterOff], [src], size, [bar] {, cache_policy};
fabric.try_red.async{.multimem}.src.completion_mechanism1{.level::cache_hint}.sem.scope.redOpMinMax.typeMinMax [dstLeId, dstDataOff, dstCounterOff], [src], size, [bar] {, cache_policy};
fabric.try_red.async{.multimem}.src.completion_mechanism1{.level::cache_hint}.sem.scope.redOpAdd.typeAdd [dstLeId, dstDataOff, dstCounterOff], [src], size, [bar] {, cache_policy};
.src = { .shared::cta }
.completion_mechanism0 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric }
.completion_mechanism1 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric.counted::bytes }
.sem = { .relaxed }
.scope = { .sys }
.level::cache_hint = { .L2::cache_hint }
.redOpBit = { .and, .xor, .or }
.typeBit = { .b32, .b64 }
.redOpMinMax = { .min, .max }
.typeMinMax = { .u32, .s32, .u64, .s64, .f16, .bf16 }
.redOpArith = { .add }
.typeArith = { .u32, .u64, .f16, .bf16, .f32, .f64 }
.redOpAdd = { .add }
.typeAdd = { .u32, .u64, .f16, .bf16, .f32, .f64 }
说明
从 [src] 异步复制 size 字节到目标 fabric 句柄 [dstLeId, dstDataOff] 并执行逐元素归约,其中 dstLeId 是表示逻辑端点标识符的 32 位无符号值,而 dstDataOff 是表示在与 dstLeId 关联的逻辑端点内要访问的资源的基偏移的 64 位无符号值。
size 操作数为 32 位,指定要复制的字节数。它必须是 16 的倍数;否则行为未定义。源范围 [src, src + size - 1] 必须在源内存空间的边界之内。目标范围 [dstDataOff, dstDataOff + size - 1] 必须在当前设备上与 dstLeId 关联的逻辑端点的边界之内。
源指针 src 与目标句柄偏移 dstDataOff 必须 16 字节对齐。
目标数组中的每个数据元素都与源数组中的相应数据元素,使用由 .redOp* 限定符指示的归约运算进行归约。源数组与目标数组中每个数据元素的类型由相匹配的 .type* 限定符指定。
若指定限定符 .multimem,则 dstLeId 必须关联到一个多播逻辑端点,使得发起该操作的设备是该多播端点的一个成员。在未指定该限定符时,dstLeId 必须关联到一个单播逻辑端点。
若 .src 为 .shared::cta,则拷贝的源 [src] 与栅栏 [bar] 引用本地 CTA 的共享内存。
mbarrier 对象 bar 必须用 .layout::v1 初始化(参见
mbarrier 对象的布局)。限定符
.mbarrier::complete_tx::16B 指定 complete-tx 操作在 bar 上执行,其完成计数等于所复制字节数除以 16;即每复制 16 字节计数加一。注意,fabric.try_get 使用不同的完成机制,其中 complete-tx 操作使用的完成计数等于所复制的字节数。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
若存在限定符 .counted::bytes(completion_mechanism1 形式),则:
dstLeId必须关联到支持计数完成的逻辑端点(详情参见 计数完成机制),且计数器偏移
dstCounterOff必须 256 字节对齐,范围
[dstCounterOff, dstCounterOff + 7]在当前设备上必须处于逻辑端点dstLeId的边界之内,且不得与[dstDataOff, dstDataOff + size - 1]重叠,且本操作使用在
[dstLeId, dstCounterOff]处、256 字节对齐、大小为 8 字节的计数器,为目标数据提供基于计数器的完成。
.mbarrier::report::fabric 的说明参见 Fabric 报告机制。
本指令通过 fabric-proxy 访问由句柄操作数所指定位置的数据和计数器,通过 async-proxy 从源 .shared::cta 读取,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
本操作具有如 内存一致性模型 所述的 .relaxed.sys 内存序语义。
示例
fabric.try_red.async.shared::cta.mbarrier::complete_tx::16B.mbarrier::report::fabric.relaxed.sys.add.u32 [dstLeId, dstLeOffData], [srcSmem], size, [mbar];
fabric.try_red.async.counted::bytes.shared::cta.L2::cache_hint.mbarrier::complete_tx::16B.mbarrier::report::fabric.add.u32 [dstLeId, dstLeOffData, dstLeOffCntr], [srcSmem], size, [mbar], cache_policy;
9.7.11.5.4. Fabric 指令:fabric.try_pullred#
fabric.try_pullred
带拉取归约的、从 fabric 句柄的异步拷贝。
语法
fabric.try_pullred.async.multimem.dst.completion_mechanism.sem.scope.redOpBit.typeBit.sync [dst], [srcLeId, srcDataOff], size, [bar], imm-membermask;
fabric.try_pullred.async.multimem.dst.completion_mechanism.sem.scope.redOpMinMax.typeMinMax.sync [dst], [srcLeId, srcDataOff], size, [bar], imm-membermask;
fabric.try_pullred.async.multimem.dst.completion_mechanism.sem.scope.redOpAdd.typeAdd.sync [dst], [srcLeId, srcDataOff], size, [bar], imm-membermask;
fabric.try_pullred.async.multimem.dst.completion_mechanism.sem.scope.redOpAddAcc16.typeAddAcc16.sync [dst], [srcLeId, srcDataOff], size, [bar], imm-membermask;
fabric.try_pullred.async.multimem.dst.completion_mechanism.sem.scope.redOpAddAcc32.typeAddAcc32.sync [dst], [srcLeId, srcDataOff], size, [bar], imm-membermask;
.dst = { .shared::cta }
.completion_mechanism = { .mbarrier::complete_tx::bytes.mbarrier::report::fabric }
.sem = { .relaxed }
.scope = { .sys }
.redOpBit = { .and, .xor, .or }
.typeBit = { .b32, .b64 }
.redOpMinMax = { .min, .max }
.typeMinMax = { .u32, .s32, .u64, .s64, .bf16, .f16, .e4m3, .e5m2 }
.redOpAdd = { .add }
.typeAdd = { .u32, .u64, .f16, .bf16, .f32 }
.redOpAddAcc16 = { .add.acc::f16 }
.typeAddAcc16 = { .e4m3, .e5m2 }
.redOpAddAcc32 = { .add.acc::f32 }
.typeAddAcc32 = { .f16, .bf16 }
说明
从多播 fabric 句柄 [srcLeId, srcDataOff] 所指向的多个资源发起对 size 字节的异步加载,并在各次加载之间对数据执行逐元素归约。结果被存于 [dst, dst + size - 1]。srcLeId 是表示逻辑端点标识符的 32 位无符号值,而 srcDataOff 是表示在与 srcLeId 关联的多播逻辑端点内要访问的资源的基偏移的 64 位无符号值。
size 操作数为 32 位,指定要复制的字节数。它必须是 16 的倍数;否则行为未定义。目标范围 [dst, dst + size - 1] 必须在目标内存空间的边界之内。源范围 [srcDataOff, srcDataOff + size - 1] 必须在当前设备上与 srcLeId 关联的逻辑端点的边界之内。
目标指针 dst 与源句柄偏移 srcDataOff 必须 16 字节对齐。
对多播逻辑端点所引用的所有资源读取到的值执行归约。.redOp* 限定符指定归约运算。.type* 限定符指定源数组中每个数据元素的类型。
srcLeId 操作数必须关联到支持拉取归约的多播逻辑端点,且发起该操作的设备必须是该多播端点的一个成员。
若 .dst 为 .shared::cta,则目标 [dst] 与栅栏 [bar] 引用本地 CTA 的共享内存。
mbarrier 对象 bar 必须用 .layout::v1 初始化(参见
mbarrier 对象的布局)。限定符
.mbarrier::complete_tx::bytes 指定 complete-tx 操作在 bar 上执行,其完成计数等于所复制的字节数。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
.mbarrier::report::fabric 的说明参见 Fabric 报告机制。
本指令通过 fabric-proxy 访问由句柄操作数所指定位置的数据,通过 async-proxy 访问目标 .shared::cta,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
本操作具有如 内存一致性模型 所述的 .relaxed.sys 内存序语义。
.sync 限定符表示该指令会使发起线程等待,直到所有 warp 通道都以相同的操作数值执行本指令。操作数 imm-membermask 是一个整数常量,且必须为 0xFFFFFFFF。在下列情况下,行为未定义:
在某线程等待期间,某个 warp 通道以不同的操作数值执行本指令,或
warp 中任何线程已退出。
示例
fabric.try_pullred.async.multimem.mbarrier::complete_tx::bytes.mbarrier::report::fabric.shared::cta.f32.add.sync.relaxed.sys [dst], [leId, offset], size, [mbar], 0xFFFFFFFF;
9.7.11.5.5. Fabric 指令:fabric.submit#
fabric.submit
提交当前线程先前发起的 fabric 操作。
语法
fabric.submit{.submitop};
.submitop = { .op_restrict::fetching }
说明
提交当前线程先前发起的 fabric 操作。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。否则,行为未定义。参见 Fabric 操作的一生。
若指定 .op_restrict::fetching,则仅提交当前线程先前发起的 fabric.try_get 和 fabric.try_pullred 操作。否则,提交当前线程先前发起的所有 fabric 操作。
本操作对已被提交的 fabric 操作没有影响。
示例
fabric.submit.op_restrict::fetching;
fabric.submit;
9.7.11.5.6. Fabric 指令:fabric.wait#
fabric.wait
等待对已提交 fabric 操作的本地共享内存读取。
语法
fabric.wait.sync_restrict::reads;
说明
Fabric 读取完成机制指令 fabric.wait 等待对已提交 fabric 操作的本地共享内存(.shared::cta)读取。这使得可以在这些操作完成之前覆写被其读取的共享内存。
示例
fabric.wait.sync_restrict::reads;
9.7.11.5.7. Fabric 指令:fabric.try_get.async.tensor#
fabric.try_get.async.tensor
从 fabric 句柄异步拷贝张量数据。
语法
fabric.try_get.async.tensor.dim.dst{.load_mode}.completion_mechanism
{.level::cache_hint}.override::global_address{.override_attribute}
.sem.sco.b128
[dstMem], [tensorMap, tensorMapLeId, tensorMapOff,
attributeOverrideInfo, tensorCoords], [mbar] {, cache_policy};
.dim = { .1d, .2d, .3d, .4d, .5d };
.dst = { .shared::cta };
.load_mode = { .tiled };
.completion_mechanism = { .mbarrier::complete_tx::bytes.mbarrier::report::fabric };
.sem.sco = { .relaxed.sys };
.level::cache_hint = { .l2::cache_hint };
.override_attribute = { .override::global_dim, .override::global_dim_stride };
说明
从位于 fabric 句柄 [tensorMapLeId, tensorMapOff] 处的张量异步复制数据到目标内存 [dstMem],其中 tensorMapLeId 是表示逻辑端点标识符的 32 位无符号值,而 tensorMapOff 是表示在与 tensorMapLeId 关联的逻辑端点内要访问的资源的基偏移的 64 位无符号值。
与 tensorMapLeId 关联的逻辑端点必须是单播逻辑端点。
范围 [dstMem, dstMem + size - 1] 必须在目标内存空间的边界之内,其中 size 由张量描述符 tensorMap 计算得出,且为从源 fabric 句柄复制的字节数。它必须是 16 的倍数;否则行为未定义。源句柄偏移 tensorMapOff 与目标指针 dstMem 必须 16 字节对齐。
若 .dst 为 .shared::cta,则:
拷贝的目标
[dstMem]与栅栏[mbar]必须引用本地 CTA 的共享内存;否则行为未定义。完成机制必须为
.mbarrier::complete_tx::bytes.mbarrier::report::fabric。
mbarrier 对象 mbar 必须用 .layout::v1 初始化(参见
mbarrier 对象的布局)。限定符
.mbarrier::complete_tx::bytes 指定该操作通过执行一次 complete-tx 操作 来完成,其完成计数为所复制的总字节数,施加在由地址操作数 mbar 所指定位置的 mbarrier 对象上。.mbarrier::report::fabric 的说明参见 Fabric 报告机制。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
操作数 tensorMap 是不透明张量映射对象的通用地址,该对象位于 .param 空间、.const 空间或 .global 空间中。操作数 tensorMap 指定张量拷贝操作的属性。tensorMap 在 tensormap 代理中被访问。有关在主机侧创建张量映射对象的内容,请参考 CUDA programming guide。
张量数据的维度由 .dim 限定符指定。
限定符 .load_mode 指定源位置中的数据如何被复制到目标位置。
本指令通过 fabric-proxy 读取由句柄操作数所指定位置的数据,通过 tensormap-proxy 读取操作数 tensorMap,通过 async-proxy 将数据复制到目标 .shared::cta 内存,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
限定符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。更多细节参见 覆盖张量属性值。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
对源句柄的访问是 128 位宽、具有 .relaxed.sys 内存序语义的原子操作,如 内存一致性模型 所述。对目标共享内存的访问具有弱内存序语义。
示例
fabric.try_get.async.tensor.1d.shared::cta.tiled.mbarrier::complete_tx::bytes.mbarrier::report::fabric.override::global_address.relaxed.sys.b128 [dstSmem], [tensorDesc, overrideLeId, overrideLeOff, {u}], [mbar];
fabric.try_get.async.tensor.1d.shared::cta.tiled.mbarrier::complete_tx::bytes.mbarrier::report::fabric.override::global_address.relaxed.sys.l2::cache_hint.b128 [dstSmem], [tensorDesc, overrideLeId, overrideLeOff, {u}], [mbar], mdesc;
9.7.11.5.8. Fabric 指令:fabric.try_put.async.tensor#
fabric.try_put.async.tensor
向 fabric 句柄异步拷贝张量数据。
语法
// Form 0
fabric.try_put.async.tensor{.multimem}.dim.src{.load_mode}.completion_mechanism0
{.level::cache_hint}.override::global_address{.override_attribute}
.sem.sco.b128
[tensorMap, tensorMapLeId, tensorMapOff,
attributeOverrideInfo, tensorCoords], [src], sizeBytes, [mbar] {, cache_policy};
// Form 1 (counted::bytes)
fabric.try_put.async.tensor{.multimem}.dim.src{.load_mode}.completion_mechanism1
{.level::cache_hint}.override::global_address{.override_attribute}
.sem.sco.b128
[tensorMap, tensorMapLeId, tensorMapOff, counterOff,
attributeOverrideInfo, tensorCoords], [src], sizeBytes, [mbar] {, cache_policy};
.dim = { .1d, .2d, .3d, .4d, .5d };
.src = { .shared::cta };
.load_mode = { .tiled };
.completion_mechanism0 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric };
.completion_mechanism1 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric.counted::bytes };
.sem.sco = { .relaxed.sys };
.level::cache_hint = { .l2::cache_hint };
.override_attribute = { .override::global_dim, .override::global_dim_stride };
说明
从源内存 [src] 异步复制数据到位于 fabric 句柄 [tensorMapLeId, tensorMapOff] 处的张量,其中 tensorMapLeId 是表示逻辑端点标识符的 32 位无符号值,而 tensorMapOff 是表示在与 tensorMapLeId 关联的逻辑端点内要访问的资源的基偏移的 64 位无符号值。
sizeBytes 操作数为 32 位,指定要复制的字节数。它必须是 16 的倍数;否则行为未定义。本指令所传输的字节数由张量描述符操作数 tensorMap 计算得出,且必须与 sizeBytes 相符;否则行为未定义。范围 [src, src + sizeBytes - 1] 必须在源内存空间的边界之内。源指针 src 与目标句柄偏移 tensorMapOff 必须 16 字节对齐。
若指定可选的 .multimem 限定符,则 tensorMapLeId 必须关联到一个多播逻辑端点,且发起该操作的设备必须是该端点的一个成员。并且在 .multimem 情形下,拷贝操作会在该多播端点的所有成员设备上执行。在缺少 .multimem 修饰符时,tensorMapLeId 必须关联到一个单播逻辑端点。
若 .src 为 .shared::cta,则拷贝的源 [src] 与栅栏 [mbar] 引用本地 CTA 的共享内存。
mbarrier 对象 mbar 必须用 .layout::v1 初始化(参见
mbarrier 对象的布局)。限定符
.mbarrier::complete_tx::16B 指定 complete-tx 操作在 mbar 上执行,其完成计数等于所复制字节数除以 16;即每复制 16 字节计数加一。注意,该完成机制与 fabric.try_get.async.tensor 者不同,后者 complete-tx 操作以等于所复制字节数的完成计数执行。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
若存在限定符 .counted::bytes,则:
tensorMapLeId必须关联到支持计数完成的逻辑端点(计数完成机制),且计数器偏移
counterOff必须 256 字节对齐,且范围
[counterOff, counterOff + 7]在当前设备上必须处于逻辑端点tensorMapLeId的边界之内,且不得与被访问的tensorMap重叠,且本操作使用在
[tensorMapLeId, counterOff]处指定的、256 字节对齐、大小为 8 字节的计数器,为目标数据提供基于计数器的完成。
.mbarrier::report::fabric 的说明参见
Fabric 报告机制。
操作数 tensorMap 是不透明张量映射对象的通用地址,该对象位于 .param 空间、.const 空间或 .global 空间中。操作数 tensorMap 指定张量拷贝操作的属性。tensorMap 在 tensormap 代理中被访问。有关在主机侧创建张量映射对象的内容,请参考 CUDA programming guide。
张量数据的维度由 .dim 限定符指定。
限定符 .load_mode 指定源位置中的数据如何被复制到目标位置。
本指令通过 fabric-proxy 访问由句柄操作数所指定位置的数据和计数器,通过 tensormap-proxy 读取 tensorMap,通过 async-proxy 从源 .shared::cta 读取,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
限定符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。更多细节参见 覆盖张量属性值。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
本操作具有如 内存一致性模型 所述的 .relaxed.sys 内存序语义。对源共享内存的访问具有弱内存序语义。
示例
fabric.try_put.async.tensor.2d.shared::cta.tile.mbarrier::complete_tx::16B.mbarrier::report::fabric.override::global_address.override::global_dim_stride.relaxed.sys.b128
[tensorDesc, overrideLeId, overrideLeOff, {overrideSize16_0, overrideSize16_1}, {overrideLowerStrd_0}, overrideUpperStrd, {u, v}], [srcSmem], numBytes, [mbar];
fabric.try_put.async.tensor.multimem.5d.shared::cta.tile.mbarrier::complete_tx::16B.mbarrier::report::fabric.override::global_address.override::global_dim_stride.relaxed.sys.L2::cache_hint.b128
[tensorDesc, overrideLeId, overrideLeOff, {overrideSize_0, overrideSize_1, overrideSize_2, overrideSize_3, overrideSize_4}, {overrideLowerStrd_0, overrideLowerStrd_1, overrideLowerStrd_2, overrideLowerStrd_3}, overrideUpperStrd, {u, v, w, x, y}], [srcSmem], numBytes, [mbar], mdesc;
9.7.11.5.9. Fabric 指令:fabric.try_red.async.tensor#
fabric.try_red.async.tensor
向 fabric 句柄异步归约张量数据。
语法
// Form 0
fabric.try_red.async.tensor{.multimem}.dim.src{.load_mode}.completion_mechanism0
{.level::cache_hint}.override::global_address{.override_attribute}
.sem.sco.redOp.type
[tensorMap, tensorMapLeId, tensorMapOff,
attributeOverrideInfo, tensorCoords], [src], sizeBytes, [mbar] {, cache_policy};
// Form 1 (counted::bytes)
fabric.try_red.async.tensor{.multimem}.dim.src{.load_mode}.completion_mechanism1
{.level::cache_hint}.override::global_address{.override_attribute}
.sem.sco.redOp.type
[tensorMap, tensorMapLeId, tensorMapOff, counterOff,
attributeOverrideInfo, tensorCoords], [src], sizeBytes, [mbar] {, cache_policy};
.dim = { .1d, .2d, .3d, .4d, .5d };
.src = { .shared::cta };
.load_mode = { .tiled };
.completion_mechanism0 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric };
.completion_mechanism1 = { .mbarrier::complete_tx::16B.mbarrier::report::fabric.counted::bytes };
.sem.sco = { .relaxed.sys };
.level::cache_hint = { .l2::cache_hint };
.override_attribute = { .override::global_dim, .override::global_dim_stride };
.redOp = { .and, .xor, .or, .add, .min, .max };
说明
从源内存 [src] 异步复制 sizeBytes 字节到位于 fabric 句柄 [tensorMapLeId, tensorMapOff] 处的张量并做逐元素归约,其中 tensorMapLeId 是表示逻辑端点标识符的 32 位无符号值,而 tensorMapOff 是表示在与 tensorMapLeId 关联的逻辑端点内要访问的资源的基偏移的 64 位无符号值。
sizeBytes 操作数为 32 位,指定要复制的字节数。它必须是 16 的倍数;否则行为未定义。范围 [src, src + sizeBytes - 1] 必须在源内存空间的边界之内。源指针 src 与目标句柄偏移 tensorMapOff 必须 16 字节对齐。
目标数组中的每个数据元素在目标处与源数组中对应的数据元素进行归约,归约操作由修饰符 .redOp 指定。源数组与目标数组中每个数据元素的类型由 tensorMap 指定。
若指定可选的 .multimem 限定符,则 tensorMapLeId 必须关联到一个多播逻辑端点,使得发起该操作的设备是该多播端点的一个成员。并且在 .multimem 情形下,归约操作会在该多播端点的所有成员设备上执行。在缺少 .multimem 限定符时,tensorMapLeId 必须关联到一个单播逻辑端点。
若 .src 为 .shared::cta,则拷贝的源 [src] 与栅栏 [mbar] 引用本地 CTA 的共享内存。
mbarrier 对象 mbar 必须用 .layout::v1 初始化(参见 mbarrier 对象的布局)。限定符 .mbarrier::complete_tx::16B 指定 complete-tx 操作在 mbar 上执行,其完成计数等于所复制字节数除以 16;即每复制 16 字节计数加一。注意,fabric.try_get 使用一种不同的完成机制,其中 complete-tx 操作以等于所复制字节数的完成计数执行。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
若存在限定符 .counted::bytes,则:
tensorMapLeId必须关联到支持计数完成的逻辑端点(计数完成机制),且计数器偏移
counterOff必须 256 字节对齐,且范围
[counterOff, counterOff + 7]在当前设备上必须处于逻辑端点tensorMapLeId的边界之内,且不得与被访问的tensorMap重叠,且本操作使用在
[tensorMapLeId, counterOff]处指定的、256 字节对齐、大小为 8 字节的计数器,为目标数据提供基于计数器的完成。
.mbarrier::report::fabric 的说明参见 Fabric 报告机制。
操作数 tensorMap 是不透明张量映射对象的通用地址,该对象位于 .param 空间、.const 空间或 .global 空间中。操作数 tensorMap 指定张量拷贝操作的属性,如张量映射中所述。tensorMap 在 tensormap 代理中被访问。有关在主机侧创建张量映射对象的内容,请参考 CUDA programming guide。
张量数据的维度由 .dim 限定符指定。
限定符 .load_mode 指定源位置中的数据如何被复制到目标位置。
下表描述了 .redOp 与元素类型的有效组合:
|
元素类型 |
|---|---|
|
|
|
|
|
|
本指令通过 fabric-proxy 访问由句柄操作数所指定位置的数据和计数器,通过 tensormap-proxy 读取 tensorMap,通过 async-proxy 从源 .shared::cta 读取,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
限定符 .override::global_address 和 .override_attribute 支持对 tensorMap 对象中存在的各种张量属性进行值覆盖。更多细节参见 覆盖张量属性值。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
本操作具有如 内存一致性模型 所述的 .relaxed.sys 内存序语义。对源共享内存的访问具有弱内存序语义。
示例
fabric.try_red.async.tensor.2d.shared::cta.tile.mbarrier::complete_tx::16B.mbarrier::report::fabric.override::global_address.override::global_dim_stride.relaxed.sys.max
[tensorDesc, overrideLeId, overrideLeOff, {overrideSize_0, overrideSize_1}, {overrideLowerStrd_0}, overrideUpperStrd, {u, v}], [srcSmem], numBytes, [mbar];
fabric.try_red.async.tensor.3d.shared::cta.tile.mbarrier::complete_tx::16B.mbarrier::report::fabric.override::global_address.override::global_dim_stride.relaxed.sys.L2::cache_hint.or
[tensorDesc, overrideLeId, overrideLeOff, {overrideSize_0, overrideSize_1, overrideSize_2}, {overrideLowerStrd_0, overrideLowerStrd_1}, overrideUpperStrd, {u, v, w}], [srcSmem], numBytes, [mbar], mdesc;
9.7.11.5.10. Fabric 指令:fabric.try_atom#
fabric.try_atom
向 fabric 句柄执行异步原子操作。
语法
// Bitwise operations
fabric.try_atom.async.src.completion_mechanism{.level::cache_hint}.sem.sco.redOpBit.typeBit
[dstLeId, dstDataOff], [smem_dst], [smem_src], [mbar] {, cache_policy};
// Exchange / compare-and-swap
fabric.try_atom.async.src.completion_mechanism{.level::cache_hint}.sem.sco.redOpExchCas.typeExchCas
[dstLeId, dstDataOff], [smem_dst], [smem_src], [mbar] {, cache_policy};
// Min / max operations
fabric.try_atom.async.src.completion_mechanism{.level::cache_hint}.sem.sco.redOpMinMax.typeMinMax
[dstLeId, dstDataOff], [smem_dst], [smem_src], [mbar] {, cache_policy};
// Add operation
fabric.try_atom.async.src.completion_mechanism{.level::cache_hint}.sem.sco.redOpAdd.typeAdd
[dstLeId, dstDataOff], [smem_dst], [smem_src], [mbar] {, cache_policy};
.src = { .shared::cta };
.completion_mechanism = { .mbarrier::complete_tx::16B.mbarrier::report::fabric };
.level::cache_hint = { .L2::cache_hint };
.sem.sco = { .relaxed.sys };
.redOpBit = { .and, .xor, .or };
.typeBit = { .b32, .b64 };
.redOpExchCas = { .exch, .cas };
.typeExchCas = { .b32, .b64, .b128 };
.redOpMinMax = { .min, .max };
.typeMinMax = { .u32, .u64, .f16x2, .bf16x2 };
.redOpAdd = { .add };
.typeAdd = { .u32, .u64, .f16x2, .bf16x2, .f32, .f64 };
说明
原子地将位于 [dstLeId, dstDataOff] 处的原始值加载到目标共享内存位置 [smem_dst],对位于共享内存位置 [smem_src] 的数据与位于 [dstLeId, dstDataOff] 处的值执行归约操作,并将指定操作的结果存储到 [dstLeId, dstDataOff] 处,覆盖原始值。
对于 .cas(比较并交换)操作,位于 [smem_src] 处的低 16 字节为比较值,位于 [smem_src] 处的高 16 字节为交换值。本操作将位于 [dstLeId, dstDataOff] 处的值与比较值进行比较;若二者相等,则将交换值存储到 [dstLeId, dstDataOff] 处,否则保持位于 [dstLeId, dstDataOff] 处的值不变。
本操作在 16 字节上执行。源范围 [smem_src, smem_src + 15] 必须在源内存空间的边界之内。对于 .cas 操作,源范围 [smem_src, smem_src + 31] 必须在源内存空间的边界之内。指针 smem_src 与 smem_dst 必须 16B 对齐。
对于类型 .f16x2、.bf16x2、.b32、.f32 与 .u32,dstDataOff 必须 4B 对齐。对于类型 .b64、.f64 与 .u64,dstDataOff 必须 8B 对齐。对于类型 .b128,dstDataOff 必须 16B 对齐。
原子操作的整元素输入与输出按如下方式选取。设 smemOffset 为 dstDataOff 与其下方 16B 对齐边界(dstDataOff & 0xF)之间的距离。输入元素在 smem_src + smemOffset 处读取,输出元素在 smem_dst + smemOffset 处写入。本操作会向字节范围 [smem_dst, smem_dst + smemOffset) 与 [smem_dst + smemOffset + elementWidth, smem_dst + 16) 写入未指定值。
若 .src 为 .shared::cta,则拷贝的源 [smem_src] 与栅栏 [mbar] 引用本地 CTA 的共享内存。
mbarrier 对象 mbar 必须用 .layout::v1 初始化(参见 mbarrier 对象的布局)。限定符 .mbarrier::complete_tx::16B 指定 complete-tx 操作将在 mbar 上执行,其完成计数等于所复制字节数除以 16;即每复制 16 字节计数加一。注意,指令 fabric.try_get 与 fabric.try_get.async.tensor 使用一种不同的完成机制,其中 complete-tx 操作以等于所复制字节数的完成计数执行。要使任何线程都能经由一个 mbarrier 对象观察到 fabric 操作的完成,发起线程必须在跟踪这些操作的栅栏阶段推进之前提交这些操作。
.mbarrier::report::fabric 的说明参见 Fabric 报告机制。
当指定可选参数 cache_policy 时,必须要有 .level::cache_hint 限定符。64 位操作数 cache_policy 指定在内存访问期间可使用的缓存逐出策略。cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
本指令通过 fabric-proxy 读取并更新由句柄操作数所指定位置的数据,通过 async-proxy 读取并更新源 .shared::cta 处的数据,并通过 generic-proxy 更新 .shared::cta 中的 mbarrier 对象。
本操作的完成可通过 CTA 作用域的运算在栅栏上等待来观察。线程必须在网格退出之前提交 fabric 操作并等待其完成;否则行为未定义。
本操作具有如 内存一致性模型 所述的 .relaxed.sys 内存序语义。对源共享内存与目标共享内存的访问具有弱内存序语义。
语义
atomic {
[smem_dst] = [dstLeId, dstDataOff]; // copy as the prev value
if (operation == cas) { // smem_src must be 32B aligned
b = lower16Bytes([smem_src]); // smem_src value to be compared
c = upper16Bytes([smem_src]); // swap value
[dstLeId, dstDataOff] = cas([dstLeId, dstDataOff], b, c);
} else {
[dstLeId, dstDataOff] = operation([dstLeId, dstDataOff], [smem_src]);
}
}
exch(r, s) = s;
cas(r, s, t) = (r == s) ? t : r;
示例
fabric.try_atom.async.shared::cta.mbarrier::complete_tx::16B.mbarrier::report::fabric.relaxed.sys.and.b32 [dstLeId, dstLeOffData], [dstSmem], [srcSmem], [mbar];
fabric.try_atom.async.shared::cta.mbarrier::complete_tx::16B.mbarrier::report::fabric.relaxed.sys.add.bf16x2 [dstLeId, dstLeOffData], [dstSmem], [srcSmem], [mbar];
fabric.try_atom.async.shared::cta.L2::cache_hint.mbarrier::complete_tx::16B.mbarrier::report::fabric.relaxed.sys.xor.b64 [dstLeId, dstLeOffData], [dstSmem], [srcSmem], [mbar], mdesc;
9.7.12. 纹理指令#
本节介绍用于访问纹理和采样器的 PTX 指令。PTX 支持对纹理和采样器描述符执行以下操作:
纹理和采样器描述符的静态初始化。
纹理和采样器描述符的模块作用域与逐入口作用域定义。
能够查询纹理和采样器描述符内的字段。
9.7.12.1. 纹理模式#
在处理纹理和采样器时,PTX 有两种工作模式。在统一模式下,纹理和采样器信息通过单个 .texref 句柄访问。在独立模式下,纹理信息和采样器信息各自拥有自己的句柄,从而可以被分别定义,并在程序中使用的地点加以组合。
统一模式的优点是,每个内核允许 256 个采样器(早于 sm_3x 的架构为 128 个),其限制是这些采样器必须与每个内核中 256 个可能的纹理(早于 sm_3x 的架构为 128 个)一一对应。独立模式的优点是纹理和采样器可以自由混搭,但采样器的数量被大幅限制为每个内核 32 个(早于 sm_3x 的架构为 16 个)。
表 40 汇总了在不同纹理模式下可用的纹理、采样器和表面的数量。
纹理模式 |
资源 |
|
|
|---|---|---|---|
统一模式 |
纹理 |
128 |
256 |
采样器 |
128 |
256 |
|
表面 |
8 |
16 |
|
独立模式 |
纹理 |
128 |
256 |
采样器 |
16 |
32 |
|
表面 |
8 |
16 |
纹理模式通过 .target 选项 texmode_unified 与 texmode_independent 选定。一个 PTX 模块只能声明一种纹理模式。若未声明任何纹理模式,则假定该模块使用统一模式。
示例:将某个元素的功率贡献计算为 该元素的功率 / 元素总数。
.target texmode_independent
.global .samplerref tsamp1 = { addr_mode_0 = clamp_to_border,
filter_mode = nearest
};
...
.entry compute_power
( .param .texref tex1 )
{
txq.width.b32 r6, [tex1]; // get tex1's width
txq.height.b32 r5, [tex1]; // get tex1's height
tex.2d.v4.f32.f32 {r1,r2,r3,r4}, [tex1, tsamp1, {f1,f2}];
mul.u32 r5, r5, r6;
add.f32 r1, r1, r2;
add.f32 r3, r3, r4;
add.f32 r1, r1, r3;
cvt.f32.u32 r5, r5;
div.f32 r1, r1, r5;
}
9.7.12.2. Mipmap#
Mipmap 是一系列纹理,其中每一个都是同一图像的分辨率逐次降低的表示。Mipmap 中的每张图像(即细节层次,LOD)的高度和宽度,都是比上一级小 2 的幂。图形应用程序使用 Mipmap 来提高渲染速度并减少走样(混叠)伪影。例如,靠近用户的物体使用高分辨率的 Mipmap 图像;而当物体显得越远时使用越低分辨率的图像。在两个细节层次(LOD)之间切换时提供了 Mipmap 过滤模式,以避免视觉保真度的突变。
示例:若某纹理的基本尺寸为 256×256 像素,则其关联的 Mipmap 集合可包含一系列共八张图像,每一张的面积都是前一张的四分之一:128×128 像素、64×64、32×32、16×16、8×8、4×4、2×2、1×1(单个像素)。例如,若某个场景在 40×40 像素的范围内渲染该纹理,则要么使用 32×32 图像的放大版本(不使用三线性插值),要么使用 64×64 与 32×32 两张 Mipmap 的插值结果(使用三线性插值)。
完整的 Mipmap 金字塔中 LOD 的总数由下式计算:
numLODs = 1 + floor(log2(max(w, h, d)))
最精细的 LOD 称为基准层(base level),即第 0 层。下一个(更粗糙的)层是第 1 层,依此类推。最粗糙的层是尺寸为 (1×1×1) 的层。每个后续的更小 Mipmap 层的 {宽度, 高度, 深度} 都是上一层的一半,但如果这个一半的值是分数量,则向下取整到最接近的整数。本质上,一个 Mipmap 层的大小可表示为:
max(1, floor(w_b / 2^i)) x
max(1, floor(h_b / 2^i)) x
max(1, floor(d_b / 2^i))
其中 i 是超出第 0 层(基准层)的第 i 层,而 w_b、h_b 与 d_b 分别是基准层的宽度、高度与深度。
PTX 对 Mipmap 的支持
PTX 的 tex 指令支持三种指定 LOD 的模式:base、level 与 gradient。在 base 模式中,该指令始终选取第 0 层。在 level 模式中,会提供一个额外的参数来指定要抓取的 LOD。在 grad 模式中,两个浮点向量参数提供偏导数(例如,对于一个 2d 纹理为 {ds/dx, dt/dx} 与 {ds/dy, dt/dy}),tex 指令用它们来计算 LOD。
这些指令提供对纹理内存的访问。
textld4txq
9.7.12.3. 纹理指令:tex#
tex
执行一次纹理内存查找。
语法
tex.geom.v4.dtype.ctype d, [a, c] {, e} {, f};
tex.geom.v4.dtype.ctype d[|p], [a, b, c] {, e} {, f}; // explicit sampler
tex.geom.v2.f16x2.ctype d[|p], [a, c] {, e} {, f};
tex.geom.v2.f16x2.ctype d[|p], [a, b, c] {, e} {, f}; // explicit sampler
// mipmaps
tex.base.geom.v4.dtype.ctype d[|p], [a, {b,} c] {, e} {, f};
tex.level.geom.v4.dtype.ctype d[|p], [a, {b,} c], lod {, e} {, f};
tex.grad.geom.v4.dtype.ctype d[|p], [a, {b,} c], dPdx, dPdy {, e} {, f};
tex.base.geom.v2.f16x2.ctype d[|p], [a, {b,} c] {, e} {, f};
tex.level.geom.v2.f16x2.ctype d[|p], [a, {b,} c], lod {, e} {, f};
tex.grad.geom.v2.f16x2.ctype d[|p], [a, {b,} c], dPdx, dPdy {, e} {, f};
.geom = { .1d, .2d, .3d, .a1d, .a2d, .cube, .acube, .2dms, .a2dms };
.dtype = { .u32, .s32, .f16, .f32 };
.ctype = { .s32, .f32 }; // .cube, .acube require .f32
// .2dms, .a2dms require .s32
说明
tex.{1d,2d,3d}
使用纹理坐标向量进行纹理查找。本指令从由操作数 a 所命名的纹理中、在由操作数 c 给出的坐标处加载数据到目标 d。对于 1d 纹理,操作数 c 是一个标量或单元素元组;对于 2d 纹理,是一个二元素向量;对于 3d 纹理,是一个四元素向量,其中第四元素被忽略。可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
可指定可选的操作数 e。操作数 e 是一个 .s32 值的向量,用于指定坐标偏移。在执行纹理查找之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。对于 1d 纹理,操作数 e 是单元素元组;对于 2d 纹理,是二元素向量;对于 3d 纹理,是四元素向量,其中第四元素被忽略。
对于 depth textures,可指定可选的操作数 f。深度纹理是一类特殊的纹理,保存来自深度缓冲区的数据。深度缓冲区包含每个像素的深度信息。操作数 f 是一个 .f32 标量值,用于指定深度纹理的深度比较值。从纹理取回的每个元素都与 f 操作数给出的值进行比较。若比较通过,结果为 1.0;否则结果为 0.0。这些逐元素比较结果用于过滤。使用深度比较操作数时,纹理坐标向量 c 中的元素具有 .f32 类型。
深度比较操作数不受 3d 纹理支持。
对于目标类型 .f16x2,本指令返回一个二元素向量。对于所有其他目标类型,本指令返回一个四元素向量。坐标可以以有符号 32 位整数或 32 位浮点数形式给出。
假定纹理基地址对齐到 16 字节边界,且坐标向量给出的地址必须自然对齐到访问大小的整数倍。若某个地址未正确对齐,则其行为未定义;也就是说,访问可能通过静默地屏蔽低位地址位以实现正确取整而继续进行,或者该指令可能触发错误(fault)。
tex.{a1d,a2d}
纹理数组选择,随后进行纹理查找。本指令首先使用数组坐标向量 c 第一个元素给出的索引,从由操作数 a 所命名的纹理数组中选择一个纹理。随后,本指令从所选纹理中、在由操作数 c 其余元素给出的坐标处加载数据到目标 d。操作数 c 是一个位宽类型向量或元组,其中包含一个指向纹理数组的索引,后接所选纹理内的坐标,如下所示:
对于 1d 纹理数组,操作数
c的类型为.v2.b32。第一个元素被解释为指向纹理数组的无符号整数索引(.u32),第二个元素被解释为.ctype类型的 1d 纹理坐标。对于 2d 纹理数组,操作数
c的类型为.v4.b32。第一个元素被解释为指向纹理数组的无符号整数索引(.u32),接下来两个元素被解释为.ctype类型的 2d 纹理坐标。第四个元素被忽略。
可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。
可指定可选的操作数 e。操作数 e 是一个 .s32 值的向量,用于指定坐标偏移。在执行纹理查找之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。对于 1d 纹理数组,操作数 e 是单元素元组;对于 2d 纹理数组,是二元素向量。
可针对深度纹理数组指定可选的操作数 f。操作数 f 是一个 .f32 标量值,用于指定深度纹理的深度比较值。使用深度比较操作数时,纹理坐标向量 c 中的坐标具有 .f32 类型。
对于目标类型 .f16x2,本指令返回一个二元素向量。对于所有其他目标类型,本指令返回一个四元素向量。纹理数组索引是 32 位无符号整数,纹理坐标元素是 32 位有符号整数或浮点值。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
tex.cube
Cubemap 纹理查找。本指令从由操作数 a 所命名的 cubemap 纹理中、在由操作数 c 给出的坐标处加载数据到目标 d。Cubemap 纹理是一类特殊的二维分层纹理,由表示立方体六个面的六层组成。cubemap 中的所有层大小相同且为正方形(即宽度等于高度)。
访问 cubemap 时,纹理坐标向量 c 的类型为 .v4.f32,由三个浮点坐标(s、t、r)和一个被忽略的第四填充参数组成。坐标(s、t、r)被投影到六个立方体面之一。可以将(s、t、r)坐标视为从立方体中心发出的方向向量。在三个坐标(s、t、r)中,幅值最大的坐标(主轴)用于选择立方体面。然后,另外两个坐标(次轴)除以主轴的绝对值,得到一个新的(s、t)坐标对,用于在所选择的立方体面中查找。
可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。
偏移向量操作数 e 不受 cubemap 纹理支持。
可针对 cubemap 深度纹理指定可选的操作数 f。操作数 f 是一个 .f32 标量值,用于指定 cubemap 深度纹理的深度比较值。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
tex.acube
Cubemap 数组选择,随后进行 cubemap 查找。本指令首先使用数组坐标向量 c 第一个元素给出的索引,从由操作数 a 所命名的 cubemap 数组中选择一个 cubemap 纹理。随后,本指令从所选的 cubemap 纹理中、在由操作数 c 其余元素给出的坐标处加载数据到目标 d。
Cubemap array 纹理由一组 cubemap 组成,即层的总数是六的倍数。访问 cubemap 数组纹理时,坐标向量 c 的类型为 .v4.b32。第一个元素被解释为指向 cubemap 数组的无符号整数索引(.u32),其余三个元素被解释为浮点 cubemap 坐标(s、t、r),如上所述用于在所选 cubemap 中查找。
可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。
偏移向量操作数 e 不受 cubemap 纹理数组支持。
可针对 cubemap 深度纹理数组指定可选的操作数 f。操作数 f 是一个 .f32 标量值,用于指定 cubemap 深度纹理的深度比较值。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
tex.2dms
使用纹理坐标向量的多重采样纹理查找。多重采样纹理为每个数据元素包含多个采样。本指令从由操作数 a 所命名的纹理中、在由操作数 c 其余元素给出的坐标处,取回由操作数 c 第一个元素给出的采样编号的采样数据,加载到目标 d。访问多重采样纹理时,纹理坐标向量 c 的类型为 .v4.b32。操作数 c 中的第一个元素被解释为无符号整数采样编号(.u32),接下来两个元素被解释为有符号整数(.s32)2d 纹理坐标。第四个元素被忽略。可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。
可指定可选的操作数 e。操作数 e 是类型为 .v2.s32 的向量,用于指定坐标偏移。在执行纹理查找之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。
深度比较操作数 f 不受多重采样纹理支持。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
tex.a2dms
多重采样纹理数组选择,随后进行多重采样纹理查找。本指令首先使用数组坐标向量 c 第一个元素给出的索引,从由操作数 a 所命名的多重采样纹理数组中选择一个多重采样纹理。随后,本指令从所选的多重采样纹理中、在由操作数 c 其余元素给出的坐标处,取回由操作数 c 第二个元素给出的采样编号的采样数据,加载到目标 d。访问多重采样纹理数组时,纹理坐标向量 c 的类型为 .v4.b32。操作数 c 中的第一个元素被解释为无符号整数采样器编号,第二个元素被解释为指向多重采样纹理数组的无符号整数索引(.u32),接下来两个元素被解释为有符号整数(.s32)2d 纹理坐标。可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。
可指定可选的操作数 e。操作数 e 是类型为 .v2.s32 值的向量,用于指定坐标偏移。在执行纹理查找之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。
深度比较操作数 f 不受多重采样纹理数组支持。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
Mipmap
-
.base(lod 零) -
选取第 0 层(基准层)。若未指定任何 mipmap 模式,则这是默认模式。无需额外参数。
-
.level(lod 显式) -
需要一个额外的 32 位标量参数
lod,其中包含要从中抓取的 LOD。lod的类型遵循.ctype(.s32或.f32)。在此模式下不支持几何.2dms与.a2dms。 -
.grad(lod 梯度) -
需要两个
.f32向量dPdx与dPdy来指定偏导数。对于 1d 与 a1d 纹理,这些向量是单元素;对于 2d 与 a2d 纹理,是二元素向量;对于 3d、cube 与 acube 纹理,是四元素向量,其中第四元素对 3d 与 cube 几何被忽略。在此模式下不支持几何.2dms与.a2dms。
对于 mipmap 纹理查找,可指定可选的操作数 e。操作数 e 是 .s32 的向量,用于指定坐标偏移。在执行纹理查找之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。cube 与 cubemap 几何不支持偏移向量操作数。
可针对 mipmap 纹理指定可选的操作数 f。操作数 f 是一个 .f32 标量值,用于指定深度纹理的深度比较值。使用深度比较操作数时,纹理坐标向量 c 中的坐标具有 .f32 类型。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
深度比较操作数不受 3d 纹理支持。
间接纹理访问
自 PTX ISA 3.1 版起,在统一模式下,针对 sm_20 或更高目标架构支持间接纹理访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .texref 变量的地址。
示例
// Example of unified mode texturing
// - f4 is required to pad four-element tuple and is ignored
tex.3d.v4.s32.s32 {r1,r2,r3,r4}, [tex_a,{f1,f2,f3,f4}];
// Example of independent mode texturing
tex.1d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a,smpl_x,{f1}];
// Example of 1D texture array, independent texturing mode
tex.a1d.v4.s32.s32 {r1,r2,r3,r4}, [tex_a,smpl_x,{idx,s1}];
// Example of 2D texture array, unified texturing mode
// - f3 is required to pad four-element tuple and is ignored
tex.a2d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a,{idx,f1,f2,f3}];
// Example of cubemap array, unified textureing mode
tex.acube.v4.f32.f32 {r0,r1,r2,r3}, [tex_cuarray,{idx,f1,f2,f3}];
// Example of multi-sample texture, unified texturing mode
tex.2dms.v4.s32.s32 {r0,r1,r2,r3}, [tex_ms,{sample,r6,r7,r8}];
// Example of multi-sample texture, independent texturing mode
tex.2dms.v4.s32.s32 {r0,r1,r2,r3}, [tex_ms, smpl_x,{sample,r6,r7,r8}];
// Example of multi-sample texture array, unified texturing mode
tex.a2dms.v4.s32.s32 {r0,r1,r2,r3}, [tex_ams,{idx,sample,r6,r7}];
// Example of texture returning .f16 data
tex.1d.v4.f16.f32 {h1,h2,h3,h4}, [tex_a,smpl_x,{f1}];
// Example of texture returning .f16x2 data
tex.1d.v2.f16x2.f32 {h1,h2}, [tex_a,smpl_x,{f1}];
// Example of 3d texture array access with tex.grad,unified texturing mode
tex.grad.3d.v4.f32.f32 {%f4,%f5,%f6,%f7},[tex_3d,{%f0,%f0,%f0,%f0}],
{fl0,fl1,fl2,fl3},{fl0,fl1,fl2,fl3};
// Example of cube texture array access with tex.grad,unified texturing mode
tex.grad.cube.v4.f32.f32{%f4,%f5,%f6,%f7},[tex_cube,{%f0,%f0,%f0,%f0}],
{fl0,fl1,fl2,fl3},{fl0,fl1,fl2,fl3};
// Example of 1d texture lookup with offset, unified texturing mode
tex.1d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a, {f1}], {r5};
// Example of 2d texture array lookup with offset, unified texturing mode
tex.a2d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a,{idx,f1,f2}], {f5,f6};
// Example of 2d mipmap texture lookup with offset, unified texturing mode
tex.level.2d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a,{f1,f2}],
flvl, {r7, r8};
// Example of 2d depth texture lookup with compare, unified texturing mode
tex.1d.v4.f32.f32 {f1,f2,f3,f4}, [tex_a, {f1}], f0;
// Example of depth 2d texture array lookup with offset, compare
tex.a2d.v4.s32.f32 {f0,f1,f2,f3}, [tex_a,{idx,f4,f5}], {r5,r6}, f6;
// Example of destination predicate use
tex.3d.v4.s32.s32 {r1,r2,r3,r4}|p, [tex_a,{f1,f2,f3,f4}];
9.7.12.4. 纹理指令:tld4#
tld4
对 4 纹素双线性插值(bilerp)足迹执行纹理取回。
语法
tld4.comp.2d.v4.dtype.f32 d[|p], [a, c] {, e} {, f};
tld4.comp.geom.v4.dtype.f32 d[|p], [a, b, c] {, e} {, f}; // explicit sampler
.comp = { .r, .g, .b, .a };
.geom = { .2d, .a2d, .cube, .acube };
.dtype = { .u32, .s32, .f32 };
说明
使用纹理坐标向量对 4 纹素双线性插值(bilerp)足迹进行纹理取回。本指令从由操作数 a 所命名的纹理中、在由操作数 c 给出的坐标处,将双线性插值足迹加载到向量目标 d。为每个纹素采样取回的纹理分量由 .comp 指定。四个纹素采样按逆时针顺序、从左下角开始放入目标向量 d 中。
可指定可选的纹理采样器 b。若未指定采样器,则采样器行为是所命名纹理的一个属性。
可选的目标谓词 p 在指定坐标处的纹理数据驻留在内存中时被置为 True,否则被置为 False。当可选的目标谓词 p 被置为 False 时,加载的数据将全为零。指定坐标处纹理数据的内存驻留性,取决于在内核启动之前使用 Driver API 调用对执行环境的设置。更多细节(包括任何系统/实现相关的行为)请参考 Driver API 文档。
对于深度纹理,可指定可选的操作数 f。深度纹理是一类特殊的纹理,保存来自深度缓冲区的数据。深度缓冲区包含每个像素的深度信息。操作数 f 是一个 .f32 标量值,用于指定深度纹理的深度比较值。从纹理取回的每个元素都与 f 操作数给出的值进行比较。若比较通过,结果为 1.0;否则结果为 0.0。这些逐元素比较结果用于过滤。
假定纹理基地址对齐到 16 字节边界,且坐标向量给出的地址必须自然对齐到访问大小的整数倍。若某个地址未正确对齐,则其行为未定义;也就是说,访问可能通过静默地屏蔽低位地址位以实现正确取整而继续进行,或者该指令可能触发错误(fault)。
tld4.2d
对于 2D 纹理,操作数 c 将坐标指定为一个二元素、32 位浮点向量。
可指定可选的操作数 e。操作数 e 是类型为 .v2.s32 的向量,用于指定坐标偏移。在执行纹理取回之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。
tld4.a2d
纹理数组选择,随后对 2d 纹理执行 tld4 纹理取回。对于 2d 纹理数组,操作数 c 是一个四元素、32 位向量。操作数 c 中的第一个元素被解释为指向纹理数组的无符号整数索引(.u32),接下来两个元素被解释为 2d 纹理的 32 位浮点坐标。第四个元素被忽略。
可指定可选的操作数 e。操作数 e 是类型为 .v2.s32 的向量,用于指定坐标偏移。在执行纹理取回之前,偏移被应用于坐标。偏移值的范围为 -8 到 +7。
tld4.cube
对于 cubemap 纹理,操作数 c 指定一个四元素向量,由三个浮点坐标(s、t、r)和一个被忽略的第四填充参数组成。
Cubemap 纹理是一类特殊的二维分层纹理,由表示立方体六个面的六层组成。cubemap 中的所有层大小相同且为正方形(即宽度等于高度)。
坐标(s、t、r)被投影到六个立方体面之一。可以将(s、t、r)坐标视为从立方体中心发出的方向向量。在三个坐标(s、t、r)中,幅值最大的坐标(主轴)用于选择立方体面。然后,另外两个坐标(次轴)除以主轴的绝对值,得到一个新的(s、t)坐标对,用于在所选择的立方体面中查找。
偏移向量操作数 e 不受 cubemap 纹理支持。
tld4.acube
Cubemap 数组选择,随后对 cubemap 纹理执行 tld4 纹理取回。操作数 c 中的第一个元素被解释为指向 cubemap 纹理数组的无符号整数索引(.u32),其余三个元素被解释为浮点 cubemap 坐标(s、t、r),用于在所选 cubemap 中查找。
偏移向量操作数 e 不受 cubemap 纹理数组支持。
间接纹理访问
自 PTX ISA 3.1 版起,在统一模式下,针对 sm_20 或更高目标架构支持间接纹理访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .texref 变量的地址。
示例
//Example of unified mode texturing
tld4.r.2d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a,{f1,f2}];
// Example of independent mode texturing
tld4.r.2d.v4.u32.f32 {u1,u2,u3,u4}, [tex_a,smpl_x,{f1,f2}];
// Example of unified mode texturing using offset
tld4.r.2d.v4.s32.f32 {r1,r2,r3,r4}, [tex_a,{f1,f2}], {r5, r6};
// Example of unified mode texturing using compare
tld4.r.2d.v4.f32.f32 {f1,f2,f3,f4}, [tex_a,{f5,f6}], f7;
// Example of optional destination predicate
tld4.r.2d.v4.f32.f32 {f1,f2,f3,f4}|p, [tex_a,{f5,f6}], f7;
9.7.12.5. 纹理指令:txq#
txq
查询纹理与采样器属性。
语法
txq.tquery.b32 d, [a]; // texture attributes
txq.level.tlquery.b32 d, [a], lod; // texture attributes
txq.squery.b32 d, [a]; // sampler attributes
.tquery = { .width, .height, .depth,
.channel_data_type, .channel_order,
.normalized_coords, .array_size,
.num_mipmap_levels, .num_samples};
.tlquery = { .width, .height, .depth };
.squery = { .force_unnormalized_coords, .filter_mode,
.addr_mode_0, addr_mode_1, addr_mode_2 };
说明
查询纹理或采样器的某个属性。操作数 a 是一个 .texref 或 .samplerref 变量,或一个 .u64 寄存器。
查询 |
返回值 |
|---|---|
|
|
以元素为单位的值 |
|
与源语言的通道数据类型枚举相对应的无符号整数。若源语言将通道数据类型与通道顺序合并为单一的枚举类型,则 |
|
与源语言的通道顺序枚举相对应的无符号整数。若源语言将通道数据类型与通道顺序合并为单一的枚举类型,则 |
|
|
|
|
|
取自 |
|
|
取自
|
|
对于纹理数组,为数组中的纹理数量;否则为 0。 |
|
对于带 mipmap 的纹理,为细节层次(LOD)的数量;否则为 0。 |
|
对于多重采样纹理,为采样的数量;否则为 0。 |
纹理属性通过向 txq 提供一个 .texref 实参来查询。在统一模式下,采样器属性也经由 .texref 实参访问;在独立模式下,采样器属性经由单独的 .samplerref 实参访问。
txq.level
txq.level 需要一个额外的 32 位整数实参 lod,用于指定 LOD,并针对所指定的 LOD 查询所请求的属性。
间接纹理访问
自 PTX ISA 3.1 版起,在统一模式下,针对 sm_20 或更高目标架构支持间接纹理访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .texref 变量的地址。
示例
txq.width.b32 %r1, [tex_A];
txq.filter_mode.b32 %r1, [tex_A]; // unified mode
txq.addr_mode_0.b32 %r1, [smpl_B]; // independent mode
txq.level.width.b32 %r1, [tex_A], %r_lod;
9.7.12.6. 纹理指令:istypep#
istypep
查询某个寄存器是否指向指定类型的不透明变量。
语法
istypep.type p, a; // result is .pred
.type = { .texref, .samplerref, .surfref };
说明
若寄存器 a 指向指定类型的不透明变量,则向谓词寄存器 p 写入 1,否则写入 0。目标 p 的类型为 .pred;源地址操作数的类型必须为 .u64。
示例
istypep.texref istex, tptr;
istypep.samplerref issampler, sptr;
istypep.surfref issurface, surfptr;
9.7.13. 表面指令#
本节介绍用于访问表面的 PTX 指令。PTX 支持对表面描述符执行以下操作:
表面描述符的静态初始化。
表面描述符的模块作用域与逐入口作用域定义。
能够查询表面描述符内的字段。
这些指令提供对表面内存的访问。
suldsustsuredsuq
9.7.13.1. 表面指令:suld#
suld
从表面内存加载。
语法
suld.b.geom{.cop}.vec.dtype.clamp d, [a, b]; // unformatted
.geom = { .1d, .2d, .3d, .a1d, .a2d };
.cop = { .ca, .cg, .cs, .cv }; // cache operation
.vec = { none, .v2, .v4 };
.dtype = { .b8 , .b16, .b32, .b64 };
.clamp = { .trap, .clamp, .zero };
说明
suld.b.{1d,2d,3d}
使用表面坐标向量从表面内存加载。本指令从由操作数 a 所命名的表面中、在由操作数 b 给出的坐标处加载数据到目标 d。操作数 a 是一个 .surfref 变量或 .u64 寄存器。对于 1d 表面,操作数 b 是标量或单元素元组;对于 2d 表面,是二元素向量;对于 3d 表面,是四元素向量,其中第四元素被忽略。坐标元素的类型为 .s32。
suld.b 对二进制数据执行非格式化加载。最低维坐标表示到表面内的字节偏移,且不被缩放,并且数据传输的大小与目标操作数 d 的大小相匹配。
suld.b.{a1d,a2d}
表面层选择,随后从所选表面加载。本指令首先使用数组坐标向量 b 第一个元素给出的索引,从由操作数 a 所命名的表面数组中选择一个表面层。随后,本指令从所选表面中、在由操作数 b 其余元素给出的坐标处加载数据到目标 d。操作数 a 是一个 .surfref 变量或 .u64 寄存器。操作数 b 是一个位宽类型向量或元组,其中包含一个指向表面数组的索引,后接所选表面内的坐标,如下所示:
对于 1d 表面数组,操作数 b 的类型为 .v2.b32。第一个元素被解释为指向表面数组的无符号整数索引(.u32),第二个元素被解释为 .s32 类型的 1d 表面坐标。
对于 2d 表面数组,操作数 b 的类型为 .v4.b32。第一个元素被解释为指向表面数组的无符号整数索引(.u32),接下来两个元素被解释为 .s32 类型的 2d 表面坐标。第四个元素被忽略。
假定表面基地址对齐到 16 字节边界,且坐标向量给出的地址必须自然对齐到访问大小的整数倍。若某个地址未正确对齐,则其行为未定义;也就是说,访问可能通过静默地屏蔽低位地址位以实现正确取整而继续进行,或者该指令可能触发错误(fault)。
.clamp 字段指定如何处理越界地址:
.trap-
对越界地址触发执行陷阱(trap)
.clamp-
在最近的表面位置加载数据(大小适当)
.zero-
对越界地址加载零
间接表面访问
自 PTX ISA 3.1 版起,针对 sm_20 或更高目标架构支持间接表面访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .surfref 变量的地址。
示例
suld.b.1d.v4.b32.trap {s1,s2,s3,s4}, [surf_B, {x}];
suld.b.3d.v2.b64.trap {r1,r2}, [surf_A, {x,y,z,w}];
suld.b.a1d.v2.b32 {r0,r1}, [surf_C, {idx,x}];
suld.b.a2d.b32 r0, [surf_D, {idx,x,y,z}]; // z ignored
9.7.13.2. 表面指令:sust#
sust
存储到表面内存。
语法
sust.b.{1d,2d,3d}{.cop}.vec.ctype.clamp [a, b], c; // unformatted
sust.p.{1d,2d,3d}.vec.b32.clamp [a, b], c; // formatted
sust.b.{a1d,a2d}{.cop}.vec.ctype.clamp [a, b], c; // unformatted
.cop = { .wb, .cg, .cs, .wt }; // cache operation
.vec = { none, .v2, .v4 };
.ctype = { .b8 , .b16, .b32, .b64 };
.clamp = { .trap, .clamp, .zero };
说明
sust.{1d,2d,3d}
使用表面坐标向量存储到表面内存。本指令将操作数 c 中的数据存储到由操作数 a 所命名的表面中、由操作数 b 给出的坐标处。操作数 a 是一个 .surfref 变量或 .u64 寄存器。对于 1d 表面,操作数 b 是标量或单元素元组;对于 2d 表面,是二元素向量;对于 3d 表面,是四元素向量,其中第四元素被忽略。坐标元素的类型为 .s32。
sust.b 对二进制数据执行非格式化存储。最低维坐标表示到表面内的字节偏移,且不被缩放。数据传输的大小与源操作数 c 的大小相匹配。
sust.p 将 32 位数据值向量以格式化方式存储到表面采样中。源向量元素按从左到右解释为 R、G、B 与 A 表面分量。这些元素被写入对应的表面采样分量。不出现在表面采样中的源元素被忽略。不出现在源向量中的表面采样分量将被写入不可预测的值。最低维坐标表示采样偏移而非字节偏移。
源数据的解释基于表面采样格式,如下:若表面格式包含 UNORM、SNORM 或 FLOAT 数据,则假定为 .f32;若表面格式包含 UINT 数据,则假定为 .u32;若表面格式包含 SINT 数据,则假定为 .s32。随后源数据从该类型转换为表面采样格式。
sust.b.{a1d,a2d}
表面层选择,随后对所选表面执行非格式化存储。本指令首先使用数组坐标向量 b 第一个元素给出的索引,从由操作数 a 所命名的表面数组中选择一个表面层。随后,本指令将操作数 c 中的数据存储到所选表面中、由操作数 b 其余元素给出的坐标处。操作数 a 是 .surfref 变量或 .u64 寄存器。操作数 b 是一个位宽类型向量或元组,其中包含一个指向表面数组的索引,后接所选表面内的坐标,如下所示:
对于 1d 表面数组,操作数
b的类型为.v2.b32。第一个元素被解释为指向表面数组的无符号整数索引(.u32),第二个元素被解释为.s32类型的 1d 表面坐标。对于 2d 表面数组,操作数
b的类型为.v4.b32。第一个元素被解释为指向表面数组的无符号整数索引(.u32),接下来两个元素被解释为.s32类型的 2d 表面坐标。第四个元素被忽略。
假定表面基地址对齐到 16 字节边界,且坐标向量给出的地址必须自然对齐到访问大小的整数倍。若某个地址未正确对齐,则其行为未定义;也就是说,访问可能通过静默地屏蔽低位地址位以实现正确取整而继续进行,或者该指令可能触发错误(fault)。
.clamp 字段指定如何处理越界地址:
.trap-
对越界地址触发执行陷阱(trap)
.clamp-
在最近的表面位置存储数据(大小适当)
.zero-
丢弃对越界地址的存储
间接表面访问
自 PTX ISA 3.1 版起,针对 sm_20 或更高目标架构支持间接表面访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .surfref 变量的地址。
示例
sust.p.1d.v4.b32.trap [surf_B, {x}], {f1,f2,f3,f4};
sust.b.3d.v2.b64.trap [surf_A, {x,y,z,w}], {r1,r2};
sust.b.a1d.v2.b64 [surf_C, {idx,x}], {r1,r2};
sust.b.a2d.b32 [surf_D, {idx,x,y,z}], r0; // z ignored
9.7.13.3. 表面指令:sured#
sured
归约表面内存。
语法
sured.b.op.geom.ctype.clamp [a,b],c; // byte addressing
sured.p.op.geom.ctype.clamp [a,b],c; // sample addressing
.op = { .add, .min, .max, .and, .or };
.geom = { .1d, .2d, .3d };
.ctype = { .u32, .u64, .s32, .b32, .s64 }; // for sured.b
.ctype = { .b32, .b64 }; // for sured.p
.clamp = { .trap, .clamp, .zero };
说明
使用表面坐标向量对表面内存进行归约。本指令将从操作数 c 取得的数据,与由操作数 a 所命名的表面中、由操作数 b 给出的坐标处执行归约运算。操作数 a 是一个 .surfref 变量或 .u64 寄存器。对于 1d 表面,操作数 b 是标量或单元素元组;对于 2d 表面,是二元素向量;对于 3d 表面,是四元素向量,其中第四元素被忽略。坐标元素的类型为 .s32。
sured.b 对 .u32、.s32、.b32、.u64 或 .s64 数据执行非格式化归约。最低维坐标表示到表面内的字节偏移,且不被缩放。运算 add 适用于 .u32、.u64 与 .s32 类型;min 与 max 适用于 .u32、.s32、.u64 与 .s64 类型;运算 and 与 or 适用于 .b32 类型。
sured.p 对按采样寻址的数据执行非格式化归约。最低维坐标表示采样偏移而非字节偏移,并按 .ctype 给出的数据大小进行缩放。指令类型 .b64 仅限于 min 与 max 运算。对于 .b32 类型,数据基于表面采样格式被解释为 .u32 或 .s32,如下:若表面格式包含 UINT 数据,则假定为 .u32;若表面格式包含 SINT 数据,则假定为 .s32。对于 .b64 类型,若表面格式包含 UINT 数据,则假定为 .u64;若表面格式包含 SINT 数据,则假定为 .s64。
假定表面基地址对齐到 16 字节边界,且坐标向量给出的地址必须自然对齐到访问大小的整数倍。若某个地址未正确对齐,则其行为未定义;也就是说,访问可能通过静默地屏蔽低位地址位以实现正确取整而继续进行,或者该指令可能触发错误(fault)。
.clamp 字段指定如何处理越界地址:
.trap-
对越界地址触发执行陷阱(trap)
.clamp-
在最近的表面位置存储数据(大小适当)
.zero-
丢弃对越界地址的存储
间接表面访问
自 PTX ISA 3.1 版起,针对 sm_20 或更高目标架构支持间接表面访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .surfref 变量的地址。
示例
sured.b.add.2d.u32.trap [surf_A, {x,y}], r1;
sured.p.min.1d.u32.trap [surf_B, {x}], r1;
sured.b.max.1d.u64.trap [surf_C, {x}], r1;
sured.p.min.1d.b64.trap [surf_D, {x}], r1;
9.7.13.4. 表面指令:suq#
suq
查询表面属性。
语法
suq.query.b32 d, [a];
.query = { .width, .height, .depth,
.channel_data_type, .channel_order,
.array_size, .memory_layout };
说明
查询表面的某个属性。操作数 a 是一个 .surfref 变量或一个 .u64 寄存器。
查询 |
返回值 |
|---|---|
|
|
以元素为单位的值 |
|
与源语言的通道数据类型枚举相对应的无符号整数。若源语言将通道数据类型与通道顺序合并为单一的枚举类型,则 |
|
与源语言的通道顺序枚举相对应的无符号整数。若源语言将通道数据类型与通道顺序合并为单一的枚举类型,则 |
|
对于表面数组,为数组中的表面数量;否则为 0。 |
|
具有线性内存布局的表面为 |
间接表面访问
自 PTX ISA 3.1 版起,针对 sm_20 或更高目标架构支持间接表面访问。在间接访问中,操作数 a 是一个 .u64 寄存器,保存某个 .surfref 变量的地址。
示例
suq.width.b32 %r1, [surf_A];
9.7.14. 控制流指令#
以下 PTX 指令与语法用于控制 PTX 程序中的执行:
{}@bracallretexit
9.7.14.1. 控制流指令:{}#
{}
指令分组。
语法
{ instructionList }
说明
花括号创建一组指令,主要用于定义函数体。花括号也提供了一种确定变量作用域的机制:在某一作用域内声明的任何变量,在该作用域之外均不可用。
示例
{ add.s32 a,b,c; mov.s32 d,a; }
9.7.14.2. 控制流指令:@#
@
谓词化执行。
语法
@{!}p instruction;
说明
为那些守卫谓词为 True 的线程执行一条指令或指令块。守卫谓词为 False 的线程什么也不做。
语义
若 {!}p 为真,则执行 instruction
示例
setp.eq.f32 p,y,0; // is y zero?
@!p div.f32 ratio,x,y // avoid division by zero
@q bra L23; // conditional branch
9.7.14.3. 控制流指令:bra#
bra
跳转到目标并在那里继续执行。
语法
@p bra{.uni} tgt; // tgt is a label
bra{.uni} tgt; // unconditional branch
说明
在目标处继续执行。条件分支通过使用守卫谓词来指定。分支目标必须是一个标号。
bra.uni 保证是非发散的,即一个 warp 中当前正在执行该指令的所有活动线程,其守卫谓词与分支目标具有相同的值。
语义
if (p) {
pc = tgt;
}
示例
bra.uni L_exit; // uniform unconditional jump
@q bra L23; // conditional branch
9.7.14.4. 控制流指令:brx.idx#
brx.idx
跳转到从一个可能的分支目标列表中索引出的标号。
语法
@p brx.idx{.uni} index, tlist;
brx.idx{.uni} index, tlist;
说明
索引到一个可能的目标标号列表中,并从所选标号处继续执行。条件分支通过使用守卫谓词来指定。
brx.idx.uni 保证该分支是非发散的,即一个 warp 中当前正在执行该指令的所有活动线程,其守卫谓词与 index 实参具有相同的值。
index 操作数是一个 .u32 寄存器。tlist 操作数必须是一个 .branchtargets 指示符的标号。它以零基序列的方式通过 index 访问。若 index 的值大于或等于 tlist 的长度,则行为未定义。
.branchtargets 指示符必须在使用之前于本地函数作用域内定义。它必须引用当前函数内的标号。
语义
if (p) {
if (index < length(tlist)) {
pc = tlist[index];
} else {
pc = undefined;
}
}
示例
.function foo () {
.reg .u32 %r0;
...
L1:
...
L2:
...
L3:
...
ts: .branchtargets L1, L2, L3;
@p brx.idx %r0, ts;
...
}
9.7.14.5. 控制流指令:call#
call
调用一个函数,记录返回位置。
语法
// direct call to named function, func is a symbol
call{.uni} (ret-param), func, (param-list);
call{.uni} func, (param-list);
call{.uni} func;
// indirect call via pointer, with full list of call targets
call{.uni} (ret-param), fptr, (param-list), flist;
call{.uni} fptr, (param-list), flist;
call{.uni} fptr, flist;
// indirect call via pointer, with no knowledge of call targets
call{.uni} (ret-param), fptr, (param-list), fproto;
call{.uni} fptr, (param-list), fproto;
call{.uni} fptr, fproto;
说明
call 指令存储下一条指令的地址,以便在执行 ret 指令之后可以从该点恢复执行。除非存在 .uni 后缀,否则 call 被假定为是发散的。.uni 后缀表示该 call 保证是非发散的,即一个 warp 中当前正在执行该指令的所有活动线程,其守卫谓词与 call 目标具有相同的值。
对于直接调用,被调用位置 func 必须是一个符号化的函数名;对于间接调用,被调用位置 fptr 必须是保存在寄存器中的某个函数的地址。输入实参与返回值是可选的。实参可以是寄存器、立即常量,或 .param 空间中的变量。实参按值传递。
间接调用需要一个额外的操作数 flist 或 fproto,分别用于传达可能的 call 目标列表,或所有 call 目标的公共函数原型。在第一种情况下,flist 给出可能的 call 目标的完整列表,优化的后端可自由地优化调用约定。在第二种情况下(即可能的 call 目标的完整列表可能未知),给出公共函数原型,且 call 必须遵循 ABI 的调用约定。
flist 操作数要么是一个被初始化为函数名列表的数组(调用表)的名字,要么是一个与 .calltargets 指示符相关联的标号,该指示符声明了一个可能的 call 目标列表。在两种情况下,fptr 寄存器都保存调用表或 .calltargets 列表中所列函数的地址,且 call 操作数会针对 flist 所指函数的类型签名进行类型检查。
fproto 操作数是一个与 .callprototype 指示符相关联的标号的名字。当可能的目标完整列表未知时使用该操作数。call 操作数会针对该原型进行类型检查,且代码生成将遵循 ABI 调用约定。若调用了与原型不匹配的函数,则行为未定义。
调用表可以在模块作用域或局部作用域声明,位于常量或全局状态空间中。.calltargets 与 .callprototype 指示符必须在函数体内声明。所有函数都必须先声明,之后才能在 call 表初始化器或 .calltargets 指示符中被引用。
示例
// examples of direct call
call init; // call function 'init'
call.uni g, (a); // call function 'g' with parameter 'a'
@p call (d), h, (a, b); // return value into register d
// call-via-pointer using jump table
.func (.reg .u32 rv) foo (.reg .u32 a, .reg .u32 b) …
.func (.reg .u32 rv) bar (.reg .u32 a, .reg .u32 b) …
.func (.reg .u32 rv) baz (.reg .u32 a, .reg .u32 b) …
.global .u32 jmptbl[5] = { foo, bar, baz };
…
@p ld.global.u32 %r0, [jmptbl+4];
@p ld.global.u32 %r0, [jmptbl+8];
call (retval), %r0, (x, y), jmptbl;
// call-via-pointer using .calltargets directive
.func (.reg .u32 rv) foo (.reg .u32 a, .reg .u32 b) …
.func (.reg .u32 rv) bar (.reg .u32 a, .reg .u32 b) …
.func (.reg .u32 rv) baz (.reg .u32 a, .reg .u32 b) …
…
@p mov.u32 %r0, foo;
@q mov.u32 %r0, baz;
Ftgt: .calltargets foo, bar, baz;
call (retval), %r0, (x, y), Ftgt;
// call-via-pointer using .callprototype directive
.func dispatch (.reg .u32 fptr, .reg .u32 idx)
{
…
Fproto: .callprototype _ (.param .u32 _, .param .u32 _);
call %fptr, (x, y), Fproto;
…
9.7.14.6. 控制流指令:ret#
ret
从函数返回到 call 之后的指令。
语法
ret{.uni};
说明
将执行返回到调用者的环境。发散的返回会挂起线程,直到所有线程都准备好返回给调用者。这允许多个发散的 ret 指令。
除非存在 .uni 后缀,否则 ret 被假定为是发散的;该后缀表示返回保证是非发散的。
从函数返回的任何值都应在执行 ret 指令之前移动到返回参数变量中。
在顶层入口例程中执行的返回指令将终止线程执行。
示例
ret;
@p ret;
9.7.14.7. 控制流指令:exit#
exit
终止一个线程。
语法
exit;
说明
结束线程的执行。
仅等待已退出线程到达的栅栏总是会被释放。
示例
exit;
@p exit;
9.7.15. 并行同步与通信指令#
这些指令包括:
bar{.cta},barrier{.cta}bar.warp.syncbarrier.clustermembaratomredred.asyncmultimem.red.asyncvotematch.syncactivemaskredux.syncgriddepcontrolelect.syncmbarrier.initmbarrier.invalmbarrier.arrivembarrier.arrive_dropmbarrier.test_waitmbarrier.try_waitmbarrier.pending_countmbarrier.check_layoutcp.async.mbarrier.arrivetensormap.cp_fenceproxyclusterlaunchcontrol.try_cancelclusterlaunchcontrol.query_cancel
9.7.15.1. 并行同步与通信指令:bar , barrier#
bar, bar.cta, barrier, barrier.cta
栅栏同步。
语法
barrier{.cta}.sync{.aligned} a{, b};
barrier{.cta}.arrive{.aligned} a, b;
barrier{.cta}.red.popc{.aligned}.u32 d, a{, b}, {!}c;
barrier{.cta}.red.op{.aligned}.pred p, a{, b}, {!}c;
bar{.cta}.sync a{, b};
bar{.cta}.arrive a, b;
bar{.cta}.red.popc.u32 d, a{, b}, {!}c;
bar{.cta}.red.op.pred p, a{, b}, {!}c;
.op = { .and, .or };
说明
在 CTA 内执行栅栏同步与通信。每个 CTA 实例有十六个栅栏,编号为 0..15。
CTA 内的线程可以使用 barrier{.cta} 指令进行同步与通信。
操作数 a、b 和 d 的类型为 .u32;操作数 p 和 c 是谓词。源操作数 a 以立即数常量或寄存器的形式指定逻辑栅栏资源,取值为 0 到 15。操作数 b 指定参与该栅栏的线程数。如果未指定线程数,则 CTA 中的所有线程都参与该栅栏。指定线程数时,该值必须是 warp 大小的倍数。注意,barrier{.cta}.arrive 要求线程数非零。
根据操作数 b,参与 barrier{.cta} 指令的要么是指定数量的线程(warp 大小的倍数),要么是 CTA 中的所有线程。barrier{.cta} 指令会发出执行线程已到达指定栅栏的信号。
barrier{.cta} 指令使执行线程等待其所在 warp 中所有未退出的线程,并标记 warp 已到达栅栏。除了发出自身到达栅栏的信号外,barrier{.cta}.red 和 barrier{.cta}.sync 指令还会使执行线程等待参与该栅栏的所有其他 warp 中未退出的线程到达。barrier{.cta}.arrive 不会使执行线程等待其他参与 warp 的线程。
当栅栏完成时,等待的线程会被立即重新启动,并且该栅栏会被重新初始化,以便可以立即复用。
barrier{.cta}.sync 或 barrier{.cta}.red 或 barrier{.cta}.arrive 指令保证:当栅栏完成时,此线程此前请求的内存访问相对于参与该栅栏的所有线程都已执行。barrier{.cta}.sync 和 barrier{.cta}.red 指令还进一步保证:在栅栏完成之前,此线程不会再请求新的内存访问。
当读取的值已从内存传出,并且不能被参与该栅栏的另一个线程修改时,就认为一次内存读(例如由 ld 或 atom 执行)已经完成。当写入的值对参与该栅栏的其他线程已可见,即先前的值不再能被读取时,就认为一次内存写(例如由 st、red 或 atom 执行)已经完成。
barrier{.cta}.red 跨线程执行归约操作。CTA 中所有线程的 c 谓词(或其补)使用指定的归约运算符进行合并。一旦达到栅栏计数,最终值会被写入在栅栏处等待的所有线程的目标寄存器。
barrier{.cta}.red 的归约操作为种群计数(.popc)、所有线程为 True(.and)以及任意线程为 True(.or)。.popc 的结果是谓词为 True 的线程数,而 .and 和 .or 分别表示是否所有线程的谓词都为 True,或者是否有任意线程的谓词为 True。
指令 barrier{.cta} 具有可选的 .aligned 修饰符。指定该修饰符时,表示 CTA 中的所有线程都将执行同一条 barrier{.cta} 指令。在条件执行的代码中,仅当确知 CTA 中所有线程对条件的求值结果相同时,才应使用 aligned 的 barrier{.cta} 指令,否则行为未定义。
不同的 warp 可以使用相同的栅栏名称和线程数执行 barrier{.cta} 指令的不同形式。一个例子是混合使用 barrier{.cta}.sync 和 barrier{.cta}.arrive 来实现生产者/消费者模型。生产者线程执行 barrier{.cta}.arrive 来宣告其到达栅栏,并立即继续执行以生成下一个值,而消费者线程执行 barrier{.cta}.sync 以等待资源被生成。随后使用另一个栅栏将角色互换:生产者线程执行 barrier{.cta}.sync 以等待资源被消费,而消费者线程用 barrier{.cta}.arrive 宣告资源已被消费。必须注意,在栅栏被重置之前,不要让某个 warp 执行比预期更多的 barrier{.cta} 指令(barrier{.cta}.arrive 之后又对同一栅栏执行任何其他 barrier{.cta} 指令)。不应将 barrier{.cta}.red 与使用同一活动栅栏的 barrier{.cta}.sync 或 barrier{.cta}.arrive 混用。在这种情况下,执行结果是不可预测的。
可选的 .cta 限定符仅表示该栅栏适用于 CTA 级别,并不会改变指令的语义。
bar{.cta}.sync 等价于 barrier{.cta}.sync.aligned。bar{.cta}.arrive 等价于 barrier{.cta}.arrive.aligned。bar{.cta}.red 等价于 barrier{.cta}.red.aligned。
注释
对于 .target sm_6x 或更低版本,
不带
.aligned修饰符的barrier{.cta}指令等价于.aligned变体,并且具有与.aligned变体相同的限制。warp 中的所有线程(已退出的除外)必须在汇聚状态下执行
barrier{.cta}指令。
示例
// Use bar.sync to arrive at a pre-computed barrier number and
// wait for all threads in CTA to also arrive:
st.shared [r0],r1; // write my result to shared memory
bar.cta.sync 1; // arrive, wait for others to arrive
ld.shared r2,[r3]; // use shared results from other threads
// Use bar.sync to arrive at a pre-computed barrier number and
// wait for fixed number of cooperating threads to arrive:
#define CNT1 (8*12) // Number of cooperating threads
st.shared [r0],r1; // write my result to shared memory
bar.cta.sync 1, CNT1; // arrive, wait for others to arrive
ld.shared r2,[r3]; // use shared results from other threads
plaintext
// Use bar.red.and to compare results across the entire CTA:
setp.eq.u32 p,r1,r2; // p is True if r1==r2
bar.cta.red.and.pred r3,1,p; // r3=AND(p) forall threads in CTA
// Use bar.red.popc to compute the size of a group of threads
// that have a specific condition True:
setp.eq.u32 p,r1,r2; // p is True if r1==r2
bar.cta.red.popc.u32 r3,1,p; // r3=SUM(p) forall threads in CTA
// Examples of barrier.cta.sync
st.shared [r0],r1;
barrier.cta.sync 0;
ld.shared r1, [r0];
/* Producer/consumer model. The producer deposits a value in
-
shared memory, signals that it is complete but does not wait
-
using bar.arrive, and begins fetching more data from memory.
-
Once the data returns from memory, the producer must wait
-
until the consumer signals that it has read the value from
-
the shared memory location. In the meantime, a consumer
-
thread waits until the data is stored by the producer, reads
-
it, and then signals that it is done (without waiting). */ // Producer code places produced value in shared memory. st.shared [r0],r1; bar.arrive 0,64; ld.global r1,[r2]; bar.sync 1,64; …
// Consumer code, reads value from shared memory bar.sync 0,64; ld.shared r1,[r0]; bar.arrive 1,64; …
9.7.15.2. 并行同步与通信指令:bar.warp.sync#
bar.warp.sync
warp 中线程的栅栏同步。
语法
bar.warp.sync membermask;
说明
bar.warp.sync 会使执行线程等待,直到 membermask 对应的所有线程都以相同的 membermask 值执行了 bar.warp.sync,之后才恢复执行。
操作数 membermask 指定一个 32 位整数,它是一个掩码,用于指示参与栅栏的线程,其中位位置对应于线程的 laneid。
如果执行线程不在 membermask 中,则 bar.warp.sync 的行为未定义。
bar.warp.sync 还保证参与栅栏的线程之间的内存顺序。因此,warp 中希望通过内存进行通信的线程可以先存储到内存,执行 bar.warp.sync,然后安全地读取 warp 中其他线程存储的值。
注释
对于 .target sm_6x 或更低版本,membermask 中的所有线程必须在汇聚状态下执行同一条 bar.warp.sync 指令,并且在执行 bar.warp.sync 指令时,只有属于某个 membermask 的线程可以是活动的。否则,行为未定义。
示例
st.shared.u32 [r0],r1; // write my result to shared memory
bar.warp.sync 0xffffffff; // arrive, wait for others to arrive
ld.shared.u32 r2,[r3]; // read results written by other threads
9.7.15.3. 并行同步与通信指令:barrier.cluster#
barrier.cluster
cluster 内的栅栏同步。
语法
barrier.cluster.arrive{.sem}{.aligned};
barrier.cluster.wait{.acquire}{.aligned};
.sem = {.release, .relaxed}
说明
在 cluster 内执行栅栏同步与通信。
barrier.cluster 指令可供 cluster 内的线程用于同步与通信。
barrier.cluster.arrive 指令标记 warp 到达栅栏,但不会使执行线程等待其他参与 warp 的线程。
barrier.cluster.wait 指令使执行线程等待 cluster 中所有未退出的线程执行 barrier.cluster.arrive。
此外,barrier.cluster 指令还会使执行线程等待其所在 warp 中所有未退出的线程。
当 cluster 中所有未退出的线程都执行了 barrier.cluster.arrive 后,该栅栏完成并自动重新初始化。在使用 barrier.cluster.wait 检测到栅栏完成后,线程可以立即再次到达该栅栏。每个线程在该栅栏完成之前只能到达该栅栏一次。
barrier.cluster.wait 指令保证:当它完成执行时,cluster 中所有线程按程序顺序在之前的 barrier.cluster.arrive 之前所请求的内存访问(异步操作除外)均已完成,并且对执行线程可见。
对于执行线程按程序顺序在 barrier.cluster.arrive 之后、barrier.cluster.wait 之前所请求的内存访问,不提供内存定序与可见性保证。
barrier.cluster.arrive 上可选的 .relaxed 限定符指定:对于在 barrier.cluster.arrive 之前执行的内存访问,不提供内存定序与可见性保证。
指令 barrier.cluster.arrive 和 barrier.cluster.wait 上可选的 .sem 和 .acquire 限定符指定如 内存一致性模型 中所述的内存同步。如果 barrier.cluster.arrive 缺少可选的 .sem 限定符,则默认假定为 .release。如果 barrier.cluster.wait 缺少可选的 .acquire 限定符,则默认假定为 .acquire。
可选的 .aligned 限定符表示 warp 中所有线程必须执行相同的 barrier.cluster 指令。在条件执行的代码中,只有当已知 warp 中所有线程对条件的求值结果相同时,才应使用 aligned 的 barrier.cluster 指令,否则行为未定义。
示例
// use of arrive followed by wait
ld.shared::cluster.u32 r0, [addr];
barrier.cluster.arrive.aligned;
...
barrier.cluster.wait.aligned;
st.shared::cluster.u32 [addr], r1;
// use memory fence prior to arrive for relaxed barrier
@cta0 ld.shared::cluster.u32 r0, [addr];
fence.cluster.acq_rel;
barrier.cluster.arrive.relaxed.aligned;
…
barrier.cluster.wait.aligned;
@cta1 st.shared::cluster.u32 [addr], r1;
9.7.15.4. 并行同步与通信指令:membar / fence#
membar, fence
强制规定内存操作的顺序。
语法
// Thread fence:
fence{.sem}.scope;
// Thread fence:
fence.acquire.sync_restrict::shared::cluster.cluster;
fence.release.sync_restrict::shared::cta.cluster;
// Operation fence:
fence.op_restrict.release.cluster;
// Proxy fence (bi-directional):
fence.proxy.proxykind;
fence.proxy.proxykind{.sem}.scope;
// Proxy fence (uni-directional):
fence.proxy.to_proxykind::from_proxykind.release.scope;
fence.proxy.to_proxykind::from_proxykind.acquire.scope [addr], size;
fence.proxy.async::generic.acquire.sync_restrict::shared::cluster.cluster;
fence.proxy.async::generic.release.sync_restrict::shared::cta.cluster;
fence.proxy.async::generic.release.sync_restrict::shared::cluster::read.cluster;
fence.proxy.to_proxykind::from_proxykind_fabric.alias.sem_fabric.sys;
// Old style membar:
membar.level;
membar.proxy.proxykind;
.sem = { .sc, .acq_rel, .acquire, .release };
.scope = { .cta, .cluster, .gpu, .sys };
.level = { .cta, .gl, .sys };
.proxykind = { .alias, .async, .async.global, .async.shared::{cta, cluster} };
.sem_alias = { .acquire, .release };
.scope_alias = { .sys };
.op_restrict = { .mbarrier_init };
.to_proxykind::from_proxykind = {.tensormap::generic};
.to_proxykind::from_proxykind_fabric = {.generic::fabric, .fabric::generic, .fabric::fabric };
.sem_fabric = { .acquire, .release };
说明
membar 指令保证:本线程此前请求的内存访问(ld、st、atom 和 red 指令)在指定的 level 上已经完成,之后本线程才执行 membar 指令之后请求的内存操作。level 限定符指定可以观察到此操作定序效果的一组线程。
当读取到的值已从内存传出、并且在指定级别上不能再被其他线程修改时,该内存读取(例如由 ld 或 atom 执行)即视为已完成。当写入的值在指定级别上已对其他线程可见,即先前的值不再能被读取时,该内存写入(例如由 st、red 或 atom 执行)即视为已完成。
fence 指令在本线程请求的内存访问(ld、st、atom 和 red 指令)之间建立定序,如 内存一致性模型 所述。scope 限定符指定可以观察到此操作定序效果的一组线程。
fence.acq_rel 是一种轻量级栅栏,足以满足大多数程序中的内存同步需求。fence.acq_rel 的实例在与附加内存操作结合时会进行同步,如 内存一致性模型 中 acquire 和 release 模式所述。如果缺少可选的 .sem 限定符,则默认假定为 .acq_rel。
fence.sc 是一种较慢的栅栏,在足够多的位置使用时可以恢复顺序一致性,但代价是性能。具有足够作用域的 fence.sc 实例总是通过在运行时确定的每个作用域上形成全序来进行同步。该全序还可以被程序中的其他同步进一步约束。
限定符 .op_restrict 和 .sync_restrict 限制 fence 指令为其提供内存定序保证的内存操作类别。当 .op_restrict 为 .mbarrier_init 时,该栅栏的同步效果仅适用于同一线程此前在 .shared::cta 状态空间中的 mbarrier 对象上执行的 mbarrier.init 操作。当 .sync_restrict 为 .sync_restrict::shared::cta 时,.sem 必须为 .release,且该栅栏的效果仅适用于对 .shared::cta 状态空间中对象执行的操作。类似地,当 .sync_restrict 为 .sync_restrict::shared::cluster 时,.sem 必须为 .acquire,且该栅栏的效果仅适用于对 .shared::cluster 状态空间中对象执行的操作。当存在 .sync_restrict::shared::cta 或 .sync_restrict::shared::cluster 时,.scope 必须指定为 .cluster。
当 .sync_restrict 为 .sync_restrict::shared::cluster::read 时,.sem 必须为 .release,且该栅栏的效果仅适用于对 .shared::cluster 状态空间中对象执行的读操作。当存在此同步限制时,.scope 必须指定为 .cluster。
注意
fence.proxy.async::generic.release.sync_restrict::shared::cluster::read.cluster 是一种非累积的栅栏操作:它不会相对于因果序传递性地建立定序。
地址操作数 addr 与操作数 size 共同指定内存范围 [addr, addr+size-1],即需要为其提供跨代理内存访问定序保证的范围。size 操作数唯一受支持的值为 128,且必须是常量整数字面量。此处无条件使用 通用寻址,并且操作数 addr 指定的地址必须落在 .global 状态空间内,否则行为未定义。
在 sm_70 及更高架构上,membar 是 fence.sc 的同义词1,并且 membar 级别 cta、gl 和 sys 分别与 fence 作用域 cta、gpu 和 sys 同义。
membar.proxy 和 fence.proxy 指令在不同代理之间可能发生的内存访问之间建立定序。
从 from-proxykind 到 to-proxykind 的单向代理定序,建立此前通过 from-proxykind 执行的内存访问与随后通过 to-proxykind 执行的内存访问之间的定序。
两种 proxykind 之间的双向代理定序建立两个单向代理定序:一个从第一个 proxykind 到第二个 proxykind,另一个从第二个 proxykind 到第一个 proxykind。
.proxykind 限定符指示在通用代理与 .proxykind 所指定的代理之间所进行的内存访问之间建立的双向代理定序。
双向代理栅栏不会像具有 .release 或 .acquire 语义的栅栏那样直接与其他栅栏同步。相反,双向代理栅栏在单个线程内生效,因此没有 .scope 限定符。其跨代理同步效果按照 内存一致性模型 的规则与其他形式的同步组合。
.proxykind 限定符的取值 .alias 指使用指向同一内存位置的虚拟别名地址所执行的内存访问。.proxykind 限定符的取值 .async 指定在异步代理与通用代理之间建立内存定序。该内存定序仅限于在所指定状态空间中的对象上执行的操作。如果未指定状态空间,则该内存定序适用于所有状态空间。
.release 代理栅栏可以形成释放序列,与包含 .acquire 代理栅栏的获取序列同步。.to_proxykind 和 .from_proxykind 限定符指示所建立的单向代理定序。
在 sm_70 及更高架构上,membar.proxy 是 fence.proxy 的同义词。
1 随 sm_70 引入的 fence.sc 语义是 membar 语义的超集,二者兼容;在 sm_70 或更高架构上执行时,membar 获得 fence.sc 的完整语义。
示例
membar.gl;
membar.cta;
membar.sys;
fence.sc.cta;
fence.sc.cluster;
fence.proxy.alias;
membar.proxy.alias;
fence.mbarrier_init.release.cluster;
fence.proxy.async;
fence.proxy.async.shared::cta;
fence.proxy.async.shared::cluster;
fence.proxy.async.global;
tensormap.replace.tile.global_address.global.b1024.b64 [gbl], new_addr;
fence.proxy.tensormap::generic.release.gpu;
cvta.global.u64 tmap, gbl;
fence.proxy.tensormap::generic.acquire.gpu [tmap], 128;
cp.async.bulk.tensor.1d.shared::cluster.global.tile [addr0], [tmap, {tc0}], [mbar0];
// Acquire remote barrier state via async proxy.
barrier.cluster.wait.acquire;
fence.proxy.async::generic.acquire.sync_restrict::shared::cluster.cluster;
// Release local barrier state via generic proxy.
mbarrier.init [bar];
fence.mbarrier_init.release.cluster;
barrier.cluster.arrive.relaxed;
// Acquire local shared memory via generic proxy.
mbarrier.try_wait.relaxed.cluster.shared::cta.b64 complete, [addr], parity;
fence.acquire.sync_restrict::shared::cluster.cluster;
// Release local shared memory via generic proxy.
fence.release.sync_restrict::shared::cta.cluster;
mbarrier.arrive.relaxed.cluster.shared::cluster.b64 state, [bar];
fence.proxy.generic::fabric.alias.release.sys;
fence.proxy.fabric::generic.alias.acquire.sys;
// Release in producer via alias proxy.
st.weak.u32 [addr], value;
fence.proxy.alias.release.sys;
st.relaxed.sys [bar], 1;
// Acquire in consumer via alias proxy.
// when (ld.relaxed.sys [bar] == count):
fence.proxy.alias.acquire.sys;
// Release local shared memory via generic proxy (reads only).
fence.proxy.async::generic.release.sync_restrict::shared::cluster::read.cluster;
9.7.15.5. 并行同步与通信指令:atom#
atom
用于线程间通信的原子归约操作。
语法
标量类型的原子操作:
atom{.sem}{.scope}{.space}.op{.level::cache_hint}.type d, [a], b{, cache_policy};
atom{.sem}{.scope}{.space}.cas.type1 d, [a], b, c;
atom{.sem}{.scope}{.space}.exch{.level::cache_hint}.type2 d, [a], b {, cache_policy};
atom{.sem}{.scope}{.space}.add.noftz{.level::cache_hint}.type3 d, [a], b{, cache_policy};
.space = { .global, .shared{::cta, ::cluster} };
.sem = { .relaxed, .acquire, .release, .acq_rel };
.scope = { .cta, .cluster, .gpu, .sys };
.op = { .and, .or, .xor,
.add, .inc, .dec,
.min, .max };
.level::cache_hint = { .L2::cache_hint };
.type = { .b32, .b64, .u32, .u64, .s32, .s64, .f32, .f64 };
.type1 = { .b16, .b32, .b64, .b128 };
.type2 = { .b32, .b64, .b128 };
.type3 = { .f16, .f16x2, .bf16, .bf16x2, .f32 };
向量类型的原子操作:
atom{.sem}{.scope}{.global}.add{.noftz}{.level::cache_hint}.vec_32_bit.f32 d, [a], b{, cache_policy};
atom{.sem}{.scope}{.global}.op.noftz{.level::cache_hint}.vec_16_bit.half_word_type d, [a], b{, cache_policy};
atom{.sem}{.scope}{.global}.op.noftz{.level::cache_hint}.vec_32_bit.packed_type d, [a], b{, cache_policy};
.sem = { .relaxed, .acquire, .release, .acq_rel };
.scope = { .cta, .cluster, .gpu, .sys };
.op = { .add, .min, .max };
.half_word_type = { .f16, .bf16 };
.packed_type = { .f16x2, .bf16x2 };
.vec_16_bit = { .v2, .v4, .v8 }
.vec_32_bit = { .v2, .v4 };
.level::cache_hint = { .L2::cache_hint }
说明
以原子方式将位置 a 处的原始值加载到目标寄存器 d,用操作数 b 与位置 a 处的值执行归约操作,并把指定操作的结果存储到位置 a,覆盖原始值。对于 .cas(compare-and-swap,比较并交换)操作,操作数 b 是比较值,操作数 c 是交换值。该操作将位置 a 处的值与操作数 b 比较;若二者相等,则将操作数 c 存储到位置 a,否则保持位置 a 处的值不变。操作数 a 指定所给状态空间中的一个位置。若未给出状态空间,则使用 通用寻址 执行内存访问。标量类型的 atom 只能与 .global 和 .shared 空间以及通用寻址一起使用,此时地址指向 .global 或 .shared 空间。向量类型的 atom 只能与 .global 空间以及地址指向 .global 空间的通用寻址一起使用。
对于向量类型的 atom,操作数 d 和 b 是用花括号括起的向量表达式,其大小等于向量限定符的大小。
若未为 .shared 状态空间指定子限定符,则默认假定为 ::cta。
可选的 .sem 限定符指定一种内存同步效果,如 内存一致性模型 中所述。若 .sem 限定符缺省,则默认假定为 .relaxed。
可选的 .scope 限定符指定能够直接观察到本操作内存同步效果的线程集合,如 内存一致性模型 中所述。若 .scope 限定符缺省,则默认假定为 .gpu 作用域。
表 41列出了标量 atom 指令的类型与原子操作的有效组合。
类型 |
整数操作 |
浮点操作 |
位操作 |
|---|---|---|---|
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
对于向量类型的 atom,向量限定符与类型的受支持组合,以及这些组合上支持的原子操作,如下表所示:
向量限定符 |
类型 |
||
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
不支持 |
不支持 |
两个原子操作(atom 或 red)只有在各自指定的作用域包含对方时,才会相对彼此原子地执行。当不满足该条件时,每个操作观察到对方操作被执行的方式,就如同对方被拆分为一次读取后跟一次依赖写入。
作用于打包类型或向量类型的 atom 指令访问内存中相邻的标量元素。在此类情况下,原子性是对各个标量元素分别保证的;整个 atom 并不保证作为单次访问而具有原子性。
对于 sm_6x 及更早架构,作用于 .shared 状态空间的 atom 操作不保证相对于对同一地址的普通存储指令的原子性。使用共享内存原子指令的程序,其正确性由程序员负责保证,例如:在针对同一公共地址的普通存储与原子操作之间插入 barrier,或使用 atom.exch 向被其他原子操作访问的位置进行存储。
操作数 a 支持的寻址模式及对齐要求见 作为操作数的地址
操作说明:
-
整数操作:
.add、.inc、.dec、.min、.max.inc和.dec操作返回范围[0..b]内的结果。.inc和.dec仅支持.u32类型。
-
浮点操作:
.add、.min、.max.add操作采用就近偶数舍入。.min和.max操作实现与非原子min和max指令完全相同的浮点指令,但以原子方式执行它们。不带
.noftz的atom.add.f32操作在全局内存上会把次正规输入和结果冲洗为保留符号的零,但在共享内存上支持次正规输入和结果且不将它们冲洗为零。atom.add.f16、atom.add.f16x2、atom.add.bf16和atom.add.bf16x2操作要求.noftz限定符;它会保留次正规输入和结果,且不将它们冲洗为零。atom.add.f16、atom.add.f16x2、atom.add.bf16和atom.add.bf16x2操作要求.noftz限定符;它会保留次正规输入和结果,且不将它们冲洗为零。
-
位操作:
.and、.or、.xor、.cas(compare-and-swap,比较并交换)和.exch(exchange,交换).cas操作接受三个操作数:d(目标)、[a](内存地址)、b(比较值)和c(交换值)。它以原子方式将位置a处的值与操作数b比较;若二者相等,则将操作数c存储到位置a,并在d中返回原始值。若二者不相等,则保持位置a处的值不变,并在d中返回原始值。
当指定可选参数 cache_policy 时,限定符 .level::cache_hint 是必需的。64 位操作数 cache_policy 指定内存访问期间可能使用的缓存逐出策略。
限定符 .level::cache_hint 仅支持 .global 状态空间,以及地址指向 .global 状态空间的通用寻址。
cache_policy 是对缓存子系统的提示,可能并不总被遵循。它仅被视为性能提示,不会改变程序的内存一致性行为。
语义
atomic {
d = *a;
*a = (operation == cas) ? operation(*a, b, c)
: operation(*a, b);
}
where
inc(r, s) = (r >= s) ? 0 : r+1;
dec(r, s) = (r==0 || r > s) ? s : r-1;
exch(r, s) = s;
cas(r,s,t) = (r == s) ? t : r;
示例
atom.global.add.s32 d,[a],1;
atom.shared::cta.max.u32 d,[x+4],0;
@p atom.global.cas.b32 d,[p],my_val,my_new_val;
atom.global.sys.add.u32 d, [a], 1;
atom.global.acquire.sys.inc.u32 ans, [gbl], %r0;
atom.add.noftz.f16x2 d, [a], b;
atom.add.noftz.f16 hd, [ha], hb;
atom.global.cas.b16 hd, [ha], hb, hc;
atom.add.noftz.bf16 hd, [a], hb;
atom.add.noftz.bf16x2 bd, [b], bb;
atom.add.shared::cluster.noftz.f16 hd, [ha], hb;
atom.shared.b128.cas d, a, b, c; // 128-bit atom
atom.global.b128.exch d, a, b; // 128-bit atom
atom.global.cluster.relaxed.add.u32 d, [a], 1;
createpolicy.fractional.L2::evict_last.b64 cache_policy, 0.25;
atom.global.add.L2::cache_hint.s32 d, [a], 1, cache_policy;
atom.global.v8.f16.max.noftz {%hd0, %hd1, %hd2, %hd3, %hd4, %hd5, %hd6, %hd7}, [gbl],
{%h0, %h1, %h2, %h3, %h4, %h5, %h6, %h7};
atom.global.v8.bf16.add.noftz {%hd0, %hd1, %hd2, %hd3, %hd4, %hd5, %hd6, %hd7}, [gbl],
{%h0, %h1, %h2, %h3, %h4, %h5, %h6, %h7};
atom.global.v2.f16.add.noftz {%hd0, %hd1}, [gbl], {%h0, %h1};
atom.global.v2.bf16.add.noftz {%hd0, %hd1}, [gbl], {%h0, %h1};
atom.global.v4.b16x2.min.noftz {%hd0, %hd1, %hd2, %hd3}, [gbl], {%h0, %h1, %h2, %h3};
atom.global.v4.f32.add {%f0, %f1, %f2, %f3}, [gbl], {%f0, %f1, %f2, %f3};
atom.global.v2.f16x2.min.noftz {%bd0, %bd1}, [g], {%b0, %b1};
atom.global.v2.bf16x2.max.noftz {%bd0, %bd1}, [g], {%b0, %b1};
atom.global.v2.f32.add {%f0, %f1}, [g], {%f0, %f1};
atom.global.add.noftz.f32 %f0, [g], %f0;
9.7.15.6. 并行同步与通信指令:red#
red
全局内存与共享内存上的归约操作。
语法
标量类型的归约操作:
red{.sem}{.scope}{.space}.op{.level::cache_hint}.type [a], b{, cache_policy};
red{.sem}{.scope}{.space}.add.noftz{.level::cache_hint}.type1 [a], b{, cache_policy};
.space = { .global, .shared{::cta, ::cluster} };
.sem = { .relaxed, .release };
.scope = { .cta, .cluster, .gpu, .sys };
.op = { .and, .or, .xor,
.add, .inc, .dec,
.min, .max };
.level::cache_hint = { .L2::cache_hint };
.type = { .b32, .b64, .u32, .u64, .s32, .s64, .f32, .f64 };
.type1 = { .f16, .f16x2, .bf16, .bf16x2, .f32 };
向量类型的归约操作:
red{.sem}{.scope}{.global}.add{.noftz}{.level::cache_hint}.vec_32_bit.f32 [a], b{, cache_policy};
red{.sem}{.scope}{.global}.op.noftz{.level::cache_hint}. vec_16_bit.half_word_type [a], b{, cache_policy};
red{.sem}{.scope}{.global}.op.noftz{.level::cache_hint}.vec_32_bit.packed_type [a], b {, cache_policy};
.sem = { .relaxed, .release };
.scope = { .cta, .cluster, .gpu, .sys };
.op = { .add, .min, .max };
.half_word_type = { .f16, .bf16 };
.packed_type = { .f16x2,.bf16x2 };
.vec_16_bit = { .v2, .v4, .v8 }
.vec_32_bit = { .v2, .v4 };
.level::cache_hint = { .L2::cache_hint }
说明
使用操作数 b 与位置 a 处的值执行归约操作,并将指定运算的结果存储到位置 a,覆盖原值。操作数 a 指定指定的状态空间中的一个位置。如果未给出状态空间,则使用 通用寻址 执行内存访问。标量类型的 red 只能与 .global 和 .shared 空间以及通用寻址一起使用,此时地址指向 .global 或 .shared 空间。向量类型的 red 只能与 .global 空间以及通用寻址一起使用,此时地址指向 .global 空间。
对于向量类型的 red,操作数 b 是用花括号括起的向量表达式,其大小等于向量限定符的大小。
如果 .shared 状态空间未指定子限定符,则默认假定为 ::cta。
可选的 .sem 限定符指定一种内存同步效果,如 内存一致性模型 中所述。如果缺少 .sem 限定符,则默认假定为 .relaxed。
可选的 .scope 限定符指定可以直接观察到该操作的内存同步效果的线程集合,如 内存一致性模型 中所述。如果缺少 .scope 限定符,则默认假定为 .gpu 作用域。
表 42 展示了标量 red 指令的类型与归约运算的有效组合。
类型 |
整数运算 |
浮点运算 |
位运算 |
|---|---|---|---|
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
|
不支持 |
不支持 |
|
|
不支持 |
不支持 |
|
对于向量类型的 red,向量限定符、类型以及这些组合所支持的归约运算的受支持组合见下表:
向量限定符 |
类型 |
||
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
不支持 |
不支持 |
两个原子操作(atom 或 red)只有在各自指定的作用域都包含对方时,才会相对于彼此以原子方式执行。当不满足该条件时,每个操作观察到另一个操作的执行方式,就仿佛它被拆分为一次读后跟一次依赖写。
对打包类型或向量类型的 red 指令会访问内存中相邻的标量元素。在这种情况下,原子性分别针对每个单独的标量元素得到保证;整个 red 不保证作为单次访问而具有原子性。
对于 sm_6x 及更早的架构,对 .shared 状态空间的 red 操作不保证相对于对同一地址的普通存储指令的原子性。程序员有责任保证使用共享内存归约指令的程序的正确性,例如:在指向同一地址的普通存储与归约操作之间插入屏障,或使用 atom.exch 向其他归约操作所访问的位置执行存储。
操作数 a 的受支持寻址模式以及对齐要求见 作为操作数的地址
运算说明:
-
整数运算:
.add、.inc、.dec、.min、.max.inc和.dec运算返回范围[0..b]内的结果。.inc和.dec仅对.u32类型受支持。
-
浮点运算:
.add、.min、.max.add运算采用就近偶数舍入。.min和.max运算实现的浮点指令与非原子的min和max指令完全相同,但以原子方式执行它们。不带
.noftz的red.add.f32运算在全局内存上会将次正规输入和结果冲洗为保留符号的零,但在共享内存上支持次正规输入和结果,不会将其冲洗为零。red.add.f16、red.add.f16x2、red.add.bf16和red.add.bf16x2运算要求.noftz限定符;它会保留次正规输入和结果,不会将其冲洗为零。red.add.f16、red.add.f16x2、red.add.bf16和red.add.bf16x2运算要求.noftz限定符;它会保留次正规输入和结果,不会将其冲洗为零。
位运算:
.and、.or、.xor
当指定可选参数 cache_policy 时,限定符 .level::cache_hint 是必需的。64 位操作数 cache_policy 指定内存访问期间可能使用的缓存逐出策略。
.level::cache_hint 限定符仅对 .global 状态空间以及地址指向 .global 状态空间的通用寻址受支持。
cache_policy 是对缓存子系统的提示,未必总是被采纳。它仅被视为性能提示,不会改变程序的内存一致性行为。
语义
*a = operation(*a, b);
where
inc(r, s) = (r >= s) ? 0 : r+1;
dec(r, s) = (r==0 || r > s) ? s : r-1;
示例
red.global.add.s32 [a],1;
red.shared::cluster.max.u32 [x+4],0;
@p red.global.and.b32 [p],my_val;
red.global.sys.add.u32 [a], 1;
red.global.acquire.sys.add.u32 [gbl], 1;
red.add.noftz.f16x2 [a], b;
red.add.noftz.bf16 [a], hb;
red.add.noftz.bf16x2 [b], bb;
red.global.cluster.relaxed.add.u32 [a], 1;
red.shared::cta.min.u32 [x+4],0;
createpolicy.fractional.L2::evict_last.b64 cache_policy, 0.25;
red.global.and.L2::cache_hint.b32 [a], 1, cache_policy;
red.global.v8.f16.add.noftz [gbl], {%h0, %h1, %h2, %h3, %h4, %h5, %h6, %h7};
red.global.v8.bf16.min.noftz [gbl], {%h0, %h1, %h2, %h3, %h4, %h5, %h6, %h7};
red.global.v2.f16.add.noftz [gbl], {%h0, %h1};
red.global.v2.bf16.add.noftz [gbl], {%h0, %h1};
red.global.v4.f16x2.max.noftz [gbl], {%h0, %h1, %h2, %h3};
red.global.v4.f32.add [gbl], {%f0, %f1, %f2, %f3};
red.global.v2.f16x2.max.noftz {%bd0, %bd1}, [g], {%b0, %b1};
red.global.v2.bf16x2.add.noftz {%bd0, %bd1}, [g], {%b0, %b1};
red.global.v2.f32.add {%f0, %f1}, [g], {%f0, %f1};
red.add.noftz.f32 [addr], %f0;
9.7.15.7. 并行同步与通信指令:red.async#
red.async
异步归约操作。
语法
// Increment and Decrement reductions
red.async.sem.scope{.ss}.completion_mechanism.op.type [a], b, [mbar];
.sem = { .relaxed };
.scope = { .cluster };
.ss = { .shared::cluster };
.op = { .inc, .dec };
.type = { .u32 };
.completion_mechanism = { .mbarrier::complete_tx::bytes };
// MIN and MAX reductions
red.async.sem.scope{.ss}.completion_mechanism.op.type [a], b, [mbar];
.sem = { .relaxed };
.scope = { .cluster };
.ss = { .shared::cluster };
.op = { .min, .max };
.type = { .u32, .s32 };
.completion_mechanism = { .mbarrier::complete_tx::bytes };
// Bitwise AND, OR and XOR reductions
red.async.sem.scope{.ss}.completion_mechanism.op.type [a], b, [mbar];
.sem = { .relaxed };
.scope = { .cluster };
.ss = { .shared::cluster };
.op = { .and, .or, .xor };
.type = { .b32 };
.completion_mechanism = { .mbarrier::complete_tx::bytes };
// ADD reductions
red.async.sem.scope{.ss}.completion_mechanism.add.type [a], b, [mbar];
.sem = { .relaxed };
.scope = { .cluster };
.ss = { .shared::cluster };
.type = { .u32, .s32, .u64 };
.completion_mechanism = { .mbarrier::complete_tx::bytes };
red.async{.mmio}.sem.scope{.ss}.add.type [a], b;
.sem = { .release };
.scope = { .gpu, .sys };
.ss = { .global };
.type = { .u32, .s32, .u64, .s64 };
说明
red.async 是一条非阻塞指令,它启动由 .op 指定的异步归约操作,参与运算的是操作数 b 以及由操作数 a 指定的目标内存位置处的值。
red.async 在通用代理(generic proxy)中执行。
操作数
a是目标地址,必须是寄存器,或者是register + immOff的形式,如作为操作数的地址所述。b是源值,其类型由限定符.type指明。mbar是一个 mbarrier 对象地址。
限定符
.mmio指示这是否为一次 mmio 操作。.sem指定内存序语义,如内存一致性模型中所述。.scope指定本指令可以直接与之同步的线程集合。-
.ss指定目标操作数a与 mbarrier 操作数mbar的状态空间。若未指定
.ss,则使用通用寻址。
-
.completion_mechanism指定用于观测该异步操作完成情况的机制。当
.completion_mechanism为.mbarrier::complete_tx::bytes:异步操作完成后,将对由操作数mbar指定的 mbarrier 对象执行一次 complete-tx 操作,其completeCount参数等于以字节为单位存储的数据量。当
.completion_mechanism未指定:存储的完成与 CTA 的结束同步。本指令使用 generic-proxy 访问其mbarrier操作数。
-
.op指定归约操作。.inc和.dec操作返回位于[0..b]范围内的结果。
.type指定源操作数b的类型。
条件
当 .sem 为 .relaxed 时:
该归约操作是一次 relaxed 内存操作。
对 mbarrier 执行的 complete-tx 操作在
.cluster作用域上具有.release语义。-
目标操作数
a与 mbarrier 操作数mbar的共享内存地址必须同时满足下列全部条件:它们属于同一个 CTA。
它们所属的 CTA 与执行线程所在的 CTA 不同,但必须位于同一个 cluster 之内。
否则,行为未定义。
不得指定
.mmio。若指定了
.ss,则必须为.shared::cluster。若未指定
.ss,则对操作数a和mbar使用通用寻址。若所指定的通用地址未落在.shared::cluster状态空间的地址窗口之内,则行为未定义。若指定了
.completion_mechanism,则必须为.mbarrier::complete_tx::bytes。若未指定
.completion_mechanism,则默认为.mbarrier::complete_tx::bytes。
当 .sem 为 .release 时:
该归约操作是一次强内存操作,在
.scope所指定的作用域上具有.release语义。若指定了
.mmio,则.scope必须为.sys。若指定了
.ss,则必须为.global。若未指定
.ss,则对操作数a使用通用寻址。若所指定的通用地址未落在.global状态空间的地址窗口之内,则行为未定义。不得指定
.completion_mechanism。
示例
red.async.relaxed.cluster.shared::cluster.mbarrier::complete_tx::bytes.min.u32 [addr], b, [mbar_addr];
red.async.release.sys.global.add.u32 [addr], b;
9.7.15.8. 并行同步与通信指令:multimem.red.async#
multimem.red.async
在 multimem 地址上执行具有 release 定序的异步归约。
语法
multimem.red.async.sem.scope{.ss}.op.type [a], b;
.sem = { .release };
.scope = { .gpu, .sys };
.ss = { .global };
.op = { .add };
.type = { .u32, .s32, .u64 };
说明
multimem.red.async 是一条非阻塞指令,它启动由 .op 指定的异步归约操作,参与运算的是操作数 b,以及驻留在各 GPU 内存上、由目标 multimem 地址操作数 a 所引用的那些内存位置处的值。
地址操作数 a 必须是 multimem 地址。否则,行为未定义。
操作数
a是目标地址,必须是寄存器,或者是register + immOff的形式,如作为操作数的地址所述。b是源值,其类型由限定符.type指明。
限定符
必需的
.sem修饰符指定内存序语义,如内存一致性模型中所述。必需的
.scope修饰符指定本指令可以直接与之同步的线程集合。该归约操作是一次强内存操作,在.scope所指定的作用域上具有.release语义。.ss指定目标操作数a的状态空间。若指定了.ss,则必须为.global。若未指定.ss,则对操作数a使用通用寻址。若所指定的通用地址未落在.global状态空间的地址窗口之内,则行为未定义。.type指定源操作数b的类型。
示例
// Asynchronous add reduction, GPU scope, explicit .global, 32-bit unsigned.
multimem.red.async.release.gpu.global.add.u32 [mm_addr], src_u32;
// System scope, generic addressing.
multimem.red.async.release.sys.add.s32 [mm_addr], src_s32;
// 64-bit unsigned add reduction.
multimem.red.async.release.gpu.global.add.u64 [mm_addr], src_u64;
9.7.15.9. 并行同步与通信指令:vote(已弃用)#
vote(已弃用)
跨线程组进行投票。
语法
vote.mode.pred d, {!}a;
vote.ballot.b32 d, {!}a; // 'ballot' form, returns bitmask
.mode = { .all, .any, .uni };
说明
对一个 warp 中所有活动线程的源谓词执行归约。目标谓词值在该 warp 中的所有线程上都相同。
归约模式如下:
.all-
若 warp 中所有活动线程的源谓词均为
True,则结果为True。将源谓词取反即可计算.none。 .any-
若 warp 中某个活动线程的源谓词为
True,则结果为True。将源谓词取反即可计算.not_all。 .uni-
若 warp 中所有活动线程的源谓词取值相同,则结果为
True。将源谓词取反也同样计算.uni。
在 ballot 形式下,vote.ballot.b32 只是把 warp 中每个线程的谓词复制到目标寄存器 d 的相应位位置,其中位位置对应于该线程的 lane id。
warp 中的非活动线程在参与 vote.ballot.b32 时,其对应项将贡献 0。
发布说明
注意,vote 作用于单个 warp 中的线程,而不是跨整个 CTA。
示例
vote.all.pred p,q;
vote.uni.pred p,q;
vote.ballot.b32 r1,p; // get 'ballot' across warp
9.7.15.10. 并行同步与通信指令:vote.sync#
vote.sync
跨线程组进行投票。
语法
vote.sync.mode.pred d, {!}a, membermask;
vote.sync.ballot.b32 d, {!}a, membermask; // 'ballot' form, returns bitmask
.mode = { .all, .any, .uni };
说明
vote.sync 会使执行线程等待,直到 membermask 所对应的全部未退出线程都已使用相同的限定符和相同的 membermask 值执行了 vote.sync,之后才恢复执行。
操作数 membermask 指定一个 32 位整数,它是一个指示参与本指令的线程的掩码,其中位位置对应于线程的 laneid。操作数 a 是一个谓词寄存器。
在 mode 形式下,vote.sync 对 membermask 中所有未退出线程的源谓词执行归约。目标操作数 d 是一个谓词寄存器,其值在 membermask 中的所有线程上都相同。
归约模式如下:
.all-
若
membermask中所有未退出线程的源谓词均为True,则结果为True。将源谓词取反即可计算.none。 .any-
若
membermask中某个线程的源谓词为True,则结果为True。将源谓词取反即可计算.not_all。 .uni-
若
membermask中所有未退出线程的源谓词取值相同,则结果为True。将源谓词取反也同样计算.uni。
在 ballot 形式下,目标操作数 d 是一个 .b32 寄存器。在该形式下,vote.sync.ballot.b32 只是把 membermask 中每个线程的谓词复制到目标寄存器 d 的相应位位置,其中位位置对应于线程的 lane id。
未在 membermask 中指定的线程,其在 vote.sync.ballot.b32 中的对应项将贡献 0。
若执行线程不在 membermask 中,则 vote.sync 的行为未定义。
注
对于 .target sm_6x 或更低,membermask 中的所有线程必须以聚合方式执行同一条 vote.sync 指令,并且在执行该 vote.sync 指令时,只有属于该 membermask 的线程可以处于活动状态。否则,行为未定义。
示例
vote.sync.all.pred p,q,0xffffffff;
vote.sync.ballot.b32 r1,p,0xffffffff; // get 'ballot' across warp
9.7.15.11. 并行同步与通信指令:match.sync#
match.sync
在 warp 的各线程之间广播并比较一个值。
语法
match.any.sync.type d, a, membermask;
match.all.sync.type d[|p], a, membermask;
.type = { .b32, .b64 };
说明
match.sync 会使执行线程等待,直到 membermask 中的全部未退出线程都已使用相同的限定符和相同的 membermask 值执行了 match.sync,之后才恢复执行。
操作数 membermask 指定一个 32 位整数,它是一个指示参与本指令的线程的掩码,其中位位置对应于线程的 laneid。
match.sync 对 membermask 中所有未退出线程广播并比较操作数 a,并根据模式设置目标 d 和可选谓词 p。
操作数 a 具有指令类型,而 d 具有 .b32 类型。
目标 d 是一个 32 位掩码,掩码中的位位置对应于线程的 laneid。
匹配操作模式如下:
.all-
若
membermask中所有未退出线程的操作数a取值相同,则d被设置为与membermask中未退出线程相对应的掩码;否则d被设置为 0。可选谓词p在membermask中所有未退出线程的操作数a取值相同时被置为 true,否则被置为 false。可以使用沉没符号‘_’代替其中任意一个目标操作数。 .any-
d被设置为membermask中操作数a取值相同的那些未退出线程所构成的掩码。
若执行线程不在 membermask 中,则 match.sync 的行为未定义。
发布说明
注意,match.sync 作用于单个 warp 中的线程,而不是跨整个 CTA。
示例
match.any.sync.b32 d, a, 0xffffffff;
match.all.sync.b64 d|p, a, mask;
9.7.15.12. 并行同步与通信指令:activemask#
activemask
查询一个 warp 内的活动线程。
语法
activemask.b32 d;
说明
activemask 查询执行 warp 中谓词为真的活动线程,并用 32 位整数掩码设置目标 d,其中掩码中的位位置对应于线程的 laneid。
目标 d 是一个 32 位目标寄存器。
活动线程在结果中的对应项将贡献 1,而已退出、非活动或谓词为假的线程在结果中的对应项将贡献 0。
示例
activemask.b32 %r1;
9.7.15.13. 并行同步与通信指令:redux.sync#
redux.sync
对线程组中每个谓词为真的活动线程所提供的数据执行归约操作。
语法
redux.sync.op.type dst, src, membermask;
.op = {.add, .min, .max}
.type = {.u32, .s32}
redux.sync.op.b32 dst, src, membermask;
.op = {.and, .or, .xor}
redux.sync.op{.abs.}{.NaN}.f32 dst, src, membermask;
.op = { .min, .max }
说明
redux.sync 会使执行线程等待,直到 membermask 所对应的全部未退出线程都已使用相同的限定符和相同的 membermask 值执行了 redux.sync,之后才恢复执行。
操作数 membermask 指定一个 32 位整数,它是一个指示参与本指令的线程的掩码,其中位位置对应于线程的 laneid。
redux.sync 对 membermask 中所有未退出线程的 32 位源寄存器 src 执行归约操作 .op。归约操作的结果写入 32 位目标寄存器 dst。
归约操作可以是 .and、.or、.xor 中的某种按位操作,也可以是 .add、.min、.max 中的某种算术操作。
对于 .add 操作,结果被截断为 32 位。
对于 .f32 指令类型,若输入值为 0.0,则 +0.0 > -0.0。
若指定了 .abs 限定符,则归约操作将考虑输入的绝对值。
若指定了 .NaN 限定符,则当任一参与线程提供给归约操作的输入为 NaN 时,归约操作的结果为规范 NaN。
在未指定 .NaN 限定符时,归约操作只考虑非 NaN 值,并且当所有输入均为 NaN 时结果为规范 NaN。
若执行线程不在 membermask 中,则 redux.sync 的行为未定义。
发布说明
注意,redux.sync 作用于单个 warp 中的线程,而不是跨整个 CTA。
示例
.reg .b32 dst, src, init, mask;
redux.sync.add.s32 dst, src, 0xff;
redux.sync.xor.b32 dst, src, mask;
redux.sync.min.abs.NaN.f32 dst, src, mask;
9.7.15.14. 并行同步与通信指令:griddepcontrol#
griddepcontrol
控制依赖网格的执行。
语法
griddepcontrol.action;
.action = { .launch_dependents, .wait }
说明
griddepcontrol 指令使得由运行时所定义的依赖网格与前置网格能够以下列方式控制执行:
.launch_dependents 修饰符发出如下信号:一旦该网格中所有其他 CTA 都发出了同一条指令或者已经完成,运行时系统所指定、会对该指令作出反应的那些特定依赖网格就可以被调度。依赖网格可以在当前网格完成之前启动。但并不保证依赖网格一定会在当前网格完成之前启动。当前 CTA 中的线程重复调用该指令,除第一次调用之外不会产生任何额外的副作用。在程序序上先于 griddepcontrol.launch_dependents 的一条释放栅栏与一个依赖网格的开始同步,条件是:两个网格具有相同的内存同步域且栅栏作用域为 gpu,或者栅栏作用域为 sys。
.wait 修饰符使执行线程等待,直到所有在途的前置网格都已完成,并且来自这些前置网格的所有内存操作都已被执行并对当前网格可见。
注
若前置网格使用了 griddepcontrol.launch_dependents,则依赖网格必须使用 griddepcontrol.wait,以确保功能正确执行。
示例
griddepcontrol.launch_dependents;
griddepcontrol.wait;
9.7.15.15. 并行同步与通信指令:elect.sync#
elect.sync
从一组线程中选出一个领导者线程。
语法
elect.sync d|p, membermask;
说明
elect.sync 从 membermask 所指定的一组线程中选出一个谓词为真的活动领导者线程。被选中的线程的 laneid 通过 32 位目标操作数 d 返回。目标操作数 d 可以使用沉没符号‘_’。谓词目标 p 在领导者线程上被置为 True,在所有其他线程上被置为 False。
操作数 membermask 指定一个 32 位整数,指示要从中选出领导者的线程集合。若执行线程不在 membermask 中,则行为未定义。
领导者线程的选举是确定性地进行的,即对于同一个 membermask,每次选出的都是同一个领导者线程。
必需的 .sync 限定符表明,elect 会使执行线程等待,直到 membermask 中的所有线程都执行了 elect 指令,之后才恢复执行。
示例
elect.sync %r0|%p0, 0xffffffff;
9.7.15.16. 并行同步与通信指令:mbarrier#
mbarrier 是在共享内存中创建的一种屏障,它支持:
同步 CTA 内的任意线程子集
对 cluster 中各 CTA 之间线程的单向同步。如 共享内存对 mbarrier 的支持 中所述,线程只能对位于
shared::cluster空间中的 mbarrier 执行 arrive 操作,而不能执行 *_wait 操作。等待由线程发起的异步内存操作完成,并使其对其他线程可见。
mbarrier 对象是内存中的一种不透明对象,可使用以下操作对其进行初始化和失效处理:
mbarrier.initmbarrier.inval
mbarrier 对象上支持的操作包括:
mbarrier.expect_txmbarrier.complete_txmbarrier.arrivembarrier.arrive_dropmbarrier.test_waitmbarrier.try_waitmbarrier.pending_countmbarrier.check_layoutcp.async.mbarrier.arrive
对未初始化的 mbarrier 对象执行除 mbarrier.init 之外的任何 mbarrier 操作会导致未定义行为。对已初始化的 mbarrier 对象执行任何非 mbarrier 操作或 mbarrier.init 操作会导致未定义行为。
与每个 CTA 只能访问有限数量屏障的 bar{.cta}/barrier{.cta} 指令不同,mbarrier 对象由用户定义,仅受可用共享内存总量的限制。
mbarrier 操作使线程能够在到达 mbarrier 之后、等待 mbarrier 完成之前执行有用的工作。
9.7.15.16.1. mbarrier 对象的大小与对齐#
mbarrier 对象是一种不透明对象,具有以下类型与对齐要求:
类型 |
对齐(字节) |
内存空间 |
|---|---|---|
|
8 |
|
9.7.15.16.2. mbarrier 对象的布局#
不透明的 mbarrier 对象支持两种不同的布局:
.layout::v0.layout::v1
mbarrier 对象的确切布局可在创建时指定。mbarrier 对象能够跟踪的异步操作取决于布局。更多详情请参阅 mbarrier 对象的内容。
9.7.15.16.3. mbarrier 对象的内容#
不透明的 mbarrier 对象无论采用何种布局,都会跟踪以下信息:
mbarrier 对象的当前主阶段与条件阶段
mbarrier 对象当前阶段的待到达计数
mbarrier 对象下一阶段的预期到达计数
由 mbarrier 对象当前阶段跟踪的待处理异步内存操作(或事务)的计数。这也称为 tx-count。
但是,采用 .layout::v1 的 mbarrier 对象还会额外跟踪以下信息:
与每个主阶段对应的负载报告
mbarrier 对象会经历一系列阶段,其中每个阶段由线程执行预期数量的 arrive-on 操作来定义。
各个计数的有效范围因 mbarrier 布局而异。更多详情请参阅 表 43。
布局 |
计数名称 |
最小值 |
最大值 |
|---|---|---|---|
|
预期到达计数 |
1 |
220 - 1 |
待到达计数 |
0 |
220 - 1 |
|
tx-count |
-(220 - 1) |
220 - 1 |
|
|
预期到达计数 |
1 |
29 - 1 |
待到达计数 |
0 |
29 - 1 |
|
tx-count |
-(220 - 1) |
220 - 1 |
9.7.15.16.4. mbarrier 对象的生命周期#
使用前必须先初始化 mbarrier 对象。
mbarrier 对象用于同步线程、跟踪异步内存操作。
mbarrier 对象可用于执行一系列此类同步。
若要将 mbarrier 对象的内存改作任何其他用途(包括用于另一个 mbarrier 对象),必须先使该 mbarrier 对象失效。
9.7.15.16.5. mbarrier 对象的阶段#
9.7.15.16.5.1. 主阶段#
mbarrier 对象的主阶段是指该 mbarrier 对象被用于同步线程和 异步 操作的次数。在每个主阶段 {0, 1, 2, …} 中,线程按程序顺序执行:
用于完成当前主阶段的 arrive-on 操作,以及
用于检查当前主阶段是否完成的 test_wait / try_wait 操作。
当前主阶段完成后,mbarrier 对象会自动重新初始化,以便立即在下一阶段中使用。当前主阶段尚未完成,而所有先前的主阶段均已完成。
对于 mbarrier 对象的每个主阶段,在后续主阶段中执行 arrive-on 操作之前,必须至少执行一次 test_wait 或 try_wait 操作,且该操作对 waitComplete 返回 True。
9.7.15.16.5.2. 条件阶段#
当到达操作完成以及 mbarrier 所跟踪的异步操作的事务计数更新完成后,mbarrier 对象的主阶段会推进。如果主阶段推进,且 mbarrier 所跟踪的异步操作未通过 report-on 操作阻止,则条件阶段也会推进。
采用 .layout::v0 的 mbarrier 对象不支持跟踪可能通过 report-on 阻止条件阶段推进的异步操作,因此两个阶段会一致推进。也就是说,要么两个阶段都推进,要么都不推进。
采用 .layout::v1 的 mbarrier 对象支持跟踪可通过 report-on 操作阻止条件阶段推进的异步操作。如果主阶段推进而条件阶段未推进,则负载报告非零,并且可能包含更多信息。如果条件阶段推进,则负载报告为零。
当前主阶段完成后,mbarrier 对象会自动重新初始化,以便立即在下一阶段中使用。有关条件阶段完成的更多详情,请参阅 mbarrier 对象的阶段完成。
9.7.15.16.6. 由 mbarrier 对象跟踪异步操作#
从 Hopper 架构(sm_9x)开始,mbarrier 对象支持一种新的计数,称为 tx-count,用于跟踪异步内存操作或事务的完成情况。tx-count 以异步内存操作指定的单位,跟踪尚未完成、仍处于未处理状态的异步事务数量。
mbarrier 对象的 tx-count 必须设置为当前阶段要跟踪的异步内存操作总量,单位由异步操作指定。每个异步操作完成时,将对 mbarrier 对象执行 complete-tx 操作,从而使 mbarrier 朝当前阶段的完成推进。
9.7.15.16.6.1. expect-tx 操作#
带 expectCount 参数的 expect-tx 操作会将 mbarrier 对象的 tx-count 增加 expectCount 所指定的值。这会将 mbarrier 对象的当前阶段设置为预期并跟踪额外异步事务的完成。
9.7.15.16.6.2. complete-tx 操作#
在 mbarrier 对象上带 completeCount 参数的 complete-tx 操作包含以下内容:
- mbarrier 发信号
-
发出由当前阶段跟踪的异步事务已完成的信号。其结果是 tx-count 减少
completeCount。 - mbarrier 可能完成当前阶段
-
如果当前阶段已完成,则 mbarrier 转换到下一阶段。有关阶段完成要求和阶段转换过程的详情,请参阅 mbarrier 对象的阶段完成。
9.7.15.16.7. 使用 mbarrier 对象跟踪操作的成功完成#
布局为 .layout::v1 的 mbarrier 对象可以跟踪阻止条件阶段推进的异步操作,并在完成时通过负载报告提供额外信息。
带 .phase_type::primary 的 mbarrier.test_wait 和 mbarrier.try_wait 指令允许观察主阶段的完成情况和负载报告。负载报告由一个报告谓词(reportPredicate)和一个报告值(reportValue)组成。要使条件阶段推进,整个负载报告必须为零。如果谓词即 reportPredicate 为零,则值 reportValue 保证为零,因此条件阶段已推进。
带 .phase_type::conditional 的 mbarrier.test_wait 和 mbarrier.try_wait 指令允许观察条件阶段的推进,这意味着负载报告为零。
9.7.15.16.8. mbarrier 对象的阶段完成#
当前阶段完成的要求如下所述。当前阶段完成后,该阶段按下文所述转换到后续阶段。
- 当前主阶段完成要求
-
无论采用何种布局,mbarrier 对象在满足以下所有条件时即完成当前主阶段:
待到达计数已降至零。
tx-count 已降至零。
- 当前条件阶段完成要求
-
mbarrier 对象在满足以下所有条件时即完成当前条件阶段:
待到达计数已降至零。
tx-count 已降至零。
如果 mbarrier 的布局为
.layout::v1,则与主阶段关联的负载报告为零。
- 阶段转换
-
当采用
.layout::v0的 mbarrier 对象完成当前阶段时,会原子地执行以下动作:mbarrier 对象转换到下一个主阶段和条件阶段。
待到达计数被重新初始化为预期到达计数。
当采用
.layout::v1的 mbarrier 对象完成当前阶段时,会原子地执行以下动作:如果与 mbarrier 当前主阶段关联的负载报告为零,则条件阶段推进。
mbarrier 对象转换到下一个主阶段。
与下一个主阶段对应的负载报告被重新初始化为零。
待到达计数被重新初始化为预期到达计数。
9.7.15.16.9. mbarrier 对象上的 arrive-on 操作#
在 mbarrier 对象上带可选 count 参数的 arrive-on 操作包含以下 2 个步骤:
-
mbarrier 发信号:
发出执行线程已到达的信号,或发出异步指令已完成的信号,该异步指令表示执行线程在 mbarrier 对象上发起的 arrive-on 操作。其结果是待到达计数减少 count。如果未指定 count 参数,则其默认为 1。
-
mbarrier 可能完成当前阶段:
如果当前阶段已完成,则 mbarrier 转换到下一阶段。有关阶段完成要求和阶段转换过程的详情,请参阅 mbarrier 对象的阶段完成。
9.7.15.16.10. mbarrier 对象上的 report-on 操作#
mbarrier 对象上的 report-on 操作用于发出有关异步操作的各种信息的信号。例如,此类各种信息可以是关于遇到的错误、警告;否则,也可以是异步操作传递的任何额外信息。
异步操作通过 report-on mbarrier 操作报告的各种信息将被更新到负载报告中。以下异步操作可能会在关联的 mbarrier 对象上发出 report-on 操作:
指定了除
.mbarrier::report::disabled之外的.report_mechanism的cp.async.bulk、cp.async.bulk.tensor指令。更多详情请参阅 异步复制操作的报告机制。诸如
fabric.try_get、fabric.try_put、fabric.try_red、fabric.try_pullred、fabric.try_get.async.tensor、fabric.try_put.async.tensor、fabric.try_red.async.tensor之类的 Fabric 操作。更多详情请参阅 Fabric 报告机制。
9.7.15.16.11. 共享内存对 mbarrier 的支持#
下表总结了位于不同共享内存位置的 mbarrier 对象上各种 mbarrier 操作的支持情况:
mbarrier 操作 |
|
|
|---|---|---|
|
受支持 |
受支持,但不能返回结果 |
|
受支持 |
受支持 |
|
受支持 |
受支持 |
其他 mbarrier 操作 |
受支持 |
不受支持 |
9.7.15.16.12. 并行同步与通信指令:mbarrier.init#
mbarrier.init
初始化mbarrier 对象。
语法
mbarrier.init{.layout}{.shared{::cta}}.b64 [addr], count;
.layout = { .layout::v0, .layout::v1 }
说明
mbarrier.init 使用无符号 32 位整数 count 初始化由地址操作数 addr 所指定位置处的mbarrier 对象。.layout 限定符指定用于初始化该 mbarrier 对象的布局。若未显式指定,则初始化一个 .layout::v0 mbarrier。更多详情参见mbarrier 对象的布局。
操作数 count 的有效取值范围随 .layout 的不同而变化,具体如下:
对于具有
.layout::v0的 mbarrier,为 [1, …, 220 - 1]对于具有
.layout::v1的 mbarrier,为 [1, …, 29 - 1]
mbarrier 对象的各组成部分初始化如下:
主阶段与条件阶段被初始化为零。
预期到达计数与待定到达计数被初始化为
count。初始事务计数 tx-count 被初始化为零。
对于具有
.layout::v1的 mbarrier 对象,与主阶段对应的负载报告被初始化为零。
若未指定状态空间,则使用通用寻址。若由 addr 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如作为操作数的地址 所述。操作数 addr 的对齐如mbarrier 对象的大小与对齐 所述。
对包含有效mbarrier 对象的内存位置执行 mbarrier.init 操作的行为是未定义的;在将该内存位置改作任何其他用途(包括用作另一个mbarrier 对象)之前,必须先使用 mbarrier.inval 使该mbarrier 对象失效。
示例
.shared .b64 shMem, shMem2, shMem3;
.reg .b64 addr;
.reg .b32 %r1;
cvta.shared.u64 addr, shMem2;
mbarrier.init.b64 [addr], %r1;
bar.cta.sync 0;
// … other mbarrier operations on addr
mbarrier.init.shared::cta.b64 [shMem], 12;
mbarrier.init.layout::v1.shared::cta.b64 [shMem3], 4;
bar.sync 0;
// … other mbarrier operations on shMem
// … other mbarrier operations on shMem3
9.7.15.16.13. 并行同步与通信指令:mbarrier.inval#
mbarrier.inval
使mbarrier 对象失效。
语法
mbarrier.inval{.shared{::cta}}.b64 [addr];
说明
mbarrier.inval 使由地址操作数 addr 所指定位置处的mbarrier 对象失效。该失效操作对mbarrier 对象的布局 中描述的所有布局都受支持。
在将其内存位置用于任何其他用途之前,必须使mbarrier 对象失效。
在不包含有效mbarrier 对象的内存位置上执行除 mbarrier.init 之外的任何 mbarrier 操作,都会导致未定义行为。
若未指定状态空间,则使用通用寻址。若由 addr 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如作为操作数的地址 所述。操作数 addr 的对齐如mbarrier 对象的大小与对齐 所述。
示例
.shared .b64 shmem;
.reg .b64 addr;
.reg .b32 %r1;
.reg .pred t0;
// Example 1 :
bar.sync 0;
@t0 mbarrier.init.b64 [addr], %r1;
// … other mbarrier operations on addr
bar.sync 0;
@t0 mbarrier.inval.b64 [addr];
// Example 2 :
bar.cta.sync 0;
mbarrier.init.shared.b64 [shmem], 12;
// … other mbarrier operations on shmem
bar.cta.sync 0;
@t0 mbarrier.inval.shared.b64 [shmem];
// shmem can be reused here for unrelated use :
bar.cta.sync 0;
st.shared.b64 [shmem], …;
// shmem can be re-initialized as mbarrier object :
bar.cta.sync 0;
@t0 mbarrier.init.shared.b64 [shmem], 24;
// … other mbarrier operations on shmem
bar.cta.sync 0;
@t0 mbarrier.inval.shared::cta.b64 [shmem];
9.7.15.16.14. 并行同步与通信指令:mbarrier.expect_tx#
mbarrier.expect_tx
在mbarrier 对象上执行expect-tx 操作。
语法
mbarrier.expect_tx{.sem.scope}{.space}.b64 [addr], txCount;
.sem = { .relaxed }
.scope = { .cta, .cluster }
.space = { .shared{::cta} }
mbarrier.expect_tx{.sem.scope}{.space}{.multicast}.b64 [addr], txCount{, ctaMask};
.sem = { .relaxed }
.scope = { .cta, .cluster }
.space = { .shared::cluster }
.multicast = { .multicast::cluster::32b }
说明
执行 mbarrier.expect_tx 的线程在由地址操作数 addr 所指定位置处的mbarrier 对象上执行一次expect-tx 操作。32 位无符号整数操作数 txCount 指定 expect-tx 操作的 expectCount 参数。
若未指定状态空间,则使用通用寻址。若由 addr 指定的地址不落在 .shared::cta 或 .shared::cluster 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如作为操作数的地址 所述。操作数 addr 的对齐如mbarrier 对象的大小与对齐 所述。
可选的 .sem 限定符指定内存同步效果,如内存一致性模型 中所述。.relaxed 限定符不提供任何内存排序语义和可见性保证。
可选的 .scope 限定符指出直接观察到本操作内存同步效果的线程集合,如内存一致性模型 中所述。
限定符 .sem 与 .scope 必须一起指定。
可选限定符 .multicast::cluster::32b 允许从 cluster 内多个 CTA 的共享内存中对一个 mbarrier 对象执行expect-tx 操作。操作数 txCount 指定expect-tx 操作的 expectCount 参数。操作数 ctaMask 指定 cluster 中预期的目标 CTA,使得 32 位 ctaMask 操作数中的每个位位置对应于一个目标 CTA 的 %cluster_ctarank。例如,值为 0x1 的 ctaMask 在 rank 为 0 的 CTA 上执行该操作,而值为 0x3 的 ctaMask 在 rank 为 0 和 1 的 CTA 上执行该操作。该expect-tx 操作被多播到目标 CTA 共享内存中与 addr 相同的 CTA 相对偏移处。
示例
mbarrier.expect_tx.b64 [addr], 32;
mbarrier.expect_tx.relaxed.cta.shared.b64 [mbarObj1], 512;
mbarrier.expect_tx.relaxed.cta.shared.b64 [mbarObj2], 512;
mbarrier.expect_tx.relaxed.cta.shared::cluster.multicast::cluster::32b.b64 [mbarObj3], 512, 0x3;
9.7.15.16.15. 并行同步与通信指令:mbarrier.complete_tx#
mbarrier.complete_tx
在mbarrier 对象上执行complete-tx 操作。
语法
mbarrier.complete_tx{.sem.scope}{.space}.b64 [addr], txCount;
.sem = { .relaxed }
.scope = { .cta, .cluster }
.space = { .shared{::cta} }
mbarrier.complete_tx{.sem.scope}{.space}{.multicast}.b64 [addr], txCount {, ctaMask};
.sem = { .relaxed }
.scope = { .cta, .cluster }
.space = { .shared::cluster }
.multicast = { .multicast::cluster::32b }
说明
执行 mbarrier.complete_tx 的线程在由地址操作数 addr 所指定位置处的mbarrier 对象上执行一次complete-tx 操作。32 位无符号整数操作数 txCount 指定 complete-tx 操作的 completeCount 参数。
mbarrier.complete_tx 不涉及任何异步内存操作,而只是模拟一次异步内存操作的完成及其向mbarrier 对象发出信号的副作用。
若未指定状态空间,则使用通用寻址。若由 addr 指定的地址不落在 .shared::cta 或 .shared::cluster 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如作为操作数的地址 所述。操作数 addr 的对齐如mbarrier 对象的大小与对齐 所述。
可选的 .sem 限定符指定内存同步效果,如内存一致性模型 中所述。.relaxed 限定符不提供任何内存排序语义和可见性保证。
可选的 .scope 限定符指出直接观察到本操作内存同步效果的线程集合,如内存一致性模型 中所述。
限定符 .sem 与 .scope 必须一起指定。
可选限定符 .multicast::cluster::32b 允许从 cluster 内多个 CTA 的共享内存中对 mbarrier 对象执行complete-tx 操作。操作数 txCount 指定complete-tx 操作的 completeCount 参数。操作数 ctaMask 指定 cluster 中预期的目标 CTA;32 位 ctaMask 操作数中的每个位位置对应于目标 CTA 的 %cluster_ctarank。例如,值为 0x1 的 ctaMask 在 rank 为 0 的 CTA 上执行该操作,而值为 0x3 的 ctaMask 在 rank 为 0 和 1 的 CTA 上执行该操作。该complete-tx 操作被多播到每个目标 CTA 共享内存中与 addr 相同的 CTA 相对偏移处。
示例
mbarrier.complete_tx.b64 [addr], 32;
mbarrier.complete_tx.shared.b64 [mbarObj1], 512;
mbarrier.complete_tx.relaxed.cta.b64 [addr2], 32;
mbarrier.complete_tx.relaxed.cta.shared::cluster.multicast::cluster::32b.b64 [addr3], 512, mask;
9.7.15.16.16. 并行同步与通信指令:mbarrier.arrive#
mbarrier.arrive
在mbarrier 对象上执行arrive-on 操作。
语法
mbarrier.arrive{.sem.scope}{.shared{::cta}}.b64 state, [addr]{, count};
mbarrier.arrive{.sem.scope}{.shared::cluster}{.multicast}.b64 _, [addr] {,count} {, ctaMask};
mbarrier.arrive.expect_tx{.sem.scope}{.shared{::cta}}.b64 state, [addr], txCount;
mbarrier.arrive.expect_tx{.sem.scope}{.shared::cluster}{.multicast}.b64 _, [addr], txCount {, ctaMask};
mbarrier.arrive.noComplete{.release.cta}{.shared{::cta}}.b64 state, [addr], count;
.sem = { .release, .relaxed }
.scope = { .cta, .cluster }
.multicast = { .multicast::cluster::32b }
说明
执行 mbarrier.arrive 的线程会在由地址操作数 addr 所指定位置处的 mbarrier 对象上执行一次 arrive-on 操作。32 位无符号整数操作数 count 指定 arrive-on 操作的 count 参数。
若未指定状态空间,则使用 通用寻址。若由 addr 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如 作为操作数的地址 所述。操作数 addr 的对齐要求如 mbarrier 对象的大小与对齐 所述。
可选限定符 .expect_tx 指定在 arrive-on 操作之前执行一次 expect-tx 操作。32 位无符号整数操作数 txCount 指定 expect-tx 操作的 expectCount 参数。当同时指定 .arrive 和 .expect_tx 两个限定符时,arrive-on 操作的 count 参数被假定为 1。
带 .noComplete 限定符的 mbarrier.arrive 操作不得使 mbarrier 完成其当前阶段,否则行为未定义。
操作数 count 的值必须处于 mbarrier 对象的内容 所指定的范围内。
注意:对于 sm_8x,当指定了参数 count 时,必须使用修饰符 .noComplete。
对位于 .shared::cta 中的 mbarrier 对象执行 mbarrier.arrive 操作时,会在目标操作数 state. 中返回一个不透明的 64 位寄存器,其中记录了该 mbarrier 对象在 arrive-on 操作之前的阶段。state 操作数的内容与实现相关。可选地,state 参数可以使用沉没符号 '_'。
对位于 .shared::cluster 中但不在 .shared::cta 中的 mbarrier 对象执行 mbarrier.arrive 操作时不能返回值。对于此类情况,目标操作数必须使用沉没符号‘_’。
可选 .sem 限定符指定内存同步效果,如 内存一致性模型 所述。若未指定 .sem 限定符,则默认假定为 .release。
.relaxed 限定符不提供任何内存排序语义与可见性保证。
可选 .scope 限定符指定能够直接观察到本操作内存同步效果的一组线程,如 内存一致性模型 所述。若未指定 .scope 限定符,则其默认值为 .cta。与之相对,.shared::<scope> 表示 mbarrier 所在的状态空间。
限定符 .sem 与 .scope 必须一起指定。
可选限定符 .multicast::cluster::32b 允许从 cluster 中多个 CTA 的共享内存对同一个 mbarrier 对象执行 arrive-on 操作,并可选地执行 expect-tx 操作。操作数 ctaMask 指定 cluster 中预期的目标 CTA;32 位 ctaMask 操作数中的每个位位置对应目标 CTA 的 %cluster_ctarank。例如,值为 0x1 的 ctaMask 会在秩为 0 的 CTA 上执行该操作,而值为 0x3 时会在秩为 0 和 1 的 CTA 上执行该操作。该 arrive-on 操作以及可选的 expect-tx 操作会被多播到每个目标 CTA 共享内存中与 addr 相同的 CTA 相对偏移处。
示例
.reg .b32 cnt, remoteAddr32, remoteCTAId, addr32;
.reg .b64 %r<5>, addr, remoteAddr64;
.shared .b64 shMem, shMem2;
cvta.shared.u64 addr, shMem2;
mov.b32 addr32, shMem2;
mapa.shared::cluster.u32 remoteAddr32, addr32, remoteCTAId;
mapa.u64 remoteAddr64, addr, remoteCTAId;
cvta.shared.u64 addr, shMem2;
mbarrier.arrive.shared.b64 %r0, [shMem];
mbarrier.arrive.shared::cta.b64 %r0, [shMem2];
mbarrier.arrive.release.cta.shared::cluster.b64 _, [remoteAddr32];
mbarrier.arrive.release.cluster.b64 _, [remoteAddr64], cnt;
mbarrier.arrive.expect_tx.release.cluster.b64 _, [remoteAddr64], tx_count;
mbarrier.arrive.noComplete.b64 %r1, [addr], 2;
mbarrier.arrive.relaxed.cta.b64 %r2, [addr], 4;
mbarrier.arrive.b64 %r2, [addr], cnt;
mbarrier.arrive.release.cta.shared::cluster.multicast::cluster::32b.b64 _, [remoteAddr32], 0xa;
9.7.15.16.17. 并行同步与通信指令:mbarrier.arrive_drop#
mbarrier.arrive_drop
递减 mbarrier 对象的预期计数,并执行 arrive-on 操作。
语法
mbarrier.arrive_drop{.sem.scope}{.shared{::cta}}.b64 state, [addr] {, count};
mbarrier.arrive_drop{.sem.scope}{.shared::cluster}{.multicast}.b64 _, [addr] {, count} {, ctaMask};
mbarrier.arrive_drop.expect_tx{.sem.scope}{.shared{::cta}}.b64 state, [addr], tx_count;
mbarrier.arrive_drop.expect_tx{.sem.scope}{.shared::cluster}{.multicast}.b64 _, [addr], tx_count {, ctaMask};
mbarrier.arrive_drop.noComplete{.release.cta}{.shared{::cta}}.b64 state, [addr], count;
.sem = { .release, .relaxed }
.scope = { .cta, .cluster }
.multicast = { .multicast::cluster::32b }
说明
在由地址操作数 addr 所指定位置处的 mbarrier 对象上执行 mbarrier.arrive_drop 的线程会执行以下步骤:
将 mbarrier 对象的预期到达计数递减 32 位整数操作数
count所指定的值。若未指定count操作数,则其默认值为 1。在该 mbarrier 对象上执行一次 arrive-on 操作。操作数
count指定 arrive-on 操作的 count 参数。
对 mbarrier 对象预期到达计数所做的递减将作用于该 mbarrier 对象的所有后续阶段。
若该递减使预期到达计数变为零,则行为未定义。
若未指定状态空间,则使用 通用寻址。若由 addr 指定的地址不落在 .shared::cta 或 .shared::cluster 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如 作为操作数的地址 所述。操作数 addr 的对齐要求如 mbarrier 对象的大小与对齐 所述。
可选限定符 .expect_tx 指定在 arrive_drop 操作(即到达计数的递减与 arrive-on 操作)之前执行一次 expect-tx 操作。32 位无符号整数操作数 txCount 指定 expect-tx 操作的 expectCount 参数。当同时指定 .arrive_drop 和 .expect_tx 两个限定符时,arrive-on 操作的 count 参数被假定为 1。
带 .release 限定符的 mbarrier.arrive_drop 操作会形成内存一致性模型中所述的 release 模式,并与 acquire 模式同步。
可选 .sem 限定符指定内存同步效果,如 内存一致性模型 所述。若未指定 .sem 限定符,则默认假定为 .release。.relaxed 限定符不提供任何内存排序语义与可见性保证。
可选 .scope 限定符指定 mbarrier.arrive_drop 指令能够直接同步的一组线程。若未指定 .scope 限定符,则其默认值为 .cta。与之相对,.shared::<scope> 表示 mbarrier 所在的状态空间。
带 .noComplete 限定符的 mbarrier.arrive_drop 不得使 mbarrier, 完成,否则行为未定义。
操作数 count 的值必须处于 mbarrier 对象的内容 所指定的范围内。
注意:对于 sm_8x,当指定了参数 count 时,必须使用修饰符 .noComplete。
想要退出或选择不参与 arrive-on 操作的线程,可以使用 mbarrier.arrive_drop 将自身从 mbarrier 中移除。
对位于 .shared::cta 中的 mbarrier 对象执行 mbarrier.arrive_drop 操作时,会在目标操作数 state 中返回一个不透明的 64 位寄存器,其中记录了该 mbarrier 对象在 arrive-on 操作之前的阶段。所返回状态的内容与实现相关。可选地,state 参数可以使用沉没符号 '_'。
对位于 .shared::cluster 中但不在 .shared::cta 中的 mbarrier 对象执行 mbarrier.arrive_drop 操作时不能返回值。对于此类情况,目标操作数必须使用沉没符号‘_’。
可选限定符 .multicast::cluster::32b 允许从 cluster 中多个 CTA 的共享内存对同一个 mbarrier 对象执行 mbarrier.arrive_drop 操作,并可选地执行 expect-tx 操作。操作数 ctaMask 指定 cluster 中预期的目标 CTA,其中 32 位 ctaMask 中的每一位对应目标 CTA 的 %cluster_ctarank。例如,值为 0x1 的 ctaMask 会在秩为 0 的 CTA 上执行该操作,而值为 0x3 的 ctaMask 会在秩为 0 和 1 的 CTA 上执行该操作。mbarrier.arrive_drop 操作以及可选的 expect-tx 操作会被多播到目标 CTA 共享内存中与 addr 相同的 CTA 相对偏移处。
限定符 .sem 与 .scope 必须一起指定。
示例
.reg .b32 cnt;
.reg .b64 %r1;
.shared .b64 shMem;
// Example 1
@p mbarrier.arrive_drop.shared.b64 _, [shMem];
@p exit;
@p2 mbarrier.arrive_drop.noComplete.shared.b64 _, [shMem], %a;
@p2 exit;
..
@!p mbarrier.arrive.shared.b64 %r1, [shMem];
@!p mbarrier.test_wait.shared.b64 q, [shMem], %r1;
// Example 2
mbarrier.arrive_drop.shared::cluster.multicast::cluster::32b.b64 _, [addr], mask;
mbarrier.arrive_drop.shared::cta.release.cluster.b64 _, [addr], cnt;
// Example 3
mbarrier.arrive_drop.expect_tx.shared::cta.relaxed.cluster.b64 state, [addr], tx_count;
9.7.15.16.18. 并行同步与通信指令:cp.async.mbarrier.arrive#
cp.async.mbarrier.arrive
使 mbarrier 对象跟踪执行线程先前发起的所有 cp.async 操作。
语法
cp.async.mbarrier.arrive{.noinc}{.shared{::cta}}.b64 [addr];
说明
使得在执行线程先前发起的所有 cp.async 操作完成后,由系统在 mbarrier 对象上触发一次 arrive-on 操作。该 mbarrier 对象位于操作数 addr 所指定的位置。该 arrive-on 操作相对于 cp.async.mbarrier.arrive 的执行是异步的。
若未指定 .noinc 修饰符,则在异步 arrive-on 操作之前,mbarrier 对象的待决计数会先加 1。这导致在当前阶段由该异步 arrive-on 操作引起的待决计数净变化为零。递增之后 mbarrier 对象的待决计数不应超过 mbarrier 对象的内容 中所述的限值。否则,行为未定义。
若指定了 .noinc 修饰符,则不会对 mbarrier 对象的待决计数进行递增。因此,由异步 arrive-on 操作所执行的待决计数递减必须在 mbarrier 对象的初始化中予以计入。
若未指定状态空间,则使用 通用寻址。若由 addr 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如 作为操作数的地址 所述。操作数 addr 的对齐要求如 mbarrier 对象的大小与对齐 所述。
示例
// Example 1: no .noinc
mbarrier.init.shared.b64 [shMem], threadCount;
....
cp.async.ca.shared.global [shard1], [gbl1], 4;
cp.async.cg.shared.global [shard2], [gbl2], 16;
....
// Absence of .noinc accounts for arrive-on from completion of prior cp.async operations.
// So mbarrier.init must only account for arrive-on from mbarrier.arrive.
cp.async.mbarrier.arrive.shared.b64 [shMem];
....
mbarrier.arrive.shared.b64 state, [shMem];
waitLoop:
mbarrier.test_wait.shared.b64 p, [shMem], state;
@!p bra waitLoop;
// Example 2: with .noinc
// Tracks arrive-on from mbarrier.arrive and cp.async.mbarrier.arrive.
// All threads participating in the mbarrier perform cp.async
mov.b32 copyOperationCnt, threadCount;
// 3 arrive-on operations will be triggered per-thread
mul.lo.u32 copyArrivalCnt, copyOperationCnt, 3;
add.u32 totalCount, threadCount, copyArrivalCnt;
mbarrier.init.shared.b64 [shMem], totalCount;
…
cp.async.ca.shared.global [shard1], [gbl1], 4;
cp.async.cg.shared.global [shard2], [gbl2], 16;
…
// Presence of .noinc requires mbarrier initialization to have accounted for arrive-on from cp.async
cp.async.mbarrier.arrive.noinc.shared.b64 [shMem]; // 1st instance
…
cp.async.ca.shared.global [shard3], [gbl3], 4;
cp.async.ca.shared.global [shard4], [gbl4], 16;
cp.async.mbarrier.arrive.noinc.shared::cta.b64 [shMem]; // 2nd instance
…
cp.async.ca.shared.global [shard5], [gbl5], 4;
cp.async.cg.shared.global [shard6], [gbl6], 16;
cp.async.mbarrier.arrive.noinc.shared.b64 [shMem]; // 3rd and last instance
…
mbarrier.arrive.shared.b64 state, [shMem];
waitLoop:
mbarrier.test_wait.shared.b64 p, [shMem], state;
@!p bra waitLoop;
9.7.15.16.19. 并行同步与通信指令:mbarrier.test_wait / mbarrier.try_wait#
mbarrier.test_wait, mbarrier.try_wait
检查 mbarrier object 是否已完成该阶段。
语法
// without parity
mbarrier.test_wait{.phase_type::primary}{.sem.scope}{.ss}.b64 waitComplete, [addr], state;
mbarrier.test_wait.phase_type::primary{.sem}{.scope}{.ss}.b64 waitComplete|reportPredicate
{, reportValue}, [addr], state;
// with parity
mbarrier.test_wait.parity{.phase_type}{.sem.scope}{.ss}.b64 waitComplete, [addr], phaseParity;
mbarrier.test_wait.parity.phase_type::primary{.sem}{.scope}{.ss}.b64 waitComplete|reportPredicate
{, reportValue}, [addr], phaseParity;
// without parity
mbarrier.try_wait{.phase_type::primary}{.sem.scope}{.ss}.b64 waitComplete, [addr], state {, timeHint};
mbarrier.try_wait.phase_type::primary{.sem}{.scope}{.ss}.b64 waitComplete|reportPredicate {, reportValue},
[addr], state {, timeHint};
// with parity
mbarrier.try_wait.parity{.phase_type}{.sem.scope}{.ss}.b64 waitComplete, [addr], phaseParity {, timeHint};
mbarrier.try_wait.parity.phase_type::primary{.sem}{.scope}{.ss}.b64 waitComplete|reportPredicate {, reportValue},
[addr], phaseParity {, timeHint};
.ss = { .shared{::cta} }
.sem = { .acquire, .relaxed }
.scope = { .cta, .cluster }
.phase_type = { .phase_type::primary, .phase_type::conditional }
说明
test_wait 和 try_wait 操作测试由操作数 addr 所指定位置处的 mbarrier object 的当前阶段或紧邻前一阶段是否已完成。
mbarrier.test_wait 是一条非阻塞指令,用于测试该阶段是否已完成。
mbarrier.try_wait 是一条可能阻塞的指令,用于测试该阶段是否已完成。如果该阶段尚未完成,执行线程可能被挂起。被挂起的线程在指定阶段完成时恢复执行,或者在经过一个依赖于系统的时间限制后、在该阶段完成之前恢复执行。可选的 32 位无符号整数操作数 timeHint 以纳秒为单位指定时间限制,可用于替代依赖于系统的时间限制。
mbarrier.test_wait 和 mbarrier.try_wait 测试以下阶段的完成情况:
由 64 位无符号整数操作数
state指定,该值由同一 mbarrier object 上的mbarrier.arrive指令在当前阶段或紧邻前一阶段期间返回。或者由 32 位无符号整数操作数
phaseParity指示,其整数奇偶性表示 mbarrier object 的当前阶段或紧邻前一阶段。
指令的 .parity 变体测试由操作数 phaseParity 的整数奇偶性所指示的阶段是否已完成,该奇偶性表示 mbarrier object 的当前阶段或紧邻前一阶段。偶数阶段的整数奇偶性为 0,奇数阶段的整数奇偶性为 1。
注:使用指令的 .parity 变体要求在整个生命周期内跟踪 mbarrier object 的阶段。
test_wait 和 try_wait 操作仅在以下情况下有效:
当前未完成的阶段,此时
waitComplete返回False。紧邻前一阶段,此时
waitComplete返回True。
限定符 .phase_type::* 指定要测试其操作完成情况的确切阶段。可能的组合及其语义总结如下:
未指定
.phase_type::*:检查 primary 阶段是否已完成。.phase_type::primary检查 primary 阶段是否已完成,并设置reportPredicate和reportValue。注意,当waitComplete为False时,reportPredicate和reportValue操作数是未定义的。对于.layout::v0,reportPredicate和reportValue始终为零。.phase_type::conditional要求使用.parity限定符,并检查 conditional 阶段是否已完成,该阶段可能独立于 primary 阶段完成。对于.layout::v0,primary 阶段与 conditional 阶段同时完成。
操作数 reportValue 的类型必须为 .b8。
如果未指定状态空间,则使用 通用寻址。如果 addr 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
操作数 addr 支持的寻址模式如 作为操作数的地址 中所述。操作数 addr 的对齐要求如 mbarrier 对象的大小与对齐 中所述。
当带 .acquire 限定符的 mbarrier.test_wait 和 mbarrier.try_wait 操作返回 True 时,它们构成 acquire 模式,如 内存一致性模型 中所述。
可选的 .sem 限定符指定内存同步效果,如 内存一致性模型 中所述。如果缺少 .sem 限定符,则默认假定为 .acquire。.relaxed 限定符不提供任何内存排序语义和可见性保证。
可选的 .scope 限定符指示 mbarrier.test_wait 和 mbarrier.try_wait 指令能够直接同步的线程集合。如果未指定 .scope 限定符,则默认为 .cta。相比之下,.shared::<scope> 指示 mbarrier 所在的状态空间。
限定符 .sem 与 .scope 必须一起指定。
当具有 acquire 语义的 mbarrier.test_wait 或 mbarrier.try_wait 返回 True 时,对执行线程而言,以下内存操作顺序成立:
在已完成阶段期间,由 CTA 的参与线程按程序顺序在具有 release 语义的
mbarrier.arrive之前请求的所有内存访问(异步拷贝 除外)都已执行,并且对执行线程可见。在已完成阶段期间,由 CTA 的参与线程按程序顺序在
cp.async.mbarrier.arrive之前请求的所有 cp.async 操作都已执行,并且对执行线程可见。在已完成阶段期间,由 CTA 的参与线程按程序顺序在具有 release 语义的
mbarrier.arrive之前请求的、使用同一 mbarrier object 的所有cp.async.bulk异步操作都已执行,并且对执行线程可见。在程序顺序中位于
mbarrier.test_wait或mbarrier.try_wait之后请求的所有内存访问都不会被执行,也不会对参与该mbarrier的其他线程按程序顺序在具有 release 语义的mbarrier.arrive之前执行的内存访问可见。对于线程按程序顺序在具有 release 语义的
mbarrier.arrive之后、且在mbarrier.test_wait之前请求的内存访问,不存在排序和可见性保证。
示例
// Example 1a, thread synchronization with test_wait:
.reg .b64 %r1;
.shared .b64 shMem;
mbarrier.init.shared.b64 [shMem], N; // N threads participating in the mbarrier.
…
mbarrier.arrive.shared.b64 %r1, [shMem]; // N threads executing mbarrier.arrive
// computation not requiring mbarrier synchronization…
waitLoop:
mbarrier.test_wait.phase_type::primary.shared.b64 complete, [shMem], %r1;
@!complete nanosleep.u32 20;
@!complete bra waitLoop;
// Example 1b, thread synchronization with try_wait :
.reg .b64 %r1;
.shared .b64 shMem;
mbarrier.init.layout::v0.shared.b64 [shMem], N; // N threads participating in the mbarrier.
…
mbarrier.arrive.shared.b64 %r1, [shMem]; // N threads executing mbarrier.arrive
// computation not requiring mbarrier synchronization…
waitLoop:
mbarrier.try_wait.phase_type::primary.relaxed.cluster.shared.b64 complete, [shMem], %r1;
@!complete bra waitLoop;
// Example 2, thread synchronization using phase parity :
.reg .b32 i, parArg;
.reg .b64 %r1;
.shared .b64 shMem;
mov.b32 i, 0;
mbarrier.init.shared.b64 [shMem], N; // N threads participating in the mbarrier.
…
loopStart : // One phase per loop iteration
…
mbarrier.arrive.shared.b64 %r1, [shMem]; // N threads
…
and.b32 parArg, i, 1;
waitLoop:
mbarrier.test_wait.parity.shared.b64 complete, [shMem], parArg;
@!complete nanosleep.u32 20;
@!complete bra waitLoop;
…
add.u32 i, i, 1;
setp.lt.u32 p, i, IterMax;
@p bra loopStart;
// Example 3, Asynchronous copy completion waiting :
.reg .b64 state;
.shared .b64 shMem2;
.shared .b64 shard1, shard2;
.global .b64 gbl1, gbl2;
mbarrier.init.shared.b64 [shMem2], threadCount;
…
cp.async.ca.shared.global [shard1], [gbl1], 4;
cp.async.cg.shared.global [shard2], [gbl2], 16;
// Absence of .noinc accounts for arrive-on from prior cp.async operation
cp.async.mbarrier.arrive.shared.b64 [shMem2];
…
mbarrier.arrive.shared.b64 state, [shMem2];
waitLoop:
mbarrier.test_wait.shared::cta.b64 p, [shMem2], state;
@!p bra waitLoop;
// Example 4, Synchronizing the CTA0 threads with cluster threads
.reg .b64 %r1, addr, remAddr;
.shared .b64 shMem;
cvta.shared.u64 addr, shMem;
mapa.u64 remAddr, addr, 0; // CTA0’s shMem instance
// One thread from CTA0 executing the below initialization operation
@p0 mbarrier.init.shared::cta.b64 [shMem], N; // N = no of cluster threads
barrier.cluster.arrive;
barrier.cluster.wait;
// Entire cluster executing the below arrive operation
mbarrier.arrive.release.cluster.b64 _, [remAddr];
// computation not requiring mbarrier synchronization …
// Only CTA0 threads executing the below wait operation
waitLoop:
mbarrier.try_wait.parity.acquire.cluster.shared::cta.b64 complete, [shMem], 0;
@!complete bra waitLoop;
// Example 5 Tracking success-status of asynchronous operation using mbarrier.test_wait:
.reg .b64 %r1;
.shared .b64 shMem;
mbarrier.init.layout::v1.shared::cta.b64 [shMem], N; // N threads participating in the mbarrier
…
// computation that issues asynchronous operation specifying report mechanism on mbarrier located at shMem
…
waitLoop:
mbarrier.test_wait.phase_type::primary.shared::cta.b64 complete|reportPred, reportValue, [shMem], %r1;
@!complete nanosleep.u32 20;
@!complete bra waitLoop;
@reportPred bra noSuccess;
// asynchronous operation completed successfully
…
exit;
noSuccess:
// Handle unsuccessful asynchronous operation
// Inspect reportVal for more details
// Example 6 Tracking successful completion of asynchronous operation by waiting on conditional phase:
.reg .b64 %r1;
.reg .b32 parity, timeHint;
.shared .b64 shMem;
mbarrier.init.layout::v1.shared::cta.b64 [shMem], N; // N threads participating in the mbarrier
…
// computation that issues asynchronous operation specifying report mechanism on mbarrier located at shMem
…
waitLoop:
mbarrier.try_wait.parity.phase_type::conditional.relaxed.cluster.shared::cta.b64 complete, [shMem], parity, timeHint;
@!complete bra waitLoop;
// asynchronous operation completed successfully
9.7.15.16.20. 并行同步与通信指令:mbarrier.pending_count#
mbarrier.pending_count
从不透明的 mbarrier 状态中查询待到达计数。
语法
mbarrier.pending_count{.layout}.b64 count, state;
.layout = { .layout::v0 }
说明
可以使用 mbarrier.pending_count 从不透明的 mbarrier 状态中查询待到达计数。
state 操作数是一个 64 位寄存器,必须是先前的 mbarrier.arrive.noComplete 或 mbarrier.arrive_drop.noComplete 指令的结果。否则,行为未定义。
目标寄存器 count 是一个 32 位无符号整数,表示 mbarrier object 在获得 state 寄存器的那个 arrive-on 操作 之前的待到达计数。可选限定符 .layout::v0 表示相应 mbarrier 对象的布局,如 mbarrier 对象的布局 一节所述。
示例
.reg .b32 %r1;
.reg .b64 state;
.shared .b64 shMem;
mbarrier.arrive.noComplete.b64 state, [shMem], 1;
mbarrier.pending_count.layout::v0.b64 %r1, state;
9.7.15.16.21. 并行同步与通信指令:mbarrier.check_layout#
mbarrier.check_layout
检查 mbarrier object 的布局。
语法
mbarrier.check_layout.layout{.ss}.b64 p, [addr];
.layout = { .layout::v0, .layout::v1 }
.ss = { .shared::cta }
说明
可以使用 mbarrier.check_layout 查询不透明的 mbarrier object 的布局。
地址操作数 addr 指定正在检查其布局的 mbarrier 对象的内存位置。如果 mbarrier 对象的布局与 .layout 限定符完全匹配,该指令将谓词操作数 p 设置为 True。更多细节请参阅 mbarrier 对象的布局。
如果未指定状态空间,则使用 通用寻址。如果 addr 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
示例
.reg .pred p;
.shared .b64 shMem;
mbarrier.check_layout.layout::v1.shared::cta.b64 p, [shMem];
@!p bra exit
// … mbarrier operations on shMem
exit: ret;
9.7.15.17. 并行同步与通信指令:tensormap.cp_fenceproxy#
tensormap.cp_fenceproxy
一种融合的复制与栅栏操作。
语法
tensormap.cp_fenceproxy.cp_qualifiers.fence_qualifiers.sync.aligned [dst], [src], size;
.cp_qualifiers = { .global.shared::cta }
.fence_qualifiers = { .to_proxy::from_proxy.release.scope }
.to_proxy::from_proxy = { .tensormap::generic }
.scope = { .cta, .cluster, .gpu , .sys }
说明
tensormap.cp_fenceproxy 指令按顺序执行以下操作:
在通用代理中,将
size参数所指定大小(以字节为单位)的数据,从共享内存中由地址操作数src所指定的位置复制到全局内存中由地址操作数dst所指定的位置。在从该复制操作到随后在 tensormap 代理中针对地址
dst所执行的访问之间的顺序上,建立一种单向代理释放模式(proxy release pattern)。
立即数操作数 size 的有效值为 128。
操作数 src 与 dst 分别指定 shared::cta 与 global 状态空间中的非通用地址。
.scope 限定符指定可以直接观察到该操作的代理同步效果的线程集合,如内存一致性模型 中所述。
必需的 .sync 限定符表示 tensormap.cp_fenceproxy 会使执行线程等待,直到 warp 中所有线程都执行同一条 tensormap.cp_fenceproxy 指令之后才恢复执行。
必需的 .aligned 限定符表示 warp 中所有线程必须执行同一条 tensormap.cp_fenceproxy 指令。在条件执行的代码中,只有当已知 warp 中所有线程对条件的求值结果完全相同时,才应使用对齐的 tensormap.cp_fenceproxy 指令,否则行为未定义。
示例
// Example: manipulate a tensor-map object and then consume it in cp.async.bulk.tensor
.reg .b64 new_addr;
.global .align 128 .b8 gbl[128];
.shared .align 128 .b8 sMem[128];
cp.async.bulk.shared::cluster.global.mbarrier::complete_tx::bytes [sMem], [gMem], 128, [mbar];
…
try_wait_loop:
mbarrier.try_wait.shared.b64 p, [mbar], state;
@!p bra try_wait loop;
tensormap.replace.tile.global_address.shared.b1024.b64 [sMem], new_addr;
tensormap.cp_fenceproxy.global.shared::cta.tensormap::generic.release.gpu.sync.aligned
[gbl], [sMem], 128;
fence.proxy.tensormap::generic.acquire.gpu [gbl], 128;
cp.async.bulk.tensor.1d.shared::cluster.global.tile [addr0], [gbl, {tc0}], [mbar0];
9.7.15.18. 并行同步与通信指令:clusterlaunchcontrol.try_cancel#
clusterlaunchcontrol.try_cancel
请求取消尚未启动的 cluster。
语法
clusterlaunchcontrol.try_cancel.async{.space}.completion_mechanism{.multicast::cluster::all}.b128 [addr], [mbar];
.completion_mechanism = { .mbarrier::complete_tx::bytes };
.space = { .shared::cta };
说明
clusterlaunchcontrol.try_cancel 指令请求以原子方式取消一个尚未开始运行的 cluster 的启动。它会以异步方式向共享内存写入一个不透明响应,指示该操作是成功还是失败。该异步操作的完成情况通过 .cluster 作用域下的 mbarrier 完成机制来跟踪。该指令使用通用代理访问其 mbarrier 操作数。
成功时,该不透明响应包含被取消 cluster 的第一个 CTA 的 ctaid;同一 grid 中其他 clusterlaunchcontrol.try_cancel 操作所产生的其他成功响应都不会包含该 id。
必需的 .async 限定符表示该指令将异步地发起取消操作,并且在该请求的操作完成之前控制权就会返回到执行线程。
若指定了 .space 限定符,则操作数 addr 和 mbar 都必须位于 .shared::cta 状态空间中。否则,将假定两者都使用通用寻址。若任一地址操作数不落在 .shared::cta 的地址窗口内,则结果未定义。
限定符 .completion_mechanism 指定:在异步操作完成时,将对该操作数 mbar 所指定的 mbarrier 对象执行 complete-tx 操作,其 completeCount 参数等于所存储数据的字节量。
随后,执行线程可以使用 mbarrier 指令 来等待该异步操作的完成。内存一致性模型 中所述的其他任何同步机制都不能用于保证异步拷贝操作的完成。
.multicast::cluster::all 限定符表示,该响应通过弱异步代理写(weak async-proxy writes)被异步写入发起请求的 cluster 中每个 CTA 的对应本地共享内存 addr。对某一特定 CTA 的 addr 的写操作的完成,通过向该 CTA 共享内存上的 mbarrier 对象执行一次 complete-tx 操作来通知。
若 cluster 中有任何 CTA 已退出,则带 .multicast::cluster::all 限定符的指令的行为未定义。
操作数 addr 指定写入该请求响应的 16 字节宽共享内存位置的自然对齐地址。
clusterlaunchcontrol.try_cancel 指令的响应将是一个 16 字节的不透明值,并将在操作数 addr 所指定的位置可用。将该响应加载到 16 字节寄存器后,可使用 clusterlaunchcontrol.query_cancel 指令检查请求是否成功,并取回被取消 cluster 的第一个 CTA 的 ctaid。
若执行 CTA 已经观察到某个 clusterlaunchcontrol.try_cancel 指令的完成结果为失败,则再发出后续 clusterlaunchcontrol.try_cancel 指令的行为未定义。
示例
// Assumption: 1D cluster (cluster_ctaid.y/.z == 1) with 1 thread per CTA.
// Current Cluster to be processed: initially the launched cluster:
mov.b32 xctaid, %ctaid.x;
// Establish full synchronization across all CTAs of the cluster for the first iteration.
// Weaker synchronization may suffice depending on initialization sequence.
barrier.cluster.arrive;
barrier.cluster.wait;
// Iteration loop over all cluster CTAs
processCluster:
mov.u32 %r0, %tid.x;
setp.u32.eq p0, %r0, 0x0;
// Elect a leader thread (thread idx 0) for each CTA to arrive and expect_tx at
// each CTA local shared memory barrier:
mov.u32 %r0, %tid.x;
setp.u32.eq p0, %r0, 0x0;
// All other threads skip to processing the work of the current cluster:
@!p0 bra processCurrentCluster;
// All CTAs in the cluster arrive at their local SMEM barrier and set 16B handle tx count:
mbarrier.arrive.expect_tx.cluster.relaxed.shared::cta.b64 state, [mbar], 16;
// First CTA in Cluster attempts to cancel a not-yet-started cluster:
mov.u32 %r0, %cluster_ctaid.x;
setp.u32.eq p0, %r0, 0x0;
@p0 clusterlaunchcontrol.try_cancel.async.mbarrier::complete_tx::bytes.multicast::cluster::all.b128 [addr], [mbar];
processCurrentCluster:
// …process current cluster (“xctaid”) while cancellation request for next cluster runs asynchronously…
// After processing current cluster, wait on cancellation request response for next cluster via specified mbarrier:
waitLoop:
// .acquire prevents weak handle read (“ld.shared handle, [addr]”) from overtaking this mbarrier.try_wait:
mbarrier.try_wait.cluster.acquire.shared::cta.b64 complete, [mbar], state;
@!complete bra waitLoop;
// Cancellation request has completed.
// Generic-proxy weak read of cancellation request into 16-byte wide register:
ld.shared.b128 handle, [addr];
// Check whether cancellation succeeded:
clusterlaunchcontrol.query_cancel.is_canceled.pred.b128 p, handle;
// If cancellation request failed, we couldn’t cancel any other cluster, so all current cluster CTAs exit.
@!p ret;
// Otherwise, cancellation request succeeded.
// Extract “ctaid” of first cancelled-cluster CTA which we’ll process in next “processCluster” loop iteration:
@p clusterlaunchcontrol.query_cancel.get_first_ctaid.v4.b32.b128 {xctaid, _, _, _}, handle;
// Release current iteration generic-proxy weak read of handle (“ld.shared handle, [addr]”)
// before next iteration async-proxy write to handle (“clusterlaunchcontrol.try_cancel [addr]”)
fence.proxy.async::generic.release.sync_restrict::shared::cta.cluster;
// Arrive and wait at the next iteration cluster barrier with relaxed semantics.
barrier.cluster.arrive.relaxed;
barrier.cluster.wait;
// Acquire prior iteration generic-proxy weak read of handle (“ld.shared handle, [addr]”)
// before current iteration async-proxy write to handle (“clusterlaunchcontrol.try_cancel [addr]”)
fence.proxy.async::generic.acquire.sync_restrict::shared::cluster.cluster;
bra processCluster;
9.7.15.19. 并行同步与通信指令:clusterlaunchcontrol.query_cancel#
clusterlaunchcontrol.query_cancel
查询 clusterlaunchcontrol.try_cancel 操作的响应。
语法
clusterlaunchcontrol.query_cancel.is_canceled.pred.b128 pred, try_cancel_response;
clusterlaunchcontrol.query_cancel.get_first_ctaid.v4.b32.b128 {xdim, ydim, zdim, _}, try_cancel_response;
clusterlaunchcontrol.query_cancel.get_first_ctaid{::dimension}.b32.b128 reg, try_cancel_response;
::dimension = { ::x, ::y, ::z };
说明
指令 clusterlaunchcontrol.query_cancel 可用于解码由指令 clusterlaunchcontrol.try_cancel 写入的不透明响应。
从 clusterlaunchcontrol.try_cancel 指令将响应加载到 16 字节寄存器后,可以进一步使用 clusterlaunchcontrol.query_cancel 指令对其进行查询,方式如下:
clusterlaunchcontrol.query_cancel.is_canceled.pred.b128:若 cluster 被成功取消,则谓词 p 被置为 true;否则被置为 false。
若请求成功,则指令 clusterlaunchcontrol.query_cancel.get_first_ctaid 提取被取消 cluster 中第一个 CTA 的 CTA id。默认情况下,该指令返回一个 .v4 向量,其前三个元素分别是被取消 cluster 中第一个 CTA 的 x、y 和 z 坐标。第 4 个元素的内容未作规定。可以使用显式的 .get_first_ctaid::x、.get_first_ctaid::y 或 .get_first_ctaid::z 限定符,将单个 x、y 或 z 坐标提取到 32 位寄存器中。
若请求失败,则 clusterlaunchcontrol.query_cancel.get_first_ctaid 的行为未定义。
示例
clusterlaunchcontrol.query_cancel.is_canceled pred.b128 p, handle;
@p clusterlaunchcontrol.query_cancel.get_first_ctaid.v4.b32.b128 {xdim, ydim, zdim, ignr} handle;
clusterlaunchcontrol.query_cancel.get_first_ctaid::x.b32.b128 reg0, handle;
clusterlaunchcontrol.query_cancel.get_first_ctaid::y.b32.b128 reg1, handle;
clusterlaunchcontrol.query_cancel.get_first_ctaid::z.b32.b128 reg2, handle;
9.7.16. Warp 级矩阵乘加指令#
矩阵乘加运算具有如下形式:
D = A * B + C
其中 D 与 C 称为累加器,并且可以指代同一个矩阵。
PTX 提供两种执行矩阵乘加计算的方式:
-
使用
wmma指令:-
这种 warp 级计算由 warp 中的所有线程按如下方式协作完成:
使用
wmma.load操作将矩阵 A、B 和 C 从内存加载到寄存器中。当该操作完成时,每个线程中的目标寄存器持有已加载矩阵的一个 fragment。对已加载的矩阵使用
wmma.mma操作执行矩阵乘加运算。当该操作完成时,每个线程中的目标寄存器持有wmma.mma操作所返回结果矩阵的一个 fragment。使用
wmma.store操作将结果矩阵 D 存回内存。或者,结果矩阵 D 也可以作为后续wmma.mma操作的参数 C 使用。
wmma.load和wmma.store指令在为wmma.mma操作从内存加载输入矩阵时,以及在将结果存回内存时,会隐式处理矩阵元素的组织方式。
-
-
使用
mma指令:与
wmma类似,mma也要求计算由 warp 中的所有线程协作完成,不过在调用mma操作之前,需要显式完成矩阵元素在不同线程之间的分布。mma指令同时支持稠密矩阵 A 以及稀疏矩阵 A。当 A 是结构化稀疏矩阵时,可以使用稀疏变体,如稀疏矩阵存储所述。
9.7.16.1. 矩阵形状#
矩阵乘加运算对操作数矩阵 A、B 和 C 仅支持有限的一组形状。三个矩阵操作数的形状由元组 MxNxK 共同描述,其中 A 是 MxK 矩阵,B 是 KxN 矩阵,而 C 和 D 是 MxN 矩阵。
以下矩阵形状在指定的类型下受支持:
指令 |
缩放 |
稀疏性 |
被乘数数据类型 |
形状 |
PTX ISA 版本 |
|---|---|---|---|---|---|
|
NA |
稠密 |
浮点 - |
|
PTX ISA 6.0 版 |
|
稠密 |
其他浮点格式 - |
|
PTX ISA 7.0 版 |
|
|
稠密 |
其他浮点格式 - |
|
PTX ISA 7.0 版 |
|
|
稠密 |
整数 - |
|
PTX ISA 6.3 版 |
|
|
稠密 |
子字节整数 - |
|
PTX ISA 6.3 版 |
|
|
稠密 |
单比特 - |
|
PTX ISA 6.3 版 |
|
|
NA |
稠密 |
浮点 - |
|
PTX ISA 7.0 版 |
|
PTX ISA 7.8 版 |
||||
|
稠密 |
浮点 - |
|
PTX ISA 6.4 版 |
|
|
PTX ISA 6.5 版 |
||||
|
PTX ISA 7.0 版 |
||||
|
稠密 |
其他浮点格式 - |
|
PTX ISA 7.0 版 |
|
|
稠密 |
其他浮点格式 - |
|
PTX ISA 7.0 版 |
|
|
稠密 |
整数 - |
|
PTX ISA 6.5 版 |
|
|
PTX ISA 7.0 版 |
||||
|
稠密 |
子字节整数 - |
|
PTX ISA 6.5 版 |
|
|
PTX ISA 7.0 版 |
||||
|
稠密 |
单比特 - |
|
PTX ISA 7.0 版 |
|
|
稠密 |
其他浮点格式 - |
|
PTX ISA 8.4 版 |
|
|
稠密 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
|
|
稠密 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
|
|
是 |
稠密 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
|
稠密 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
|
|
NA |
稀疏 |
浮点 - |
|
PTX ISA 7.1 版 |
|
稀疏 |
其他浮点格式 - |
|
PTX ISA 7.1 版 |
|
|
稀疏 |
其他浮点格式 - |
|
PTX ISA 7.1 版 |
|
|
稀疏 |
整数 - |
|
PTX ISA 7.1 版 |
|
|
稀疏 |
子字节整数 - |
|
PTX ISA 7.1 版 |
|
|
稀疏 |
其他浮点格式 - |
|
PTX ISA 8.4 版 |
|
|
带有序元数据的稀疏 |
浮点 - |
|
PTX ISA 8.5 版 |
|
|
带有序元数据的稀疏 |
其他浮点格式 - |
|
PTX ISA 8.5 版 |
|
|
带有序元数据的稀疏 |
其他浮点格式 - |
|
PTX ISA 8.5 版 |
|
|
带有序元数据的稀疏 |
整数 - |
|
PTX ISA 8.5 版 |
|
|
带有序元数据的稀疏 |
子字节整数 - |
|
PTX ISA 8.5 版 |
|
|
带有序元数据的稀疏 |
其他浮点格式 - |
|
PTX ISA 8.5 版 |
|
|
带有序元数据的稀疏 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
|
|
是 |
带有序元数据的稀疏 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
|
带有序元数据的稀疏 |
其他浮点格式 - |
|
PTX ISA 8.7 版 |
9.7.16.2. 矩阵数据类型#
矩阵乘加运算分别在整数、浮点、子字节整数和单比特数据类型上受支持。所有操作数必须包含相同的基本类型种类,即整数或浮点。
对于浮点矩阵乘加运算,不同的矩阵操作数可以具有不同的精度,如下文所述。
数据类型 |
被乘数(A 或 B) |
累加器(C 或 D) |
|---|---|---|
整数 |
|
|
浮点 |
|
|
其他浮点 |
|
|
其他浮点 |
|
|
其他浮点 |
|
|
带缩放的其他浮点 |
|
|
带缩放的其他浮点 |
|
|
浮点 |
|
|
子字节整数 |
both |
|
单比特整数 |
|
|
9.7.16.3. mma.sync 的块缩放#
带有以下 .kind 限定符的 mma 指令:
.kind::mxf8f6f4.kind::mxf4.kind::mxf4nvf4
执行带块缩放的矩阵乘法。该运算具有以下形式:D = (A * scale_A) * (B * scale_B) + C。
对于形状为 M x SFA_N 的 scale_A 矩阵,矩阵 A 的每一行被划分为 SFA_N 个块,一行的每个块与 scale_A 同一行中对应的元素(以下称为 SF_A)相乘。
类似地,对于形状为 SFB_M x N 的 scale_B 矩阵,矩阵 B 的每一列被划分为 SFB_M 个块,一列的每个块与 scale_B 同一列中对应的元素(以下称为 SF_B)相乘。
图 45 展示了具有 scale_vec::2X 块缩放的 mma 示例。
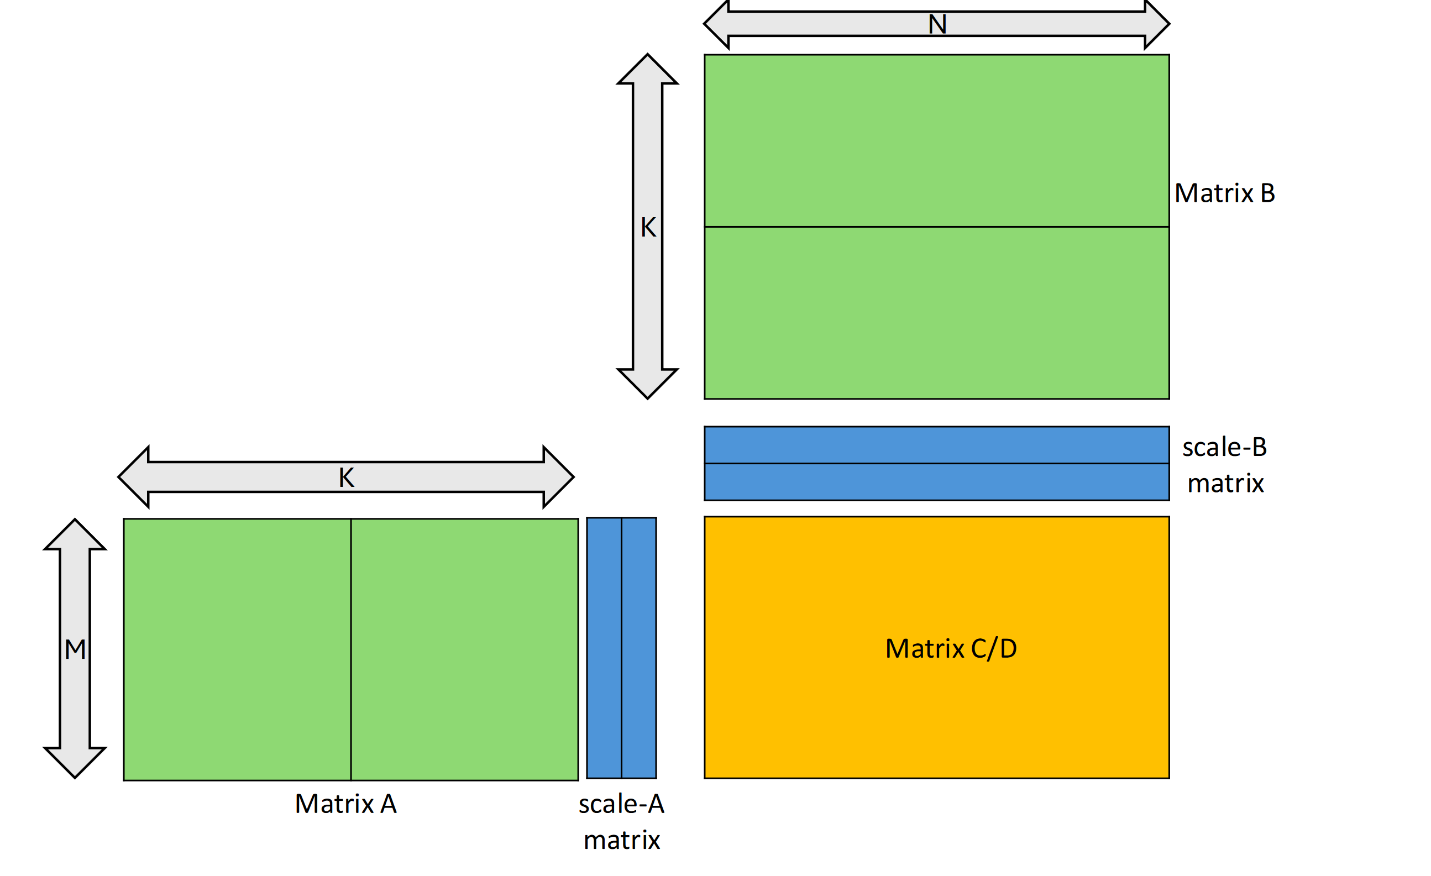
图 45 具有 .scale_vec::2X 块缩放的 mma
scale_A 和 scale_B 矩阵的形状取决于限定符 .scale_vec_size,如 表 44 所示。
.scale_vec_size |
scale_A 的形状 |
scale_B 的形状 |
|---|---|---|
|
M x 1 |
1 x N |
|
M x 2 |
2 x N |
|
M x 4 |
4 x N |
精确元素类型与 .scale_vec_size 的有效组合列于 表 45。
.kind::* |
元素数据类型 .atype 和 .btype |
缩放数据类型 .stype |
.scale_vec_size |
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
scale-a-data 和 scale-b-data 参数分别提供 scale_A 和 scale_B 矩阵的元数据。元组 {byte-id-a, thread-id-a} 和 {byte-id-b, thread-id-b} 提供选择器信息,用于从对应的元数据参数 scale-a-data 和 scale-b-data 中选择元素 SF_A 和 SF_B。元组 {byte-id-a, thread-id-a} 允许从 scale-a-data 中选择缩放矩阵元素 SF_A。类似地,元组 {byte-id-b, thread-id-b} 允许从 scale-b-data 中选择缩放矩阵元素 SF_B。
分量 thread-id-a、thread-id-b 决定 quad 中哪些线程提供 SF_A 和 SF_B 值。以下列表描述线程选择器分量 thread-id-a、thread-id-b 的影响:
-
由
thread-id-a确定的 quad 中的一个线程对提供 SF_A 值。值为 0 选择 quad 中低位的两个线程,而值为 1 选择高位的两个线程。换言之,当thread-id-a设为 0 时,满足%laneid% 4 == 0 或 1 的线程对提供 SF_A。相反,当thread-id-a设为 1 时,满足%laneid% 4 == 2 或 3 的线程对提供 SF_A。更多细节参见 图 46。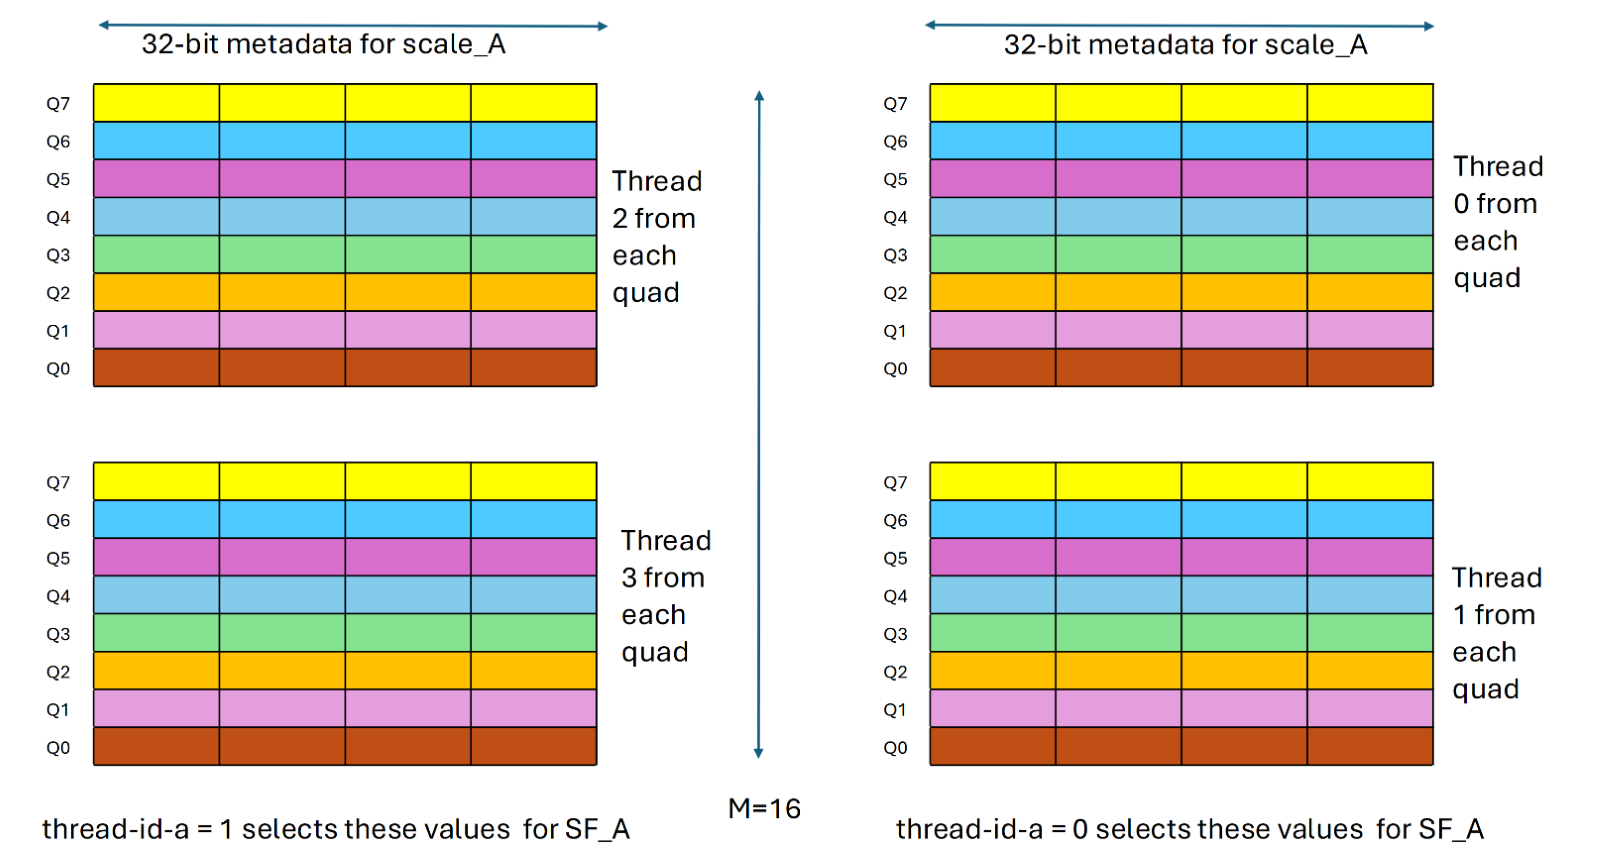
图 46 基于
thread-id-a选择 SF_A 的值集合 -
由
thread-id-b确定的 quad 中的一个线程提供 SF_B 值。换言之,满足%laneid% 4 ==thread-id-b的每个线程提供 SF_B。更多细节参见 图 47。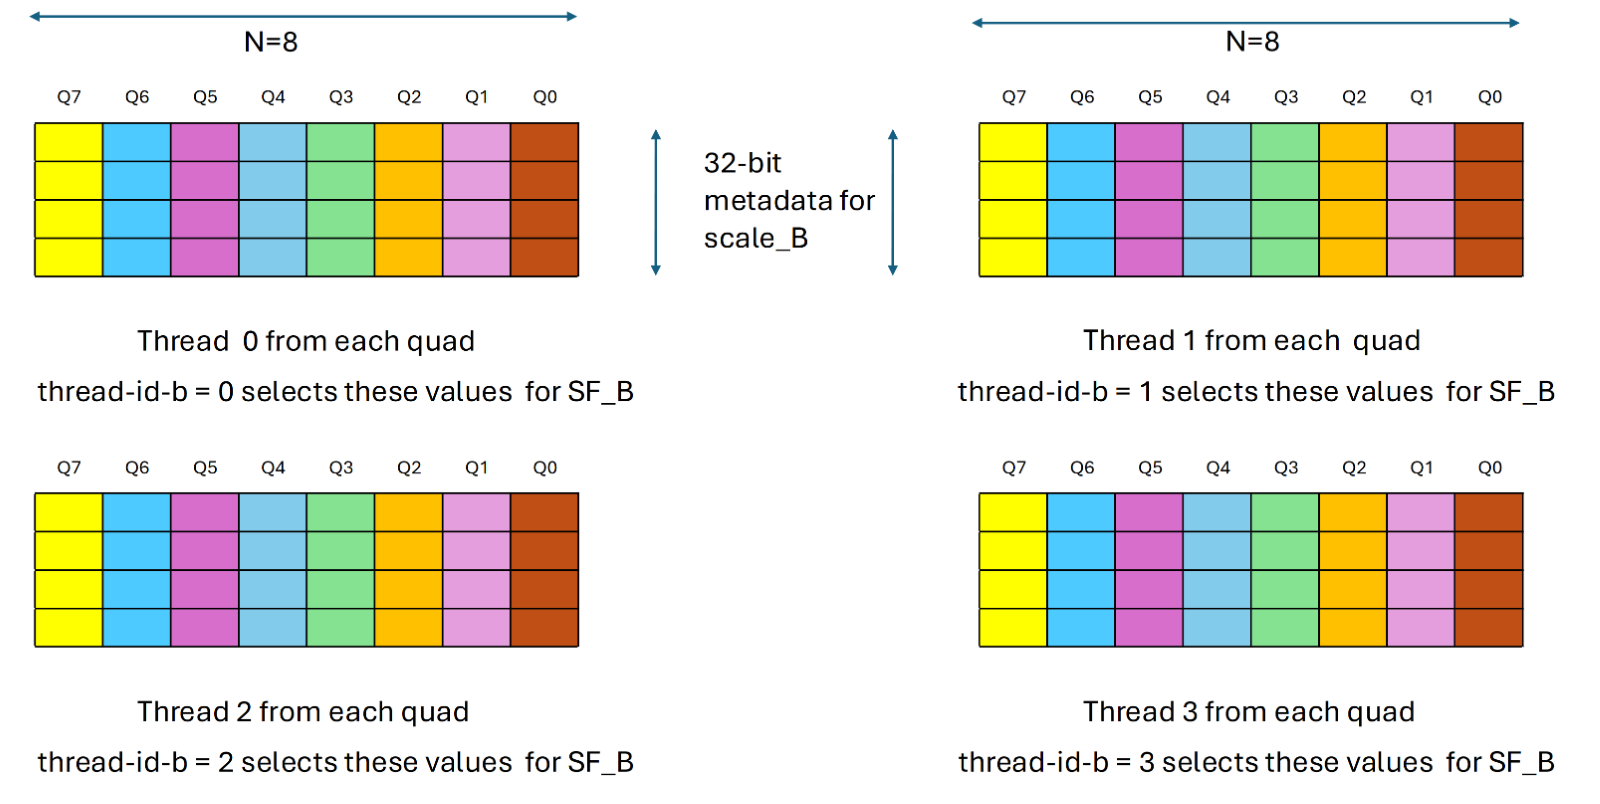
图 47 基于
thread-id-b选择 SF_B 的值集合
参数 byte-id-a、byte-id-b 选择 scale-a-data、scale-b-data 中哪些字节提供 SF_A 和 SF_B 值。以下列表描述 .scale_vec_size 限定符对字节选择器分量 byte-id-a、byte-id-b 的影响:
-
当
.scale_vec_size为.scale_vec::1X时由
byte-id-a、byte-id-b分别在scale-a-data和scale-b-data中确定的一个字节提供 SF_A 和 SF_B 值。
-
当
.scale_vec_size为.scale_vec::2X时由
byte-id-a和byte-id-b确定的scale-a-data和scale-b-data中的一个字节对(两个字节)提供 SF_A 和 SF_B 值。值为 0 选择对应的元数据值中的低两个字节,而值为 2 选择高两个字节。
-
当
.scale_vec_size为.scale_vec::4X时scale-a-data和scale-b-data中的所有四个字节都提供值。因此,byte-id-a、byte-id-b必须为零。
更多细节参见 图 48。
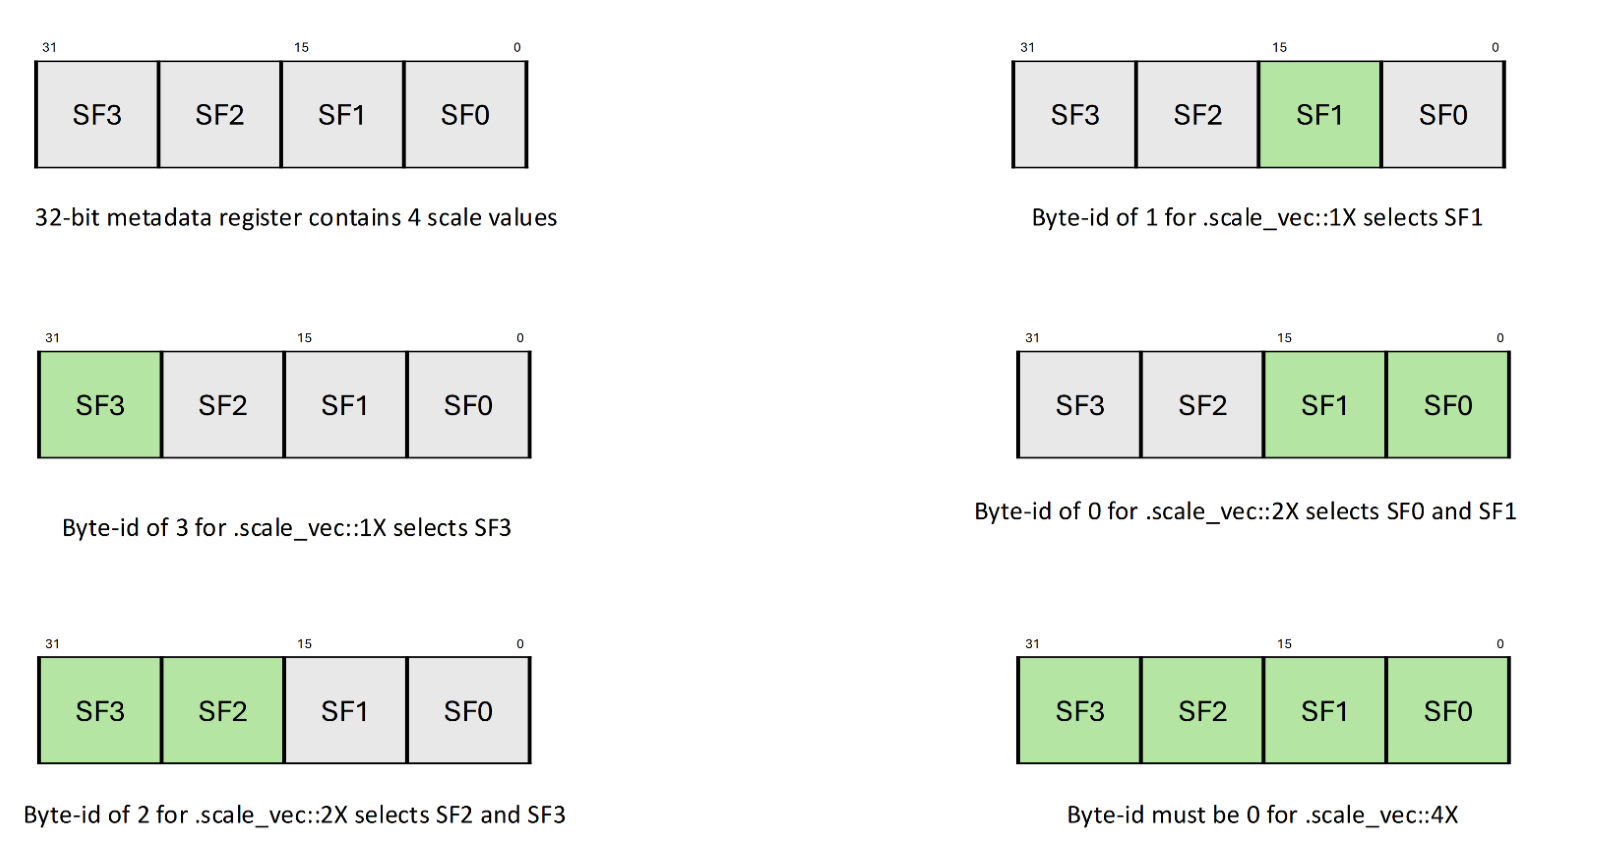
图 48 基于 byte-id-a 或 byte-id-b 选择 SF_A 或 SF_B 的值集合
表 46 列举了各种选择器分量的有效值。任何其他值都会导致未定义行为。
.scale_vec_size |
选择器分量 |
|||
|---|---|---|---|---|
byte-id-a |
thread-id-a |
byte-id-b |
thread-id-b |
|
|
[0, 1, 2, 3] |
[0, 1] |
[0, 1, 2, 3] |
[0, 1, 2, 3] |
|
[0, 2] |
[0, 2] |
||
|
0 |
0 |
||
9.7.16.4. 使用 wmma 指令的矩阵乘加运算#
本节介绍 warp 级 wmma.load, wmma.mma 和 wmma.store 指令,以及这些指令所涉及的各种矩阵的组织方式。
9.7.16.4.1. WMMA 的矩阵片段#
warp 中的每个线程持有矩阵的一个片段。warp 中各线程所加载片段的分布是未指定的,且依赖于目标架构,因此片段在矩阵中的具体身份也是未指定的,并依赖于目标架构。如果底层矩阵的形状、布局和元素类型匹配,则 wmma 操作返回的片段可用作另一个 wmma 操作的操作数。由于片段布局依赖于架构,将一个函数中 wmma 操作返回的片段用作另一函数中 wmma 操作的操作数时,如果这两个函数被链接在一起但针对不同的链接兼容 SM 架构编译,则可能无法按预期工作。注意,将 wmma 片段传递给具有 .weak 链接的函数是不安全的,因为在链接时对此类函数的引用可能被解析到不同编译模块中的函数。
每个片段都是一个向量表达式,其内容按如下方式确定。片段中各矩阵元素的具体身份是未指定的。
整数片段
被乘数(A 或 B):
数据类型 |
形状 |
矩阵 |
片段 |
|---|---|---|---|
|
|
A |
由两个 |
B |
由两个 |
||
|
A |
包含单个 |
|
B |
由四个 |
||
|
A |
由四个 |
|
B |
包含单个 |
累加器(C 或 D):
数据类型 |
形状 |
片段 |
|---|---|---|
|
|
由八个 |
|
||
|
浮点片段
数据类型 |
矩阵 |
片段 |
|---|---|---|
|
A 或 B |
由八个 |
|
C 或 D |
由四个 |
|
由八个 |
用于 .bf16 数据格式的浮点片段
被乘数(A 或 B):
数据类型 |
形状 |
矩阵 |
片段 |
|---|---|---|---|
|
|
A |
由四个 |
B |
|||
|
A |
包含两个 |
|
B |
由八个 |
||
|
A |
由八个 |
|
B |
包含两个 |
累加器(C 或 D):
数据类型 |
矩阵 |
片段 |
|---|---|---|
|
C 或 D |
包含八个 |
用于 .tf32 数据格式的浮点片段
被乘数(A 或 B):
数据类型 |
形状 |
矩阵 |
片段 |
|---|---|---|---|
|
|
A |
由四个 |
B |
由四个 |
累加器(C 或 D):
数据类型 |
形状 |
矩阵 |
片段 |
|---|---|---|---|
|
|
C 或 D |
包含八个 |
双精度浮点片段
被乘数(A 或 B):
数据类型 |
形状 |
矩阵 |
片段 |
|---|---|---|---|
|
|
A 或 B |
由单个 |
累加器(C 或 D):
数据类型 |
形状 |
矩阵 |
片段 |
|---|---|---|---|
|
|
C 或 D |
包含单个 |
次字节整数和单比特片段
被乘数(A 或 B):
数据类型 |
形状 |
片段 |
|---|---|---|
|
|
包含单个 |
|
|
包含单个 |
累加器(C 或 D):
数据类型 |
形状 |
片段 |
|---|---|---|
|
|
由两个 |
|
由两个 |
操作片段内容
可以通过读写片段中的各个寄存器来操作矩阵片段的内容,前提是满足以下条件:
片段中的所有矩阵元素在各线程间以统一方式、使用相同参数进行操作。
矩阵元素的顺序不被改变。
例如,如果与给定矩阵对应的每个寄存器都乘以一个统一的常数值,那么得到的矩阵就只是原矩阵的缩放版本。
注意,不支持 .f16 与 .f32 累加器片段之间任一方向的类型转换。即使片段中元素的顺序保持不变,结果也是未定义的。
9.7.16.4.2. WMMA 的矩阵存储#
每个矩阵都可以按行主序或列主序布局存储在内存中。在行主序格式中,每一行的连续元素存储在连续的内存位置中,该行被称为矩阵的主维度。在列主序格式中,每一列的连续元素存储在连续的内存位置中,该列被称为矩阵的主维度。
主维度(行或列)的连续实例不必在内存中连续存储。wmma.load 和 wmma.store 操作接受一个可选参数 stride,它指定从每一行(或列)开头到下一行(或列)开头的偏移量,以矩阵元素为单位(而不是字节)。例如,wmma 操作访问的矩阵可能是内存中存储的更大矩阵的一个子矩阵。这允许程序员对大于 wmma 操作所支持形状的矩阵组合出乘加运算。
地址对齐
主维度(行或列)的每个实例的起始地址都必须与对应片段的大小(以字节为单位)对齐。注意,起始地址由基指针和可选的 stride 决定。
以下面的指令为例:
wmma.load.a.sync.aligned.row.m16n16k16.f16 {x0,...,x7}, [p], s;
片段大小(字节)= 32(八个
.f16x2类型的元素)实际的
stride(字节)= 2 *s(因为stride以.f16元素为单位指定,而不是字节)-
要使该矩阵的每一行都在片段大小上对齐,必须满足以下条件:
p是 32 的倍数。2*s是 32 的倍数。
stride 的默认值
stride 的默认值是矩阵的主维度大小。例如,对于 MxK 矩阵,行主序布局下 stride 为 K,列主序布局下 stride 为 M。具体而言,受支持的矩阵形状的默认 stride 如下:
形状 |
A(行) |
A(列) |
B(行) |
B(列) |
累加器(行) |
累加器(列) |
|---|---|---|---|---|---|---|
16x16x16 |
16 |
16 |
16 |
16 |
16 |
16 |
8x32x16 |
16 |
8 |
32 |
16 |
32 |
8 |
32x8x16 |
16 |
32 |
8 |
16 |
8 |
32 |
8x8x32 |
32 |
8 |
8 |
32 |
8 |
8 |
8x8x128 |
128 |
8 |
8 |
128 |
8 |
8 |
16x16x8 |
8 |
16 |
16 |
8 |
16 |
16 |
8x8x4 |
4 |
8 |
8 |
4 |
8 |
8 |
9.7.16.4.3. Warp 级矩阵加载指令:wmma.load#
wmma.load
为 WMMA 从内存中协同加载一个矩阵
语法
浮点格式 .f16 加载:
wmma.load.a.sync.aligned.layout.shape{.ss}.atype r, [p] {, stride};
wmma.load.b.sync.aligned.layout.shape{.ss}.btype r, [p] {, stride};
wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride};
.layout = {.row, .col};
.shape = {.m16n16k16, .m8n32k16, .m32n8k16};
.ss = {.global, .shared{::cta}};
.atype = {.f16, .s8, .u8};
.btype = {.f16, .s8, .u8};
.ctype = {.f16, .f32, .s32};
备用浮点格式 .bf16 加载:
wmma.load.a.sync.aligned.layout.shape{.ss}.atype r, [p] {, stride}
wmma.load.b.sync.aligned.layout.shape{.ss}.btype r, [p] {, stride}
wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride}
.layout = {.row, .col};
.shape = {.m16n16k16, .m8n32k16, .m32n8k16};
.ss = {.global, .shared{::cta}};
.atype = {.bf16 };
.btype = {.bf16 };
.ctype = {.f32 };
备用浮点格式 .tf32 加载:
wmma.load.a.sync.aligned.layout.shape{.ss}.atype r, [p] {, stride}
wmma.load.b.sync.aligned.layout.shape{.ss}.btype r, [p] {, stride}
wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride}
.layout = {.row, .col};
.shape = {.m16n16k8 };
.ss = {.global, .shared{::cta}};
.atype = {.tf32 };
.btype = {.tf32 };
.ctype = {.f32 };
双精度浮点 .f64 加载:
wmma.load.a.sync.aligned.layout.shape{.ss}.atype r, [p] {, stride}
wmma.load.b.sync.aligned.layout.shape{.ss}.btype r, [p] {, stride}
wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride}
.layout = {.row, .col};
.shape = {.m8n8k4 };
.ss = {.global, .shared{::cta}};
.atype = {.f64 };
.btype = {.f64 };
.ctype = {.f64 };
子字节加载:
wmma.load.a.sync.aligned.row.shape{.ss}.atype r, [p] {, stride}
wmma.load.b.sync.aligned.col.shape{.ss}.btype r, [p] {, stride}
wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride}
.layout = {.row, .col};
.shape = {.m8n8k32};
.ss = {.global, .shared{::cta}};
.atype = {.s4, .u4};
.btype = {.s4, .u4};
.ctype = {.s32};
单比特加载:
wmma.load.a.sync.aligned.row.shape{.ss}.atype r, [p] {, stride}
wmma.load.b.sync.aligned.col.shape{.ss}.btype r, [p] {, stride}
wmma.load.c.sync.aligned.layout.shape{.ss}.ctype r, [p] {, stride}
.layout = {.row, .col};
.shape = {.m8n8k128};
.ss = {.global, .shared{::cta}};
.atype = {.b1};
.btype = {.b1};
.ctype = {.s32};
说明
由 warp 中的所有线程协同地,从指定状态空间中由地址操作数 p 指示的位置,将一个矩阵加载到目标寄存器 r 中。
如果未给出状态空间,则使用 通用寻址 执行内存访问。wmma.load 操作只能用于 .global 和 .shared 空间,以及通用寻址(此时地址指向 .global 或 .shared 空间)。
互斥限定符 .a、.b 和 .c 分别指示为 wmma 计算加载的是矩阵 A、B 还是 C。
目标操作数 r 是一个用花括号括起的向量表达式,可容纳加载操作返回的 fragment,如 WMMA 的矩阵片段 中所述。
.shape 限定符指示目标 wmma 计算中涉及的所有矩阵参数的维度。
.layout 限定符指示要加载的矩阵是以行主序还是列主序格式存储的。
stride 是一个可选的 32 位整数操作数,它以矩阵元素为单位给出主导维度(行或列)连续实例的起始之间的偏移。stride 的默认值在 WMMA 的矩阵存储 中描述,如果实际值大于默认值则必须指定。例如,如果该矩阵是某个更大矩阵的子矩阵,则 stride 的值就是该更大矩阵的主导维度。指定的值小于默认值会导致未定义行为。
地址 p 和 stride 所需的对齐在 WMMA 的矩阵存储 中描述。
强制性 .sync 限定符指示 wmma.load 使执行线程等待,直到 warp 中的所有线程都执行同一条 wmma.load 指令后才继续执行。
强制性 .aligned 限定符指示 warp 中的所有线程必须执行同一条 wmma.load 指令。在条件执行的代码中,只有当已知 warp 中的所有线程对条件的求值结果相同时,才应使用 wmma.load 指令,否则行为未定义。
如果所有线程未使用相同的限定符以及相同的 p 和 stride 值,或者 warp 中有任何线程已退出,则 wmma.load 的行为未定义。
wmma.load 在 内存一致性模型 中被视为弱内存操作。
示例
// Load elements from f16 row-major matrix B
.reg .b32 x<8>;
wmma.load.b.sync.aligned.m16n16k16.row.f16 {x0,x1,x2,x3,x4,x5,x,x7}, [ptr];
// Now use {x0, …, x7} for the actual wmma.mma
// Load elements from f32 column-major matrix C and scale the values:
.reg .b32 x<8>;
wmma.load.c.sync.aligned.m16n16k16.col.f32
{x0,x1,x2,x3,x4,x5,x6,x7}, [ptr];
mul.f32 x0, x0, 0.1;
// repeat for all registers x<8>;
…
mul.f32 x7, x7, 0.1;
// Now use {x0, …, x7} for the actual wmma.mma
// Load elements from integer matrix A:
.reg .b32 x<4>
// destination registers x<4> contain four packed .u8 values each
wmma.load.a.sync.aligned.m32n8k16.row.u8 {x0,x1,x2,x3}, [ptr];
// Load elements from sub-byte integer matrix A:
.reg .b32 x0;
// destination register x0 contains eight packed .s4 values
wmma.load.a.sync.aligned.m8n8k32.row.s4 {x0}, [ptr];
// Load elements from .bf16 matrix A:
.reg .b32 x<4>;
wmma.load.a.sync.aligned.m16n16k16.row.bf16
{x0,x1,x2,x3}, [ptr];
// Load elements from .tf32 matrix A:
.reg .b32 x<4>;
wmma.load.a.sync.aligned.m16n16k8.row.tf32
{x0,x1,x2,x3}, [ptr];
// Load elements from .f64 matrix A:
.reg .b32 x<4>;
wmma.load.a.sync.aligned.m8n8k4.row.f64
{x0}, [ptr];
9.7.16.4.4. Warp 级矩阵存储指令:wmma.store#
wmma.store
为 WMMA 将一个矩阵协同存储到内存中
语法
wmma.store.d.sync.aligned.layout.shape{.ss}.type [p], r {, stride};
.layout = {.row, .col};
.shape = {.m16n16k16, .m8n32k16, .m32n8k16};
.ss = {.global, .shared{::cta}};
.type = {.f16, .f32, .s32};
wmma.store.d.sync.aligned.layout.shape{.ss}.type [p], r {, stride}
.layout = {.row, .col};
.shape = {.m8n8k32, .m8n8k128};
.ss = {.global, .shared{::cta}};
.type = {.s32};
wmma.store.d.sync.aligned.layout.shape{.ss}.type [p], r {, stride}
.layout = {.row, .col};
.shape = {.m16n16k8};
.ss = {.global, .shared{::cta}};
.type = {.f32};
wmma.store.d.sync.aligned.layout.shape{.ss}.type [p], r {, stride}
.layout = {.row, .col};
.shape = {.m8n8k4 };
.ss = {.global, .shared{::cta}};
.type = {.f64};
说明
由 warp 中的所有线程协同地,从源寄存器 r 将一个矩阵存储到指定状态空间中由地址操作数 p 指示的位置。
如果未给出状态空间,则使用 通用寻址 执行内存访问。wmma.load 操作只能用于 .global 和 .shared 空间,以及通用寻址(此时地址指向 .global 或 .shared 空间)。
源操作数 r 是一个用花括号括起的向量表达式,与存储操作所期望的 fragment 形状匹配,如 WMMA 的矩阵片段 中所述。
.shape 限定符指示目标 wmma 计算中涉及的所有矩阵参数的维度。它必须与生成所存储的 D 矩阵的 wmma.mma 指令上指定的 .shape 限定符匹配。
.layout 限定符指示要加载的矩阵是以行主序还是列主序格式存储的。
stride 是一个可选的 32 位整数操作数,它以矩阵元素为单位给出主导维度(行或列)连续实例的起始之间的偏移。stride 的默认值在 WMMA 的矩阵存储 中描述,如果实际值大于默认值则必须指定。例如,如果该矩阵是某个更大矩阵的子矩阵,则 stride 的值就是该更大矩阵的主导维度。指定的值小于默认值会导致未定义行为。
地址 p 和 stride 所需的对齐在 WMMA 的矩阵存储 中描述。
强制性 .sync 限定符指示 wmma.store 使执行线程等待,直到 warp 中的所有线程都执行同一条 wmma.store 指令后才继续执行。
强制性 .aligned 限定符指示 warp 中的所有线程必须执行同一条 wmma.store 指令。在条件执行的代码中,只有当已知 warp 中的所有线程对条件的求值结果相同时,才应使用 wmma.store 指令,否则行为未定义。
如果所有线程未使用相同的限定符以及相同的 p 和 stride 值,或者 warp 中有任何线程已退出,则 wmma.store 的行为未定义。
wmma.store 在 内存一致性模型 中被视为弱内存操作。
示例
// Storing f32 elements computed by a wmma.mma
.reg .b32 x<8>;
wmma.mma.sync.m16n16k16.row.col.f32.f32
{d0, d1, d2, d3, d4, d5, d6, d7}, …;
wmma.store.d.sync.m16n16k16.row.f32
[ptr], {d0, d1, d2, d3, d4, d5, d6, d7};
// Store s32 accumulator for m16n16k16 shape:
.reg .b32 d<8>;
wmma.store.d.sync.aligned.m16n16k16.row.s32
[ptr], {d0, d1, d2, d3, d4, d5, d6, d7};
// Store s32 accumulator for m8n8k128 shape:
.reg .b32 d<2>
wmma.store.d.sync.aligned.m8n8k128.row.s32
[ptr], {d0, d1};
// Store f64 accumulator for m8n8k4 shape:
.reg .f64 d<2>;
wmma.store.d.sync.aligned.m8n8k4.row.f64
[ptr], {d0, d1};
9.7.16.4.5. Warp 级矩阵乘累加指令:wmma.mma#
wmma.mma
跨一个 warp 执行单次矩阵乘累加运算
语法
// Floating point (.f16 multiplicands) wmma.mma
wmma.mma.sync.aligned.alayout.blayout.shape.dtype.ctype d, a, b, c;
// Integer (.u8/.s8 multiplicands) wmma.mma
wmma.mma.sync.aligned.alayout.blayout.shape.s32.atype.btype.s32{.satfinite} d, a, b, c;
.alayout = {.row, .col};
.blayout = {.row, .col};
.shape = {.m16n16k16, .m8n32k16, .m32n8k16};
.dtype = {.f16, .f32};
.atype = {.s8, .u8};
.btype = {.s8, .u8};
.ctype = {.f16, .f32};
浮点格式 .bf16 wmma.mma:
wmma.mma.sync.aligned.alayout.blayout.shape.f32.atype.btype.f32 d, a, b, c;
.alayout = {.row, .col};
.blayout = {.row, .col};
.shape = {.m16n16k16, .m8n32k16, .m32n8k16};
.atype = {.bf16 };
.btype = {.bf16};
浮点格式 .tf32 wmma.mma:
wmma.mma.sync.aligned.alayout.blayout.shape.f32.atype.btype.f32 d, a, b, c;
.alayout = {.row, .col};
.blayout = {.row, .col};
.shape = {.m16n16k8 };
.atype = {.tf32 };
.btype = {.tf32};
浮点双精度 wmma.mma:
wmma.mma.sync.aligned.alayout.blayout.shape{.rnd}.f64.f64.f64.f64 d, a, b, c;
.alayout = {.row, .col};
.blayout = {.row, .col};
.shape = {.m8n8k4 };
.rnd = { .rn, .rz, .rm, .rp };
子字节(.u4/.s4 被乘数)wmma.mma:
wmma.mma.sync.aligned.row.col.shape.s32.atype.btype.s32{.satfinite} d, a, b, c;
.shape = {.m8n8k32};
.atype = {.s4, .u4};
.btype = {.s4, .u4};
单比特(.b1 被乘数)wmma.mma:
wmma.mma.op.popc.sync.aligned.row.col.shape.s32.atype.btype.s32 d, a, b, c;
.shape = {.m8n8k128};
.atype = {.b1};
.btype = {.b1};
.op = {.xor, .and}
说明
使用分别加载在寄存器 a、b 和 c 中的矩阵 A、B 和 C,执行 warp 级矩阵乘累加计算 D = A * B + C,并将结果矩阵存储在寄存器 d 中。寄存器参数 a、b、c 和 d 保存对应矩阵的未指定 fragment,如 WMMA 的矩阵片段 中所述
限定符 .dtype、.atype、.btype 和 .ctype 分别指示矩阵 D、A、B 和 C 中元素的数据类型。
对于不带显式 .atype 和 .btype 的 wmma.mma:.atype 和 .btype 隐式设置为 .f16。
对于整数 wmma,.ctype 和 .dtype 必须指定为 .s32。此外,.atype 和 .btype 的取值必须相同,即两者都为 .s8 或两者都为 .u8。
对于子字节单比特 wmma,.ctype 和 .dtype 必须指定为 .s32。此外,.atype 和 .btype 的取值必须相同;即两者都为 .s4、都为 .u4,或都为 .b1。
对于单比特 wmma,乘法被替换为一系列逻辑运算;具体而言,wmma.xor.popc 和 wmma.and.popc 分别计算 A 的 128 位行与 B 的 128 位列的 XOR、AND,然后统计结果中置位的比特数(popc)。该结果与 C 的对应元素相加并写入 D。
限定符 .alayout 和 .blayout 必须分别与生成操作数 a 和 b 内容的 wmma.load 指令上指定的 layout 匹配。类似地,限定符 .atype、.btype 和 .ctype 必须分别与生成操作数 a、b 和 c 内容的 wmma.load 指令上对应的限定符匹配。
.shape 限定符必须与生成全部三个输入操作数 a、b 和 c 内容的 wmma.load 指令上使用的 .shape 限定符匹配。
目标操作数 d 是一个用花括号括起的向量表达式,与 wmma.mma 指令所计算的 fragment 的 .shape 匹配。
- 输出处的饱和:
-
可选限定符
.satfinite指示目标寄存器中的最终值按如下方式饱和:输出被钳制到 32 位有符号整数的最小值或最大值。否则,如果累加会溢出,则该值回绕。
.f16浮点运算的精度与舍入:-
矩阵 A 和 B 的逐元素乘法以至少单精度执行。当
.ctype或.dtype为.f32时,中间值的累加以至少单精度执行。当.ctype和.dtype都指定为.f16时,累加以至少半精度执行。累加顺序、舍入以及次正规输入的处理方式均未指定。
.bf16、.tf32浮点运算的精度与舍入:-
矩阵 A 和 B 的逐元素乘法以指定的精度执行。中间值的累加以至少单精度执行。
累加顺序、舍入以及次正规输入的处理方式均未指定。
双精度 wmma.mma 上的舍入修饰符(默认为 .rn):
.rn-
尾数 LSB 就近偶数舍入
.rz-
尾数 LSB 向零舍入
.rm-
尾数 LSB 向负无穷大舍入
.rp-
尾数 LSB 向正无穷大舍入
强制性 .sync 限定符指示 wmma.mma 使执行线程等待,直到 warp 中的所有线程都执行同一条 wmma.mma 指令后才继续执行。
强制性 .aligned 限定符指示 warp 中的所有线程必须执行同一条 wmma.mma 指令。在条件执行的代码中,只有当已知 warp 中的所有线程对条件的求值结果相同时,才应使用 wmma.mma 指令,否则行为未定义。
如果同一 warp 中的所有线程未使用相同的限定符,或者 warp 中有任何线程已退出,则 wmma.mma 的行为未定义。
示例
.global .align 32 .f16 A[256], B[256];
.global .align 32 .f32 C[256], D[256];
.reg .b32 a<8> b<8> c<8> d<8>;
wmma.load.a.sync.aligned.m16n16k16.global.row.f16
{a0, a1, a2, a3, a4, a5, a6, a7}, [A];
wmma.load.b.sync.aligned.m16n16k16.global.col.f16
{b0, b1, b2, b3, b4, b5, b6, b7}, [B];
wmma.load.c.sync.aligned.m16n16k16.global.row.f32
{c0, c1, c2, c3, c4, c5, c6, c7}, [C];
wmma.mma.sync.aligned.m16n16k16.row.col.f32.f32
{d0, d1, d2, d3, d4, d5, d6, d7},
{a0, a1, a2, a3, a4, a5, a6, a7},
{b0, b1, b2, b3, b4, b5, b6, b7},
{c0, c1, c2, c3, c4, c5, c6, c7};
wmma.store.d.sync.aligned.m16n16k16.global.col.f32
[D], {d0, d1, d2, d3, d4, d5, d6, d7};
// Compute an integer WMMA:
.reg .b32 a, b<4>;
.reg .b32 c<8>, d<8>;
wmma.mma.sync.aligned.m8n32k16.row.col.s32.s8.s8.s32
{d0, d1, d2, d3, d4, d5, d6, d7},
{a}, {b0, b1, b2, b3},
{c0, c1, c2, c3, c4, c5, c6, c7};
// Compute sub-byte WMMA:
.reg .b32 a, b, c<2> d<2>
wmma.mma.sync.aligned.m8n8k32.row.col.s32.s4.s4.s32
{d0, d1}, {a}, {b}, {c0, c1};
// Compute single-bit type WMMA:
.reg .b32 a, b, c<2> d<2>
wmma.mma.xor.popc.sync.aligned.m8n8k128.row.col.s32.b1.b1.s32
{d0, d1}, {a}, {b}, {c0, c1};
// Compute double precision wmma
.reg .f64 a, b, c<2>, d<2>;
wmma.mma.sync.aligned.m8n8k4.row.col.f64.f64.f64.f64
{d0, d1}, {a}, {b}, {c0, c1};
// Compute alternate floating point precision wmma
.reg .b32 a<2>, b<2>, c<8>, d<8>;
wmma.mma.sync.aligned.m16n16k8.row.col.f32.tf32.tf32.f32
{d0, d1, d2, d3, d4, d5, d6, d7},
{a0, a1, a2, a3}, {b0, b1, b2, b3},
{c0, c1, c2, c3, c4, c5, c6, c7};
9.7.16.5. 使用 mma 指令的矩阵乘累加运算#
本节介绍 warp 级的 mma、ldmatrix、stmatrix 和 movmatrix 指令,以及这些指令所涉及的各种矩阵的组织方式。
9.7.16.5.1. mma.m8n8k4 使用 .f16 浮点类型的矩阵 Fragment#
执行 .f16 浮点类型的 mma.m8n8k4 的 warp 将计算 4 个形状为 .m8n8k4 的 MMA 运算。
4 个矩阵的元素需要分布到 warp 中的各个线程上。下表给出了 MMA 运算中矩阵的分布。
MMA 计算 |
参与 MMA 计算的线程 |
|---|---|
MMA 计算 1 |
|
MMA 计算 2 |
|
MMA 计算 3 |
|
MMA 计算 4 |
|
对于上述每个单独的 MMA 计算,每个所需的线程都持有矩阵的一个 fragment,用于按如下方式执行 mma 运算:
-
乘数 A:
.atype
Fragment
元素(从低到高)
.f16一个向量表达式,包含两个
.f16x2寄存器,每个寄存器包含来自矩阵 A 的两个.f16元素。a0, a1, a2, a3
不同线程所持有的 fragment 布局如下所示:
-
行主序矩阵 A 的 Fragment 布局如 图 49 所示。
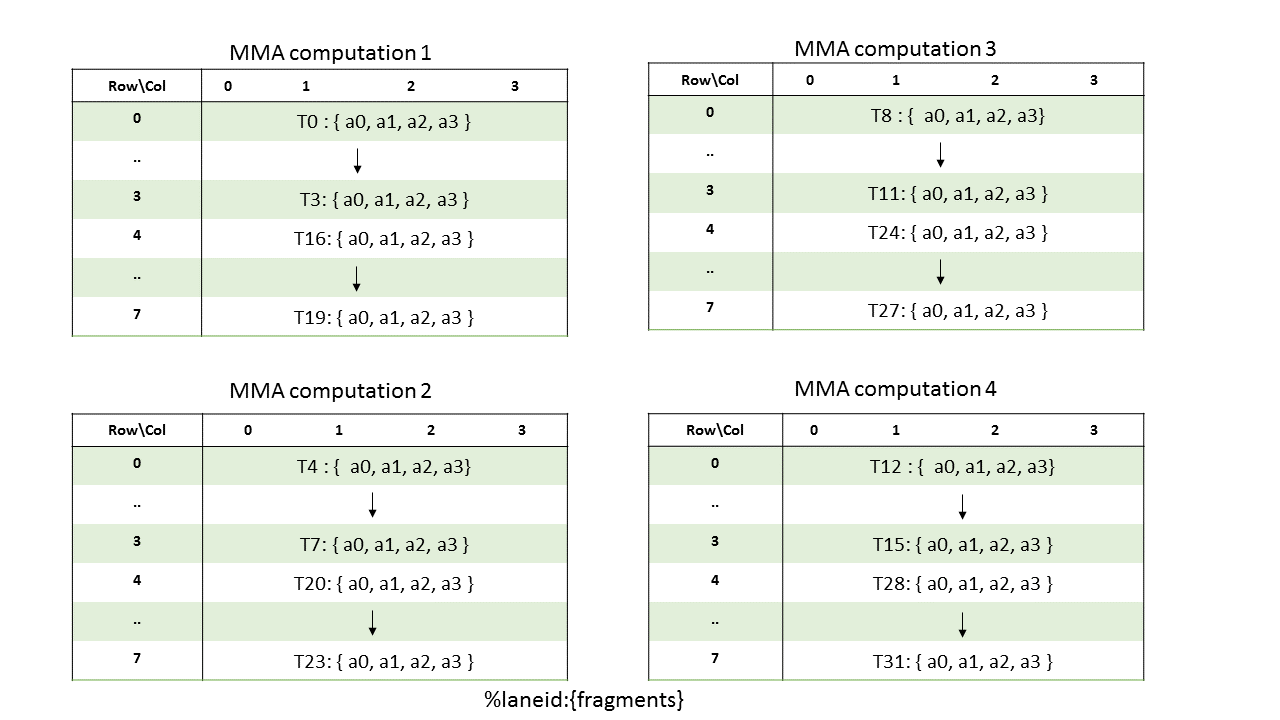
图 49 使用
.f16类型的行主序矩阵 A 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = %laneid % 4 if %laneid < 16 (%laneid % 4) + 4 otherwise
col = i for ai where i = {0,..,3}
-
列主序矩阵 A 的 Fragment 布局如 图 50 所示。
不同线程所持有的 fragment 布局如下所示:
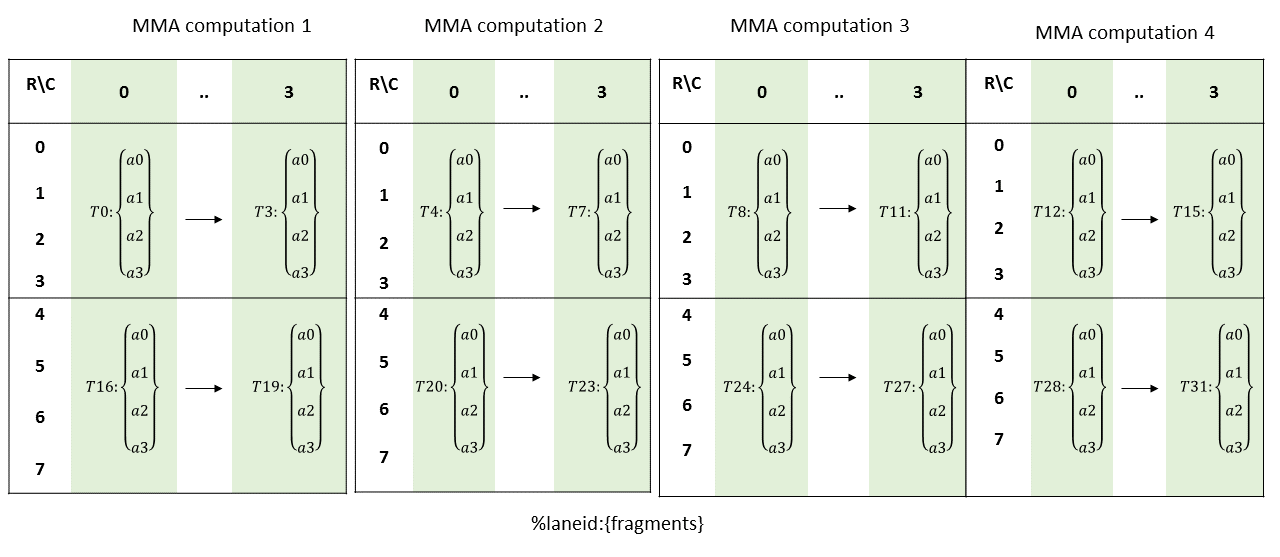
图 50 使用
.f16类型的列主序矩阵 A 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = i % 4 for ai where i = {0,..,3} if %laneid < 16 (i % 4) + 4 for ai where i = {0,..,3} otherwise
col = %laneid % 4
-
-
乘数 B:
.btype
Fragment
元素(从低到高)
.f16一个向量表达式,包含两个
.f16x2寄存器,每个寄存器包含来自矩阵 B 的两个.f16元素。b0, b1, b2, b3
不同线程所持有的 fragment 布局如下所示:
-
行主序矩阵 B 的 Fragment 布局如 图 51 所示。
图 51 使用
.f16类型的行主序矩阵 B 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = %laneid % 4
col = i for bi where i = {0,..,3} if %laneid < 16 i+4 for bi where i = {0,..,3} otherwise
-
列主序矩阵 B 的 Fragment 布局如 图 52 所示。
图 52 使用
.f16类型的列主序矩阵 B 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = i for bi where i = {0,..,3}
col = %laneid % 4 if %laneid < 16 (%laneid % 4) + 4 otherwise
-
-
累加器 C(或 D):
.ctype / .dtype
Fragment
元素(从低到高)
.f16一个向量表达式,包含四个
.f16x2寄存器,每个寄存器包含来自矩阵 C(或 D)的两个.f16元素。c0, c1, c2, c3, c4, c5, c6, c7
.f32一个由八个
.f32寄存器组成的向量表达式。不同线程所持有的 fragment 布局如下所示:
-
当
.ctype为.f16时,累加器矩阵的 Fragment 布局如 图 53 所示。
图 53 当
.ctype=.f16时矩阵 C/D 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = %laneid % 4 if %laneid < 16 (%laneid % 4) + 4 otherwise
col = i for ci where i = {0,..,7}
-
当
.ctype为.f32时,累加器矩阵的 Fragment 布局如 图 54 和 图 55 所示。
图 54 当
.ctype=.f32时矩阵 C/D 的 MMA .m8n8k4 计算 1 和 2 的 fragment 布局
图 55 当
.ctype=.f32时矩阵 C/D 的 MMA .m8n8k4 计算 3 和 4 的 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = X if %laneid < 16 X + 4 otherwise
where X = (%laneid & 0b1) + (i & 0b10) for ci where i = {0,..,7}
col = (i & 0b100) + (%laneid & 0b10) + (i & 0b1) for ci where i = {0,..,7}
-
9.7.16.5.2. mma.m8n8k4 使用 .f64 浮点类型的矩阵 Fragment#
执行 .f64 浮点类型的 mma.m8n8k4 的 warp 将计算一个形状为 .m8n8k4 的 MMA 运算。
矩阵的元素分布到 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个 fragment。
-
乘数 A:
.atype
Fragment
元素(从低到高)
.f64一个向量表达式,包含单个
.f64寄存器,其中含有来自矩阵 A 的单个.f64元素。a0
不同线程所持有的 fragment 布局如 图 56 所示。
图 56 使用
.f64类型的矩阵 A 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = %laneid >> 2
col = %laneid % 4
-
乘数 B:
.btype
Fragment
元素(从低到高)
.f64一个向量表达式,包含单个
.f64寄存器,其中含有来自矩阵 B 的单个.f64元素。b0
不同线程所持有的 fragment 布局如 图 57 所示。
图 57 使用
.f64类型的矩阵 B 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
row = %laneid % 4
col = %laneid >> 2
-
累加器(C 或 D):
.ctype / .dtype
Fragment
元素(从低到高)
.f64一个向量表达式,包含两个
.f64寄存器,其中含有来自矩阵 C 的两个.f64元素。c0, c1
不同线程所持有的 fragment 布局如 图 58 所示。
图 58 使用
.f64类型的累加器矩阵 C/D 的 MMA .m8n8k4 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0, 1}
9.7.16.5.3. mma.m8n8k16 的矩阵 Fragment#
执行 mma.m8n8k16 的 warp 将计算一个形状为 .m8n8k16 的 MMA 运算。
矩阵的元素分布到 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个 fragment。
-
乘数 A:
.atype
Fragment
元素(从低到高)
.s8/.u8一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 A 的四个.s8或.u8元素。a0, a1, a2, a3
不同线程所持有的 fragment 布局如 图 59 所示。
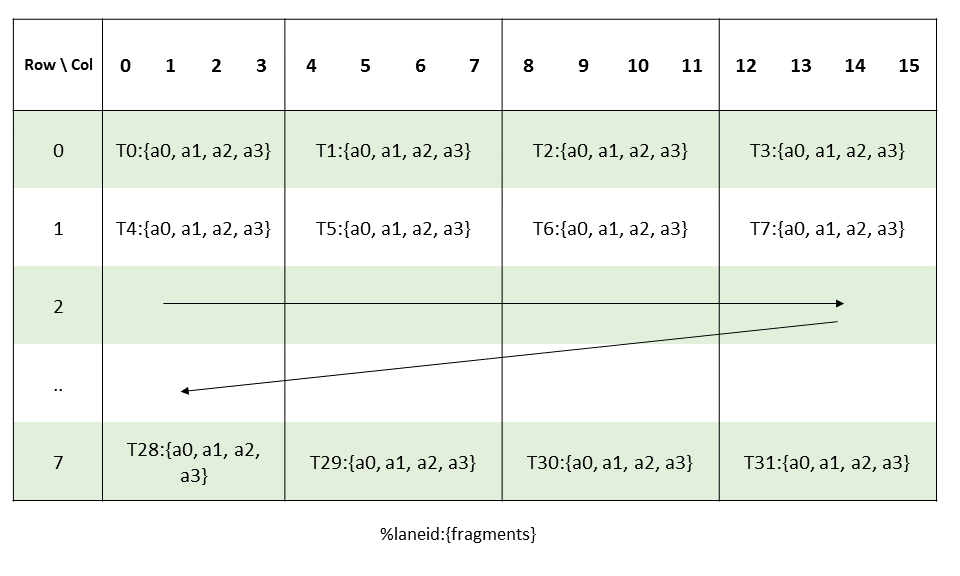
图 59 使用
.u8/.s8类型的矩阵 A 的 MMA .m8n8k16 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID
col = (threadID_in_group * 4) + i for ai where i = {0,..,3}
-
乘数 B:
.btype
Fragment
元素(从低到高)
.s8/.u8一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 B 的四个.s8或.u8元素。b0, b1, b2, b3
不同线程所持有的 fragment 布局如 图 60 所示。
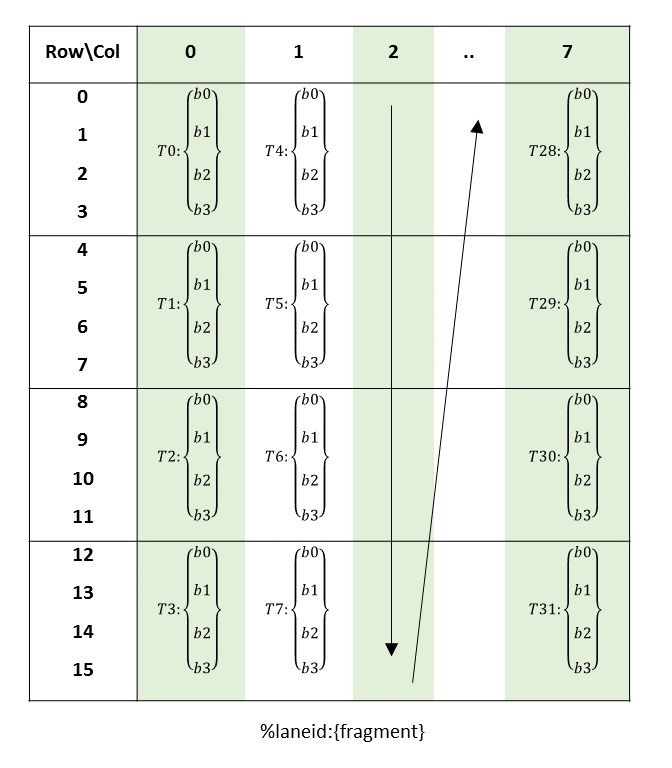
图 60 使用
.u8/.s8类型的矩阵 B 的 MMA .m8n8k16 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 4) + i for bi where i = {0,..,3}
col = groupID
-
累加器(C 或 D):
.ctype / .dtype
Fragment
元素(从低到高)
.s32一个由两个
.s32寄存器组成的向量表达式。c0, c1
不同线程所持有的 fragment 布局如 图 61 所示。
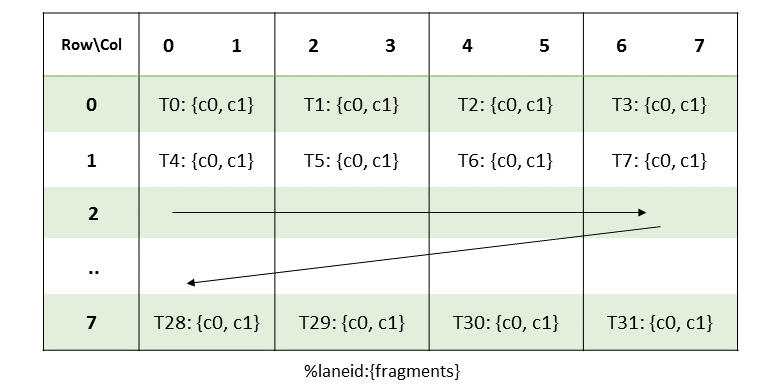
图 61 使用
.s32类型的累加器矩阵 C/D 的 MMA .m8n8k16 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID
col = (threadID_in_group * 2) + i for ci where i = {0, 1}
9.7.16.5.4. mma.m8n8k32 的矩阵 Fragment#
执行 mma.m8n8k32 的 warp 将计算一个形状为 .m8n8k32 的 MMA 运算。
矩阵的元素分布到 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个 fragment。
-
乘数 A:
.atype
Fragment
元素(从低到高)
.s4/.u4一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 A 的八个.s4或.u4元素。a0, a1, a2, a3, a4, a5, a6, a7
不同线程所持有的 fragment 布局如 图 62 所示。
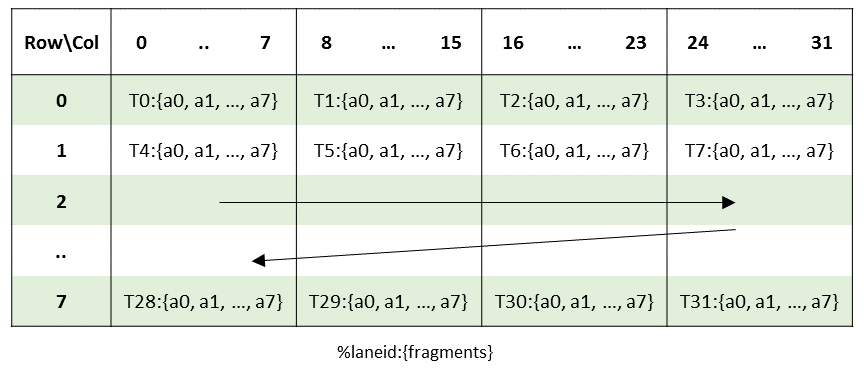
图 62 使用
.u4/.s4类型的矩阵 A 的 MMA .m8n8k32 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID
col = (threadID_in_group * 8) + i for ai where i = {0,..,7}
-
乘数 B:
.btype
Fragment
元素(从低到高)
.s4/.u4一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 B 的八个.s4或.u4元素。b0, b1, b2, b3, b4, b5, b6, b7
不同线程所持有的 fragment 布局如 图 63 所示。
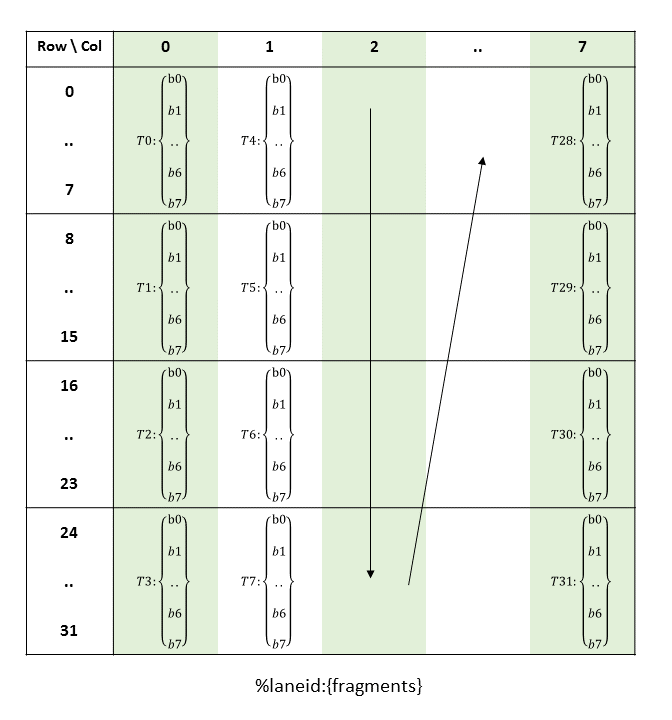
图 63 使用
.u4/.s4类型的矩阵 B 的 MMA .m8n8k32 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 8) + i for bi where i = {0,..,7}
col = groupID
-
累加器(C 或 D):
.ctype / .dtype
Fragment
元素(从低到高)
.s32一个由两个
.s32寄存器组成的向量表达式。c0, c1
不同线程所持有的 fragment 布局如 图 64 所示:
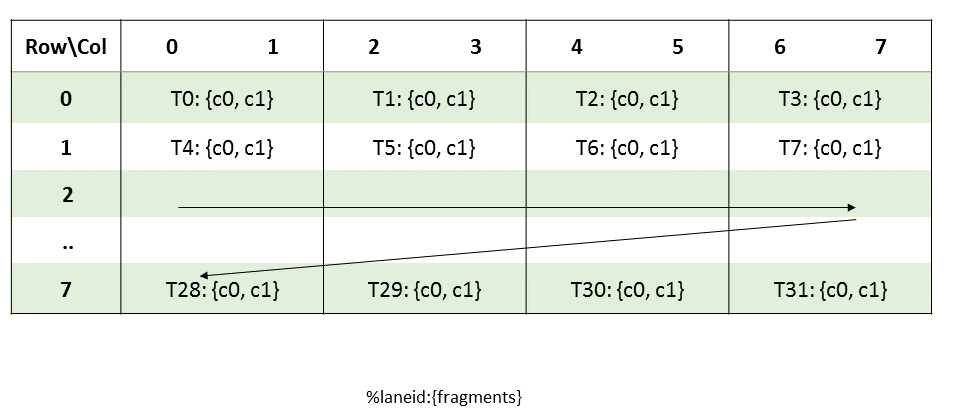
图 64 使用
.s32类型的累加器矩阵 C/D 的 MMA .m8n8k32 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID col = (threadID_in_group * 2) + i for ci where i = {0, 1}
9.7.16.5.5. mma.m8n8k128 的矩阵 Fragment#
执行 mma.m8n8k128 的 warp 将计算一个形状为 .m8n8k128 的 MMA 运算。
矩阵的元素分布到 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个 fragment。
-
乘数 A:
.atype
Fragment
元素(从低到高)
.b1一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 A 的三十二个.b1元素。a0, a1, … a30, a31
不同线程所持有的 fragment 布局如 图 65 所示。
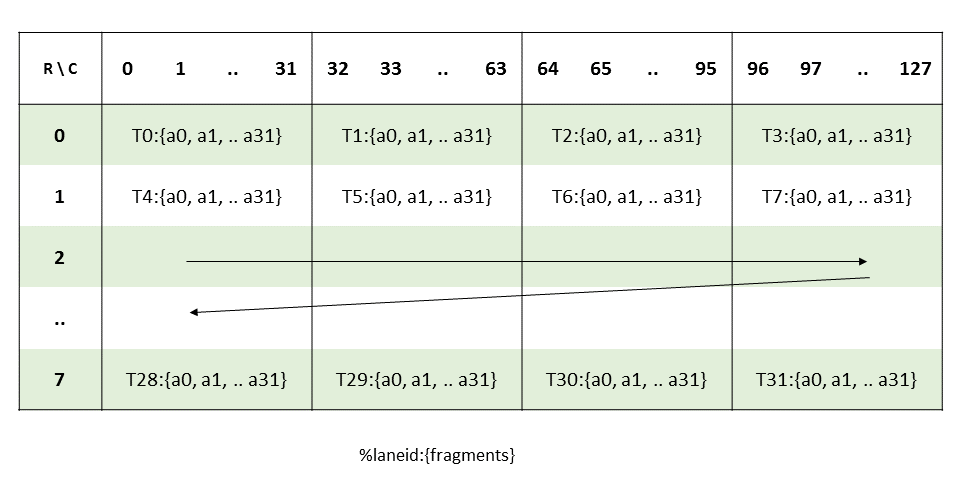
图 65 使用
.b1类型的矩阵 A 的 MMA .m8n8k128 fragment 布局。矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID
col = (threadID_in_group * 32) + i for ai where i = {0,..,31}
-
乘数 B:
.btype
Fragment
元素(从低到高)
.b1一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 B 的三十二个.b1元素。b0, b1, …, b30, b31
不同线程所持有的 fragment 布局如 图 66 所示。
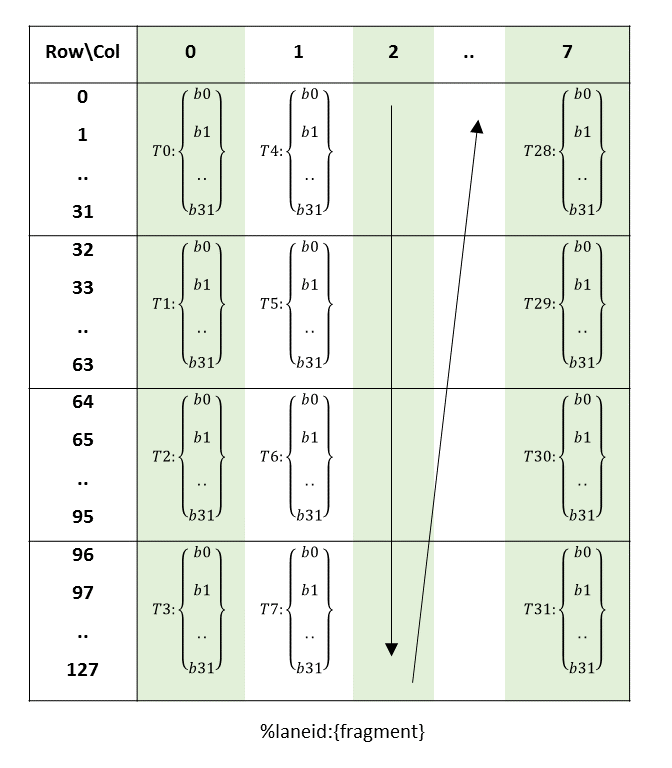
图 66 使用
.b1类型的矩阵 B 的 MMA .m8n8k128 fragment 布局。矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 32) + i for bi where i = {0,..,31}
col = groupID
-
累加器(C 或 D):
.ctype / .dtype
Fragment
元素(从低到高)
.s32一个向量表达式,包含两个
.s32寄存器,其中含有来自矩阵 C(或 D)的两个.s32元素。c0, c1
不同线程所持有的 fragment 布局如 图 67 所示。
图 67 使用
.s32类型的累加器矩阵 C/D 的 MMA .m8n8k128 fragment 布局矩阵 fragment 的行和列可以计算如下:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID
col = (threadID_in_group * 2) + i for ci where i = {0, 1}
9.7.16.5.6. mma.m16n8k4 的矩阵片段#
执行 mma.m16n8k4 的一个 warp 将计算形状为 .m16n8k4 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
-
.tf32:.atype
矩阵片段
元素(从低到高)
.tf32一个向量表达式,包含两个
.b32寄存器,其中含有来自矩阵 A 的两个.tf32元素。a0, a1
不同线程所持有的片段布局如图 68所示。
图 68 MMA .m16n8k4 矩阵片段布局(矩阵 A,
.tf32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 groupID + 8 for a1
col = threadID_in_group
-
.f64:.atype
矩阵片段
元素(从低到高)
.f64一个向量表达式,包含两个
.f64寄存器,其中含有来自矩阵 A 的两个.f64元素。a0, a1
不同线程所持有的片段布局如图 69所示。
图 69 MMA .m16n8k4 矩阵片段布局(矩阵 A,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 groupID + 8 for a1
col = threadID_in_group
-
-
被乘数 B:
-
.tf32:.btype
矩阵片段
元素(从低到高)
.tf32一个向量表达式,包含单个
.b32寄存器,其中含有来自矩阵 B 的单个.tf32元素。b0
不同线程所持有的片段布局如图 70所示。
图 70 MMA .m16n8k4 矩阵片段布局(矩阵 B,
.tf32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = threadID_in_group
col = groupID
-
.f64:.btype
矩阵片段
元素(从低到高)
.f64一个向量表达式,包含单个
.f64寄存器,其中含有来自矩阵 B 的单个.f64元素。b0
不同线程所持有的片段布局如图 71所示。
图 71 MMA .m16n8k4 矩阵片段布局(矩阵 B,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = threadID_in_group
col = groupID
-
-
累加器(C 或 D):
-
.tf32:.ctype / .dtype
矩阵片段
元素(从低到高)
.f32一个向量表达式,包含四个
.f32寄存器,其中含有来自矩阵 C(或 D)的四个.f32元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 72所示。
图 72 MMA .m16n8k4 矩阵片段布局(累加器矩阵 C/D,
.f32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for c0 and c1 groupID + 8 for c2 and c3
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
-
.f64:.ctype / .dtype
矩阵片段
元素(从低到高)
.f64一个向量表达式,包含四个
.f64寄存器,其中含有来自矩阵 C(或 D)的四个.f64元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 73所示。
图 73 MMA .m16n8k4 矩阵片段布局(累加器矩阵 C/D,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for c0 and c1 groupID + 8 for c2 and c3
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
-
9.7.16.5.7. mma.m16n8k8 的矩阵片段#
执行 mma.m16n8k8 的一个 warp 将计算形状为 .m16n8k8 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
-
.f16和.bf16:.atype
矩阵片段
元素(从低到高)
.f16/.bf16一个向量表达式,包含两个
.f16x2寄存器,其中每个寄存器包含来自矩阵 A 的两个.f16/.bf16元素。a0, a1, a2, a3
不同线程所持有的片段布局如图 74所示。
图 74 MMA .m16n8k8 矩阵片段布局(矩阵 A,
.f16/.bf16类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 and a1 groupID + 8 for a2 and a3
col = threadID_in_group * 2 + (i & 0x1) for ai where i = {0,..,3}
-
.tf32:.atype
矩阵片段
元素(从低到高)
.tf32一个向量表达式,包含四个
.b32寄存器,其中含有来自矩阵 A 的四个.tf32元素。a0, a1, a2, a3
不同线程所持有的片段布局如图 75所示。
图 75 MMA .m16n8k8 矩阵片段布局(矩阵 A,
.tf32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 and a2 groupID + 8 for a1 and a3
col = threadID_in_group for a0 and a1 threadID_in_group + 4 for a2 and a3
-
.f64:.atype
矩阵片段
元素(从低到高)
.f64一个向量表达式,包含四个
.f64寄存器,其中含有来自矩阵 A 的四个.f64元素。a0, a1, a2, a3
不同线程所持有的片段布局如图 76所示。
图 76 MMA .m16n8k8 矩阵片段布局(矩阵 A,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 and a2 groupID + 8 for a1 and a3
col = threadID_in_group for a0 and a1 threadID_in_group + 4 for a2 and a3
-
-
被乘数 B:
-
.f16和.bf16:.btype
矩阵片段
元素(从低到高)
.f16/.bf16一个向量表达式,包含单个
.f16x2寄存器,其中含有来自矩阵 B 的两个.f16/.bf16元素。b0, b1
不同线程所持有的片段布局如图 77所示。
图 77 MMA .m16n8k8 矩阵片段布局(矩阵 B,
.f16/.bf16类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 2) + i for bi where i = {0, 1}
col = groupID
-
.tf32:.btype
矩阵片段
元素(从低到高)
.tf32一个向量表达式,包含两个
.b32寄存器,其中含有来自矩阵 B 的两个.tf32元素。b0, b1
不同线程所持有的片段布局如图 78所示。
图 78 MMA .m16n8k8 矩阵片段布局(矩阵 B,
.tf32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = threadID_in_group for b0 threadID_in_group + 4 for b1
col = groupID
-
.f64:.btype
矩阵片段
元素(从低到高)
.f64一个向量表达式,包含两个
.f64寄存器,其中含有来自矩阵 B 的两个.f64元素。b0, b1
不同线程所持有的片段布局如图 79所示。
图 79 MMA .m16n8k8 矩阵片段布局(矩阵 B,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = threadID_in_group for b0 threadID_in_group + 4 for b1
col = groupID
-
-
累加器(C 或 D):
-
.f16、.bf16和.tf32:.ctype / .dtype
矩阵片段
元素(从低到高)
.f16一个向量表达式,包含两个
.f16x2寄存器,其中每个寄存器包含来自矩阵 C(或 D)的两个.f16元素。c0, c1, c2, c3
.f32一个由四个
.f32寄存器组成的向量表达式。不同线程所持有的片段布局如图 80所示。
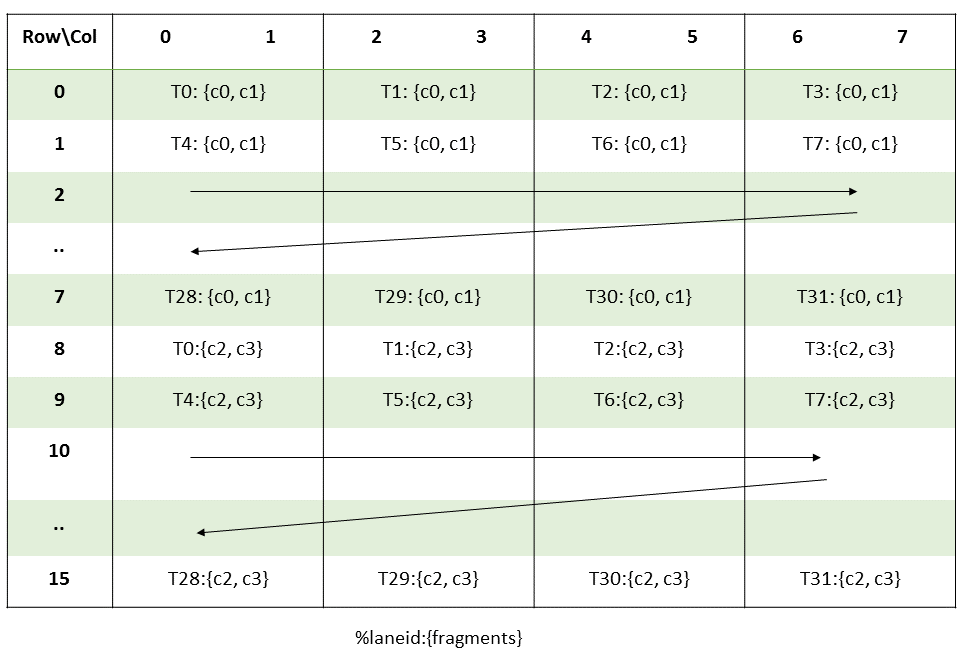
图 80 MMA .m16n8k8 矩阵片段布局(累加器矩阵 C/D,
.f16x2/.f32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for c0 and c1 groupID + 8 for c2 and c3
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
-
.f64:.ctype / .dtype
矩阵片段
元素(从低到高)
.f64一个由四个
.f64寄存器组成的向量表达式,其中含有来自矩阵 C(或 D)的四个.f64元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 81所示。
图 81 MMA .m16n8k8 矩阵片段布局(累加器矩阵 C/D,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for c0 and c1 groupID + 8 for c2 and c3
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
-
9.7.16.5.8. 浮点类型 mma.m16n8k16 的矩阵片段#
一个执行 mma.m16n8k16 浮点类型的 warp 将计算形状为 .m16n8k16 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
-
.f16和.bf16:.atype
矩阵片段
元素(从低到高)
.f16/.bf16一个包含四个
.f16x2寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的两个.f16/.bf16元素。a0, a1, a2, a3, a4, a5, a6, a7
不同线程所持有的片段布局如图 82所示。
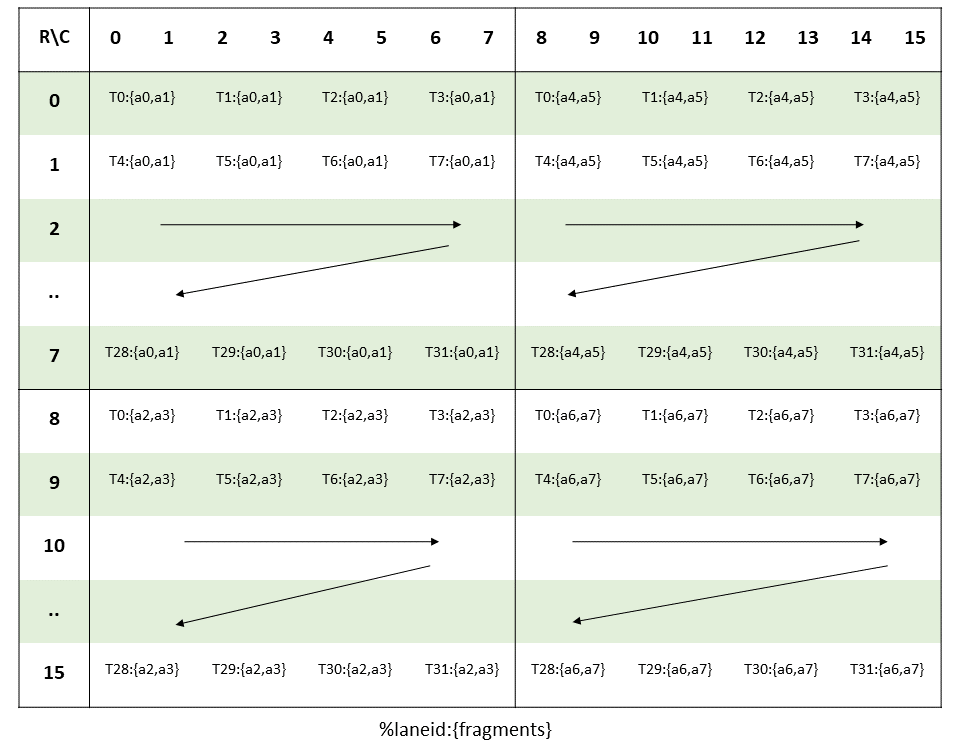
图 82 MMA .m16n8k16 矩阵片段布局(矩阵 A,
.f16/.bf16类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 2 || 4 <= i < 6 groupID + 8 Otherwise
col = (threadID_in_group 2) + (i & 0x1) for ai where i < 4 (threadID_in_group 2) + (i & 0x1) + 8 for ai where i >= 4
-
.f64:.atype
矩阵片段
元素(从低到高)
.f64一个包含八个
.f64寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的一个.f64元素。a0, a1, a2, a3, a4, a5, a6, a7
不同线程所持有的片段布局如图 83所示。
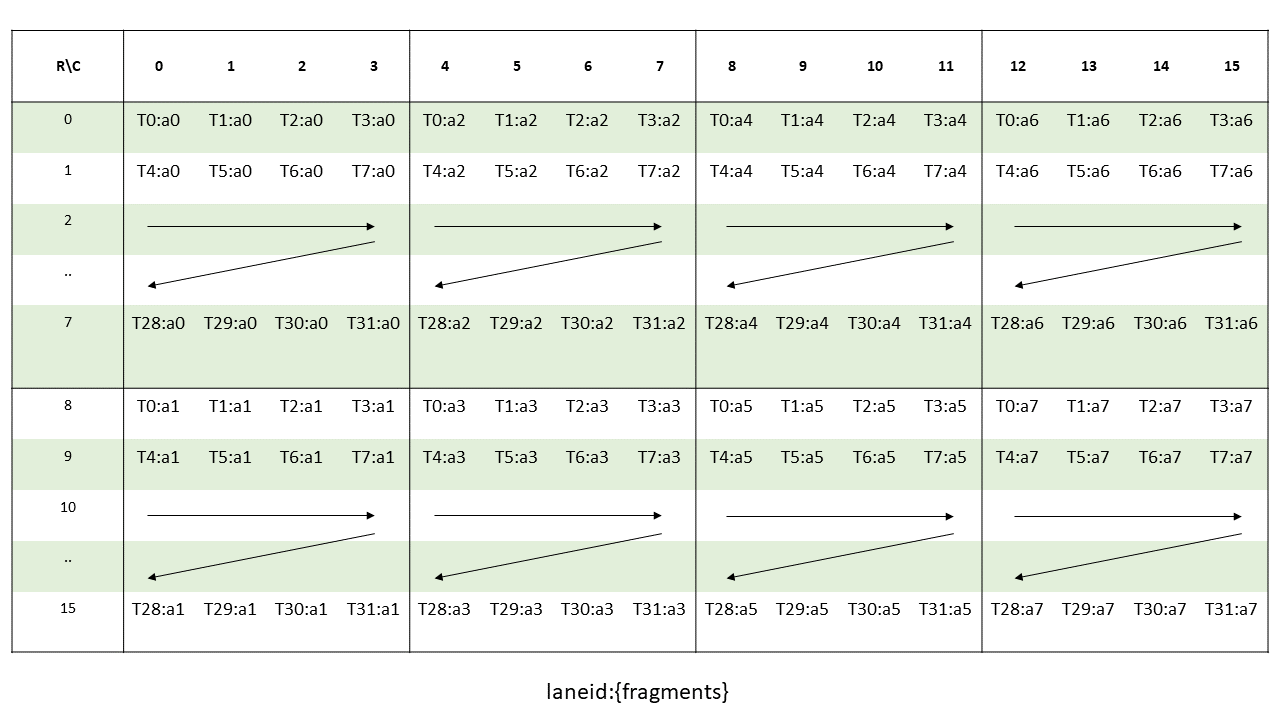
图 83 MMA .m16n8k16 矩阵片段布局(矩阵 A,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where i % 2 = 0 groupID + 8 Otherwise
col = (i 2) + threadID_in_group for ai where i % 2 = 0 (i 2) - 2 + (threadID_in_group Otherwise
-
-
被乘数 B:
-
.f16和.bf16:.btype
矩阵片段
元素(从低到高)
.f16/.bf16一个包含两个
.f16x2寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的两个.f16/.bf16元素。b0, b1, b2, b3
不同线程所持有的片段布局如图 84所示。
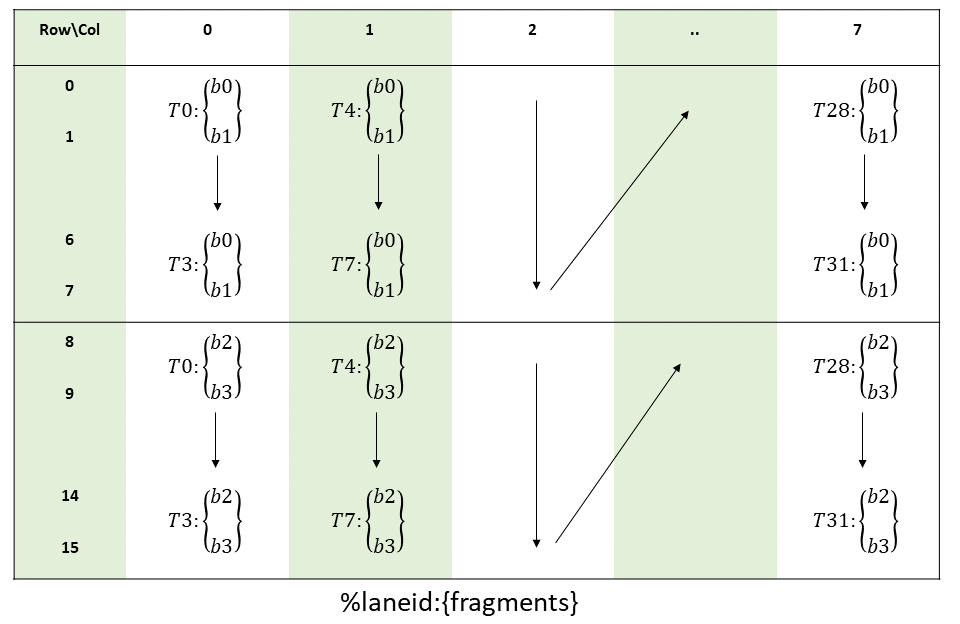
图 84 MMA .m16n8k16 矩阵片段布局(矩阵 B,
.f16/.bf16类型)。其中矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group 2) + (i & 0x1) for bi where i < 2 (threadID_in_group 2) + (i & 0x1) + 8 for bi where i >= 2
col = groupID
-
.f64:.atype
矩阵片段
元素(从低到高)
.f64一个包含四个
.f64寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的一个.f64元素。b0, b1, b2, b3
不同线程所持有的片段布局如图 85所示。
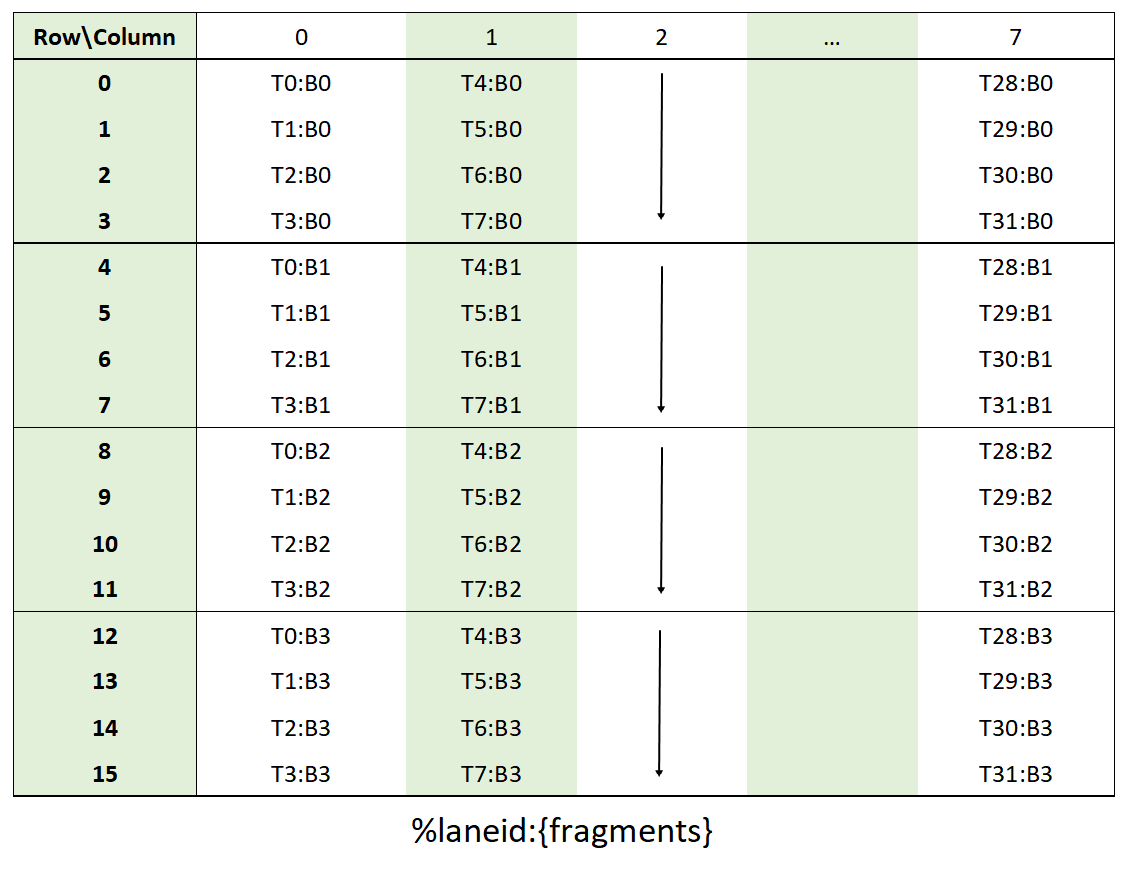
图 85 MMA .m16n8k16 矩阵片段布局(矩阵 B,
.f64类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = threadID_in_group + (i * 4) for bi where i < 4
col = groupID
-
-
累加器(C 或 D):
.ctype / .dtype
矩阵片段
元素(从低到高)
.f64一个包含四个
.f64寄存器的向量表达式,其中包含矩阵 C(或 D)中的.f64元素。c0, c1, c2, c3
.f32一个包含四个
.f32寄存器的向量表达式,其中包含矩阵 C(或 D)中的四个.f32元素。.f16一个包含两个
.f16x2寄存器的向量表达式,其中每个寄存器包含矩阵 C(或 D)中的两个.f16元素。不同线程所持有的片段布局如图 86所示。
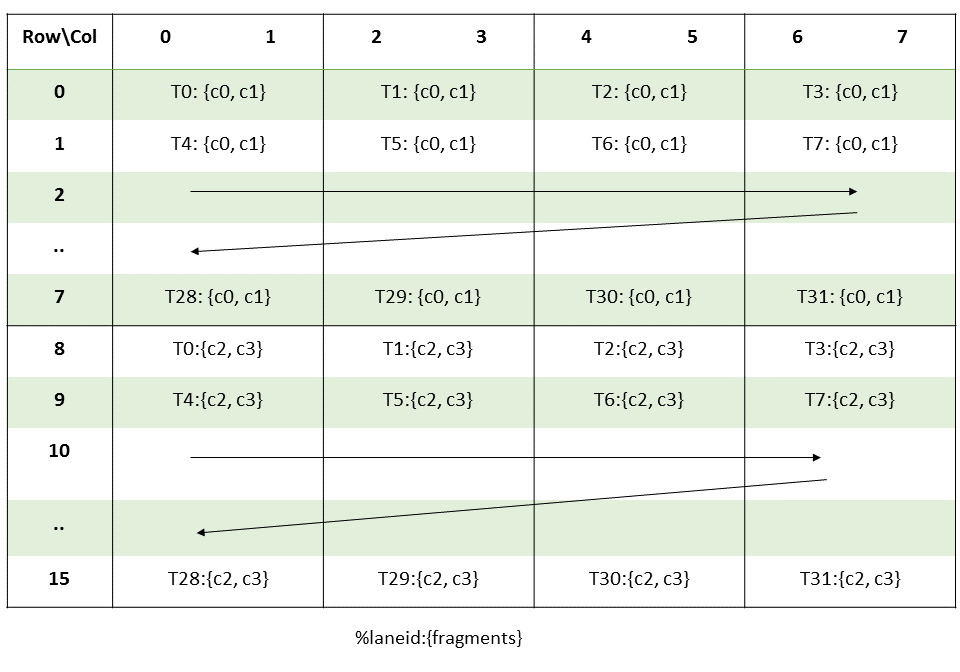
图 86 MMA .m16n8k16 矩阵片段布局(累加器矩阵 matrix C/D)。
矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ci where i < 2 groupID + 8 for ci where i >= 2
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
9.7.16.5.9. 整数类型 mma.m16n8k16 的矩阵片段#
一个执行 mma.m16n8k16 的 warp 将计算形状为 .m16n8k16 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素(从低到高)
.u8/.s8一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的四个.u8/.s8元素。a0, a1, a2, a3, a4, a5, a6, a7
.e4m3/.e5m2一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的四个.e4m3/.e5m2元素。a0, a1, a2, a3, a4, a5, a6, a7
不同线程所持有的片段布局如图 87所示。
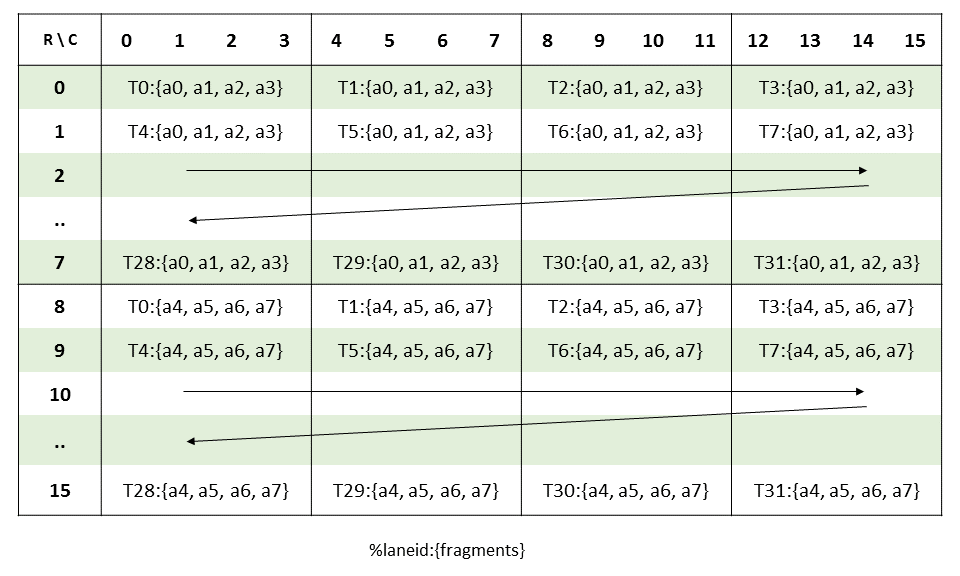
图 87 MMA .m16n8k16 矩阵片段布局(矩阵 A,
.u8/.s8类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where i < 4 groupID + 8 for ai where i >= 4
col = (threadID_in_group * 4) + (i & 0x3) for ai where i = {0,..,7}
-
被乘数 B:
.btype
矩阵片段
元素(从低到高)
.u8/.s8一个包含单个
.b32寄存器的向量表达式,其中包含矩阵 B 中的四个.u8/.s8元素。b0, b1, b2, b3
.e4m3/.e5m2一个包含单个
.b32寄存器的向量表达式,其中包含矩阵 B 中的四个.e4m3/.e5m2元素。b0, b1. b2. b3
不同线程所持有的片段布局如图 88所示。
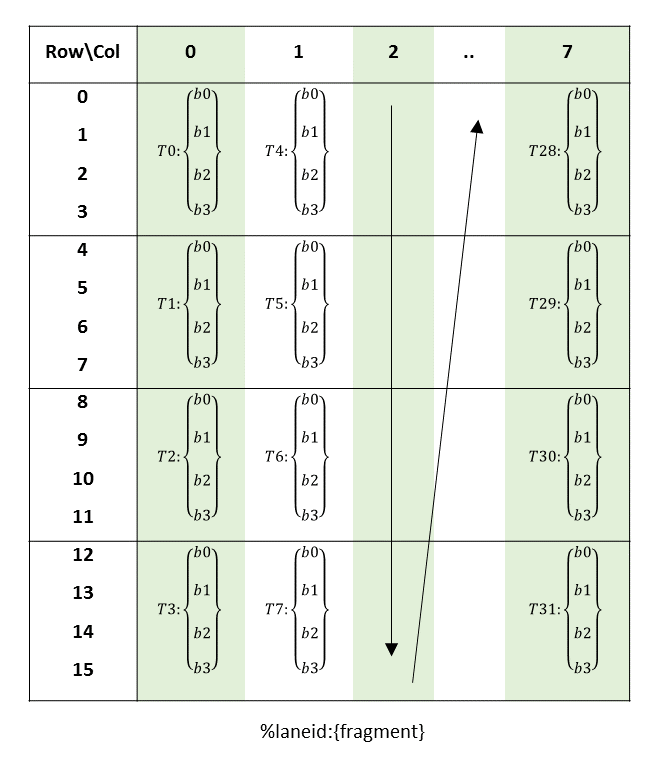
图 88 MMA .m16n8k16 矩阵片段布局(矩阵 B,
.u8/.s8类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 4) + i for bi where i = {0,..,3}
col = groupID
-
累加器(C 或 D):
.ctype / .dtype
矩阵片段
元素(从低到高)
.s32一个包含四个
.s32寄存器的向量表达式,其中包含矩阵 C(或 D)中的四个.s32元素。c0, c1, c2, c3
.f32一个包含四个
.f32寄存器的向量表达式,其中包含矩阵 C(或 D)中的四个.f32元素。c0, c1, c2, c3
.f16一个包含两个
.f16x2寄存器的向量表达式,其中每个寄存器包含矩阵 C(或 D)中的两个.f16元素。c0, c1, c1, c2
不同线程所持有的片段布局如图 89所示。
图 89 MMA .m16n8k16 矩阵片段布局(累加器矩阵 C/D,
.s32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ci where i < 2 groupID + 8 for ci where i >= 2
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
9.7.16.5.10. mma.m16n8k32 的矩阵片段#
一个执行 mma.m16n8k32 的 warp 将计算形状为 .m16n8k32 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
-
.s4或.u4:.atype
矩阵片段
元素(从低到高)
.s4/.u4一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的八个.u4/.s4元素。a0, a1, …, a14, a15
不同线程所持有的片段布局如图 90所示。
图 90 MMA .m16n8k32 矩阵片段布局(矩阵 A,
.u4/.s4类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where i < 8 groupID + 8 for ai where i >= 8
col = (threadID_in_group * 8) + (i & 0x7) for ai where i = {0,..,15}
-
.s8或.u8或.e4m3或.e5m2或.e3m2或.e2m3或.e2m1:.atype
矩阵片段
元素(从低到高)
.s8/.u8一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的四个.s8/.u8元素。a0, a1, .., a14, a15
.e4m3/.e5m2/.e3m2/.e2m3/.e2m1一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的四个.e4m3/.e5m2/.e3m2/.e2m3/.e2m1元素。a0, a1, …, a14, a15
不同线程所持有的片段布局如图 91所示。
图 91 MMA .m16n8k32 矩阵片段布局(矩阵 A,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 4 || 8 <= i < 12 groupID + 8 otherwise
col = (threadID_in_group 4) + (i & 0x3) for ai where i < 8 (threadID_in_group 4) + (i & 0x3) + 16 for ai where i >= 8
-
-
被乘数 B:
-
.s4或.u4:.btype
矩阵片段
元素(从低到高)
.s4/.u4一个包含单个
.b32寄存器的向量表达式,其中包含矩阵 B 中的八个.s4/.u4元素。b0, b1, b2, b3, b4, b5, b6, b7
不同线程所持有的片段布局如图 92所示。
图 92 MMA .m16n8k32 矩阵片段布局(矩阵 B,
.u4/.s4类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 8) + (i & 0x7) for bi where i = {0,..,7} col = groupID
-
.s8或.u8或.e4m3或.e5m2或.e3m2或.e2m3或.e2m1:.btype
矩阵片段
元素(从低到高)
.s8/.u8一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的四个.s8/.u8元素。b0, b1, b2, b3, b4, b5, b6, b7
.e4m3/.e5m2/.e3m2/.e2m3/.e2m1一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的四个.e4m3/.e5m2/.e3m2/.e2m3/.e2m1元素。b0, b1, b2, b3, b4, b5, b6, b7
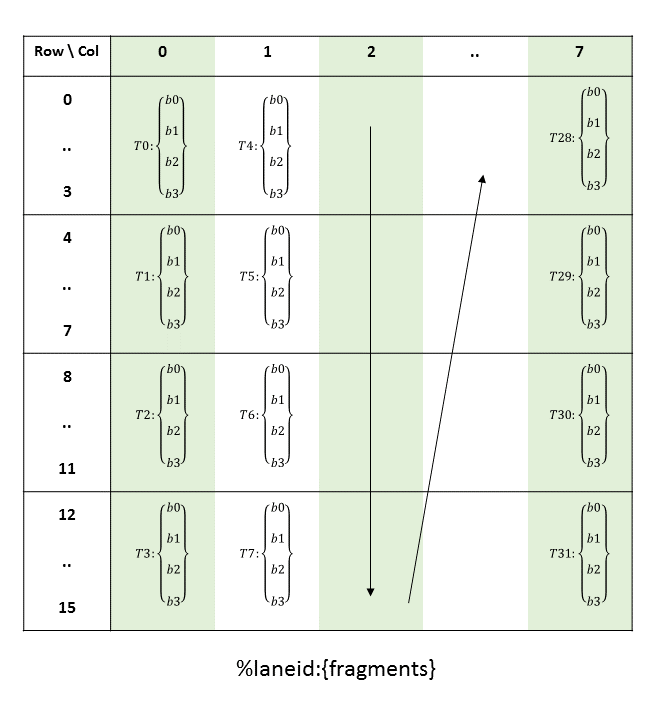
图 93 MMA .m16n8k32 矩阵片段布局(矩阵 B 的第 0–15 行,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。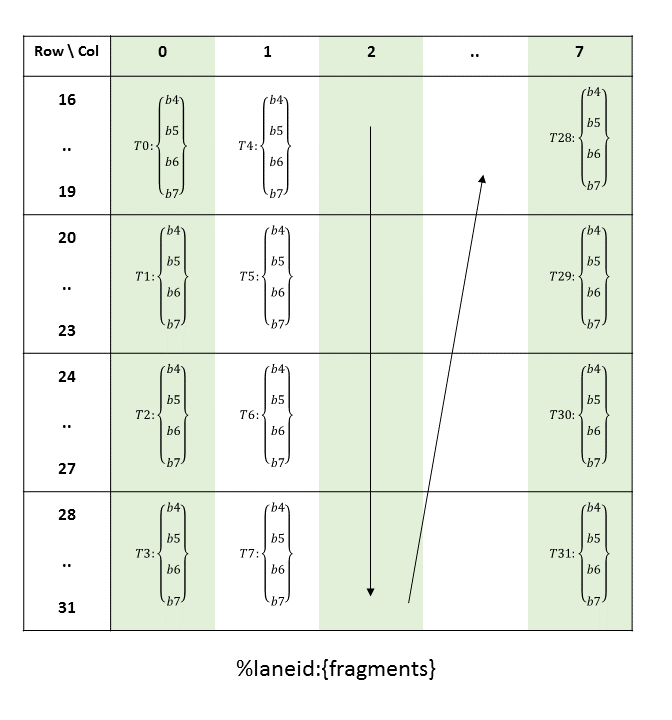
图 94 MMA .m16n8k32 矩阵片段布局(矩阵 B 的第 16–31 行,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group 4) + (i & 0x3) for bi where i < 4 (threadID_in_group 4) + (i & 0x3) + 16 for bi where i >= 4
col = groupID
-
-
累加器(C 或 D):
.ctype / .dtype
矩阵片段
元素(从低到高)
.s32一个包含四个
.s32寄存器的向量表达式,其中包含矩阵 C(或 D)中的四个.s32元素。c0, c1, c2, c3
.f32一个包含四个
.f32寄存器的向量表达式,其中包含矩阵 C(或 D)中的四个.f32元素。c0, c1, c2, c3
.f16一个包含两个
.f16x2寄存器的向量表达式,其中每个寄存器包含矩阵 C(或 D)中的两个.f16元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 95所示。
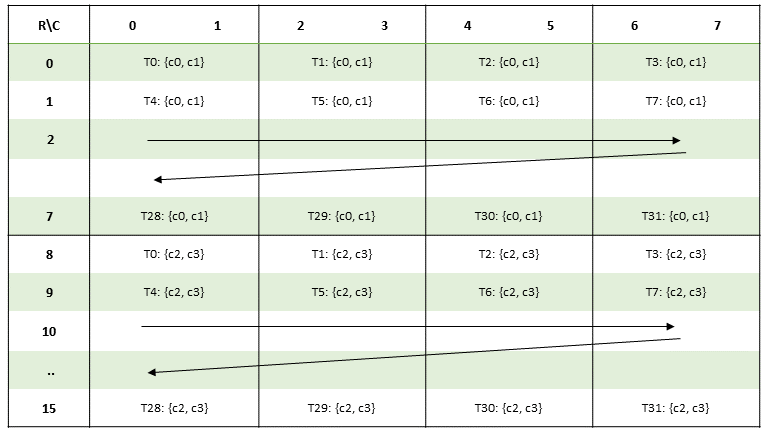
图 95 MMA .m16n8k32 矩阵片段布局(累加器矩阵 C/D,
.s32/.f32/.f16类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ci where i < 2 groupID + 8 for ci where i >= 2
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
9.7.16.5.11. mma.m16n8k64 的矩阵片段#
执行 mma.m16n8k64 的一个 warp 将计算形状为 .m16n8k64 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素(从低到高)
.s4/.u4一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的八个.s4/.u4元素。a0, a1, …, a30, a31
.e2m1一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的八个.e2m1元素。a0, a1, …, a30, a31
不同线程所持有的片段布局如图 96所示。
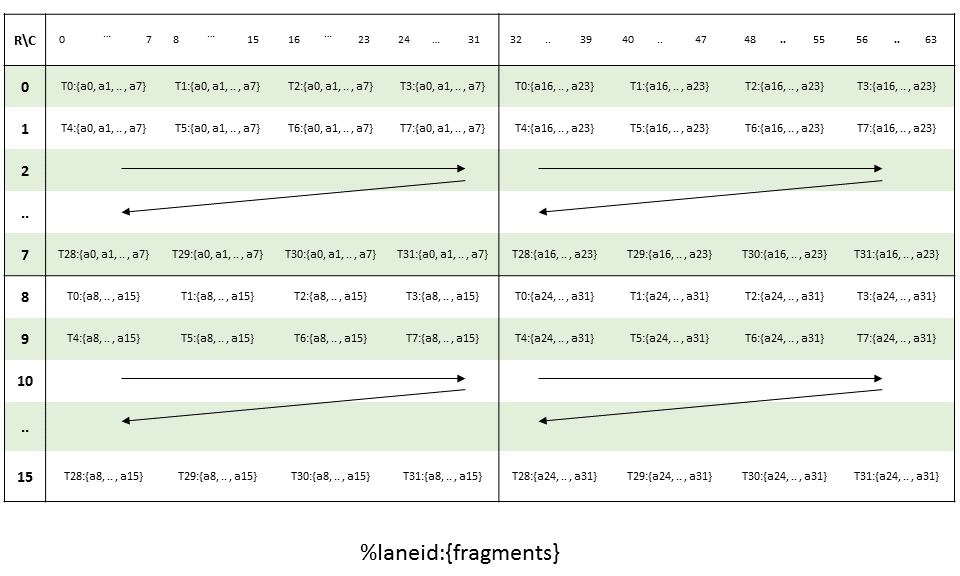
图 96 MMA .m16n8k64 矩阵片段布局(矩阵 A,
.u4/.s4/.e2m1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 8 || 16 <= i < 24 groupID + 8 otherwise
col = (threadID_in_group 8) + (i & 0x7) for ai where i < 16 (threadID_in_group 8) + (i & 0x7) + 32 for ai where i >= 16
-
被乘数 B:
.btype
矩阵片段
元素(从低到高)
.s4/.u4一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的八个.s4/.u4元素。b0, b1, …, b14, b15
.e2m1一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的八个.e2m1元素。b0, b1, …, b14, b15
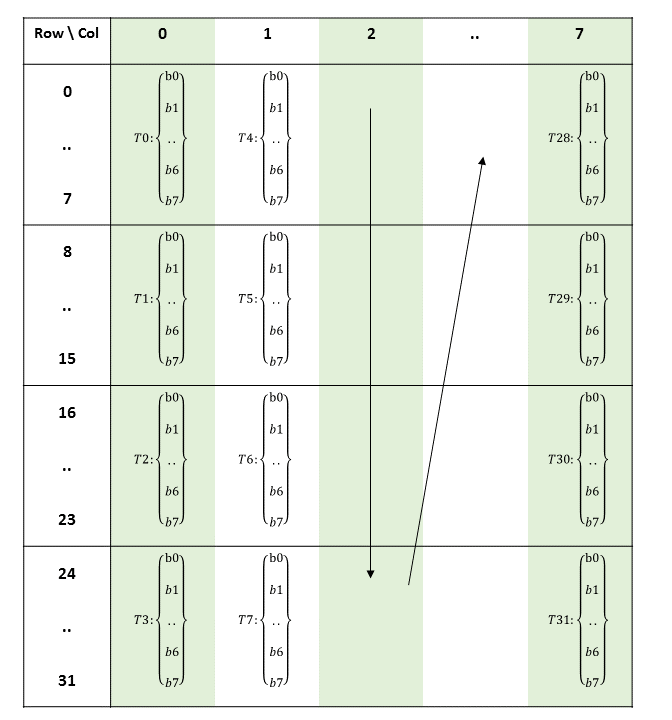
图 97 MMA .m16n8k64 矩阵片段布局(矩阵 B 的第 0–31 行,
.u4/.s4/.e2m1类型)。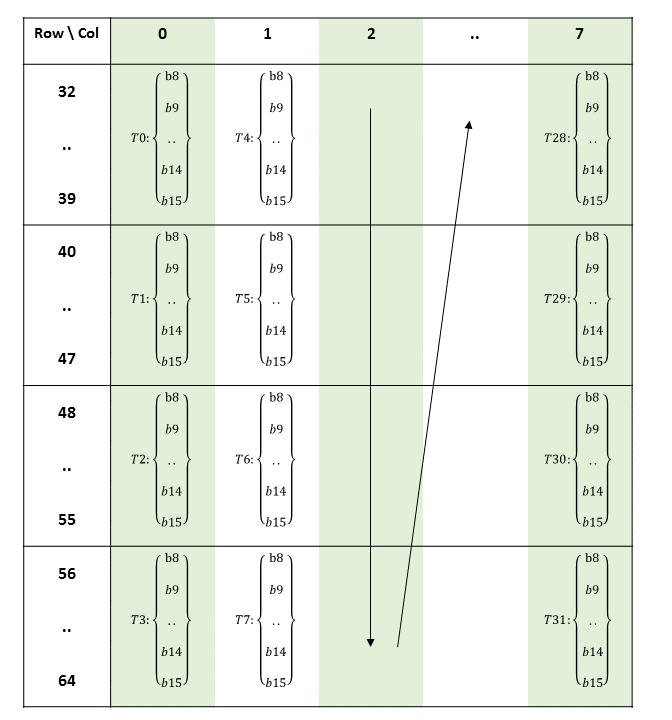
图 98 MMA .m16n8k64 矩阵片段布局(矩阵 B 的第 32–63 行,
.u4/.s4/.e2m1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group 8) + (i & 0x7) for bi where i < 8 (threadID_in_group 8) + (i & 0x7) + 32 for bi where i >= 8
col = groupID
-
累加器(C 或 D):
.ctype / .dtype
矩阵片段
元素(从低到高)
.s32一个包含四个
.s32寄存器的向量表达式,包含矩阵 C(或 D)中的四个.s32元素。c0, c1, c2, c3
.f32一个包含四个
.f32寄存器的向量表达式,包含矩阵 C(或 D)中的四个.f32元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 99所示。
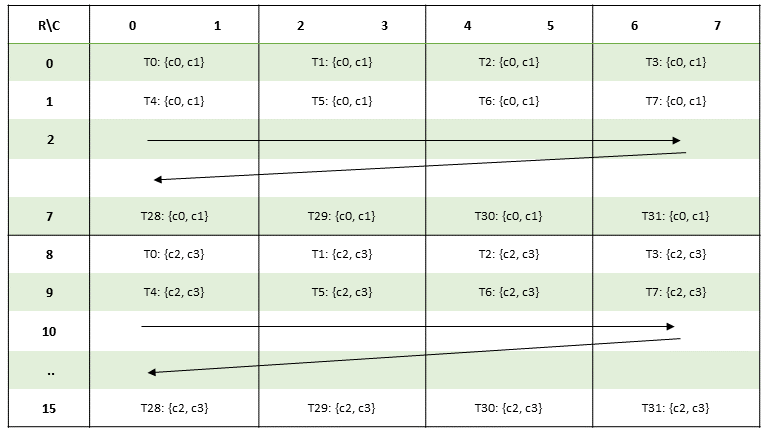
图 99 MMA .m16n8k64 累加器矩阵 C/D 的片段布局(
.s32/.f32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ci where i < 2 groupID + 8 for ci where i >= 2
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0,..,3}
9.7.16.5.12. mma.m16n8k128 的矩阵片段#
执行 mma.m16n8k128 的一个 warp 将计算形状为 .m16n8k128 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素(从低到高)
.b1一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的三十二个.b1元素。a0, a1, …, a62, a63
不同线程所持有的片段布局如图 100所示。
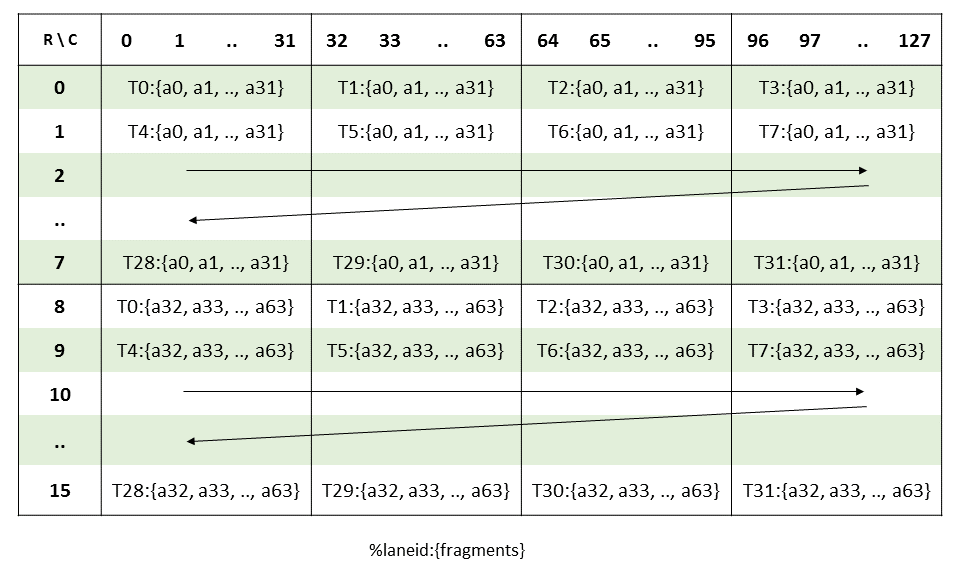
图 100 MMA .m16n8k128 矩阵片段布局(矩阵 A,
.b1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where i < 32 groupID + 8 for ai where i >= 32
col = (threadID_in_group * 32) + (i & 0x1F) for ai where i = {0, …,63}
-
被乘数 B:
.btype
矩阵片段
元素(从低到高)
.b1一个包含单个
.b32寄存器的向量表达式,该寄存器包含矩阵 B 中的三十二个.b1元素。b0, b1, … , b30, b31
不同线程所持有的片段布局如图 101所示。
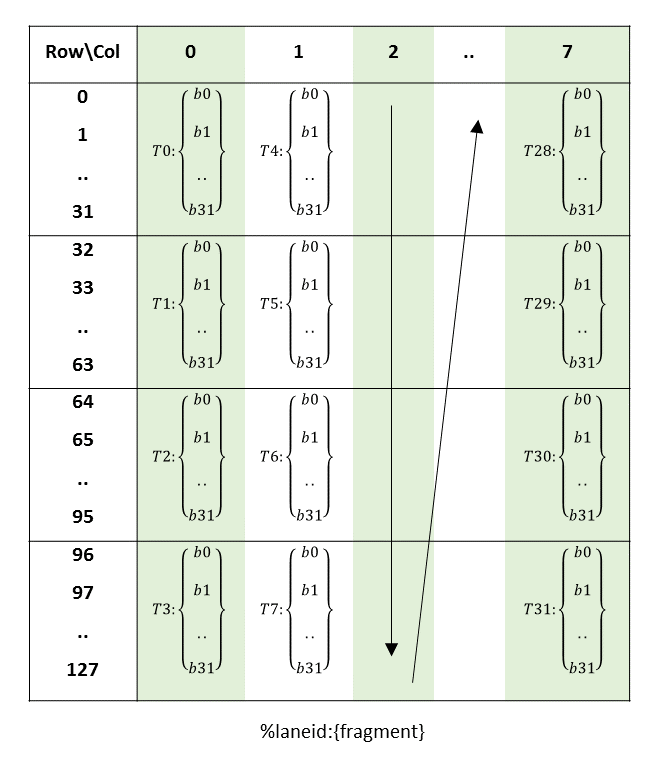
图 101 MMA .m16n8k128 矩阵片段布局(矩阵 B,
.b1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group * 32) + i for bi where i = {0,…,31} col = groupID
-
累加器(C 或 D):
.ctype / .dtype
矩阵片段
元素(从低到高)
.s32一个包含四个
.s32寄存器的向量表达式,包含矩阵 C(或 D)中的四个.s32元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 102所示。
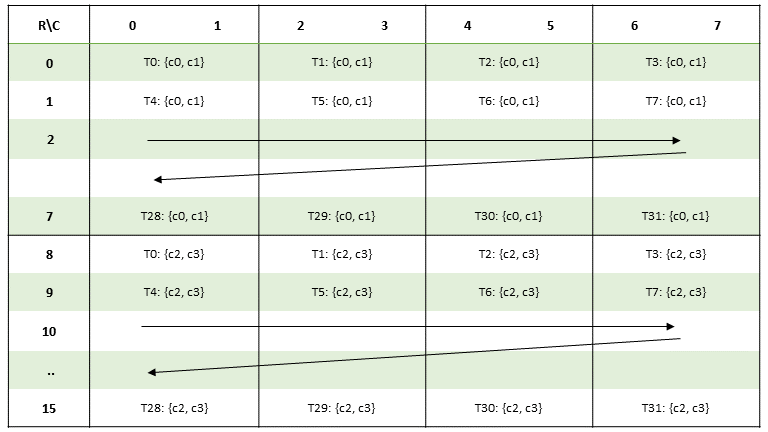
图 102 MMA .m16n8k128 累加器矩阵 C/D 的片段布局(
.s32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ci where i < 2 groupID + 8 for ci where i >= 2
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0, 1, 2, 3}
9.7.16.5.13. mma.m16n8k256 的矩阵片段#
执行 mma.m16n8k256 的一个 warp 将计算形状为 .m16n8k256 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素(从低到高)
.b1一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中的三十二个.b1元素。a0, a1, …, a126, a127
不同线程所持有的片段布局如图 103所示。
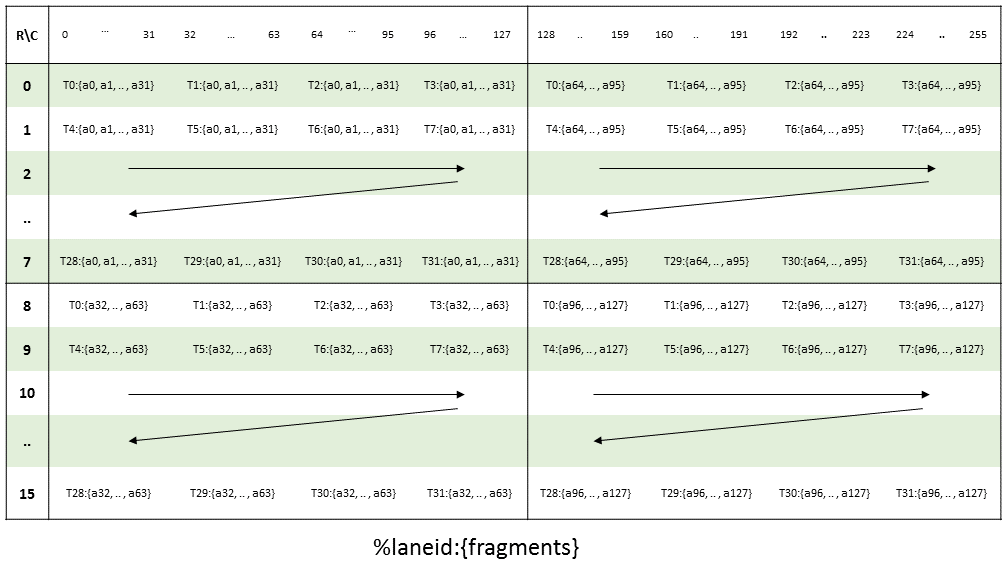
图 103 MMA .m16n8k256 矩阵片段布局(矩阵 A,
.b1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 32 || 64 <= i < 96 groupID + 8 otherwise
col = (threadID_in_group 32) + i for ai where i < 64 (threadID_in_group 32) + (i & 0x1F) + 128 for ai where i >= 64
-
被乘数 B:
.btype
矩阵片段
元素(从低到高)
.b1一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的三十二个.b1元素。b0, b1, …, b62, b63
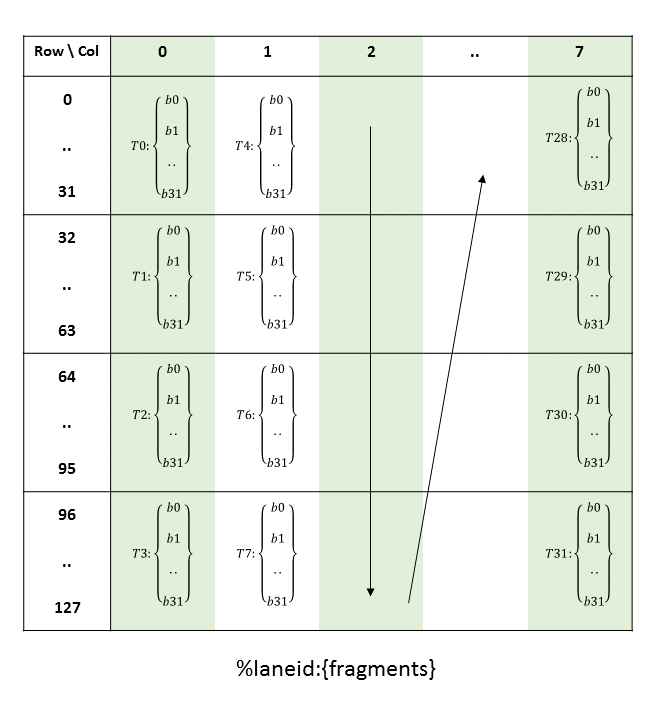
图 104 MMA .m16n8k256 矩阵片段布局(矩阵 B 的第 0–127 行,
.b1类型)。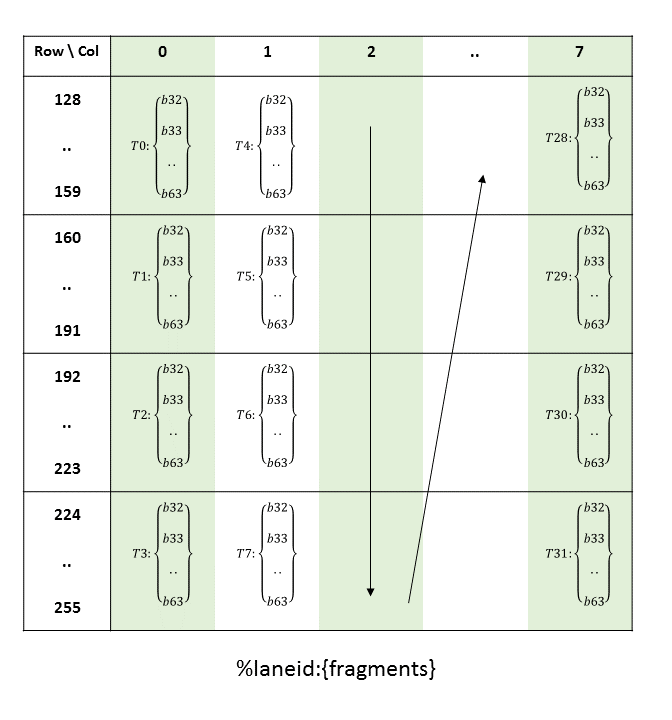
图 105 MMA .m16n8k256 矩阵片段布局(矩阵 B 的第 128–255 行,
.b1类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = (threadID_in_group 32) + (i & 0x1F) for bi where i < 32 (threadID_in_group 32) + (i & 0x1F) + 128 for bi where i >= 32
col = groupID
-
累加器(C 或 D):
.ctype / .dtype
矩阵片段
元素(从低到高)
.s32一个包含四个
.s32寄存器的向量表达式,包含矩阵 C(或 D)中的四个.s32元素。c0, c1, c2, c3
不同线程所持有的片段布局如图 106所示。
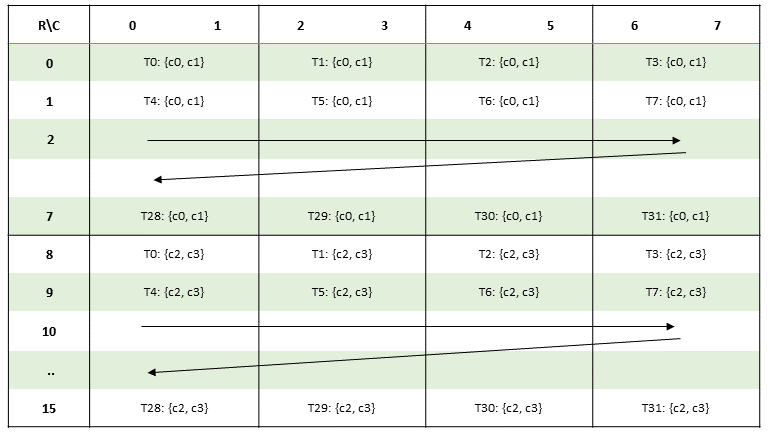
图 106 MMA .m16n8k256 累加器矩阵 C/D 的片段布局(
.s32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ci where i < 2 groupID + 8 for ci where i >= 2
col = (threadID_in_group * 2) + (i & 0x1) for ci where i = {0, 1, 2, 3}
9.7.16.5.14. 乘加指令:mma#
mma
执行矩阵乘加运算
语法
半精度浮点类型:
mma.sync.aligned.m8n8k4.alayout.blayout.dtype.f16.f16.ctype d, a, b, c;
mma.sync.aligned.m16n8k8.row.col.dtype.f16.f16.ctype d, a, b, c;
mma.sync.aligned.m16n8k16.row.col.dtype.f16.f16.ctype d, a, b, c;
.alayout = {.row, .col};
.blayout = {.row, .col};
.ctype = {.f16, .f32};
.dtype = {.f16, .f32};
其他浮点类型:
mma.sync.aligned.m16n8k4.row.col.f32.tf32.tf32.f32 d, a, b, c;
mma.sync.aligned.m16n8k8.row.col.f32.atype.btype.f32 d, a, b, c;
mma.sync.aligned.m16n8k16.row.col.f32.bf16.bf16.f32 d, a, b, c;
mma.sync.aligned.shape.row.col.dtype.f8type.f8type.ctype d, a, b, c;
mma.sync.aligned.m16n8k32.row.col.kind.dtype.f8f6f4type.f8f6f4type.ctype d, a, b, c;
.atype = {.bf16, .tf32};
.btype = {.bf16, .tf32};
.f8type = {.e4m3, .e5m2};
.f8f6f4type = {.e4m3, .e5m2, .e3m2, .e2m3, .e2m1};
.ctype = {.f16, .f32};
.dtype = {.f16, .f32};
.shape = {.m16n8k16, .m16n8k32};
.kind = {.kind::f8f6f4};
带块缩放的其他浮点类型:
mma.sync.aligned.m16n8k64.row.col.kind.block_scale{.scale_vec_size}.f32.e2m1.e2m1.f32.stype d, a, b, c, scale-a-data, {byte-id-a, thread-id-a}, scale-b-data, {byte-id-b, thread-id-b};
.kind = {.kind::mxf4};
.scale_vec_size = {.scale_vec::2X};
.stype = {.ue8m0};
mma.sync.aligned.m16n8k64.row.col.kind.block_scale.scale_vec_size.f32.e2m1.e2m1.f32.stype d, a, b, c, scale-a-data, {byte-id-a, thread-id-a}, scale-b-data, {byte-id-b, thread-id-b};
.kind = {.kind::mxf4nvf4};
.scale_vec_size = {.scale_vec::2X, .scale_vec::4X};
.stype = {.ue8m0, .ue4m3};
mma.sync.aligned.m16n8k32.row.col.kind.block_scale{.scale_vec_size}.f32.f8f6f4type.f8f6f4type.f32.stype d, a, b, c, scale-a-data, {byte-id-a, thread-id-a}, scale-b-data, {byte-id-b, thread-id-b};
.kind = {.kind::mxf8f6f4};
.scale_vec_size = {.scale_vec::1X};
.f8f6f4type = {.e4m3, .e5m2, .e3m2, .e2m3, .e2m1};
.stype = {.ue8m0};
双精度浮点类型:
mma.sync.aligned.shape.row.col.f64.f64.f64.f64 d, a, b, c;
.shape = {.m8n84, .m16n8k4, .m16n8k8, .m16n8k16};
整数类型:
mma.sync.aligned.shape.row.col{.satfinite}.s32.atype.btype.s32 d, a, b, c;
.shape = {.m8n8k16, .m16n8k16, .m16n8k32}
.atype = {.u8, .s8};
.btype = {.u8, .s8};
mma.sync.aligned.shape.row.col{.satfinite}.s32.atype.btype.s32 d, a, b, c;
.shape = {.m8n8k32, .m16n8k32, .m16n8k64}
.atype = {.u4, .s4};
.btype = {.u4, .s4};
单比特:
mma.sync.aligned.shape.row.col.s32.b1.b1.s32.bitOp.popc d, a, b, c;
.bitOp = {.xor, .and}
.shape = {.m8n8k128, .m16n8k128, .m16n8k256}
说明
执行 MxNxK 矩阵乘加运算 D = A*B+C,其中 A 矩阵为 MxK,B 矩阵为 KxN,C 和 D 矩阵为 MxN。
限定符 .block_scale 指明在执行矩阵乘加运算之前,矩阵 A 和 B 分别先用 scale_A 和 scale_B 矩阵缩放,具体如 mma.sync 的块缩放 一节所述。scale_A 和 Scale_B 矩阵内各元素对应的数据类型由 .stype 指定。限定符 .scale_vec_size 指定 scale_A 矩阵的列数和矩阵 scale_B 的行数。
.kind、.stype 和 .scale_vec_size 的有效组合如 表 45 所述。对于带 .kind::mxf4 的 mma,未指定限定符 .scale_vec_size 时默认为 2X。相反,当 .kind 指定为 .kind::mxf8f6f4 时,限定符 .scale_vec_size 默认为 1X。但对于 .kind::mxf4nvf4,必须提供有效的 .scale_vec_size。
执行 mma.sync.m8n8k4 指令的 warp 计算 4 次矩阵乘加运算。其余 mma.sync 运算每个 warp 计算单次矩阵乘加运算。
对于单比特 mma.sync,乘法被替换为一系列逻辑运算;具体而言,mma.xor.popc 和 mma.and.popc 分别计算 A 的 k 位行与 B 的 k 位列的 XOR、AND,然后统计结果中被置位的位数(popc)。该结果被加到 C 的对应元素上并写入 D。
操作数 a 和 b 表示两个被乘数矩阵 A 和 B,c 和 d 表示累加器和目标矩阵,分布在 warp 的各线程之间。指定 .block_scale 限定符时,操作数 scale-a-data、scale-b-data 分别表示对应 scale_A 和 scale_B 矩阵的缩放矩阵元数据。元组 {byte-id-a, thread-id-a} 和 {byte-id-b, thread-id-b} 分别表示从相应元数据参数 scale-a-data、scale-b-data 中为矩阵 scale_A 和 scale_B 选择的选择器。操作数 scale-a-data、scale-b-data 的类型为 .b32。操作数 byte-id-a、thread-id-a、byte-id-b、thread-id-b 是无符号 16 位整数值。有关选择器参数的更多细节,请参见 mma.sync 的块缩放 一节。
每个线程中的寄存器持有矩阵的一个片段,如 使用 mma 指令的矩阵乘加运算 所述。
限定符 .dtype、.atype、.btype 和 .ctype 分别指明矩阵 D、A、B 和 C 中元素的数据类型。限定符 .stype 指明矩阵 scale_A 和 scale_B 中元素的数据类型。特定形状有类型限制:
.m8n8k4:当.ctype为.f32时,.dtype也必须为.f32。-
.m16n8k8:.dtype必须与.ctype相同。.atype必须与.btype相同。
-
.m16n8k16和.m16n8k32:.dtype必须与.ctype相同。
限定符 .alayout 和 .blayout 分别指明矩阵 A 和 B 的行主序或列主序布局。
当 .kind 为 .kind::mxf8f6f4 或 .kind::f8f6f4 时,各个 4 位和 6 位浮点类型元素必须打包进 8 位容器。.e2m1 类型的矩阵元素位于 8 位容器的中间 4 位,容器的上 2 位和下 2 位为填充。当矩阵元素为 .e3m2 或 .e2m3 类型时,矩阵元素位于 8 位容器的低 6 位,容器的上 2 位为填充。相反,请注意在使用带 .kind::mxf4 或 .kind::mxf4nvf4 的 mma 时,即使矩阵元素为 .e2m1 类型,也无需显式填充。
- 精度与舍入:
-
-
.f16浮点运算:矩阵 A 和 B 的逐元素乘法以至少单精度执行。当
.ctype或.dtype为.f32时,中间值的累加以至少单精度执行。当.ctype和.dtype都指定为.f16时,累加以至少半精度执行。累加顺序、舍入以及次正规数输入的处理均未指定。
-
.e4m3、.e5m2、.e3m2、.e2m3、.e2m1浮点运算:矩阵 A 和 B 的逐元素乘法以指定精度执行。中间值的累加以至少单精度执行。
累加顺序、舍入以及次正规数输入的处理均未指定。
-
.bf16和.tf32浮点运算:矩阵 A 和 B 的逐元素乘法以指定精度执行。中间值的累加以至少单精度执行。
累加顺序、舍入以及次正规数输入的处理均未指定。
-
.f64浮点运算:逐元素乘法与加法运算的精度与
.f64精度融合乘加相同。受支持的舍入修饰符有:.rn:尾数 LSB 就近偶数舍入。这是默认值。.rz:尾数 LSB 向零舍入。.rm:尾数 LSB 向负无穷舍入。.rp:尾数 LSB 向正无穷舍入。
-
整数运算:
整数
mma运算使用.s32累加器执行。.satfinite限定符指明溢出时累加值被限制在 MIN_INT32.. MAX_INT32 范围内(这两个边界分别定义为最小负 32 位有符号整数和最大正 32 位有符号整数)。若未指定
.satfinite,则累加值改为回绕。
-
必需的 .sync 限定符指明 mma 指令使执行线程等待,直到 warp 中所有线程都执行同一条 mma 指令后才继续执行。
必需的 .aligned 限定符指明 warp 中所有线程都必须执行同一条 mma 指令。在条件执行的代码中,只有当确知 warp 中所有线程对该条件的求值结果相同时,才应使用 mma 指令,否则行为未定义。
若同一 warp 中所有线程未使用相同的限定符,或 warp 中任一线程已退出,则 mma 指令的行为未定义。
半精度浮点类型示例
// f16 elements in C and D matrix
.reg .f16x2 %Ra<2> %Rb<2> %Rc<4> %Rd<4>
mma.sync.aligned.m8n8k4.row.col.f16.f16.f16.f16
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
// f16 elements in C and f32 elements in D
.reg .f16x2 %Ra<2> %Rb<2> %Rc<4>
.reg .f32 %Rd<8>
mma.sync.aligned.m8n8k4.row.col.f32.f16.f16.f16
{%Rd0, %Rd1, %Rd2, %Rd3, %Rd4, %Rd5, %Rd6, %Rd7},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
// f32 elements in C and D
.reg .f16x2 %Ra<2>, %Rb<1>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k8.row.col.f32.f16.f16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .f16x2 %Ra<4>, %Rb<2>, %Rc<2>, %Rd<2>;
mma.sync.aligned.m16n8k16.row.col.f16.f16.f16.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1};
.reg .f16 %Ra<4>, %Rb<2>;
.reg .f32 %Rc<2>, %Rd<2>;
mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
其他浮点类型示例
.reg .b32 %Ra<2>, %Rb<1>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k4.row.col.f32.tf32.tf32.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .f16x2 %Ra<2>, %Rb<1>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k8.row.col.f32.bf16.bf16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<2>, %Rb<1>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k8.row.col.f32.tf32.tf32.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Rb2, %Rb3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .f16x2 %Ra<2>, %Rb<1>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k16.row.col.f32.bf16.bf16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k32.row.col.f32.e4m3.e5m2.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k16.row.col.f32.e5m2.e4m3.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .b32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k32.row.col.f16.e4m3.e5m2.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .b32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k16.row.col.f16.e5m2.e5m2.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1},
{%Rb0},
{%Rc0, %Rc1};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k32.row.col.kind::f8f6f4.f32.e3m2.e2m3.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .b32 %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k32.row.col.kind::f8f6f4.f16.e2m3.e2m1.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1};
整数类型示例
.reg .b32 %Ra, %Rb, %Rc<2>, %Rd<2>;
// s8 elements in A and u8 elements in B
mma.sync.aligned.m8n8k16.row.col.satfinite.s32.s8.u8.s32
{%Rd0, %Rd1},
{%Ra},
{%Rb},
{%Rc0, %Rc1};
// u4 elements in A and B matrix
mma.sync.aligned.m8n8k32.row.col.satfinite.s32.u4.u4.s32
{%Rd0, %Rd1},
{%Ra},
{%Rb},
{%Rc0, %Rc1};
// s8 elements in A and u8 elements in B
.reg .b32 %Ra<2>, %Rb, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k16.row.col.satfinite.s32.s8.u8.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb},
{%Rc0, %Rc1, %Rc2, %Rc3};
// u4 elements in A and s4 elements in B
.reg .b32 %Ra<2>, %Rb, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k32.row.col.satfinite.s32.u4.s4.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb},
{%Rc0, %Rc1, %Rc2, %Rc3};
// s8 elements in A and s8 elements in B
.reg .b32 %Ra<4>, %Rb<2>, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k32.row.col.satfinite.s32.s8.s8.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
// u8 elements in A and u8 elements in B
.reg .b32 %Ra<4>, %Rb<2>, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k64.row.col.satfinite.s32.u4.u4.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1 },
{%Rc0, %Rc1, %Rc2, %Rc3};
单比特类型示例
// b1 elements in A and B
.reg .b32 %Ra, %Rb, %Rc<2>, %Rd<2>;
mma.sync.aligned.m8n8k128.row.col.s32.b1.b1.s32.and.popc
{%Rd0, %Rd1},
{%Ra},
{%Rb},
{%Rc0, %Rc1};
// b1 elements in A and B
.reg .b32 %Ra, %Rb, %Rc<2>, %Rd<2>;
mma.sync.aligned.m8n8k128.row.col.s32.b1.b1.s32.xor.popc
{%Rd0, %Rd1},
{%Ra},
{%Rb},
{%Rc0, %Rc1};
.reg .b32 %Ra<2>, %Rb, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k128.row.col.s32.b1.b1.s32.xor.popc
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<2>, %Rb, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k128.row.col.s32.b1.b1.s32.and.popc
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<4>, %Rb<2>, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k256.row.col.s32.b1.b1.s32.xor.popc
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
.reg .b32 %Ra<4>, %Rb<2>, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k256.row.col.s32.b1.b1.s32.and.popc
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
.f64 浮点类型示例
.reg .f64 %Ra, %Rb, %Rc<2>, %Rd<2>;
mma.sync.aligned.m8n8k4.row.col.f64.f64.f64.f64
{%Rd0, %Rd1},
{%Ra},
{%Rb},
{%Rc0, %Rc1};
.reg .f64 %Ra<8>, %Rb<4>, %Rc<4>, %Rd<4>;
mma.sync.aligned.m16n8k4.row.col.f64.f64.f64.f64.rn
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0},
{%Rc0, %Rc1, %Rc2, %Rc3};
mma.sync.aligned.m16n8k8.row.col.f64.f64.f64.f64.rn
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3};
mma.sync.aligned.m16n8k16.row.col.f64.f64.f64.f64.rn
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3, %Ra4, %Ra5, %Ra6, %Ra7},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3};
带块缩放的 mma 示例
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
mma.sync.aligned.m16n8k64.row.col.kind::mxf4.block_scale.f32.e2m1.e2m1.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3},
scaleAData, {2, 1}, scaleBData, {2, 3};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .u16 bidA, bidB, tidA, tidB;
mma.sync.aligned.m16n8k64.row.col.kind::mxf4nvf4.block_scale.scale_vec::4X.f32.e2m1.e2m1.f32.ue4m3
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3},
scaleAData, {bidA, tidA}, scaleBData, {bidB, tidB};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .u16 bidA, bidB, tidA, tidB;
mma.sync.aligned.m16n8k64.row.col.kind::mxf4nvf4.block_scale.scale_vec::4X.f32.e2m1.e2m1.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3},
scaleAData, {bidA, tidA}, scaleBData, {bidB, tidB};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
mma.sync.aligned.m16n8k32.row.col.kind::mxf8f6f4.block_scale.scale_vec::1X.f32.e3m2.e2m1.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3},
scaleAData, {0, 1}, scaleBData, {0, 1};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
mma.sync.aligned.m16n8k32.row.col.kind::mxf8f6f4.block_scale.scale_vec::1X.f32.e4m3.e5m2.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3},
scaleAData, {0, 1}, scaleBData, {0, 0};
9.7.16.5.15. Warp 级矩阵加载指令:ldmatrix#
ldmatrix
集体地从共享内存加载一个或多个矩阵,供 mma 指令使用
语法
ldmatrix.sync.aligned.shape.num{.trans}{.ss}.type r, [p];
ldmatrix.sync.aligned.m8n16.num{.ss}.dst_fmt.src_fmt r, [p];
ldmatrix.sync.aligned.m16n16.num.trans{.ss}.dst_fmt.src_fmt r, [p];
ldmatrix.sync.aligned.m8n16.num{.ss}.dtype.ctype r, [p];
.shape = {.m8n8, .m16n16};
.num = {.x1, .x2, .x4};
.ss = {.shared{::cta}};
.type = {.b16, .b8};
.dst_fmt = { .b8x16 };
.src_fmt = { .b6x16_p32, .b4x16_p64 };
.dtype = { .s8 };
.ctype = { .s4 };
说明
在 warp 中的所有线程之间,从地址操作数 p 所指示的位置、从 .shared 状态空间集体地将一个或多个矩阵加载到目标寄存器 r 中。如果未提供状态空间,则使用通用寻址,此时 p 中的地址指向 .shared 空间。如果该通用地址不落在 .shared 状态空间中,则行为未定义。该指令可选地支持在加载期间进行元素大小扩展。
.shape 限定符指示所加载矩阵的维度。每个矩阵元素保存 16 位、8 位、6 位或 4 位数据。
下表显示了每种 .shape 的矩阵加载情形。
.shape |
矩阵形状 |
元素大小 |
|---|---|---|
|
8x8 |
16 位 |
|
16x16 |
8 位、6 位或 4 位 |
|
8x16 |
6 位或 4 位 |
下表显示了 6 位或 4 位数据加载的有效用法。
.src_fmt |
.shape |
源数据 |
填充 |
.dst_fmt |
|---|---|---|---|---|
|
|
16 个 6 位元素 |
32 位 |
|
|
||||
|
|
16 个 4 位元素 |
64 位 |
|
|
对于 .b6x16_p32 格式,源数据为 16 个无符号 6 位元素并带有 32 位填充。对于 .b4x16_p64 格式,源数据为 16 个无符号 4 位元素并带有 64 位填充。
下表显示了 4 位加载扩展为 8 位的有效用法。
.ctype |
.shape |
源数据 |
.dtype |
|---|---|---|---|
|
|
有符号 4 位元素 |
|
对于 .s4 类型,源数据是一串有符号 4 位元素,在加载期间被扩展为有符号 8 位值。
.num 的取值 .x1、.x2 和 .x4 分别表示一个、两个或四个矩阵。当 .shape 为 .m16n16 时,只有 .x1 和 .x2 是 .num 的有效取值。
必需的 .sync 限定符指示 ldmatrix 会使执行线程等待,直到 warp 中的所有线程都执行同一条 ldmatrix 指令后才恢复执行。
必需的 .aligned 限定符指示 warp 中的所有线程必须执行同一条 ldmatrix 指令。在条件执行的代码中,仅当已知 warp 中的所有线程对条件的求值结果相同时,才应使用 ldmatrix 指令,否则行为未定义。
如果所有线程未使用相同的限定符,或者 warp 中任何线程已退出,则 ldmatrix 的行为未定义。
目标操作数 r 是一个由花括号包围的向量表达式,根据 .num 的取值由 1、2 或 4 个 32 位寄存器组成。该向量表达式的每个分量保存来自相应矩阵的一个 fragment。
p 支持的寻址模式见 作为操作数的地址。
连续的 row 实例无需在内存中连续存储。每个矩阵所需的八个地址由八个线程提供,具体取决于 .num 的取值,如下表所示。每个地址对应矩阵一行的起始位置。地址 addr0–addr7 对应第一个矩阵的各行,地址 addr8–addr15 对应第二个矩阵的各行,依此类推。
|
线程 0–7 |
线程 8–15 |
线程 16–23 |
线程 24–31 |
|---|---|---|---|---|
|
addr0–addr7 |
– |
– |
– |
|
addr0–addr7 |
addr8–addr15 |
– |
– |
|
addr0–addr7 |
addr8–addr15 |
addr16–addr23 |
addr24–addr31 |
注释
对于 .target sm_75 或更低架构,所有线程都必须包含有效地址。否则行为未定义。对于 .num = .x1 和 .num = .x2,可将较低线程中包含的地址复制到较高线程,以获得预期的行为。
读取 8x8 矩阵时,一组四个连续线程加载 16 字节。矩阵地址必须相应地自然对齐。
warp 中的每个线程加载一行的各个 fragment,其中线程 0 在其寄存器 r 中接收第一个 fragment,依此类推。一组四个线程加载矩阵的整行,如 图 107 所示。
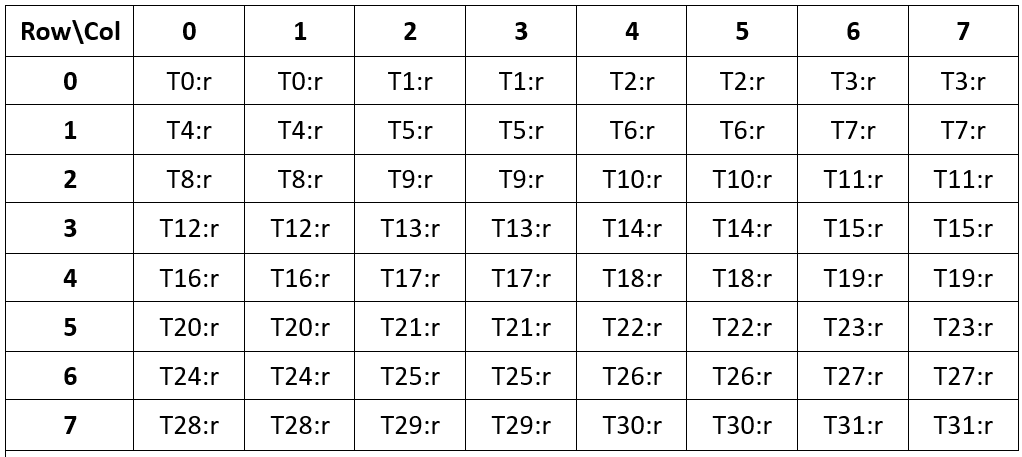
图 107 具有 16 位元素的一个 8x8 矩阵的 ldmatrix fragment 布局
当 .num = .x2 时,第二个矩阵的元素按照上表中的布局加载到每个线程的下一个目标寄存器中。类似地,当 .num = .x4 时,第三个和第四个矩阵的元素加载到每个线程的后续目标寄存器中。
对于矩阵形状 16x16,必须指定两个 .b32 类型的目标寄存器 r0 和 r1,并且每个寄存器中加载四个 8 位元素。对于 4 位或 6 位数据,8 位元素将分别带有 4 位或 2 位填充。
矩阵的整行可由一组四个连续且对齐的线程加载。warp 中的每个线程加载跨 2 行的 4 个连续列,如 图 108 所示。
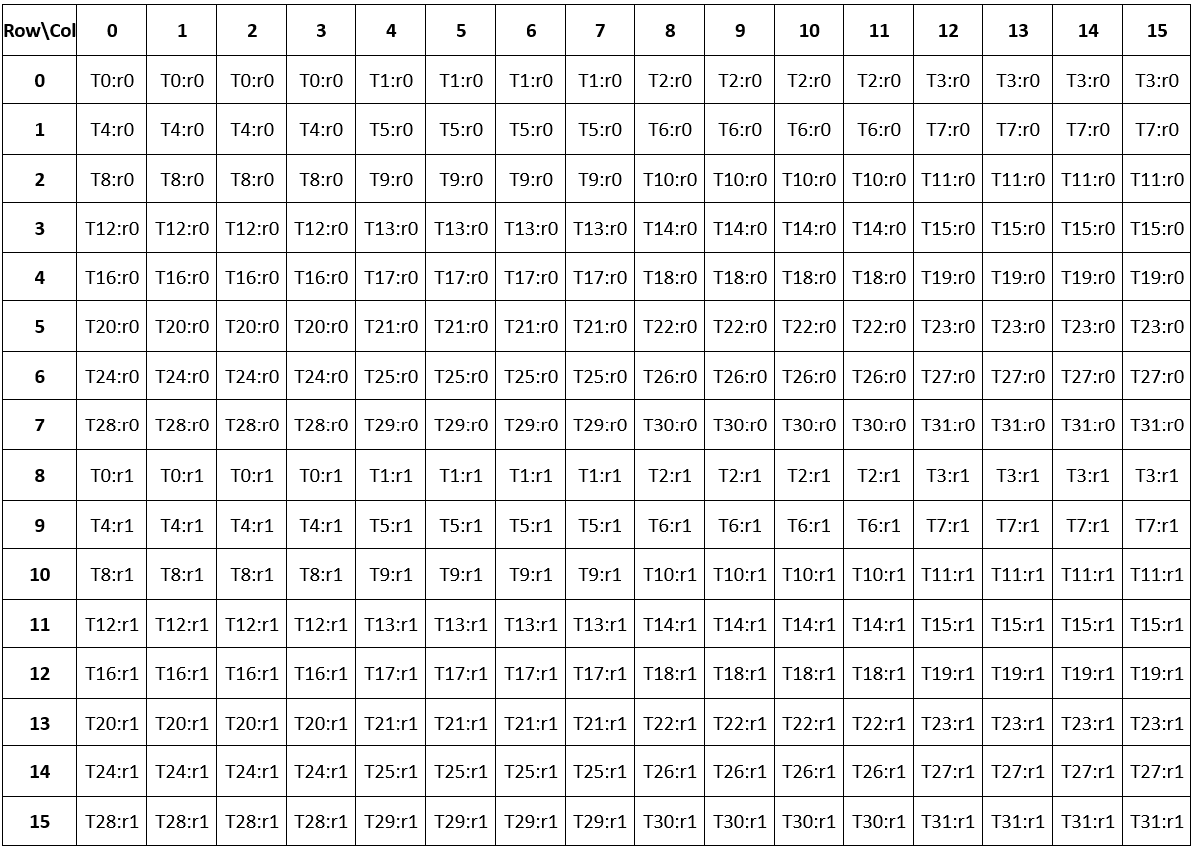
图 108 具有 8 位元素的一个 16x16 矩阵的 ldmatrix fragment 布局
对于矩阵形状 8x16,必须指定一个 .b32 类型的目标寄存器 r0,该寄存器中加载四个 8 位元素。对于 4 位或 6 位数据,8 位元素将分别带有 4 位或 2 位填充。
矩阵的整行可由一组四个连续且对齐的线程加载。warp 中的每个线程加载 4 个连续列,如 图 109 所示。
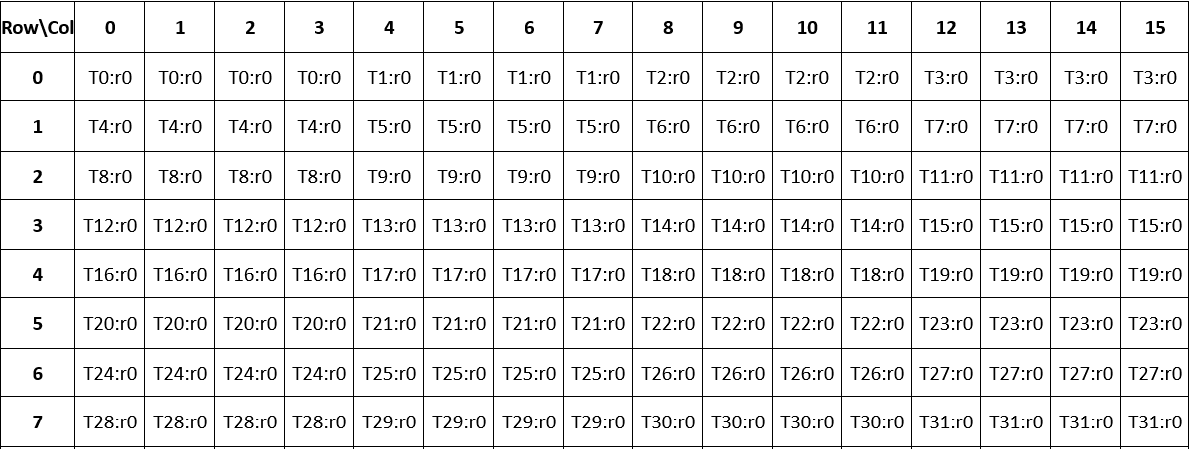
图 109 包含 4 位/6 位数据、具有 8 位元素的一个 8x16 矩阵的 ldmatrix fragment 布局
可选限定符 .trans 指示以列主序格式加载矩阵。但是,对于 16x16 矩阵,.trans 是必需的。
ldmatrix 指令在 内存一致性模型 中被视为弱内存操作。
示例
// Load a single 8x8 matrix using 64-bit addressing
.reg .b64 addr;
.reg .b32 d;
ldmatrix.sync.aligned.m8n8.x1.shared::cta.b16 {d}, [addr];
// Load two 8x8 matrices in column-major format
.reg .b64 addr;
.reg .b32 d<2>;
ldmatrix.sync.aligned.m8n8.x2.trans.shared.b16 {d0, d1}, [addr];
// Load four 8x8 matrices
.reg .b64 addr;
.reg .b32 d<4>;
ldmatrix.sync.aligned.m8n8.x4.b16 {d0, d1, d2, d3}, [addr];
// Load one 16x16 matrices of 64-bit elements and transpose them
.reg .b64 addr;
.reg .b32 d<2>;
ldmatrix.sync.aligned.m16n16.x1.trans.shared.b8 {d0, d1}, [addr];
// Load two 16x16 matrices of 64-bit elements and transpose them
.reg .b64 addr;
.reg .b32 d<4>;
ldmatrix.sync.aligned.m16n16.x2.trans.shared::cta.b8 {d0, d1, d2, d3}, [addr];
// Load two 16x16 matrices of 6-bit elements and transpose them
.reg .b64 addr;
.reg .b32 d<4>;
ldmatrix.sync.aligned.m16n16.x2.trans.shared::cta.b8x16.b6x16_p32 {d0, d1, d2, d3}, [addr];
// Load one 8x16 matrix of 4-bit signed elements expanded to 8-bit signed
.reg .b64 addr;
.reg .b32 d;
ldmatrix.sync.aligned.m8n16.x1.shared::cta.s8.s4 {d}, [addr];
9.7.16.5.16. Warp 级矩阵存储指令:stmatrix#
stmatrix
集体地将一个或多个矩阵存储到共享内存。
语法
stmatrix.sync.aligned.shape.num{.trans}{.ss}.type [p], r;
.shape = {.m8n8, .m16n8};
.num = {.x1, .x2, .x4};
.ss = {.shared{::cta}};
.type = {.b16, .b8};
说明
在 warp 中的所有线程之间,集体地将一个或多个矩阵存储到地址操作数 p 所指示的位置、存储到 .shared 状态空间。如果未提供状态空间,则使用通用寻址,此时 p 中的地址指向 .shared 空间。如果该通用地址不落在 .shared 状态空间中,则行为未定义。
.shape 限定符指示所加载矩阵的维度。每个矩阵元素保存 16 位或 8 位数据,由 .type 限定符指示。
.m16n8 形状仅对 .b8 类型有效。
.num 的取值 .x1、.x2 和 .x4 分别表示一个、两个或四个矩阵。
必需的 .sync 限定符指示 stmatrix 会使执行线程等待,直到 warp 中的所有线程都执行同一条 stmatrix 指令后才恢复执行。
必需的 .aligned 限定符指示 warp 中的所有线程必须执行同一条 stmatrix 指令。在条件执行的代码中,仅当已知 warp 中的所有线程对条件的求值结果相同时,才应使用 stmatrix 指令,否则行为未定义。
如果所有线程未使用相同的限定符,或者 warp 中任何线程已退出,则 stmatrix 的行为未定义。
源操作数 r 是一个由花括号包围的向量表达式,根据 .num 的取值由 1、2 或 4 个 32 位寄存器组成。该向量表达式的每个分量保存来自相应矩阵的一个 fragment。
p 支持的寻址模式见 作为操作数的地址。
连续的 row 实例无需在内存中连续存储。每个矩阵所需的八个地址由八个线程提供,具体取决于 .num 的取值,如下表所示。每个地址对应矩阵一行的起始位置。地址 addr0–addr7 对应第一个矩阵的各行,地址 addr8–addr15 对应第二个矩阵的各行,依此类推。
|
线程 0–7 |
线程 8–15 |
线程 16–23 |
线程 24–31 |
|---|---|---|---|---|
|
addr0–addr7 |
– |
– |
– |
|
addr0–addr7 |
addr8–addr15 |
– |
– |
|
addr0–addr7 |
addr8–addr15 |
addr16–addr23 |
addr24–addr31 |
存储 8x8 矩阵时,一组四个连续线程存储 16 字节。矩阵地址必须相应地自然对齐。
warp 中的每个线程存储一行的各个 fragment,其中线程 0 从其寄存器 r 中存储第一个 fragment,依此类推。一组四个线程存储矩阵的整行,如 图 110 所示。
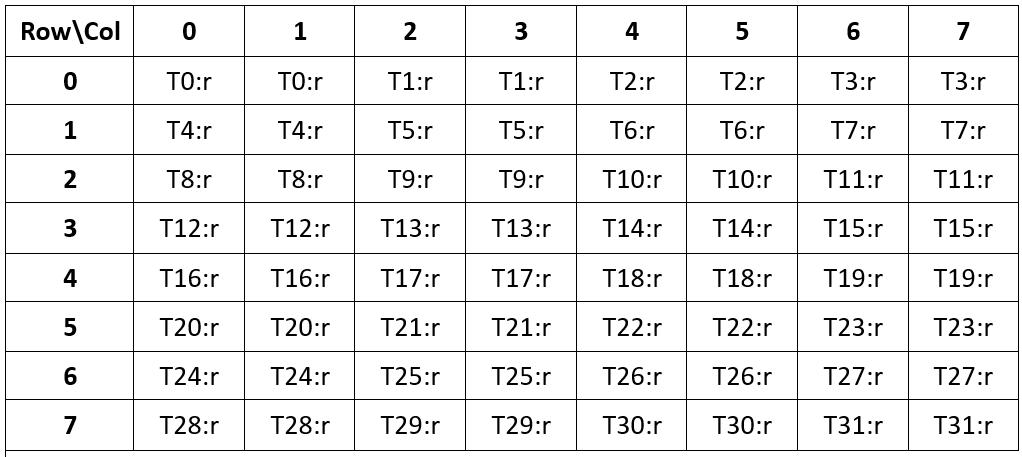
图 110 具有 16 位元素的一个 8x8 矩阵的 stmatrix fragment 布局
当 .num = .x2 时,第二个矩阵的元素按照上表中的布局从每个线程的下一个源寄存器中存储。类似地,当 .num = .x4 时,第三个和第四个矩阵的元素从每个线程的后续源寄存器中存储。
对于 16x8 矩阵形状,warp 中的 32 个线程每个为每个矩阵提供四个数据元素。
源操作数 r 中的每个元素均为 .b32 类型,包含四个 8 位元素 e0、e1、e2、e3,其中 e0 和 e3 分别包含寄存器 r 的 LSB 和 MSB。
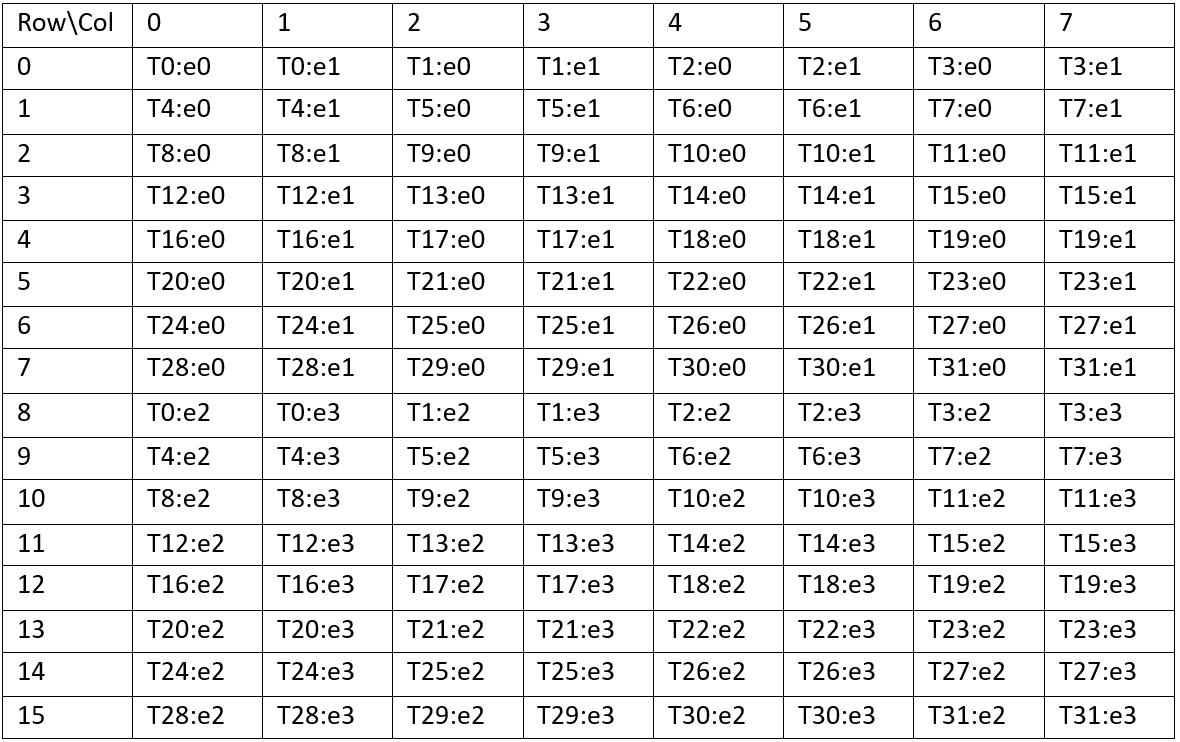
图 111 具有 8 位元素的一个 16x8 矩阵的 stmatrix fragment 布局
可选限定符 .trans 指示以列主序格式存储矩阵。但是,对于 16x8 矩阵,.trans 是必需的。
stmatrix 指令在 内存一致性模型 中被视为弱内存操作。
示例
// Store a single 8x8 matrix using 64-bit addressing
.reg .b64 addr;
.reg .b32 r;
stmatrix.sync.aligned.m8n8.x1.shared.b16 [addr], {r};
// Store two 8x8 matrices in column-major format
.reg .b64 addr;
.reg .b32 r<2>;
stmatrix.sync.aligned.m8n8.x2.trans.shared::cta.b16 [addr], {r0, r1};
// Store four 8x8 matrices
.reg .b64 addr;
.reg .b32 r<4>;
stmatrix.sync.aligned.m8n8.x4.b16 [addr], {r0, r1, r2, r3};
// Store a single 16x8 matrix using generic addressing
.reg .b64 addr;
.reg .b32 r;
stmatrix.sync.aligned.m16n8.x1.trans.shared.b8 [addr], {r};
// Store two 16x8 matrices
.reg .b64 addr;
.reg .b32 r<2>;
stmatrix.sync.aligned.m16n8.x2.trans.shared::cta.b8 [addr],{r0, r1};
// Store four 16x8 matrices
.reg .b64 addr;
.reg .b32 r<4>;
stmatrix.sync.aligned.m16n8.x4.b8 [addr], {r0, r1, r2, r3};
9.7.16.5.17. Warp 级矩阵转置指令:movmatrix#
movmatrix
在寄存器中跨 warp 转置矩阵。
语法
movmatrix.sync.aligned.shape.trans.type d, a;
.shape = {.m8n8};
.type = {.b16};
说明
在 warp 中的所有线程之间移动一个行主序矩阵,从源 a 读取元素,并将转置后的元素写入目标 d。
.shape 限定符指示被转置矩阵的维度。每个矩阵元素保存 16 位数据,由 .type 限定符指示。
必需的 .sync 限定符指示 movmatrix 会使执行线程等待,直到 warp 中的所有线程都执行同一条 movmatrix 指令后才恢复执行。
必需的 .aligned 限定符指示 warp 中的所有线程必须执行同一条 movmatrix 指令。在条件执行的代码中,仅当已知 warp 中的所有线程对条件的求值结果相同时,才应使用 movmatrix 指令,否则行为未定义。
操作数 a 和 d 是 32 位寄存器,分别包含输入矩阵和结果矩阵的 fragment。必需限定符 .trans 指示 d 中的结果矩阵是 a 所指定输入矩阵的转置。
warp 中的每个线程持有输入矩阵某一行的 fragment,其中线程 0 在寄存器 a 中持有第一个 fragment,依此类推。一组四个线程持有输入矩阵的整行,如 图 112 所示。
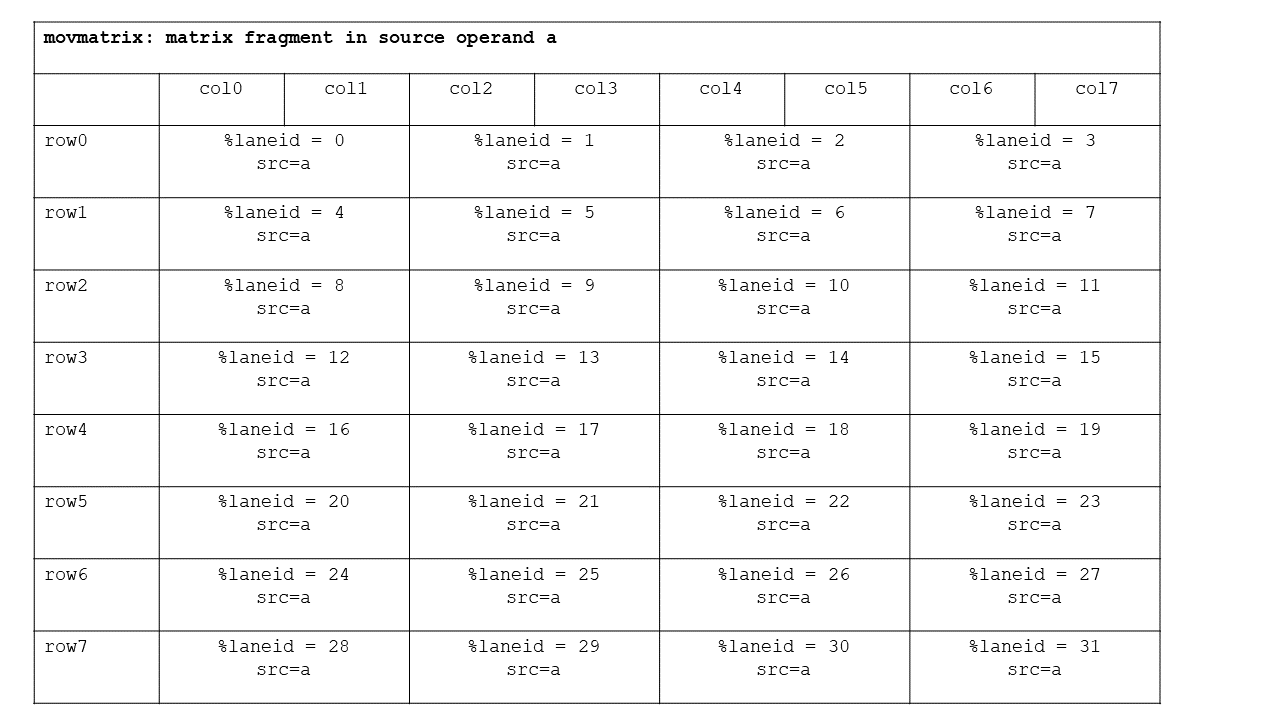
图 112 movmatrix 源矩阵 fragment 布局
warp 中的每个线程持有结果矩阵某一列的 fragment,其中线程 0 在寄存器 d 中持有第一个 fragment,依此类推。一组四个线程持有结果矩阵的整列,如 图 113 所示。
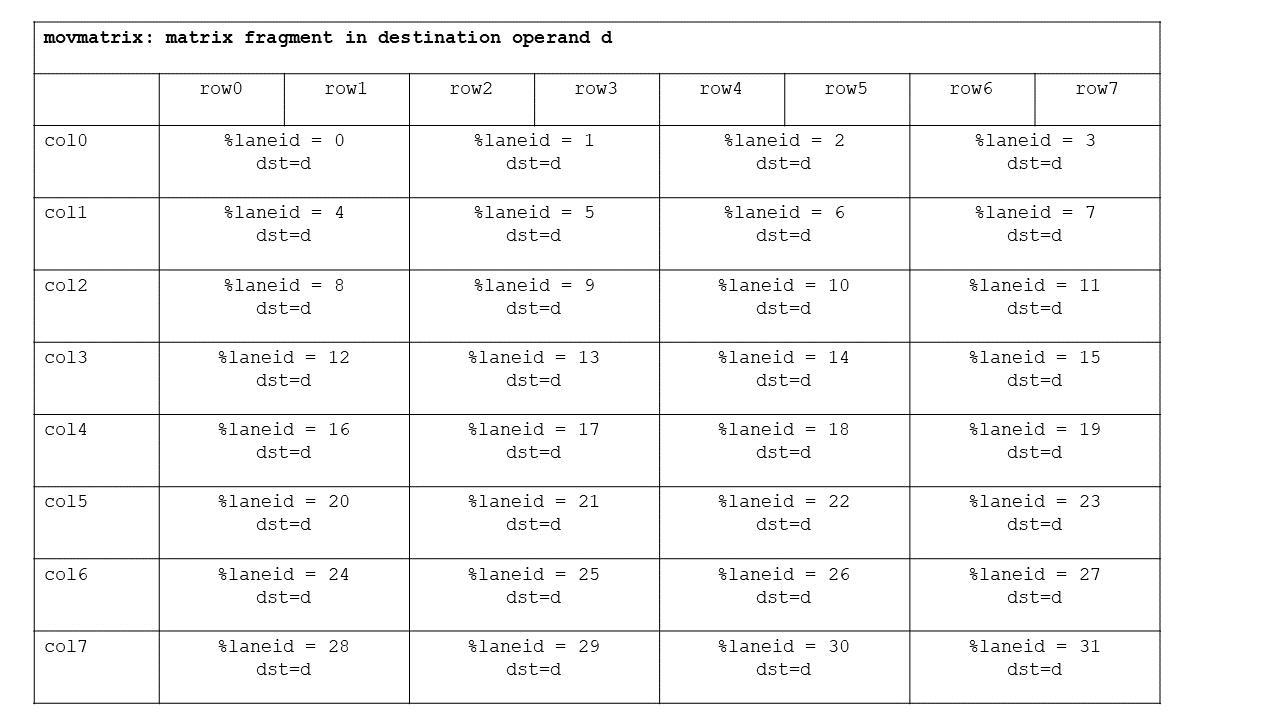
图 113 movmatrix 结果矩阵 fragment 布局
示例
.reg .b32 d, a;
movmatrix.sync.aligned.m8n8.trans.b16 d, a;
9.7.16.6. 使用 mma.sp 指令的稀疏矩阵乘加运算#
本节描述 warp 级的 mma.sp{::ordered_metadata} 指令(使用稀疏矩阵 A)。当 A 是一个结构化稀疏矩阵,且每行按形状特定的粒度分布有 50% 的零元素时,可以使用 mma 运算的这一变体。对于一个 MxNxK 稀疏 mma.sp{::ordered_metadata} 运算,MxK 矩阵 A 被打包为 MxK/2 个元素。对于矩阵 A 的每一条 K 宽的行,有 50% 的元素为零,其余 K/2 个非零元素被打包进表示矩阵 A 的操作数中。这 K/2 个元素到相应 K 宽行的映射由元数据显式提供。
9.7.16.6.1. 稀疏矩阵存储#
稀疏矩阵 A 的粒度定义为:矩阵行的子块中非零元素的数量与该子块中元素总数的比值,其中子块的大小是形状特定的。例如,对于一个 16x16 矩阵 A,稀疏性要求为 2:4 粒度,即矩阵行的每个 4 元素向量(即由 4 个连续元素构成的子块)包含 2 个零。子块中每个非零元素的索引存储在元数据操作数中。值 0b0000、0b0101、0b1010、0b1111 是元数据的无效值,将导致未定义行为。在一组四个连续线程中,由一个或多个线程存储整组的元数据,具体取决于矩阵形状。这些线程由一个额外的稀疏性选择器操作数指定。
图 114 给出了一个以稀疏格式表示的 16x16 矩阵 A 的示例,以及稀疏性选择器,它指示一组四个连续线程中的哪个线程存储元数据。
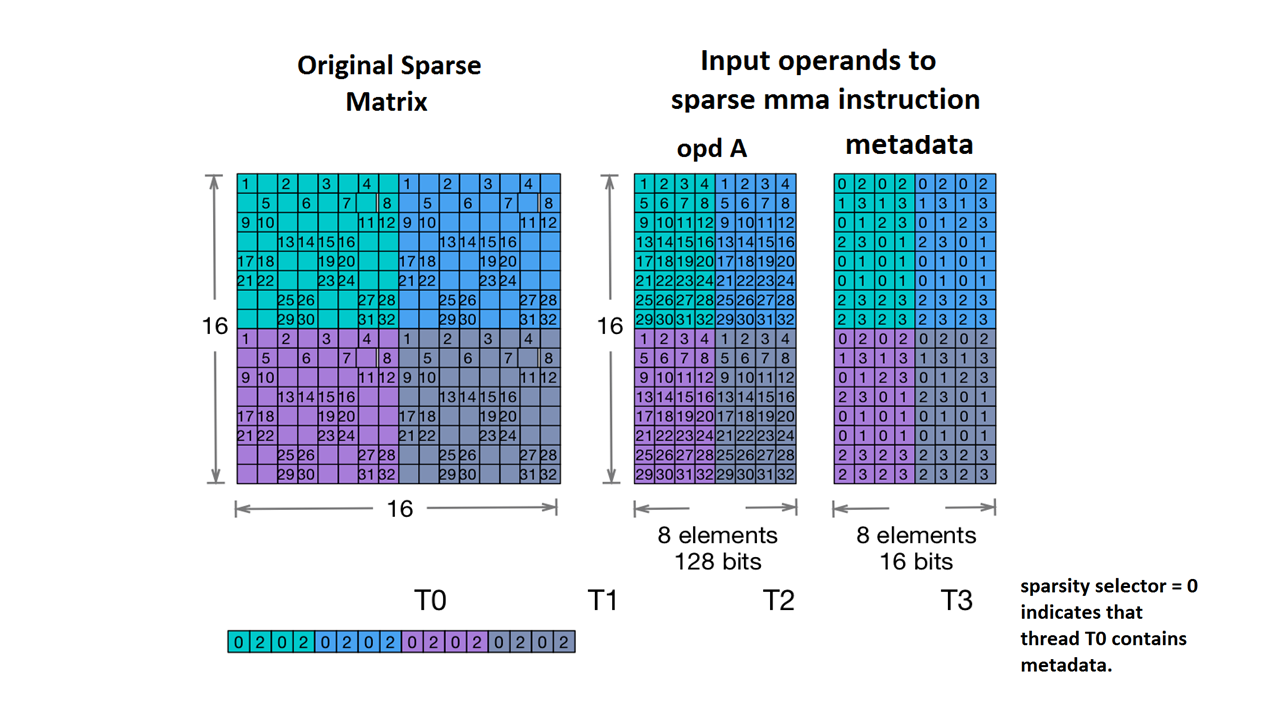
图 114 稀疏 MMA 存储示例
不同矩阵形状与数据类型的粒度如下所述。
稀疏 mma.sp{::ordered_metadata},半精度与 .bf16 类型
对于 .m16n8k16 和 .m16n8k32 的 mma.sp{::ordered_metadata} 运算,矩阵 A 以 2:4 粒度结构化稀疏。换言之,矩阵 A 某一行中每 4 个相邻元素构成的块含有两个零和两个非零元素。只有这两个非零元素被存储在表示矩阵 A 的操作数中,它们在矩阵 A 中四宽块内的位置由元数据操作数中的两个 2 位索引指示。对于 mma.sp::ordered_metadata,0b0100、0b1000、0b1001、0b1100、0b1101、0b1110 是索引的有效取值;任何其他值都会导致未定义行为。
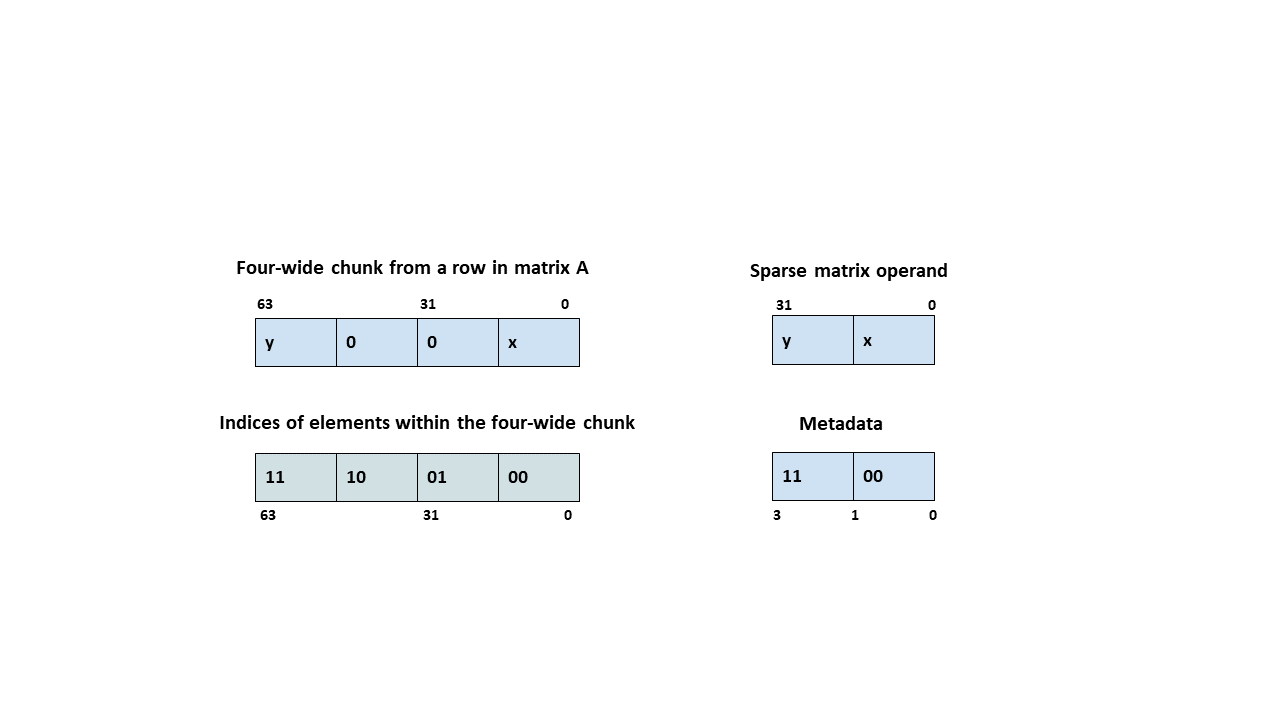
图 115 稀疏 MMA 元数据示例(.f16/.bf16 类型)。
稀疏性选择器指示提供元数据的线程,如下所示:
m16n8k16:一组四个连续线程中的一个线程提供整组的元数据。该线程由 {0, 1, 2, 3} 中的某个值指示。m16n8k32:一组四个连续线程中的一个线程对提供稀疏性元数据。因此,稀疏性选择器必须为 0(线程 T0、T1)或 1(线程 T2、T3);任何其他值都会导致未定义行为。
稀疏 mma.sp{::ordered_metadata},.tf32 类型
当矩阵 A 具有 .tf32 元素时,矩阵 A 以 1:2 粒度结构化稀疏。换言之,矩阵 A 某一行中每 2 个相邻元素构成的块含有一个零和一个非零元素。只有非零元素被存储在矩阵 A 的操作数中,它们在矩阵 A 中二宽块内的位置由元数据中的 4 位索引指示。0b1110 和 0b0100 是唯一有效的索引值;任何其他值都会导致未定义行为。
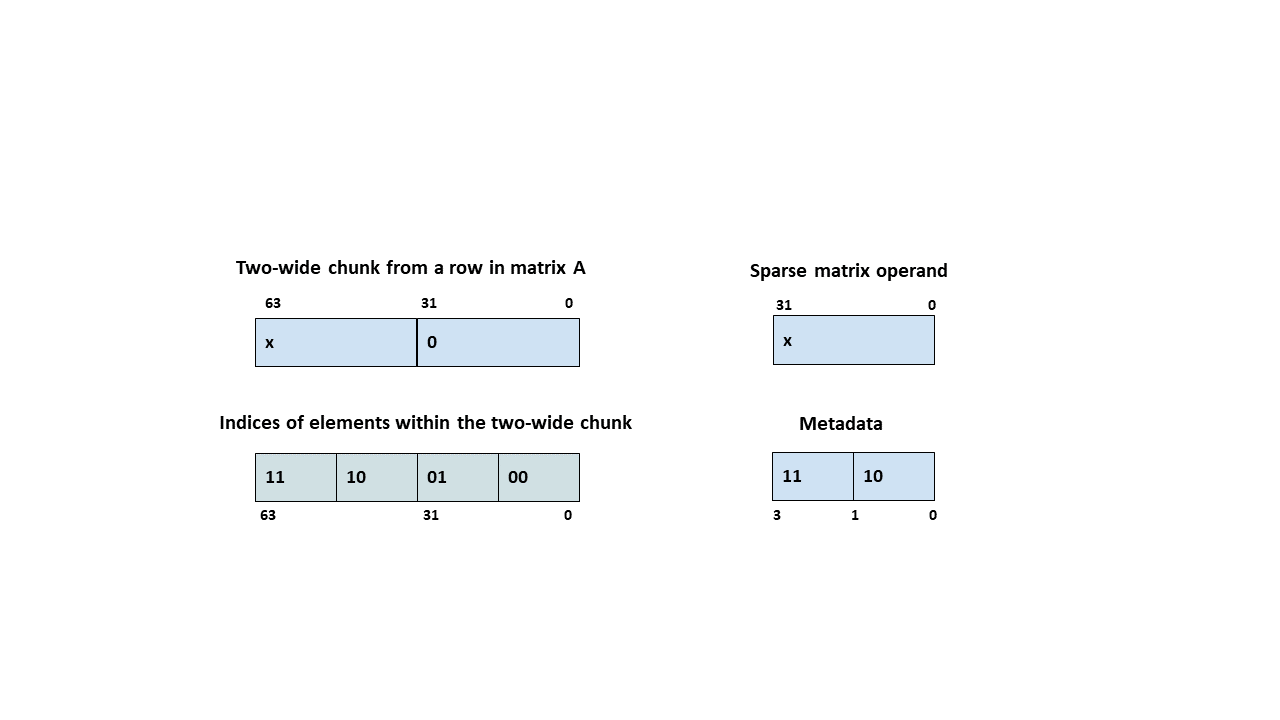
图 116 稀疏 MMA 元数据示例(.tf32 类型)。
稀疏性选择器指示提供元数据的线程,如下所示:
m16n8k8:一组四个连续线程中的一个线程提供整组的元数据。该线程由 {0, 1, 2, 3} 中的某个值指示。m16n8k16:一组四个连续线程中的一个线程对提供稀疏性元数据。因此,稀疏性选择器必须为 0(线程 T0、T1)或 1(线程 T2、T3);任何其他值都会导致未定义行为。
稀疏 mma.sp{::ordered_metadata},整数类型
当矩阵 A 和 B 具有 .u8/.s8 元素时,矩阵 A 以 2:4 粒度结构化稀疏。换言之,矩阵 A 某一行中每 4 个相邻元素构成的块含有两个零和两个非零元素。只有这两个非零元素被存储在稀疏矩阵中,它们在四宽块中的位置由元数据中的两个 2 位索引指示。对于 mma.sp::ordered_metadata,0b0100、0b1000、0b1001、0b1100、0b1101、0b1110 是索引的有效取值;任何其他值都会导致未定义行为。
图 117 稀疏 MMA 元数据示例(.u8/.s8 类型)。
当矩阵 A 和 B 具有 .u4/.s4 元素时,矩阵 A 以 4:8 粒度成对结构化稀疏。换言之,矩阵 A 某一行中每 8 个相邻元素构成的块含有四个零和四个非零值。此外,零与非零值在八宽块内以每两个元素为一个子块的方式聚集,即八宽块内的每个二宽子块必须全为零或全为非零。只有四个非零值被存储在稀疏矩阵中,矩阵 A 某一行的八宽块中两个含非零值的二宽子块的位置由元数据中的两个 2 位索引指示。对于 mma.sp::ordered_metadata,0b0100、0b1000、0b1001、0b1100、0b1101、0b1110 是索引的有效取值;任何其他值都会导致未定义行为。
图 118 稀疏 MMA 元数据示例(.u4/.s4 类型)。
稀疏性选择器指示提供元数据的线程,如下所示:
m16n8k32(.u8/.s8类型)与m16n8k64(.u4/.s4类型):一组四个连续线程中的一个线程对提供稀疏性元数据。因此,稀疏性选择器必须为 0(线程 T0、T1)或 1(线程 T2、T3);任何其他值都会导致未定义行为。m16n8k64(.u8/.s8类型)与m16n8k128(.u4/.s4类型):一组四个连续线程中的所有线程都提供稀疏性元数据。因此,这种情况下稀疏性选择器必须为 0。稀疏性选择器的任何其他值都会导致未定义行为。
稀疏 mma.sp{::ordered_metadata} 运算于 .e4m3/.e5m2/.e3m2/.e2m3/.e2m1 类型并带 .kind::f8f6f4 或 .kind::mxf8f6f4
当矩阵 A 和 B 具有 .e4m3/.e5m2/.e3m2/.e2m3/.e2m1 元素时,矩阵 A 以 2:4 粒度结构化稀疏。换言之,矩阵 A 某一行中每 4 个相邻元素构成的块含有两个零和两个非零元素。只有这两个非零元素被存储在稀疏矩阵中,它们在四宽块中的位置由元数据中的两个 2 位索引指示。0b0100、0b1000、0b1001、0b1100、0b1101、0b1110 是索引的有效取值;任何其他值都会导致未定义行为。
图 119 稀疏 MMA 元数据示例(.e4m3/.e5m2/.e3m2/.e2m3/.e2m1 类型)。
稀疏性选择器指示提供元数据的线程,如下所示:
m16n8k64:一组四个连续线程中的所有线程都提供稀疏性元数据。因此,这种情况下稀疏性选择器必须为 0。稀疏性选择器的任何其他值都会导致未定义行为。
稀疏 mma.sp::ordered_metadata 运算于 .e2m1 类型并带 .kind::mxf4 或 .kind::mxf4nvf4
当矩阵 A 和 B 具有 .e2m1 元素时,矩阵 A 以 4:8 粒度成对结构化稀疏。换言之,矩阵 A 某一行中每 8 个相邻元素构成的块含有四个零和四个非零值。此外,零与非零值在八宽块内以每两个元素为一个子块的方式聚集,即八宽块内的每个二宽子块必须全为零或全为非零。只有四个非零值被存储在稀疏矩阵中,矩阵 A 某一行的八宽块中两个含非零值的二宽子块的位置由元数据中的两个 2 位索引指示。0b0100、0b1000、0b1001、0b1100、0b1101、0b1110 是索引的有效取值;任何其他值都会导致未定义行为。
图 120 稀疏 MMA 元数据示例(.e2m1 类型带 .kind::mxf4 或 .kind::mxf4nvf4)
稀疏性选择器指示提供元数据的线程,如下所示:
m16n8k128:一组四个连续线程中的所有线程都提供稀疏性元数据。因此,这种情况下稀疏性选择器必须为 0。稀疏性选择器的任何其他值都会导致未定义行为。
9.7.16.6.2. 稀疏矩阵 A 乘加运算的矩阵片段#
在本节中,我们描述线程寄存器的内容如何与各矩阵的片段以及稀疏性元数据相关联。本节通篇使用以下约定:
对于矩阵 A,仅以寄存器向量大小及其与矩阵数据的关联关系来描述片段的布局。
对于矩阵 B,当矩阵维度与所支持数据类型的组合尚未在使用 mma 指令的矩阵乘加运算中涵盖时,会给出矩阵片段的图示表示。
对于矩阵 C 和 D,由于矩阵维度与数据类型的组合对所有支持的形状都相同,并且已在使用 mma 指令的矩阵乘加运算中涵盖,因此本节不再给出矩阵片段的图示表示。
对于元数据操作数,给出了矩阵 A 元素索引与元数据操作数内容之间关联关系的图示表示。出现在单元格
[x][y..z]中的Tk: [m..n]表示%laneid=k的线程的元数据操作数中第m位到第n位(m为较高位)包含矩阵 A 的[x][y]..[x][z]块中非零元素的索引。
9.7.16.6.2.1. 稀疏 mma.m16n8k16 的矩阵片段(.f16 与 .bf16 类型)#
执行稀疏 mma.m16n8k16(.f16 / .bf16 浮点类型)的一个 warp 将计算形状为 .m16n8k16 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素
.f16/.bf16一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 4 个连续元素里的两个非零.f16/.bf16元素。非零元素的映射如稀疏矩阵存储所述。
不同线程所持有的片段布局如图 121所示。
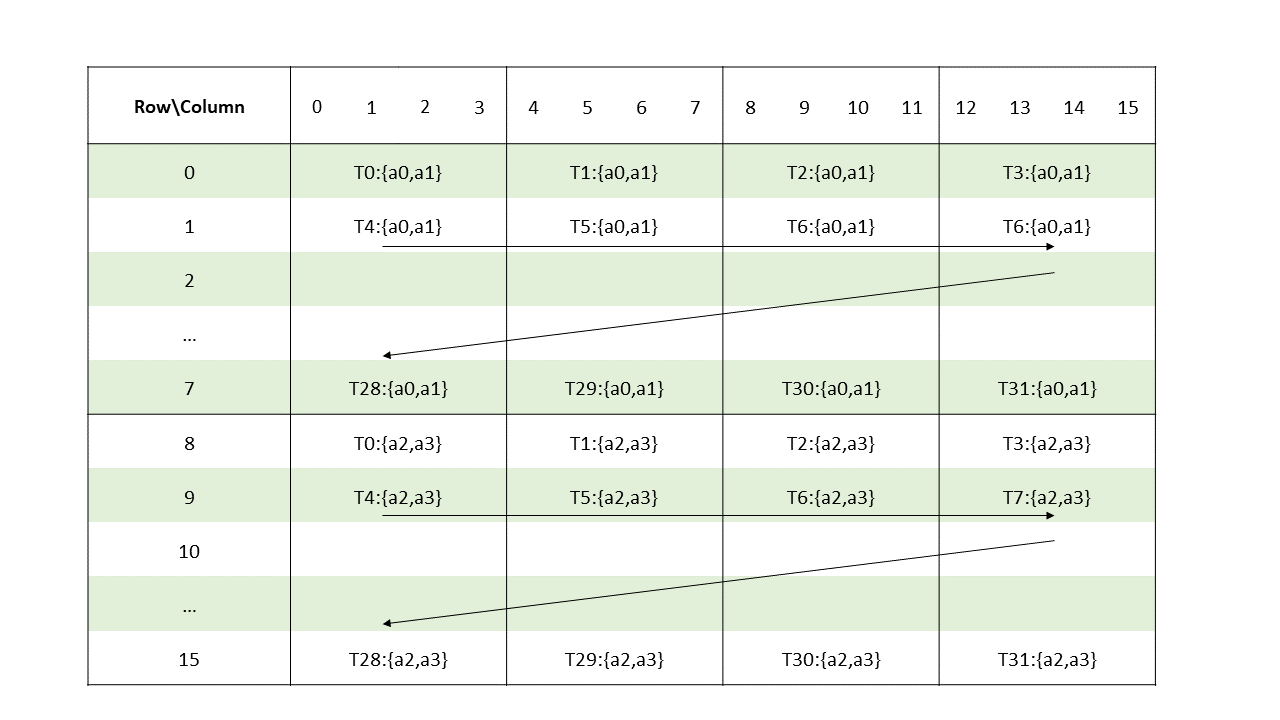
图 121 稀疏 MMA .m16n8k16 矩阵片段布局(矩阵 A,
.f16/.bf16类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 and a1 groupID + 8 for a2 and a3
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group * 4 lastcol = firstcol + 3
被乘数 B 以及累加器 C 和 D 的矩阵片段与浮点类型 mma.m16n8k16 的矩阵片段中
.f16/.b16格式的情况相同。-
元数据:一个
.b32寄存器,包含 16 个 2 位向量,每个向量存储矩阵 A 的某个 4 宽块中一个非零元素的索引,如图 122所示。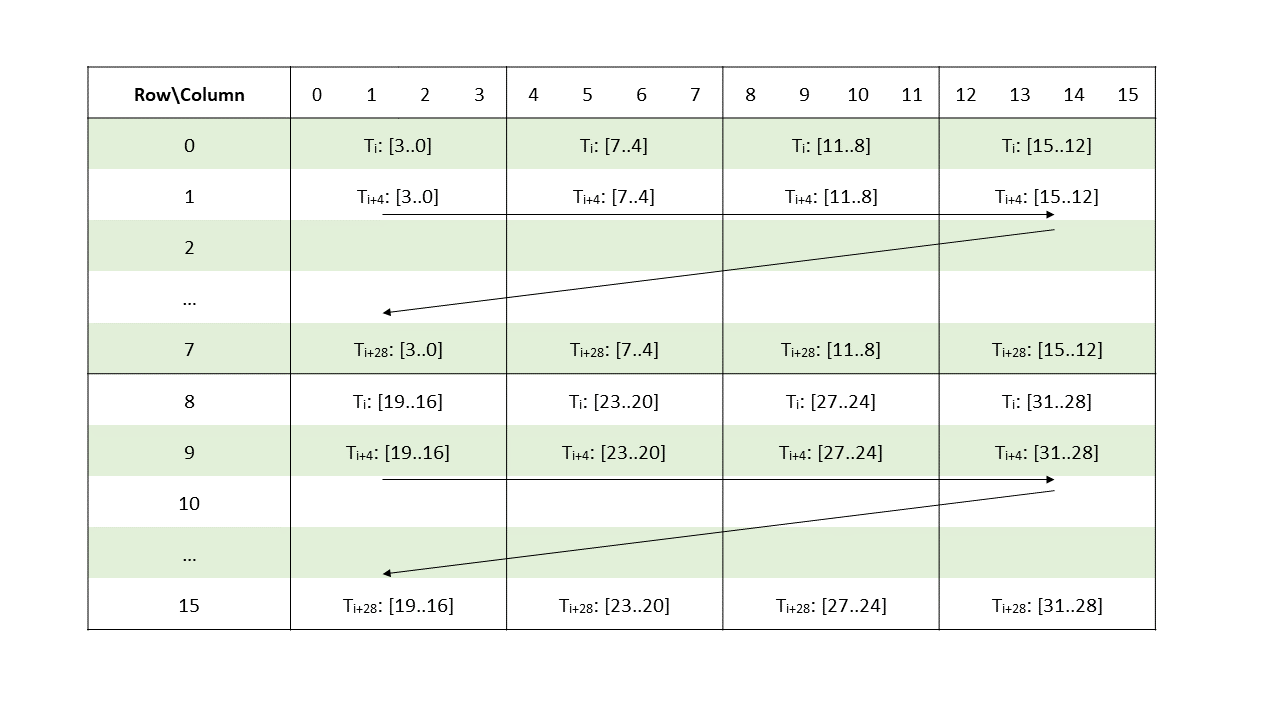
图 122 稀疏 MMA .m16n8k16 元数据布局(
.f16/.bf16类型)。
9.7.16.6.2.2. 稀疏 mma.m16n8k32 的矩阵片段(.f16 与 .bf16 类型)#
执行稀疏 mma.m16n8k32(.f16 / .bf16 浮点类型)的一个 warp 将计算形状为 .m16n8k32 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素
.f16/.bf16一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 4 个连续元素里的两个非零.f16/.bf16元素。非零元素的映射如稀疏矩阵存储所述。
不同线程所持有的片段布局如图 123所示。
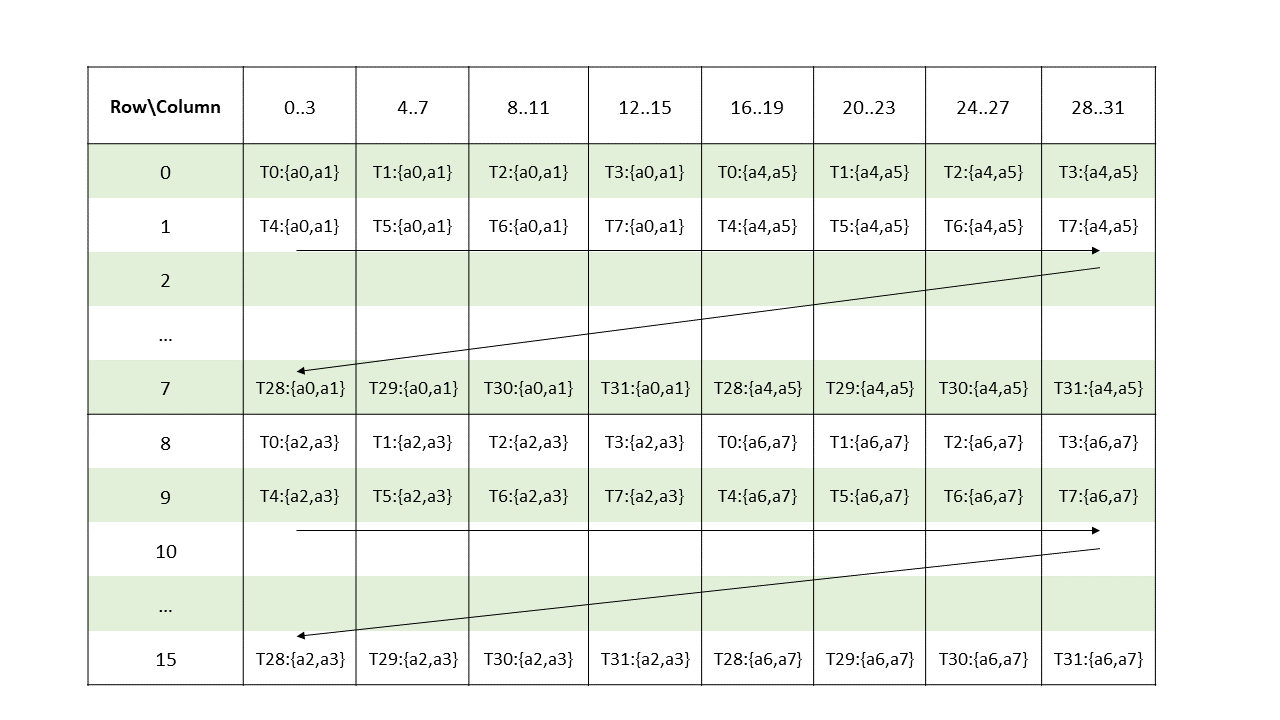
图 123 稀疏 MMA .m16n8k32 矩阵片段布局(矩阵 A,
.f16/.bf16类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 2 || 4 <= i < 6 groupID + 8 Otherwise
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group 4 For ai where i < 4 (threadID_in_group 4) + 16 for ai where i >= 4 lastcol = firstcol + 3
-
被乘数 B:
.atype
矩阵片段
元素(由低到高)
.f16/.bf16一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的两个.f16/.bf16元素。b0, b1, b2, b3
不同线程所持有的片段布局如图 124所示。
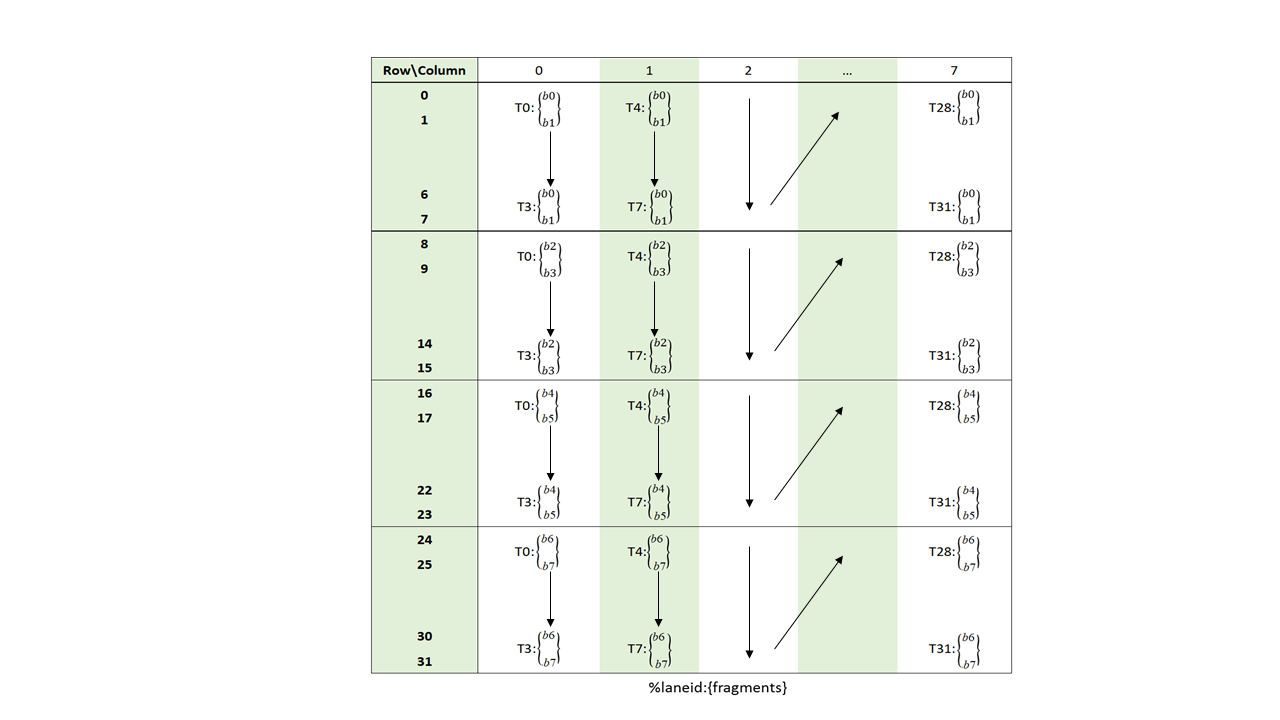
图 124 稀疏 MMA .m16n8k32 矩阵片段布局(矩阵 B,
.f16/.bf16类型)。 累加器 C 和 D 的矩阵片段与浮点类型 mma.m16n8k16 的矩阵片段中
.f16/.b16格式的情况相同。-
元数据:一个
.b32寄存器,包含 16 个 2 位向量,每对 2 位向量存储矩阵 A 的一个 4 宽块中两个非零元素的索引,如图 125所示。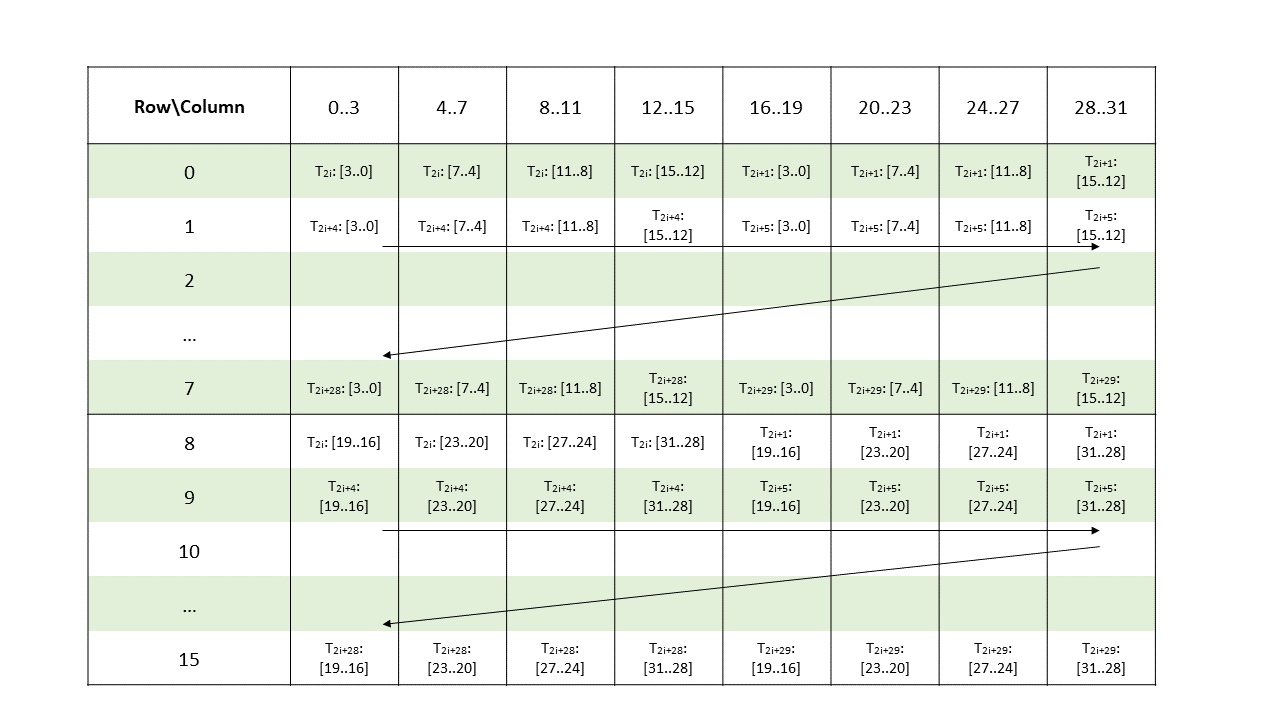
图 125 稀疏 MMA .m16n8k32 元数据布局(
.f16/.bf16类型)。
9.7.16.6.2.3. 稀疏 mma.m16n8k16 的矩阵片段(.tf32 浮点类型)#
执行稀疏 mma.m16n8k16(.tf32 浮点类型)的一个 warp 将计算形状为 .m16n8k16 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素
.tf32一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 2 个连续元素里的一个非零.tf32元素。非零元素的映射如稀疏矩阵存储所述。
不同线程所持有的片段布局如图 126所示。
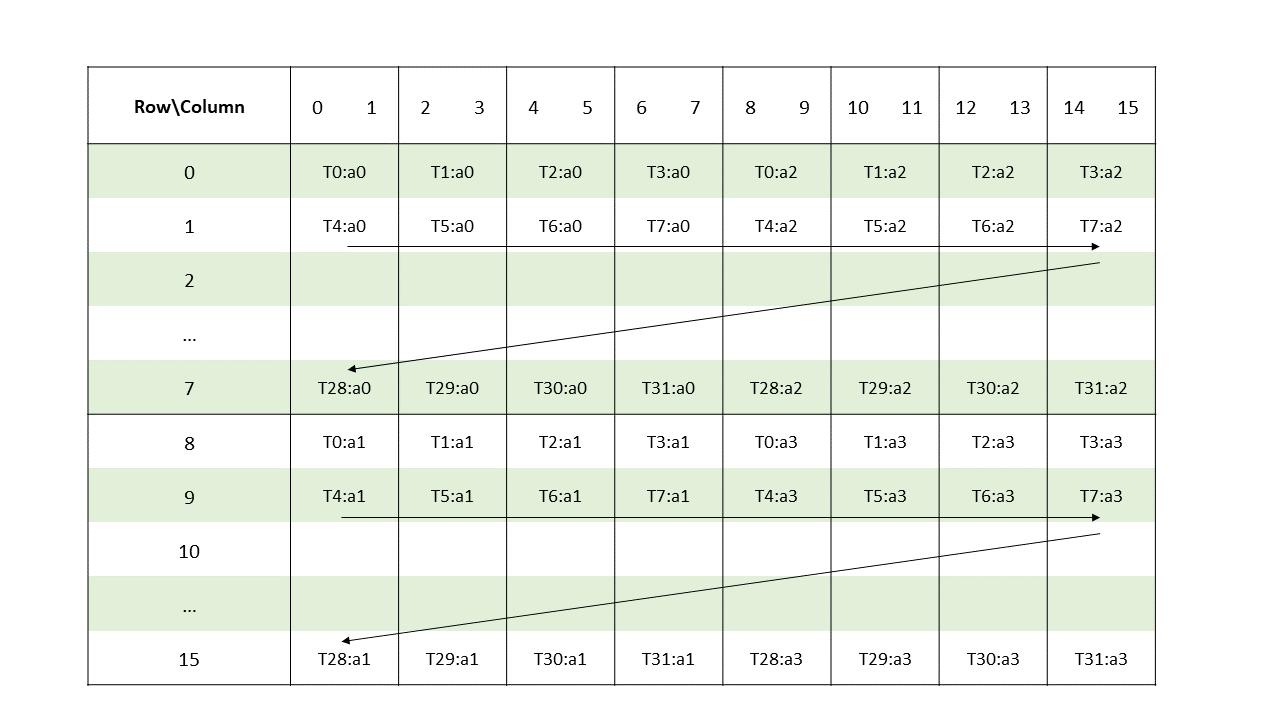
图 126 稀疏 MMA .m16n8k16 矩阵片段布局(矩阵 A,
.tf32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 and a2 groupID + 8 for a1 and a3
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group 2 for a0 and a1 (threadID_in_group 2) + 8 for a2 and a3 lastcol = firstcol + 1
-
被乘数 B:
.atype
矩阵片段
元素(由低到高)
.tf32一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的四个.tf32元素。b0, b1, b2, b3
不同线程所持有的片段布局如图 127所示。
图 127 稀疏 MMA .m16n8k16 矩阵片段布局(矩阵 B,
.tf32类型)。 累加器 C 和 D 的矩阵片段与浮点类型 mma.m16n8k16 的矩阵片段的情况相同。
-
元数据:一个
.b32寄存器,包含 8 个 4 位向量,每个向量存储矩阵 A 的某个 2 宽块中一个非零元素的索引,如图 128所示。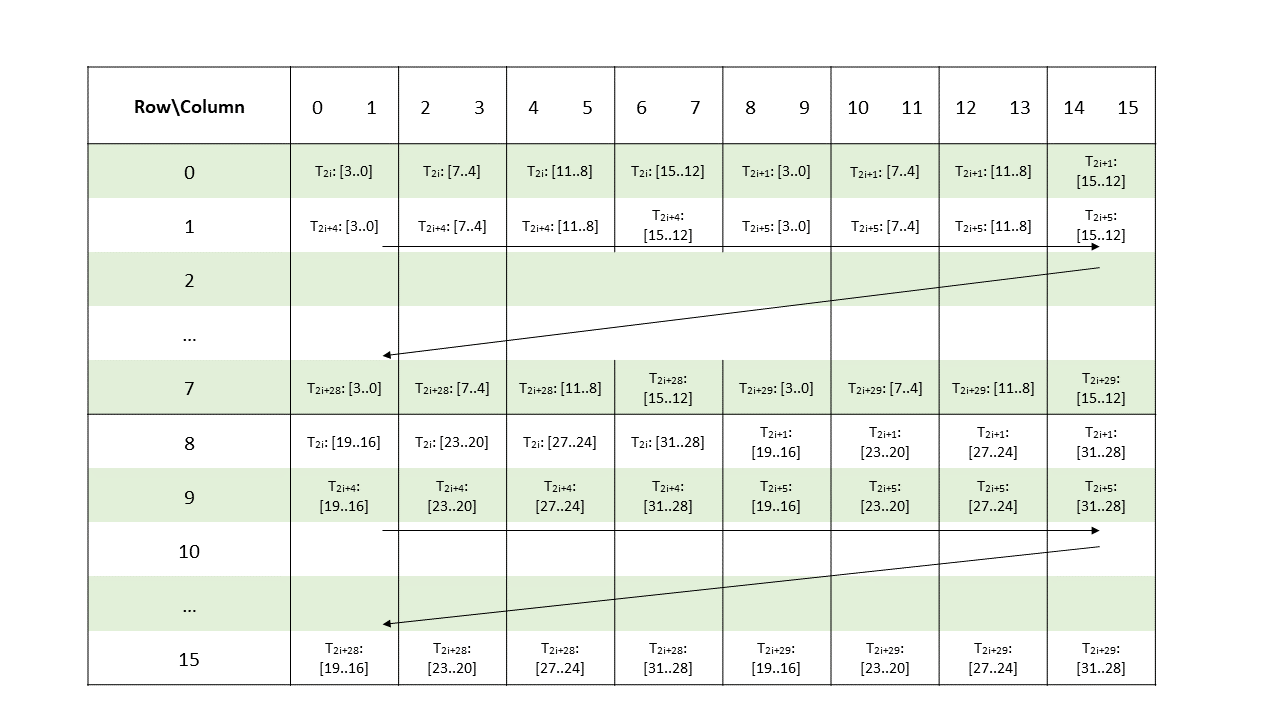
图 128 稀疏 MMA .m16n8k16 元数据布局(
.tf32类型)。
9.7.16.6.2.4. 稀疏 mma.m16n8k8 的矩阵片段(.tf32 浮点类型)#
执行稀疏 mma.m16n8k8(.tf32 浮点类型)的一个 warp 将计算形状为 .m16n8k8 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素
.tf32一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 2 个连续元素里的一个非零.tf32元素。非零元素的映射如稀疏矩阵存储所述。
不同线程所持有的片段布局如图 129所示。
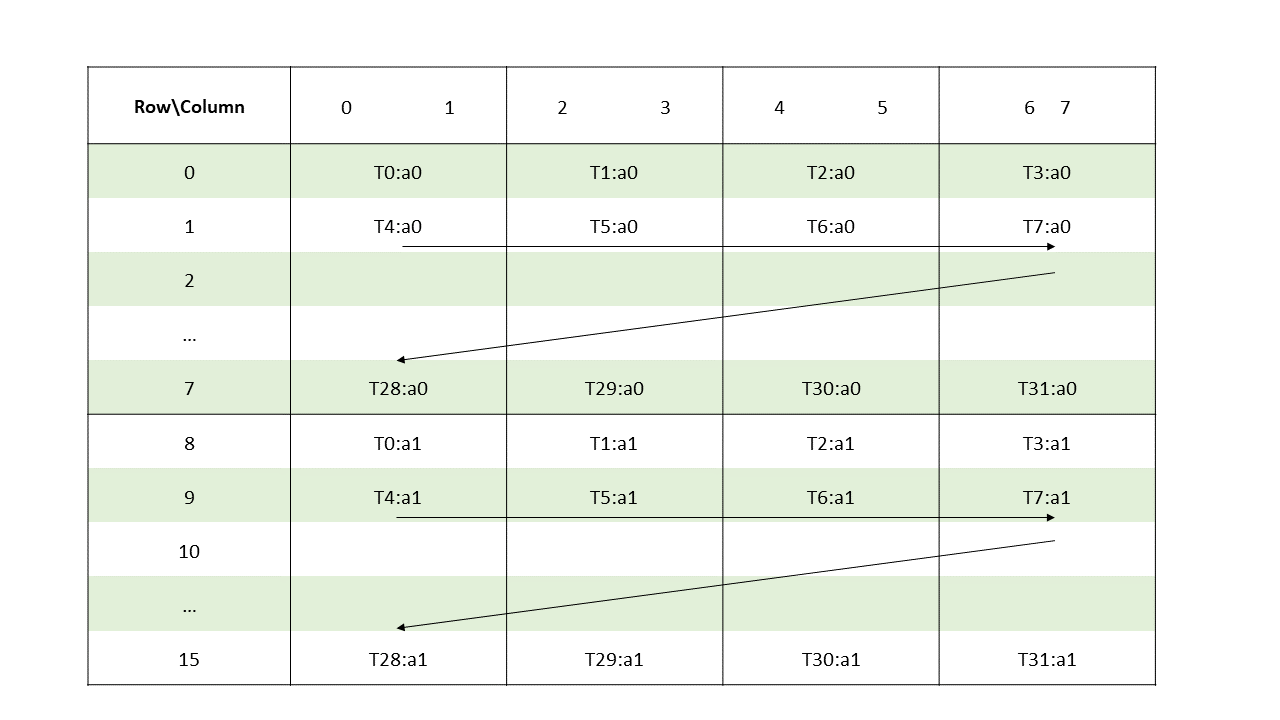
图 129 稀疏 MMA .m16n8k8 矩阵片段布局(矩阵 A,
.tf32类型)。矩阵片段的行与列可如下计算:
groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for a0 groupID + 8 for a1
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group * 2 lastcol = firstcol + 1
被乘数 B 以及累加器 C 和 D 的矩阵片段与mma.m16n8k8 的矩阵片段中
.tf32格式的情况相同。-
元数据:一个
.b32寄存器,包含 8 个 4 位向量,每个向量存储矩阵 A 的某个 2 宽块中一个非零元素的索引,如图 130所示。
图 130 稀疏 MMA .m16n8k8 元数据布局(
.tf32类型)。
9.7.16.6.2.5. 稀疏 mma.m16n8k32 的矩阵片段(.u8 / .s8 整数类型)#
执行稀疏 mma.m16n8k32(.u8 / .s8 整数类型)的一个 warp 将计算形状为 .m16n8k32 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素
.u8/.s8一个包含两个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 8 个连续元素里的四个非零.u8/.s8元素。非零元素的映射如稀疏矩阵存储所述。
不同线程所持有的片段布局如图 131所示。
图 131 稀疏 MMA .m16n8k32 矩阵片段布局(矩阵 A,
.u8/.s8类型)。groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 4 groupID + 8 Otherwise
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group * 8 lastcol = firstcol + 7
被乘数 B 以及累加器 C 和 D 的矩阵片段与mma.m16n8k32 的矩阵片段的情况相同。
-
元数据:一个
.b32寄存器,包含 16 个 2 位向量,每对 2 位向量存储矩阵 A 的一个 4 宽块中两个非零元素的索引,如图 132所示。
图 132 稀疏 MMA .m16n8k32 元数据布局(
.u8/.s8类型)。
9.7.16.6.2.6. 稀疏 mma.m16n8k64 的矩阵片段(.u8 / .s8 / .e4m3 / .e5m2 类型)#
执行稀疏 mma.m16n8k64(.u8 / .s8/ .e4m3/ .e5m2 / .e3m2 / .e2m3 / .e2m1 类型)的一个 warp 将计算形状为 .m16n8k64 的 MMA 运算。
矩阵的元素分布在 warp 中的各个线程上,因此 warp 的每个线程都持有矩阵的一个片段。
-
被乘数 A:
.atype
矩阵片段
元素
.u8/.s8一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 8 个连续元素里的四个非零.u8/.s8元素。非零元素的映射如稀疏矩阵存储所述。
.e4m3/.e5m2/.e3m2/.e2m3/.e2m1一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 8 个连续元素里的四个非零.e4m3/.e5m2/.e3m2/.e2m3/.e2m1元素。
图 133 稀疏 MMA .m16n8k64 矩阵片段布局(矩阵 A 的第 0–31 列,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。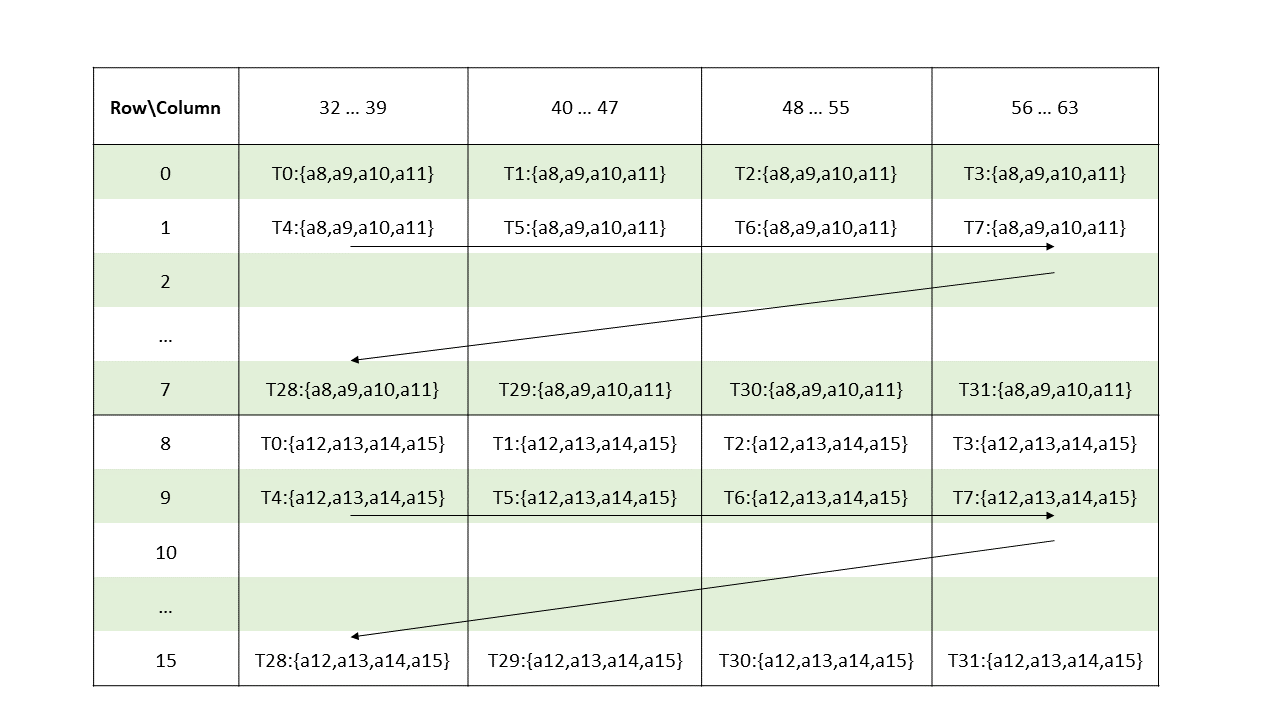
图 134 稀疏 MMA .m16n8k64 矩阵片段布局(矩阵 A 的第 32–63 列,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 4 || 8 <= i < 12 groupID + 8 Otherwise
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group 8 For ai where i < 8 (threadID_in_group 8) + 32 For ai where i >= 8 lastcol = firstcol + 7
-
被乘数 B:
.btype
矩阵片段
元素(由低到高)
.u8/.s8一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的四个.u8/.s8元素。b0, b1, b2, b3, …, b15
.e4m3/.e5m2/.e3m2/.e2m3/.e2m1一个包含四个
.b32寄存器的向量表达式,其中每个寄存器包含矩阵 B 中的四个.e4m3/.e5m2/.e3m2/.e2m3/.e2m1元素。不同线程所持有的片段布局如图 135、图 136、图 137和图 138所示。
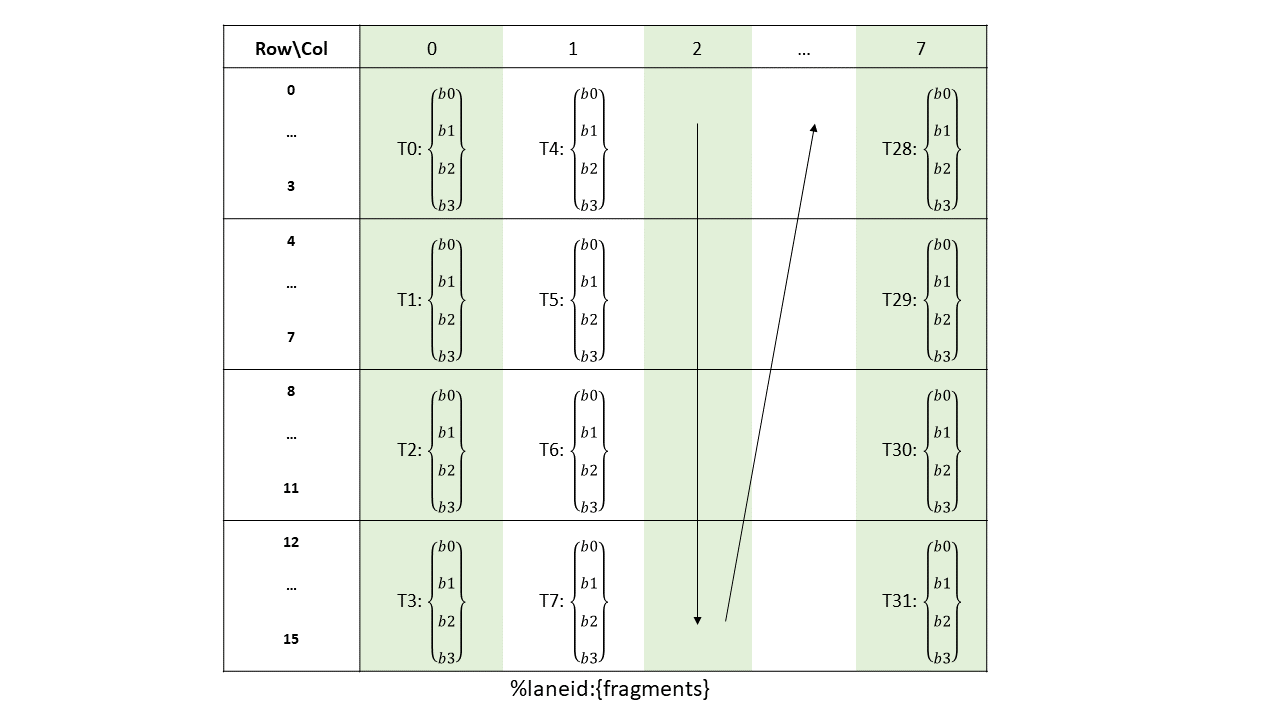
图 135 稀疏 MMA .m16n8k64 矩阵片段布局(矩阵 B 的第 0–15 行,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。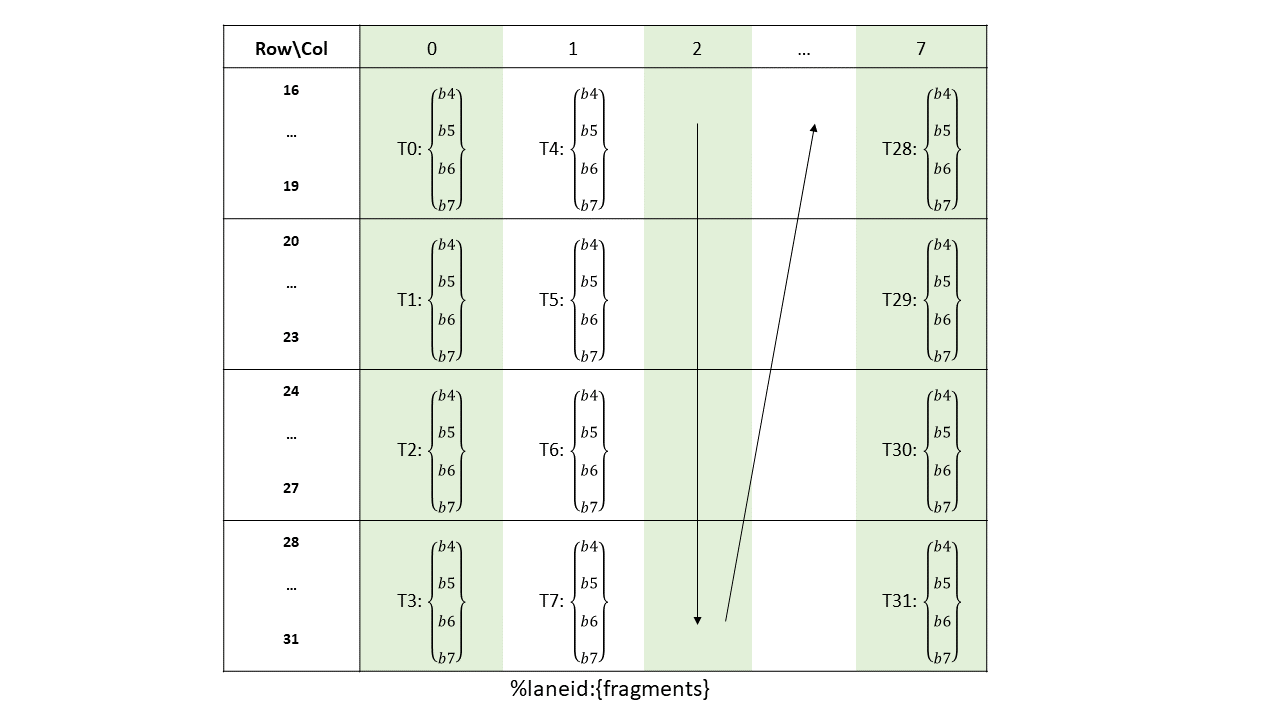
图 136 稀疏 MMA .m16n8k64 矩阵片段布局(矩阵 B 的第 16–31 行,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。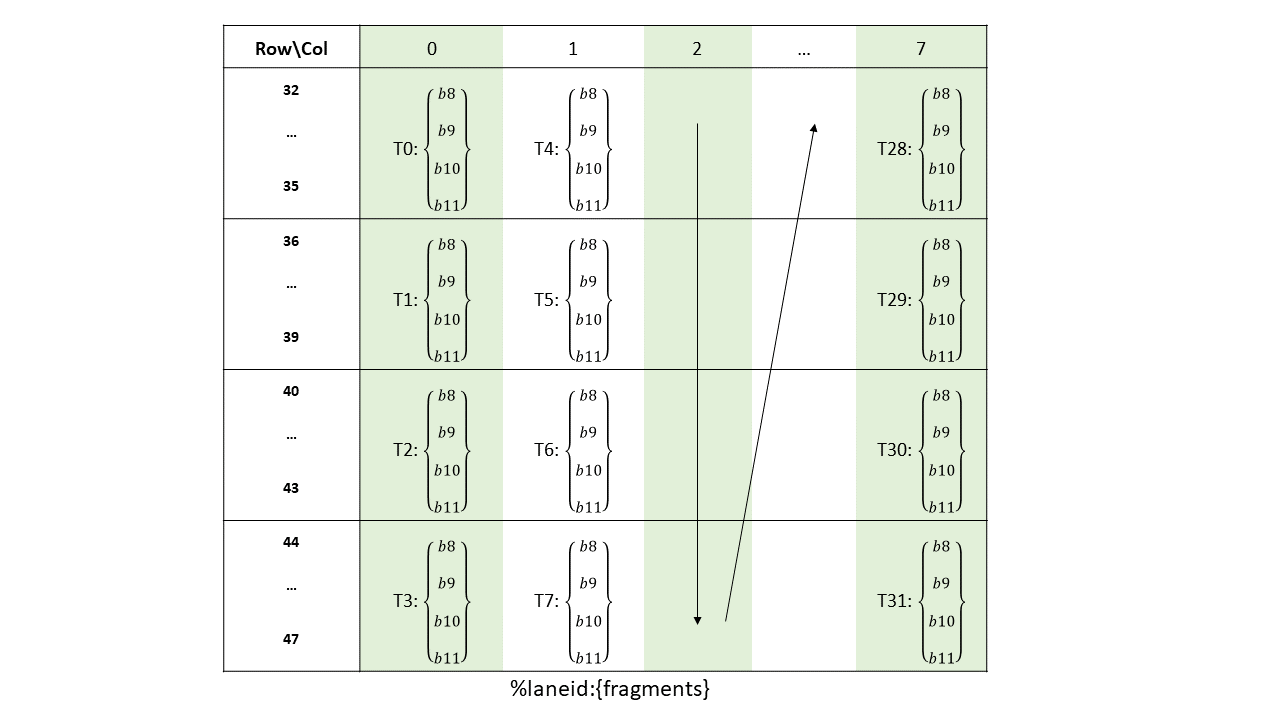
图 137 稀疏 MMA .m16n8k64 矩阵片段布局(矩阵 B 的第 32–47 行,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。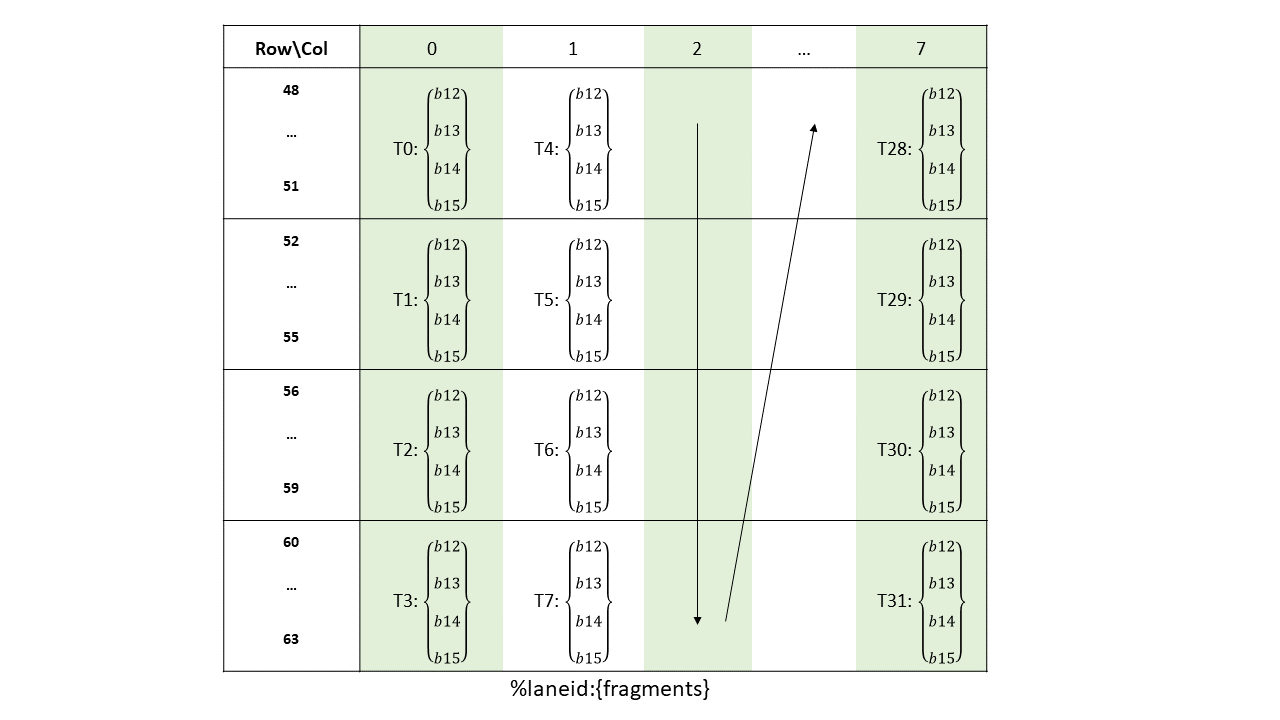
图 138 稀疏 MMA .m16n8k64 矩阵片段布局(矩阵 B 的第 48–63 行,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。 累加器 C 和 D 的矩阵片段与整数类型 mma.m16n8k16 的矩阵片段的情况相同。
-
元数据:一个
.b32寄存器,包含 16 个 2 位向量,每对 2 位向量存储矩阵 A 的一个 4 宽块中两个非零元素的索引,如图 139和图 140所示。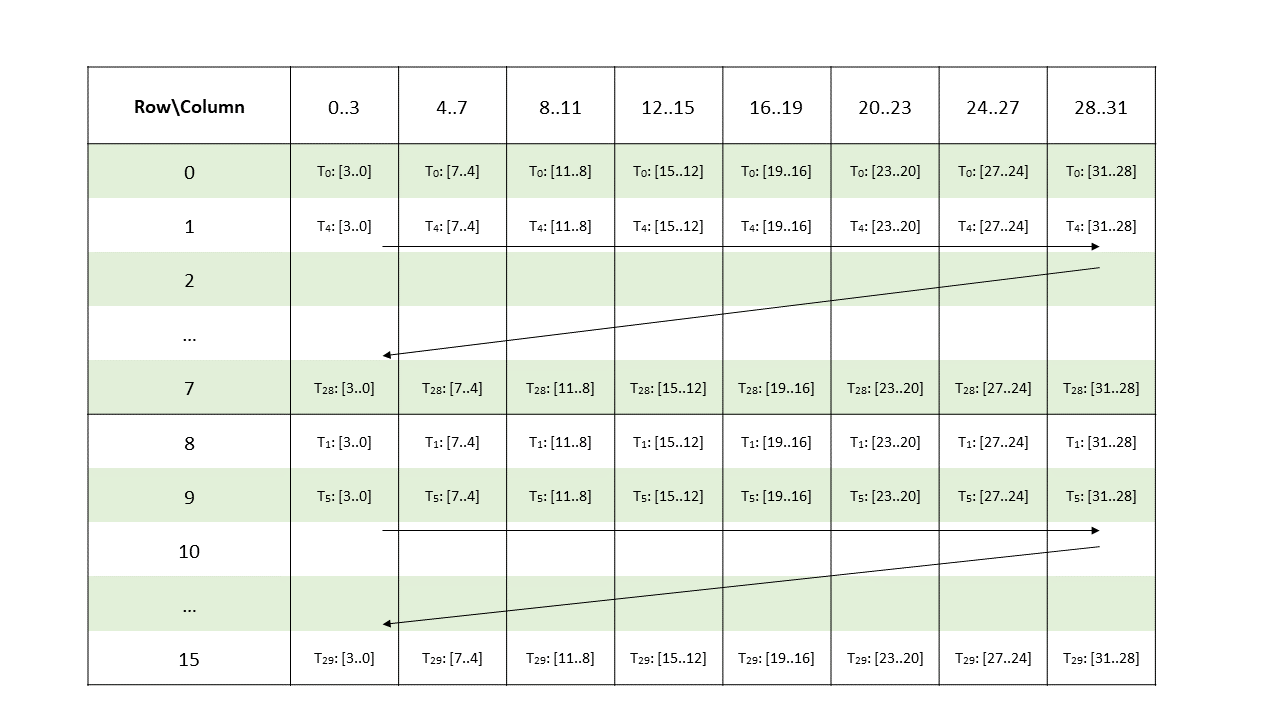
图 139 稀疏 MMA .m16n8k64 元数据布局(第 0–31 列,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。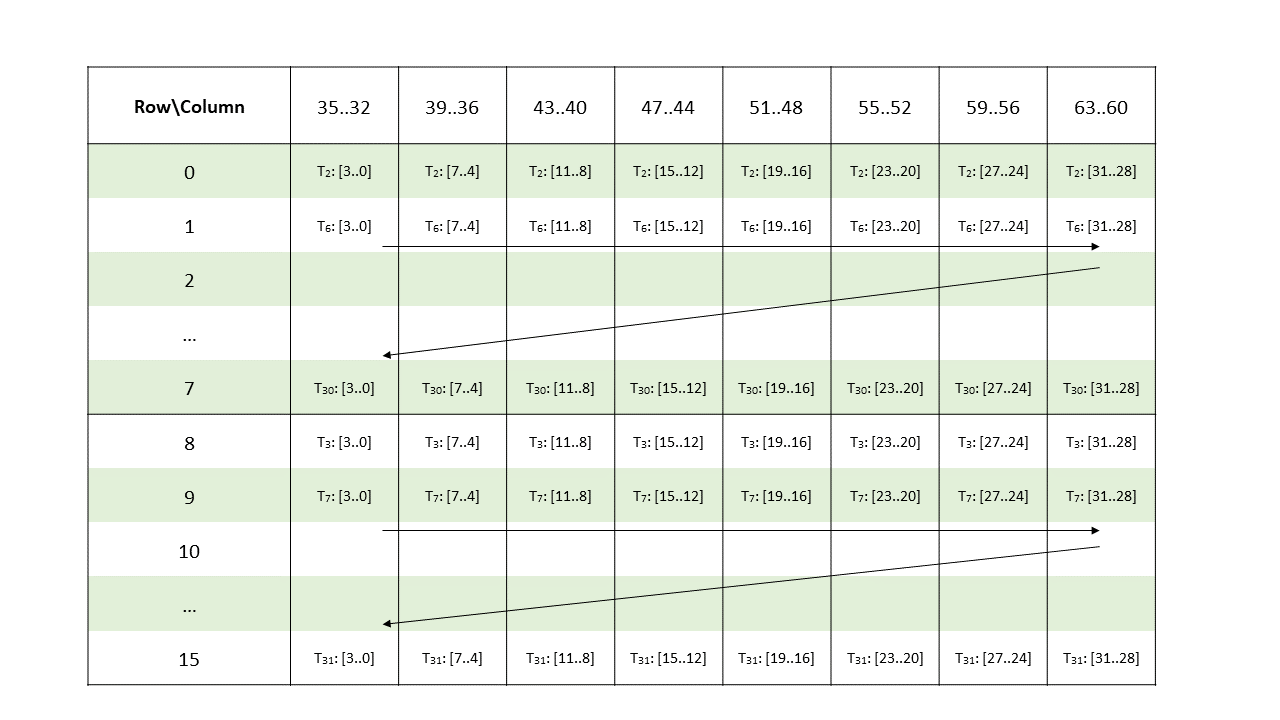
图 140 稀疏 MMA .m16n8k64 元数据布局(第 32–63 列,
.u8/.s8/.e4m3/.e5m2/.e3m2/.e2m3/.e2m1类型)。
9.7.16.6.2.7. .u4 / .s4 整数类型稀疏 mma.m16n8k64 的矩阵片段#
执行 .u4 / .s4 整数类型稀疏 mma.m16n8k64 的 warp 将计算形状为 .m16n8k64 的 MMA 运算。
矩阵的元素分布在 warp 的各线程之间,因此 warp 的每个线程持有矩阵的一个片段。
-
被乘数 A:
.atype
片段
元素
.u4/.s4一个向量表达式,包含两个
.b32寄存器,每个寄存器含有取自矩阵 A 中 16 个连续元素的八个非零.u4/.s4元素。非零元素的映射如 稀疏矩阵存储 所述。
不同线程所持片段的布局如 图 141 所示。
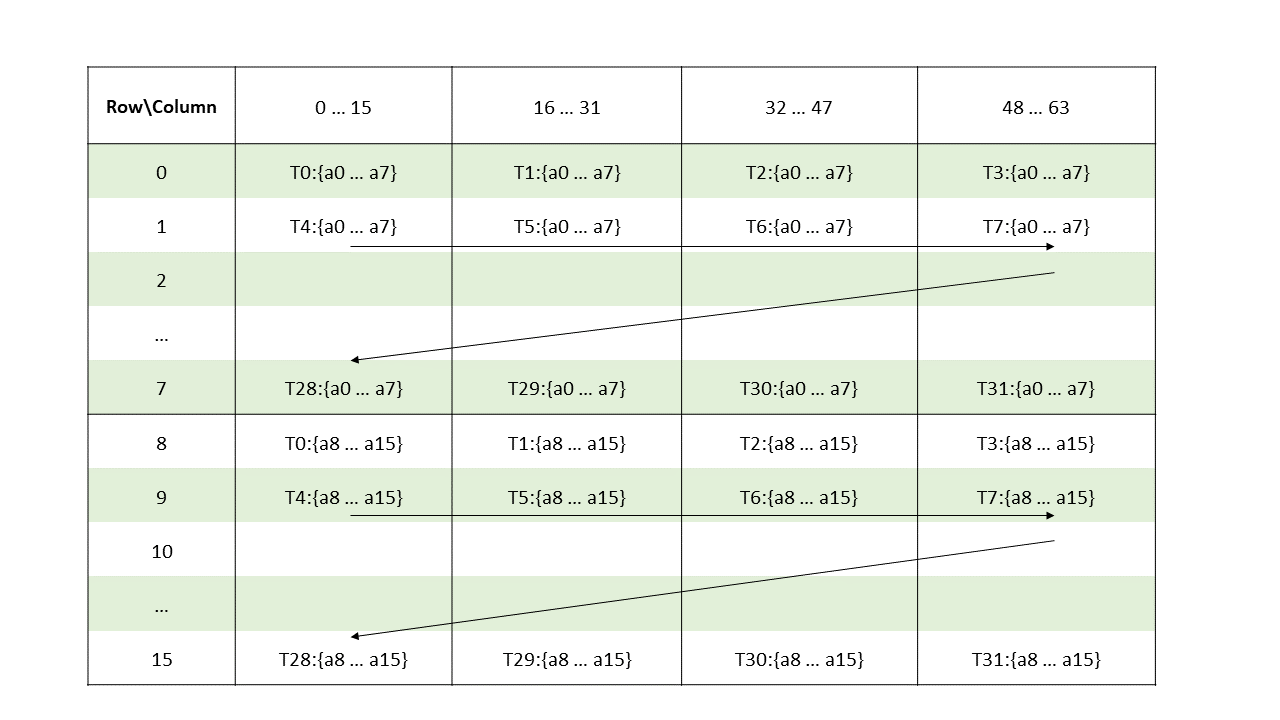
图 141 矩阵 A 在
.u4/.s4类型下稀疏 MMA .m16n8k64 的片段布局。groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 8 groupID + 8 Otherwise
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group * 16 lastcol = firstcol + 15
被乘数 B 以及累加器 C 和 D 的矩阵片段与 mma.m16n8k64 的矩阵片段 相同。
-
元数据:一个
.b32寄存器,包含 16 个 2 位向量,每对 2 位向量存储矩阵 A 中一个 8 宽数据块内四个非零元素的索引,如 图 142 所示。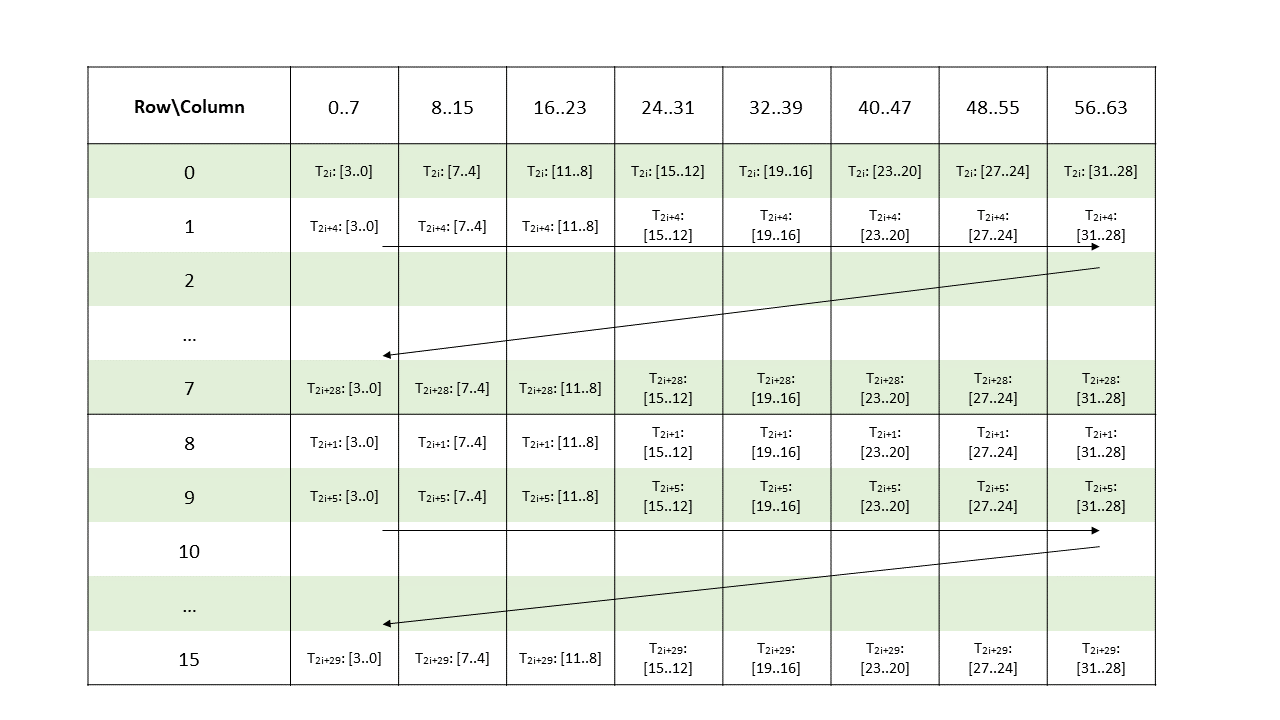
图 142
.u4/.s4类型下稀疏 MMA .m16n8k64 的元数据布局。
9.7.16.6.2.8. .u4 / .s4 整数类型稀疏 mma.m16n8k128 的矩阵片段#
执行 .u4 / .s4 / .e2m1 整数类型稀疏 mma.m16n8k128 的 warp 将计算形状为 .m16n8k128 的 MMA 运算。
矩阵的元素分布在 warp 的各线程之间,因此 warp 的每个线程持有矩阵的一个片段。
-
被乘数 A:
.atype
片段
元素
.u4/.s4一个向量表达式,包含四个
.b32寄存器,每个寄存器含有取自矩阵 A 中 16 个连续元素的八个非零.u4/.s4元素。非零元素的映射如 稀疏矩阵存储 所述。
.e2m1一个向量表达式,包含四个
.b32寄存器,每个寄存器含有取自矩阵 A 中 16 个连续元素的八个非零.e2m1元素。不同线程所持片段的布局如 图 143 和 图 144 所示。
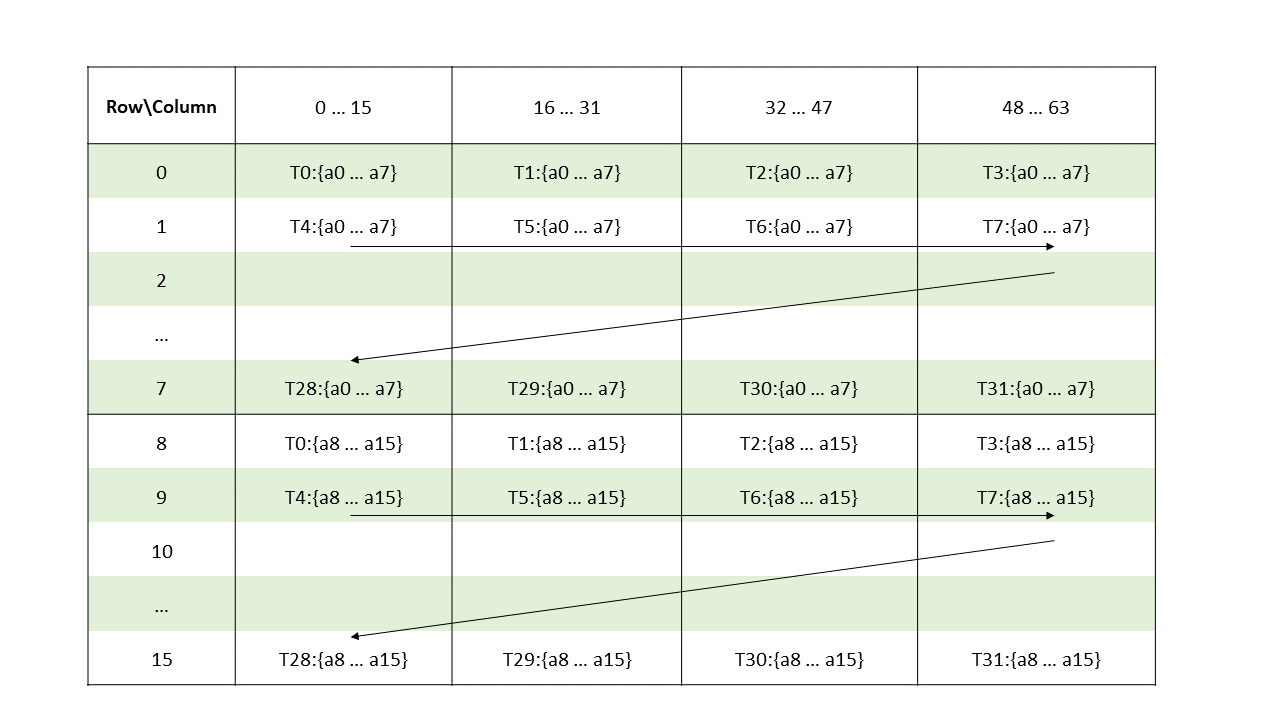
图 143 矩阵 A 第 0–63 列在
.u4/.s4/.e2m1类型下稀疏 MMA .m16n8k128 的片段布局。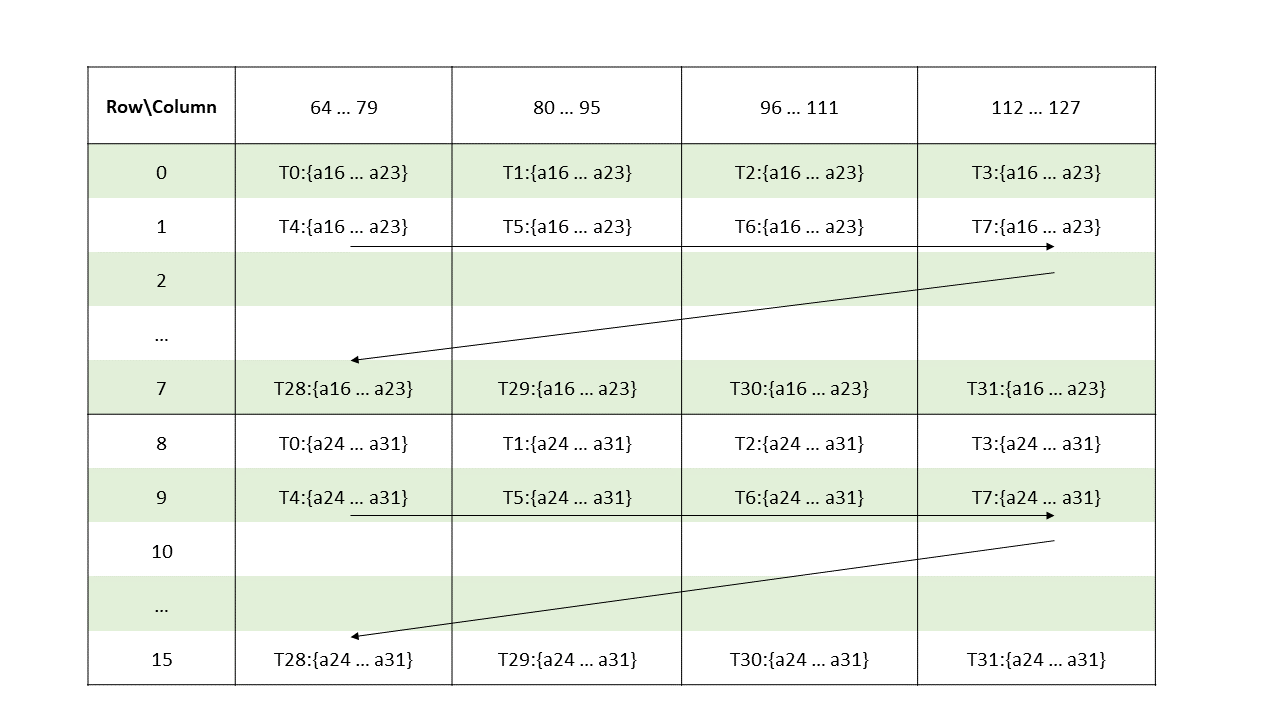
图 144 矩阵 A 第 64–127 列在
.u4/.s4/.e2m1类型下稀疏 MMA .m16n8k128 的片段布局。groupID = %laneid >> 2 threadID_in_group = %laneid % 4
row = groupID for ai where 0 <= i < 8 || 16 <= i < 24 groupID + 8 Otherwise
col = [firstcol … lastcol] // As per the mapping of non-zero elements // as described in Sparse matrix storage
Where firstcol = threadID_in_group 16 For ai where i < 16 (threadID_in_group 16) + 64 For ai where i >= 16 lastcol = firstcol + 15
-
被乘数 B:
.atype
片段
元素(从低到高)
.u4/.s4一个向量表达式,包含四个
.b32寄存器,每个寄存器含有矩阵 B 中的八个.u4/.s4元素。b0, b1, b2, b3, …, b31
.e2m1一个向量表达式,包含四个
.b32寄存器,每个寄存器含有矩阵 B 中的八个.e2m1元素。不同线程所持片段的布局如 图 145、图 146、图 147、图 148 所示。
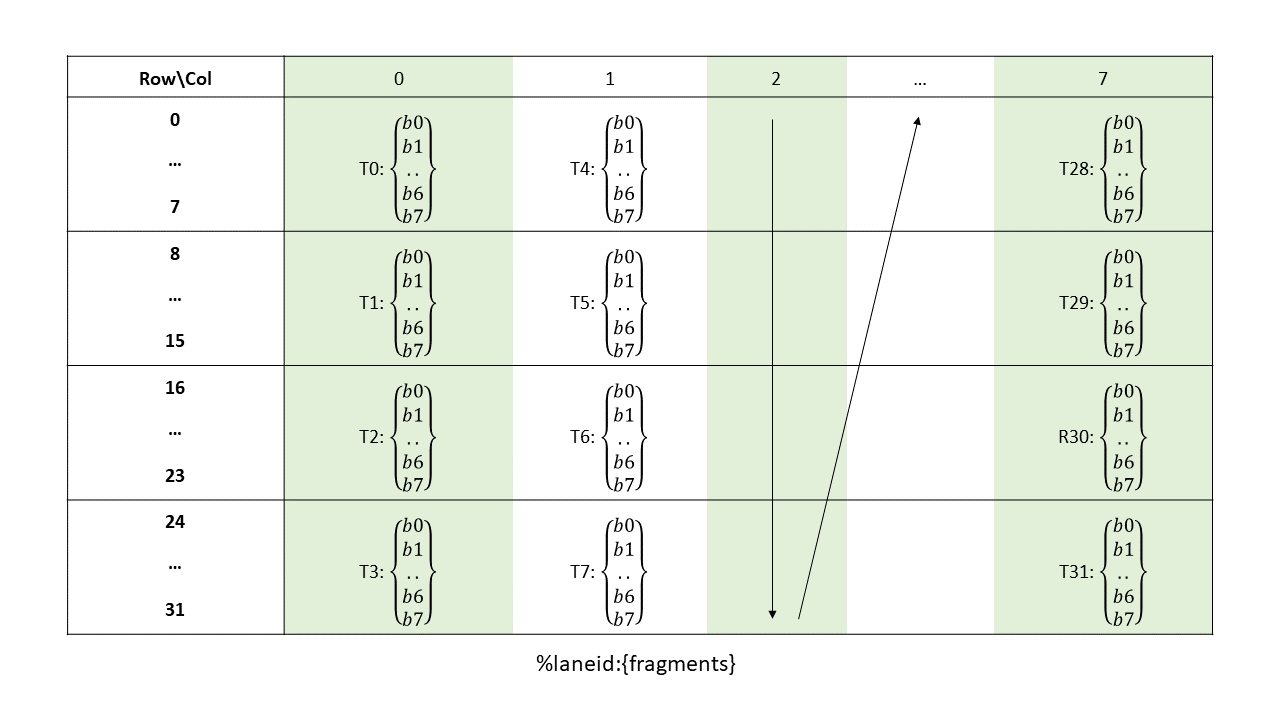
图 145 矩阵 B 第 0–31 行在
.u4/.s4/.e2m1类型下稀疏 MMA .m16n8k128 的片段布局。
图 146 矩阵 B 第 32–63 行在
.u4/.s4/.e2m1类型下稀疏 MMA .m16n8k128 的片段布局。
图 147 矩阵 B 第 64–95 行在
.u4/.s4/.e2m1类型下稀疏 MMA .m16n8k128 的片段布局。
图 148 矩阵 B 第 96–127 行在
.u4/.s4/.e2m1类型下稀疏 MMA .m16n8k128 的片段布局。 累加器 C 和 D 的矩阵片段与 mma.m16n8k64 的矩阵片段 相同。
-
元数据:一个
.b32寄存器,包含 16 个 2 位向量,每对 2 位向量存储矩阵 A 中一个 8 宽数据块内四个非零元素的索引,如 图 149 和 图 150 所示。
图 149
.u4/.s4/.e2m1类型下第 0–63 列的稀疏 MMA .m16n8k128 元数据布局。
图 150
.u4/.s4/.e2m1类型下第 64–127 列的稀疏 MMA .m16n8k128 元数据布局。
9.7.16.6.3. 乘加指令:mma.sp / mma.sp::ordered_metadata#
mma.sp, mma.sp::ordered_metadata
使用稀疏矩阵 A 执行矩阵乘加运算
语法
半精度浮点类型:
mma.spvariant.sync.aligned.m16n8k16.row.col.dtype.f16.f16.ctype d, a, b, c, e, f;
mma.spvariant.sync.aligned.m16n8k32.row.col.dtype.f16.f16.ctype d, a, b, c, e, f;
.ctype = {.f16, .f32};
.dtype = {.f16, .f32};
.spvariant = {.sp, .sp::ordered_metadata};
其他浮点类型:
mma.spvariant.sync.aligned.m16n8k16.row.col.f32.bf16.bf16.f32 d, a, b, c, e, f;
mma.spvariant.sync.aligned.m16n8k32.row.col.f32.bf16.bf16.f32 d, a, b, c, e, f;
mma.spvariant.sync.aligned.m16n8k8.row.col.f32.tf32.tf32.f32 d, a, b, c, e, f;
mma.spvariant.sync.aligned.m16n8k16.row.col.f32.tf32.tf32.f32 d, a, b, c, e, f;
mma.spvariant.sync.aligned.m16n8k64.row.col.f32.f8type.f8type.f32 d, a, b, c, e, f;
mma.sp::ordered_metadata.sync.aligned.m16n8k64.row.col.kind.dtype.f8f6f4type.f8f6f4type.ctype d, a, b, c, e, f;
.f8type = {.e4m3, .e5m2};
.spvariant = {.sp, .sp::ordered_metadata};
.f8f6f4type = {.e4m3, .e5m2, .e3m2, .e2m3, .e2m1};
.kind = {kind::f8f6f4};
.ctype = {.f16, .f32};
.dtype = {.f16, .f32};
带块缩放的其他浮点类型:
mma.spvariant.sync.aligned.m16n8k128.row.col.kind.block_scale{.scale_vec_size}.f32.e2m1.e2m1.f32.stype d, a, b, c, e, f, scale-a-data, {byte-id-a, thread-id-a}, scale-b-data, {byte-id-b, thread-id-b};
.spvariant = {.sp::ordered_metadata};
.kind = {.kind::mxf4};
.scale_vec_size = {.scale_vec::2X};
.stype = {.ue8m0};
mma.spvariant.sync.aligned.m16n8k128.row.col.kind.block_scale.scale_vec_size.f32.e2m1.e2m1.f32.stype d, a, b, c, e, f, scale-a-data, {byte-id-a, thread-id-a}, scale-b-data, {byte-id-b, thread-id-b};
.spvariant = {.sp::ordered_metadata};
.kind = {.kind::mxf4nvf4};
.scale_vec_size = {.scale_vec::2X, .scale_vec::4X};
.stype = {.ue8m0, .ue4m3};
mma.spvariant.sync.aligned.m16n8k64.row.col.kind.block_scale{.scale_vec_size}.f32.f8f6f4type.f8f6f4type.f32.stype d, a, b, c, e, f, scale-a-data, {byte-id-a, thread-id-a}, scale-b-data, {byte-id-b, thread-id-b};
.spvariant = {.sp::ordered_metadata};
.kind = {.kind::mxf8f6f4};
.scale_vec_size = {.scale_vec::1X};
.f8f6f4type = {.e4m3, .e5m2, .e3m2, .e2m3, .e2m1};
.stype = {.ue8m0};
整数类型:
mma.spvariant.sync.aligned.shape.row.col{.satfinite}.s32.atype.btype.s32 d, a, b, c, e, f;
.shape = {.m16n8k32, .m16n8k64}
.atype = {.u8, .s8};
.btype = {.u8, .s8};
.spvariant = {.sp, .sp::ordered_metadata};
mma.spvariant.sync.aligned.shape.row.col{.satfinite}.s32.atype.btype.s32 d, a, b, c, e, f;
.shape = {.m16n8k64, .m16n8k128}
.atype = {.u4, .s4};
.btype = {.u4, .s4};
.spvariant = {.sp, .sp::ordered_metadata};
说明
执行 MxNxK 矩阵乘加运算 D = A*B+C,其中 A 矩阵为 MxK,B 矩阵为 KxN,C 和 D 矩阵为 MxN。
执行 mma.sp.sync/mma.sp::ordered_metadata.sync 指令的 warp 计算单次矩阵乘加运算。
限定符 .block_scale 指明在执行矩阵乘加运算之前,矩阵 A 和 B 分别先用 scale_A 和 scale_B 矩阵缩放,具体如 mma.sync 的块缩放 一节所述。scale_A 和 scale_B 矩阵内各元素对应的数据类型由 .stype 指定。限定符 .scale_vec_size 指定 scale_A 矩阵的列数和矩阵 scale_B 的行数。
.kind、.stype 和 .scale_vec_size 的有效组合如 表 45 所述。对于带 .kind::mxf4 的 mma,未指定限定符 .scale_vec_size 时默认为 2X。相反,当 .kind 指定为 .kind::mxf8f6f4 时,限定符 .scale_vec_size 默认为 1X。但对于 .kind::mxf4nvf4,必须提供有效的 .scale_vec_size。
操作数 a 和 b 表示两个被乘数矩阵 A 和 B,c 和 d 表示累加器和目标矩阵,分布在 warp 的各线程之间。矩阵 A 按 稀疏矩阵存储 所述组织为结构化稀疏。操作数 e 和 f 分别表示稀疏性元数据和稀疏性选择器。操作数 e 是 32 位整数,操作数 f 是取值在 0..3 范围内的 32 位整数常量。
指定 .block_scale 限定符时,操作数 scale-a-data、scale-b-data 分别表示对应 scale_A 和 scale_B 矩阵的缩放矩阵元数据。
元组 {byte-id-a, thread-id-a} 和 {byte-id-b, thread-id-b} 分别表示从相应元数据参数 scale-a-data、scale-b-data 中为矩阵 scale_A 和 scale_B 选择的选择器。操作数 scale-a-data、scale-b-data 的类型为 .b32。操作数 byte-id-a、thread-id-a、byte-id-b、thread-id-b 是无符号 16 位整数值。有关选择器参数的更多细节,请参见 mma.sync 的块缩放 一节。
指令 mma.sp::ordered_metadata 要求稀疏性元数据中的索引从最低有效位起按递增顺序排列,否则行为未定义。
每个线程中的寄存器持有矩阵的一个片段,如 稀疏矩阵 A 乘加运算的矩阵片段 所述。
限定符 .dtype、.atype、.btype 和 .ctype 分别指明矩阵 D、A、B 和 C 中元素的数据类型。限定符 .stype 指明矩阵 scale_A 和 scale_B 中元素的数据类型。在形状 .m16n8k16、.m16n8k32 和 .m16n8k64 下,.dtype 必须与 .ctype 相同。
当 .kind 为 .kind::mxf8f6f4 或 .kind::f8f6f4 时,各个 4 位和 6 位浮点类型元素必须打包进 8 位容器。.e2m1 类型的矩阵元素位于 8 位容器的中间 4 位,容器的上 2 位和下 2 位为填充。当矩阵元素为 .e3m2 或 .e2m3 类型时,矩阵元素位于 8 位容器的低 6 位,容器的上 2 位为填充。相反,请注意在使用带 .kind::mxf4 或 .kind::mxf4nvf4 的 mma 时,即使矩阵元素为 .e2m1 类型,也无需显式填充。
- 精度与舍入:
-
-
.f16浮点运算:矩阵 A 和 B 的逐元素乘法以至少单精度执行。当
.ctype或.dtype为.f32时,中间值的累加以至少单精度执行。当.ctype和.dtype都指定为.f16时,累加以至少半精度执行。累加顺序、舍入以及次正规数输入的处理均未指定。
-
.e4m3、.e5m2、.e3m2、.e2m3、.e2m1浮点运算:矩阵 A 和 B 的逐元素乘法以指定精度执行。中间值的累加以至少单精度执行。
累加顺序、舍入以及次正规数输入的处理均未指定。
-
.bf16和.tf32浮点运算:矩阵 A 和 B 的逐元素乘法以指定精度执行。中间值的累加以至少单精度执行。
累加顺序、舍入以及次正规数输入的处理均未指定。
-
整数运算:
整数
mma.sp/mma.sp::ordered_metadata运算使用.s32累加器执行。.satfinite限定符指明溢出时累加值被限制在 MIN_INT32.. MAX_INT32 范围内(这两个边界分别定义为最小负 32 位有符号整数和最大正 32 位有符号整数)。若未指定
.satfinite,则累加值改为回绕。
-
必需的 .sync 限定符指明 mma.sp/mma.sp::ordered_metadata 指令使执行线程等待,直到 warp 中所有线程都执行同一条 mma.sp/mma.sp::ordered_metadata 指令后才继续执行。
必需的 .aligned 限定符指明 warp 中所有线程都必须执行同一条 mma.sp/mma.sp::ordered_metadata 指令。在条件执行的代码中,只有当确知 warp 中所有线程对该条件的求值结果相同时,才应使用 mma.sp/mma.sp::ordered_metadata 指令,否则行为未定义。
若同一 warp 中所有线程未使用相同的限定符,或 warp 中任一线程已退出,则 mma.sp/mma.sp::ordered_metadata 指令的行为未定义。
半精度浮点类型示例
// f16 elements in C and D matrix
.reg .f16x2 %Ra<2> %Rb<2> %Rc<2> %Rd<2>
.reg .b32 %Re;
mma.sp.sync.aligned.m16n8k16.row.col.f16.f16.f16.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1}, %Re, 0x1;
.reg .f16x2 %Ra<2> %Rb<2> %Rc<2> %Rd<2>
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k16.row.col.f16.f16.f16.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1}, %Re, 0x1;
其他浮点类型示例
.reg .b32 %Ra<2>, %Rb<2>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp.sync.aligned.m16n8k8.row.col.f32.tf32.tf32.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x1;
.reg .b32 %Ra<2>, %Rb<2>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp.sync.aligned.m16n8k16.row.col.f32.bf16.bf16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x1;
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp.sync.aligned.m16n8k32.row.col.f32.bf16.bf16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x1;
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp.sync.aligned.m16n8k64.row.col.f32.e5m2.e4m3.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0;
.reg .b32 %Ra<2>, %Rb<2>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k16.row.col.f32.bf16.bf16.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x1;
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k64.row.col.kind::f8f6f4.f32.e3m2.e2m3.f32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0;
.reg .b32 %Ra<4>, %Rb<4>;
.reg .b32 %Rc<4>, %Rd<4>;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k64.row.col.kind::f8f6f4.f16.e2m3.e2m1.f16
{%Rd0, %Rd1},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1}, %Re, 0;
整数类型示例
.reg .b32 %Ra<4>, %Rb<4>, %Rc<4>, %Rd<4>;
.reg .u32 %Re;
// u8 elements in A and B matrix
mma.sp.sync.aligned.m16n8k32.row.col.satfinite.s32.u8.u8.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x1;
// s8 elements in A and B matrix
mma.sp.sync.aligned.m16n8k64.row.col.satfinite.s32.s8.s8.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x0;
// s8 elements in A and B matrix with ordered metadata
mma.sp::ordered_metadata.sync.aligned.m16n8k64.row.col.satfinite.s32.s8.s8.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x0;
// u4 elements in A and B matrix
mma.sp.sync.aligned.m16n8k64.row.col.s32.s4.s4.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1},
{%Rb0, %Rb1},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x1;
// u4 elements in A and B matrix
mma.sp.sync.aligned.m16n8k128.row.col.satfinite.s32.u4.u4.s32
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3}, %Re, 0x0;
带块缩放的 mma 示例
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k128.row.col.kind::mxf4.block_scale.f32.e2m1.e2m1.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3},
%Re, 0,
scaleAData, {2, 1}, scaleBData, {2, 3};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .u16 bidA, bidB, tidA, tidB;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k128.row.col.kind::mxf4nvf4.block_scale.scale_vec::4X.f32.e2m1.e2m1.f32.ue4m3
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3},
%Re, 0,
scaleAData, {bidA, tidA}, scaleBData, {bidB, tidB};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .u16 bidA, bidB, tidA, tidB;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k128.row.col.kind::mxf4nvf4.block_scale.scale_vec::4X.f32.e2m1.e2m1.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3},
%Re, 0,
scaleAData, {bidA, tidA}, scaleBData, {bidB, tidB};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k64.row.col.kind::mxf8f6f4.block_scale.scale_vec::1X.f32.e3m2.e2m1.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3},
%Re, 0,
scaleAData, {0, 1}, scaleBData, {0, 1};
.reg .b32 %Ra<4>, %Rb<4>;
.reg .f32 %Rc<4>, %Rd<4>;
.reg .b32 scaleAData, scaleBData;
.reg .b32 %Re;
mma.sp::ordered_metadata.sync.aligned.m16n8k64.row.col.kind::mxf8f6f4.block_scale.scale_vec::1X.f32.e4m3.e5m2.f32.ue8m0
{%Rd0, %Rd1, %Rd2, %Rd3},
{%Ra0, %Ra1, %Ra2, %Ra3},
{%Rb0, %Rb1, %Rb2, %Rb3},
{%Rc0, %Rc1, %Rc2, %Rc3},
%Re, 0,
scaleAData, {0, 1}, scaleBData, {0, 0};
9.7.17. 异步 Warpgroup 级矩阵乘加指令#
Warpgroup 级矩阵乘加运算具有以下两种形式之一,其中矩阵 D 称为累加器:
D = A * B + DD = A * B,其中来自累加器 D 的输入被禁用。
wgmma 指令通过让 warpgroup 中的所有线程共同执行以下动作,来执行 warpgroup 级矩阵乘加运算:
将矩阵 A、B 和 D 加载到寄存器或共享内存中。
-
执行以下
fence操作:wgmma.fence操作,用于指示整个 warpgroup 的寄存器/共享内存已被写入。fence.proxy.async操作,用于使通用代理操作对异步代理可见。
使用
wgmma.mma_async操作对输入矩阵发起异步矩阵乘加运算。wgmma.mma_async操作在异步代理中执行。创建一个 wgmma-group,并使用
wgmma.commit_group操作将所有先前未完成的wgmma.mma_async操作提交到该组中。等待所需的 wgmma-group 完成。
一旦 wgmma-group 完成,所有
wgmma.mma_async操作均已执行并完成。
9.7.17.1. Warpgroup#
warpgroup 是一组四个连续的 warp,其中第一个 warp 的 warp-rank 是 4 的倍数。
一个 warp 的 warp-rank 定义如下:
(%tid.x + %tid.y * %ntid.x + %tid.z * %ntid.x * %ntid.y) / 32
9.7.17.2. 矩阵形状#
矩阵乘累加运算对操作数矩阵 A、B 和 D 仅支持有限的一组形状。三个矩阵操作数的形状统一由元组 MxNxK 描述,其中 A 是 MxK 矩阵,B 是 KxN 矩阵,而 D 是 MxN 矩阵。
对于 wgmma.mma_async 运算,下列矩阵形状在指定类型下受支持:
被乘数数据类型 |
稀疏性 |
形状 |
|---|---|---|
浮点 - |
稠密 |
|
其他浮点格式 - |
||
其他浮点格式 - |
稀疏 |
|
其他浮点格式 - |
稠密 |
|
其他浮点格式 - |
稠密 |
|
浮点 - |
稀疏 |
|
其他浮点格式 - |
||
整数 - |
稠密 |
|
其他浮点格式 - |
稀疏 |
|
整数 - |
稀疏 |
|
单比特 - |
稠密 |
|
9.7.17.3. 矩阵数据类型#
矩阵乘累加运算分别支持整数、浮点、子字节整数和单比特数据类型。所有操作数必须具有相同的基本类型种类,即整数或浮点。
对于浮点矩阵乘累加运算,不同的矩阵操作数可以具有不同的精度,详见后文。
对于整数矩阵乘累加运算,两个被乘数矩阵(A 和 B)的元素必须具有相同的数据类型,例如均为有符号整数或均为无符号整数。
数据类型 |
被乘数(A 或 B) |
累加器(D) |
|---|---|---|
整数 |
均为 |
|
浮点 |
|
|
其他浮点 |
|
|
其他浮点 |
|
|
其他浮点 |
|
|
单比特整数 |
|
|
9.7.17.4. 异步代理#
wgmma.mma_async 运算在异步代理(async proxy)中执行。
跨多个代理访问同一内存位置需要跨代理栅栏。对于 async 代理,应使用 fence.proxy.async 在 generic 代理与 async 代理之间同步内存。
wgmma.mma_async 运算完成之后会隐含一个 generic-async 代理栅栏。因此,一旦观察到该异步运算完成,其结果就对 generic 代理可见。必须使用 wgmma.commit_group 和 wgmma.wait_group 运算来等待 wgmma.mma_async 指令完成。
9.7.17.5. 使用 wgmma.mma_async 指令的异步 Warpgroup 级矩阵乘累加运算#
本节介绍 warpgroup 级的 wgmma.mma_async 指令以及该指令所涉及的各种矩阵的组织方式。
9.7.17.5.1. 寄存器片段与共享内存矩阵布局#
warpgroup 级 MMA 运算的输入矩阵 A 可以位于寄存器中,也可以位于共享内存中。warpgroup 级 MMA 运算的输入矩阵 B 必须位于共享内存中。本节介绍 warpgroup MMA 指令所期望的寄存器片段与共享内存的布局。
当矩阵位于共享内存中时,其起始地址必须按 16 字节对齐。
9.7.17.5.1.1. 寄存器片段#
本节介绍位于 wgmma.mma_async 指令寄存器操作数中的各种矩阵的组织方式。
9.7.17.5.1.1.1. wgmma.mma_async.m64nNk16 的矩阵片段#
执行 wgmma.mma_async.m64nNk16 的 warpgroup 将计算形状为 .m64nNk16 的 MMA 运算,其中 N 是 矩阵形状 中所列的有效 n 维度。
矩阵的元素分布在 warpgroup 的各线程上,因此 warpgroup 的每个线程持有该矩阵的一个片段。
-
寄存器中的被乘数 A:
.atype
片段
元素(从低到高)
.f16/.bf16一个向量表达式,包含四个
.f16x2寄存器,每个寄存器包含来自矩阵 A 的两个.f16/.bf16元素。a0, a1, a2, a3, a4, a5, a6, a7
不同线程所持有的片段布局如图 151所示。
图 151 矩阵 A 的 WGMMA .m64nNk16 寄存器片段布局。
-
累加器 D:
.dtype
片段
元素(从低到高)
.f16一个向量表达式,包含 N/4 个
.f16x2寄存器,每个寄存器包含来自矩阵 D 的两个.f16元素。d0, d1, d2, d3, …, dX, dY, dZ, dW
where
X = N/2 - 4Y = N/2 - 3Z = N/2 - 2W = N/2 - 1N = 8*i where i = {1, 2, ... , 32}.f32一个向量表达式,包含 N/2 个
.f32寄存器。不同线程所持有的片段布局如图 152所示。
图 152 累加器矩阵 D 的 WGMMA .m64nNk16 寄存器片段布局。
9.7.17.5.1.1.2. wgmma.mma_async.m64nNk8 的矩阵片段#
执行 wgmma.mma_async.m64nNk8 的 warpgroup 将计算形状为 .m64nNk8 的 MMA 运算,其中 N 是 矩阵形状 中所列的有效 n 维度。
矩阵的元素分布在 warpgroup 的各线程上,因此 warpgroup 的每个线程持有该矩阵的一个片段。
-
寄存器中的被乘数 A:
.atype
片段
元素(从低到高)
.tf32一个向量表达式,包含四个
.b32寄存器,其中包含来自矩阵 A 的四个.tf32元素。a0, a1, a2, a3
不同线程所持有的片段布局如图 153所示。
图 153 矩阵 A 的 WGMMA .m64nNk8 寄存器片段布局。
-
累加器 D:
.dtype
片段
元素(从低到高)
.f32一个向量表达式,包含 N/2 个
.f32寄存器。d0, d1, d2, d3, …, dX, dY, dZ, dW
where
X = N/2 - 4Y = N/2 - 3Z = N/2 - 2W = N/2 - 1N = 8*i where i = {1, 2, ... , 32}不同线程所持有的片段布局如图 154所示。
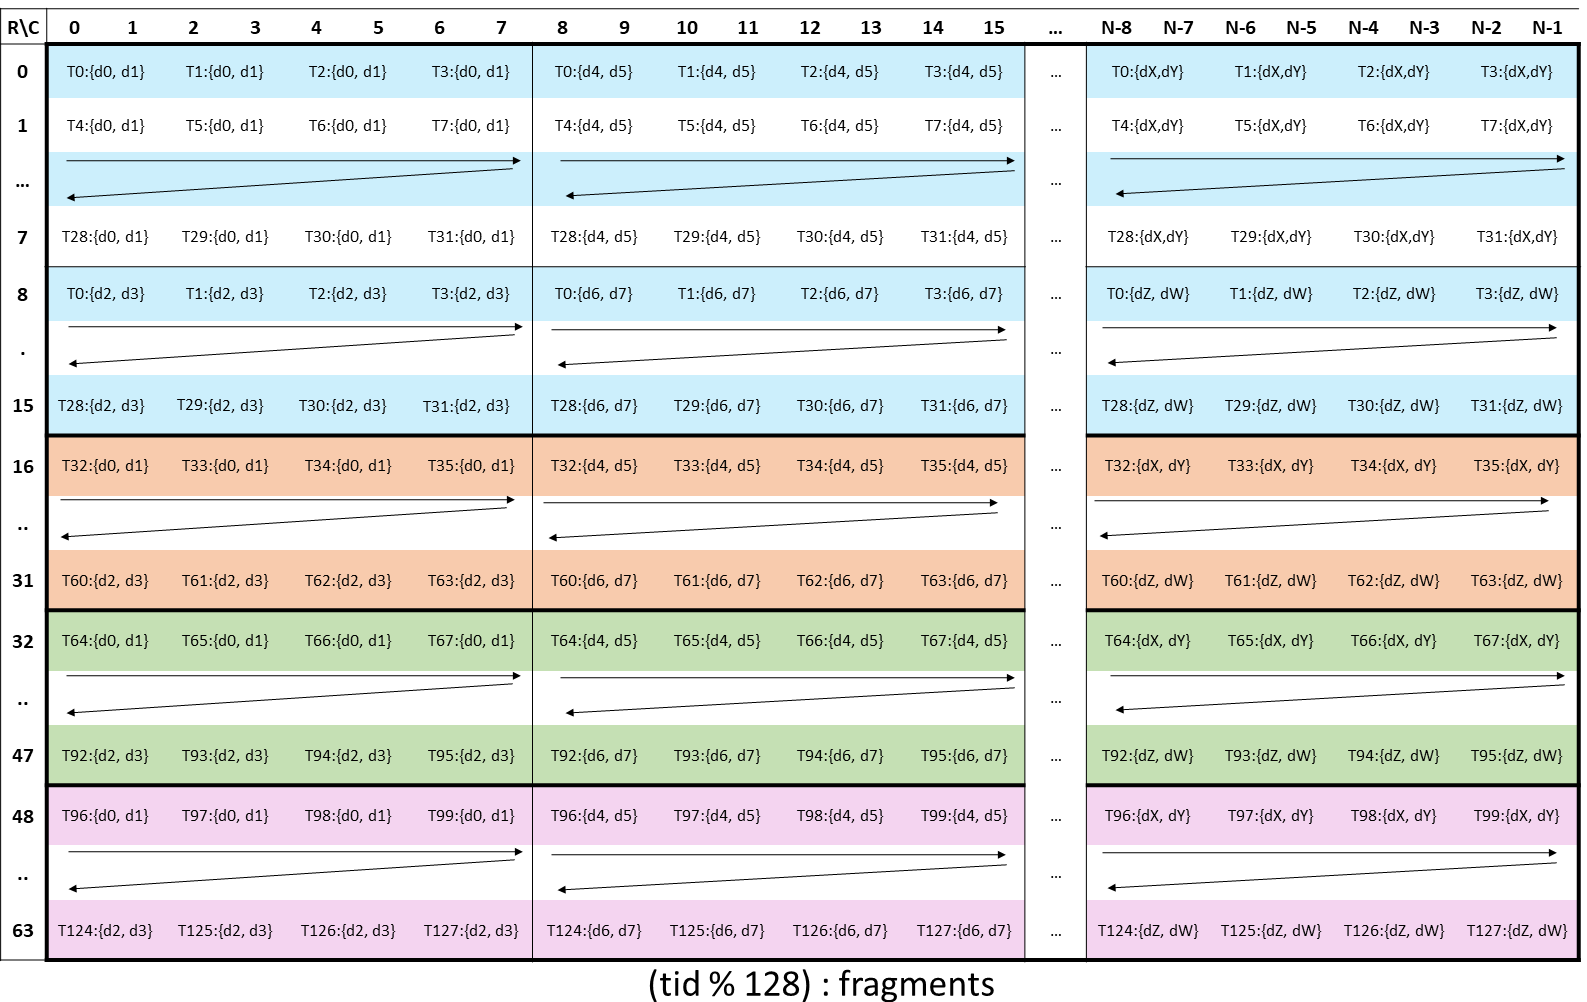
图 154 累加器矩阵 D 的 WGMMA .m64nNk8 寄存器片段布局。
9.7.17.5.1.1.3. wgmma.mma_async.m64nNk32 的矩阵片段#
执行 wgmma.mma_async.m64nNk32 的 warpgroup 将计算形状为 .m64nNk32 的 MMA 运算,其中 N 是 矩阵形状 中所列的有效 n 维度。
矩阵的元素分布在 warpgroup 的各线程上,因此 warpgroup 的每个线程持有该矩阵的一个片段。
-
寄存器中的被乘数 A:
.atype
片段
元素(从低到高)
.s8/.u8一个向量表达式,包含四个
.b32寄存器,每个寄存器包含来自矩阵 A 的四个.u8/.s8元素。a0, a1, a2, a3, … , a14, a15
.e4m3/.e5m2一个向量表达式,包含四个
.b32寄存器,每个寄存器包含来自矩阵 A 的四个.e4m3/.e5m2元素。不同线程所持有的片段布局如图 155所示。
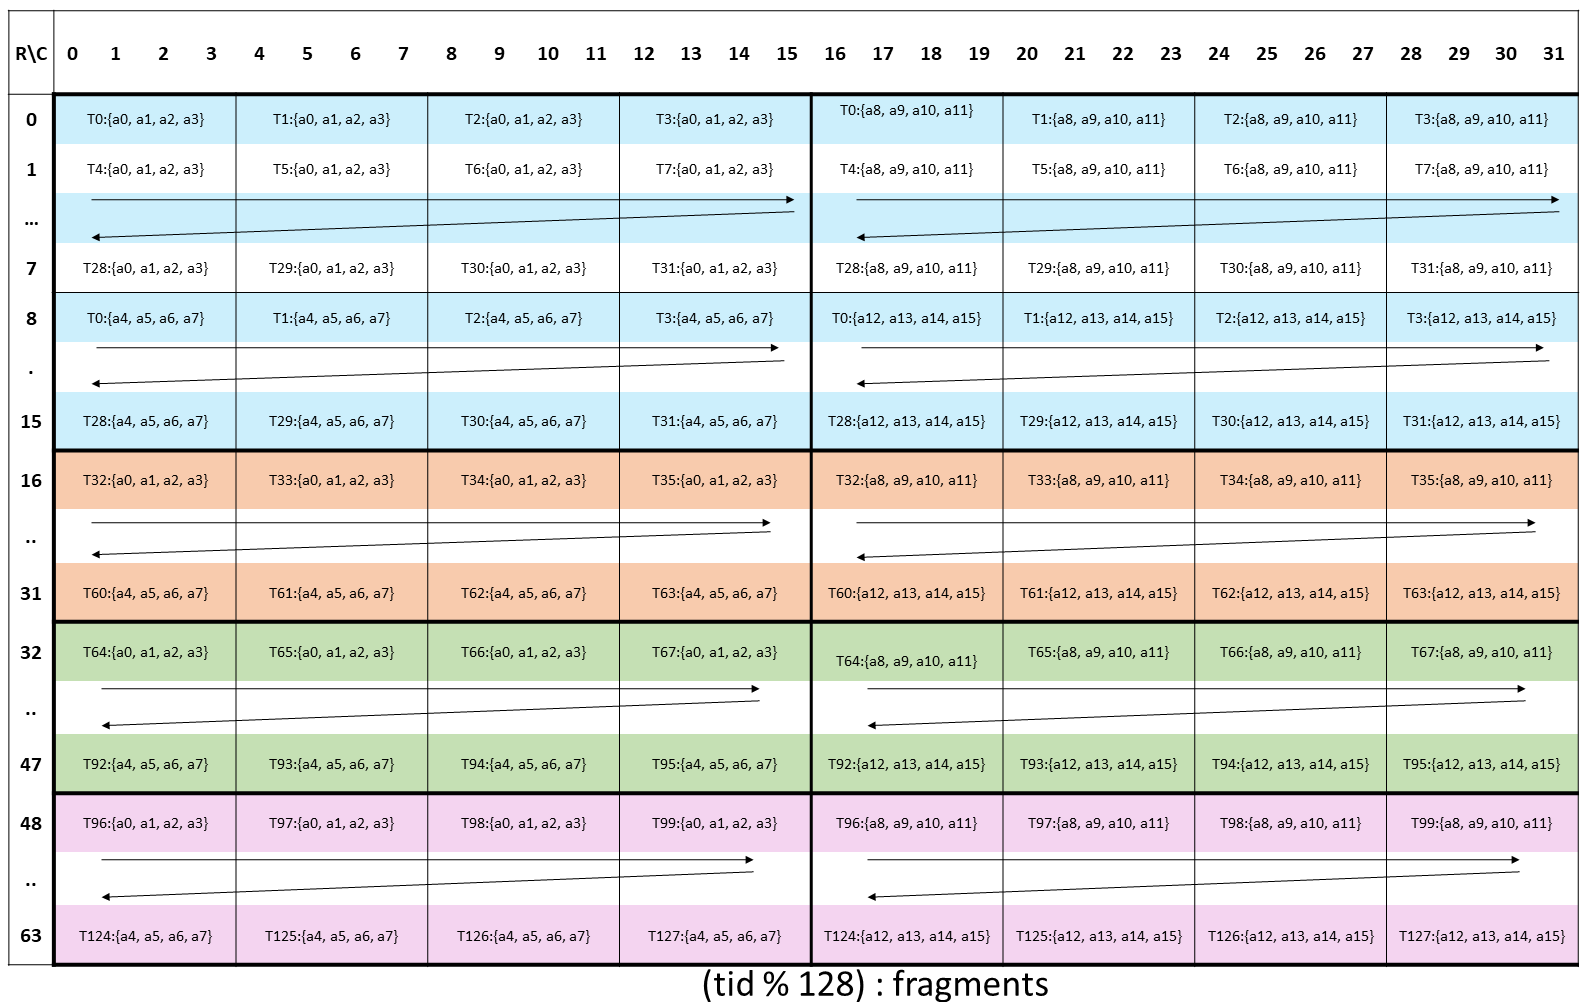
图 155 矩阵 A 的 WGMMA .m64nNk32 寄存器片段布局。
-
累加器 D:
.dtype
片段
元素(从低到高)
其他信息
.s32一个向量表达式,包含 N/2 个
.s32寄存器。d0, d1, d2, d3, …, dX, dY, dZ, dW
where
X = N/2 - 4Y = N/2 - 3Z = N/2 - 2W = N/2 - 1N取决于 .dtype,如下一列所述。N = 8*i where i = {1, 2, 3, 4}= 16*i where i = {3, 4, ..., 15, 16}.f32一个向量表达式,包含 N/2 个
.f32寄存器。N = 8*i where i = {1, 2, ... , 32}.f16一个向量表达式,包含 N/4 个
.f16x2寄存器,每个寄存器包含来自矩阵 D 的两个.f16元素。不同线程所持有的片段布局如图 156所示。
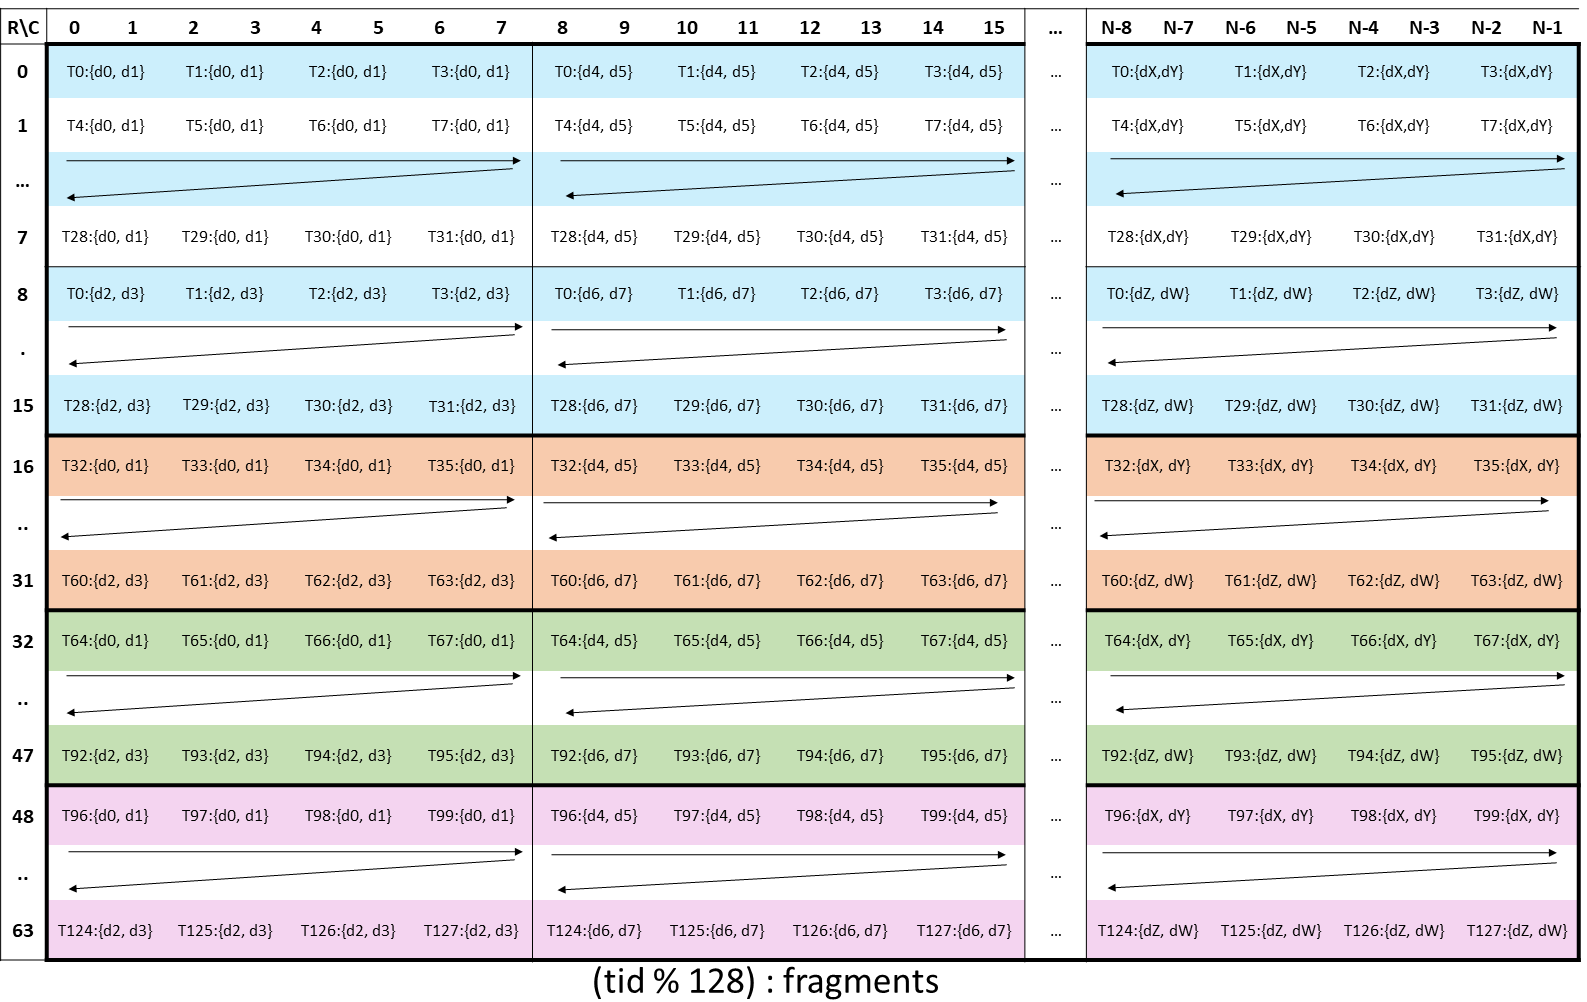
图 156 累加器矩阵 D 的 WGMMA .m64nNk32 寄存器片段布局。
9.7.17.5.1.1.4. wgmma.mma_async.m64nNk256 的矩阵片段#
执行 wgmma.mma_async.m64nNk256 的 warpgroup 将计算形状为 .m64nNk256 的 MMA 运算,其中 N 是 矩阵形状 中所列的有效 n 维度。
矩阵的元素分布在 warpgroup 的各线程上,因此 warpgroup 的每个线程持有该矩阵的一个片段。
-
寄存器中的被乘数 A:
.atype
片段
元素(从低到高)
.b1一个向量表达式,包含四个
.b32寄存器,每个寄存器包含来自矩阵 A 的三十二个.b1元素。a0, a1, a2, …, a127
不同线程所持有的片段布局如图 157所示。
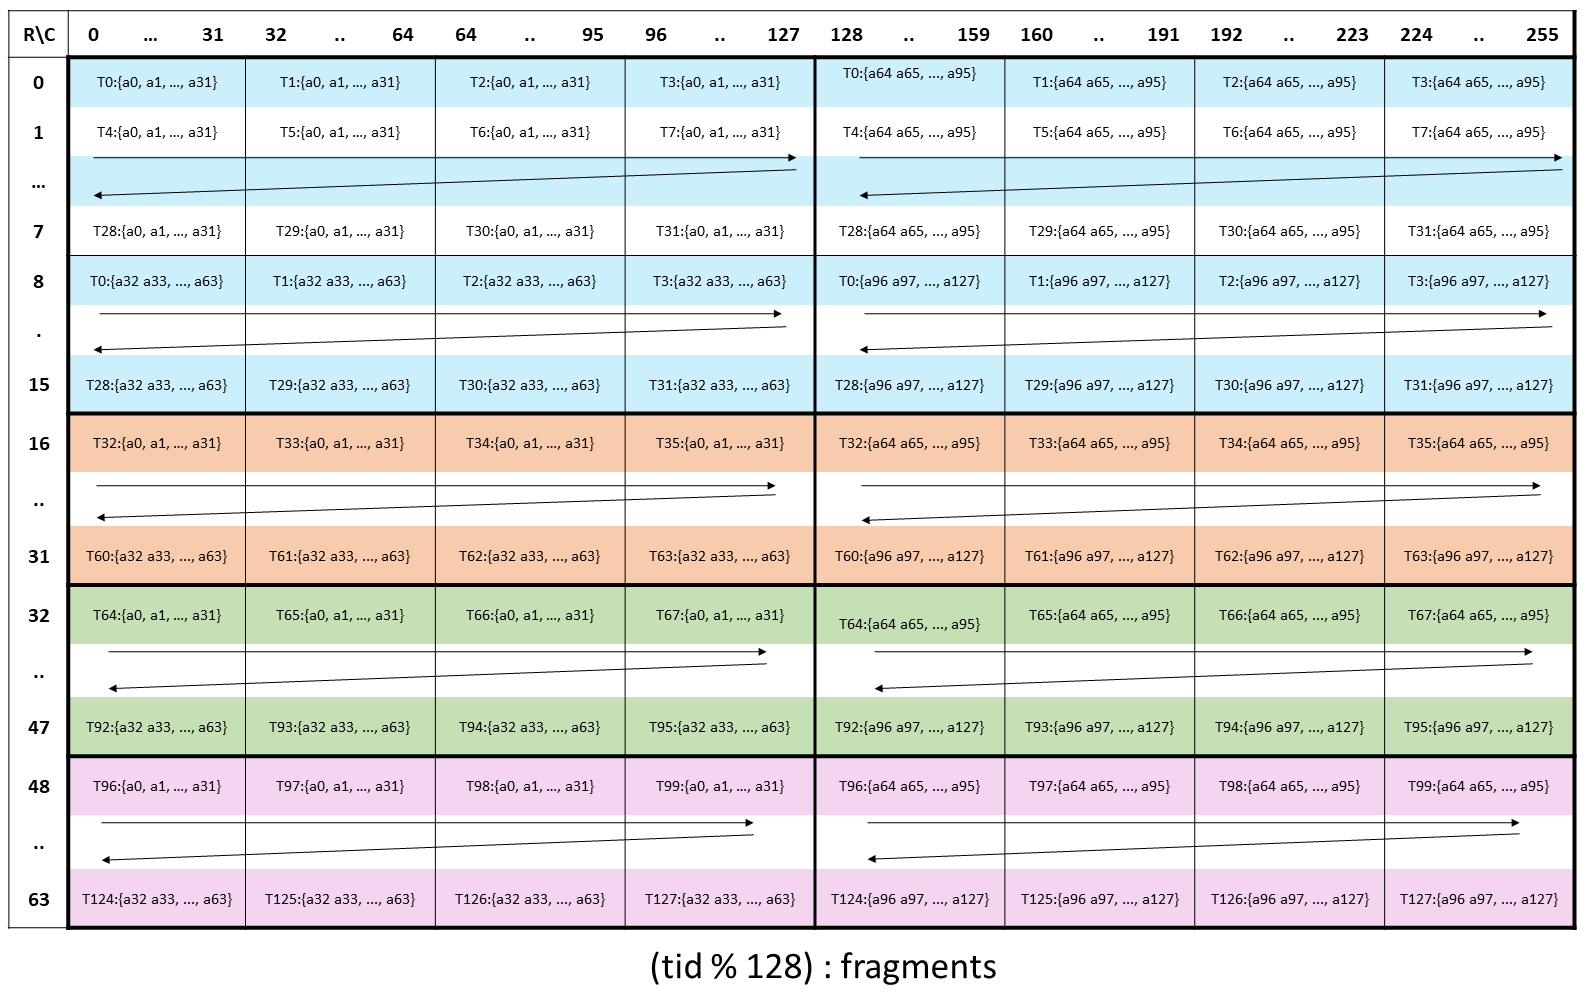
图 157 矩阵 A 的 WGMMA .m64nNk256 寄存器片段布局。
-
累加器 D:
.dtype
片段
元素(从低到高)
.s32一个向量表达式,包含 N/2 个
.s32寄存器。d0, d1, d2, d3, …, dX, dY, dZ, dW
where
X = N/2 - 4Y = N/2 - 3Z = N/2 - 2W = N/2 - 1N = 8*i where i = {1, 2, 3, 4}= 16*i where i = {3, 4, ..., 15, 16}不同线程所持有的片段布局如图 158所示。
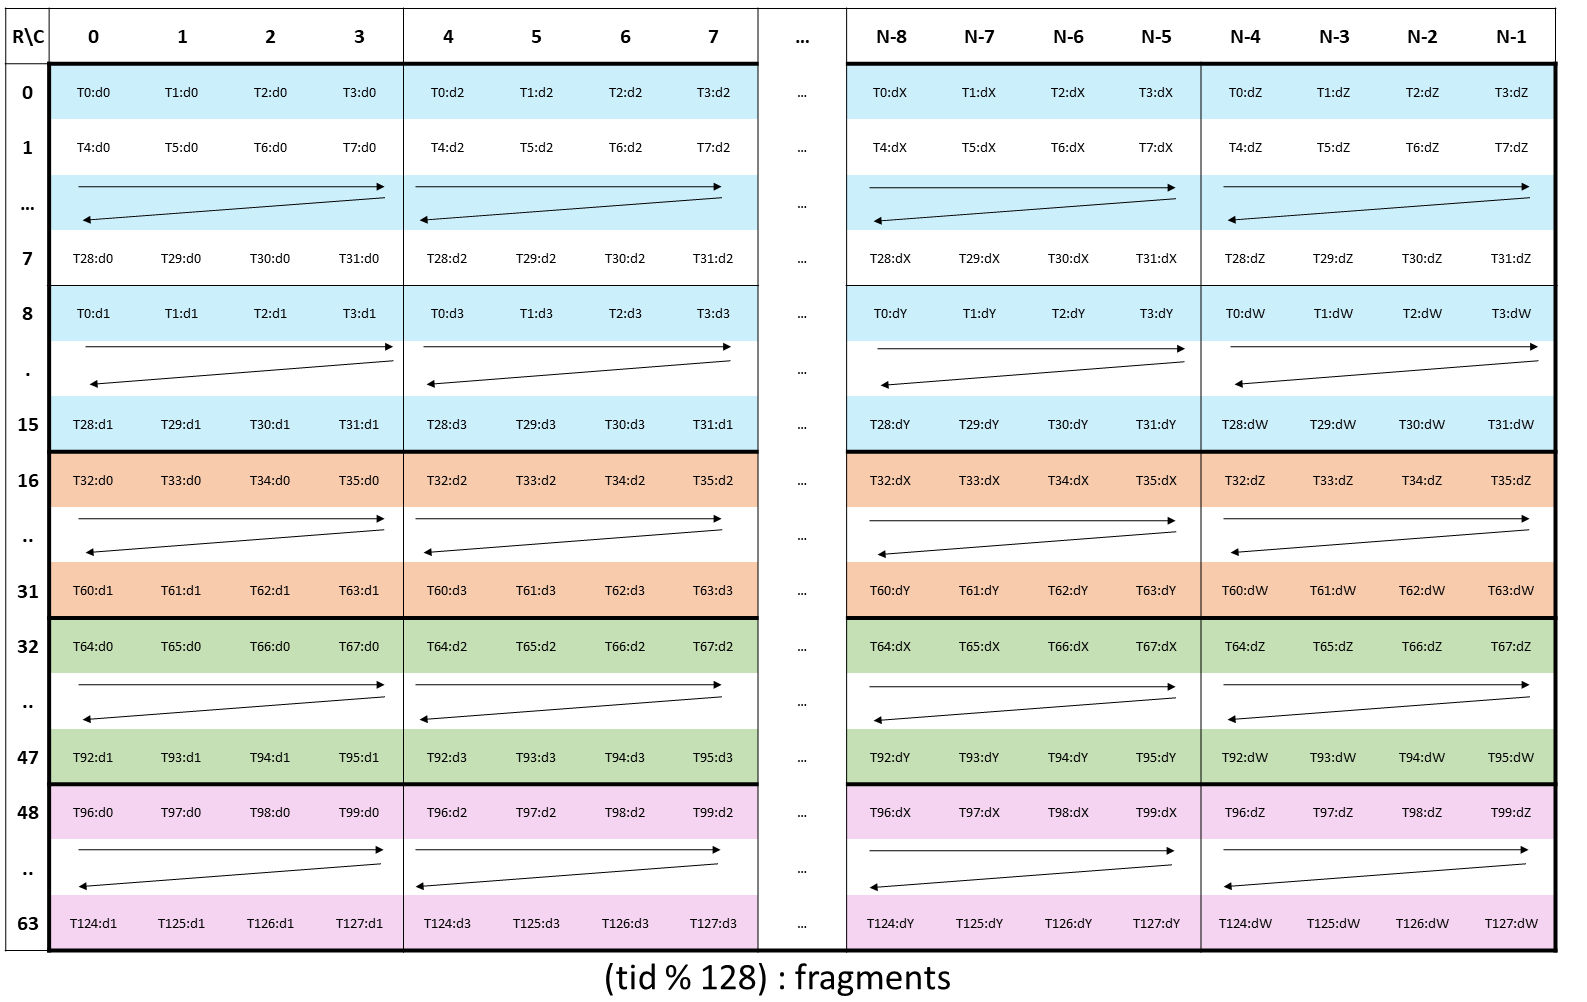
图 158 累加器矩阵 D 的 WGMMA .m64nNk256 寄存器片段布局。
9.7.17.5.1.2. 共享内存矩阵布局#
如果指令 wgmma.mma_async{.sp} 的参数 imm-trans-a / imm-trans-b 为 0,则分别对矩阵 A / B 使用 K-major。如果参数 imm-trans-a 的值为 1,则对矩阵 A 使用 M-major。如果参数 imm-trans-b 的值为 1,则对矩阵 B 使用 N-major。
在诸如 cuBLAS 这类默认列主序的 BLAS 库中,转置与未转置的矩阵 A 和 B 可归类为 K-Major 或 M-or-N-Major,如下表所示:
非转置 |
转置 |
|
|---|---|---|
A |
K-major |
M-major |
B |
K-major |
N-major |
为避免与 A、B、row-major、col-major、transpose 和 non-transpose 混淆,本节中我们将通篇使用 MN-Major 和 K-Major。
共享内存中的矩阵由一个或多个“swizzle 布局原子(swizzle layout atom)”构成。这些 swizzle 原子的确切布局取决于 swizzling 模式、swizzle 原子性(swizzle-atomicity)以及前导维度。swizzle 的布局如表 47 所示。
swizzle 模式 |
前导维度 / 主序性 |
swizzle 原子布局(128b 元素) |
|---|---|---|
128B swizzle 模式 |
M/N |
8x8 |
K |
8x8 |
|
64B swizzle 模式 |
M/N |
4x8 |
K |
8x4 |
|
32B swizzle 模式 |
M/N |
2x8 |
K |
8x2 |
|
无 |
M/N |
1x8 |
K |
8x1 |
上述形状针对大小为 128 位的元素。对于更小的元素大小,相同的形状会沿前导维度乘以因子 128/sizeof_bits(Element)。例如,对于 tf32 tensor core 输入,128B MN major swizzle 原子的形状为 (8*(128/32))x8 = 32x8。
示例
以下是采用各种 swizzling 模式的 MxK 或 KxN 矩阵的一些示例布局,单位为 128b 元素,每个彩色单元格如图 159、图 160、图 161、图 162、图 163、图 164、图 165、图 166 所示。
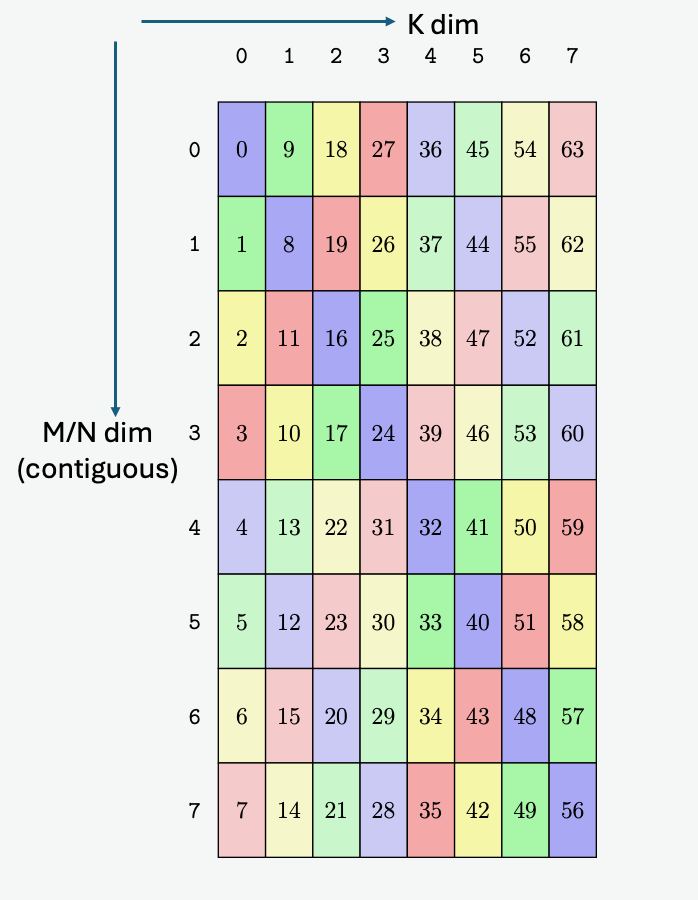
图 159 MN major 128B swizzling
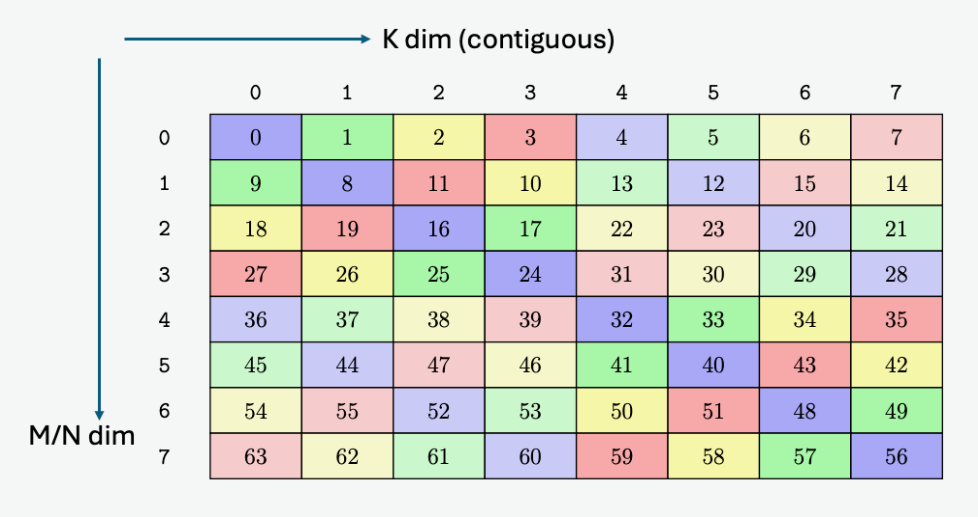
图 160 K major 128B swizzling
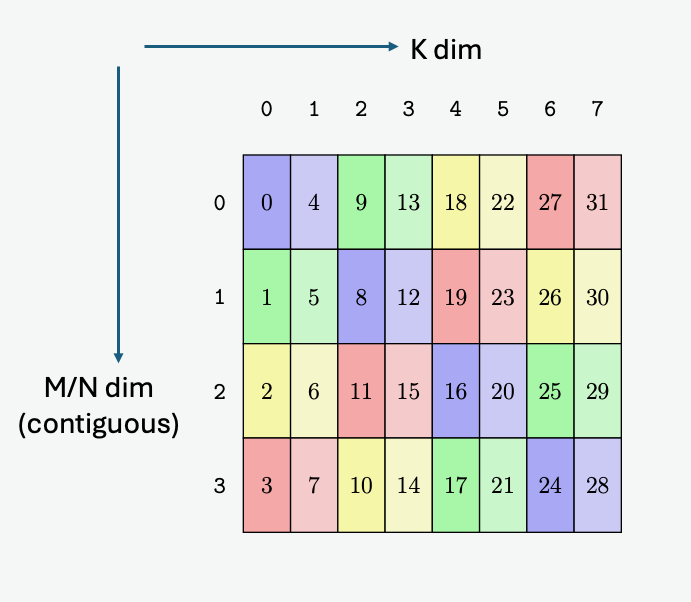
图 161 MN major 64B swizzling
图 162 K major 64B swizzling
图 163 MN major 32B swizzling
图 164 K major 32B swizzling
图 165 MN major 交织
图 166 K major 交织
以下是 tf32 元素类型的 128B swizzling 布局的一些示例。
9.7.17.5.1.2.1. Stride 支持的主序性#
从共享内存访问矩阵时会涉及两种 stride:
前导维度字节偏移
Stride 维度字节偏移
9.7.17.5.1.2.1.1. 前导维度字节偏移#
对于转置矩阵和非转置矩阵,前导维度字节偏移的定义有所不同。对于元素类型归一化为 128 位的矩阵,前导字节偏移的定义如下:
主序性 |
定义 |
|---|---|
K-Major |
|
MN-Major |
|
9.7.17.5.1.2.1.2. Stride 维度字节偏移#
对于转置矩阵和非转置矩阵,stride 维度字节偏移的定义有所不同。对于元素类型归一化为 128 位的矩阵,stride 维度字节偏移的定义如下:
主序性 |
定义 |
|---|---|
K-Major |
从第一个 8 行到下一个 8 行的偏移。 |
MN-Major |
|
9.7.17.5.1.2.1.3. 规范布局#
用 CuTe 布局 来表达,规范布局可以写成如下形式:
主序性 |
swizzle 模式 |
无 swizzling 时的规范布局 |
对前一列应用 Swizzling |
|---|---|---|---|
MN-major |
无 swizzling 或交织 |
((T,1,m),(8,k)):((1,T,SBO),(1T,LBO)) |
Swizzle<0, 4, 3> |
32B swizzling |
((T,2,m),(8,k)):((1,T,LBO),(2T,SBO)) |
Swizzle<1, 4, 3> |
|
64B swizzling |
((T,4,m),(8,k)):((1,T,LBO),(4T,SBO)) |
Swizzle<2, 4, 3> |
|
128B swizzling |
((T,8,m),(8,k)):((1,T,LBO),(8T,SBO)) |
Swizzle<3, 4, 3> |
|
K-major |
无 swizzling 或交织 |
((8,m),(T,2k)):((1T,SBO),(1,LBO)) |
Swizzle<0, 4, 3> |
32B swizzling |
((8,m),(T,2k)):((2T,SBO),(1,T)) |
Swizzle<1, 4, 3> |
|
64B swizzling |
((8,m),(T,2k)):((4T,SBO),(1,T)) |
Swizzle<2, 4, 3> |
|
128B swizzling |
((8,m),(T,2k)):((8T,SBO),(1,T)) |
Swizzle<3, 4, 3> |
其中
T = 128 / sizeof-elements-in-bits T 表示将矩阵元素类型归一化为 128 位的比例因子。
m 表示沿行方向重复模式的数量。
k 表示沿列方向重复模式的数量。
示例
-
K-Major,无 swizzling 且类型为 tf32:图 169
图 169 K major,无 swizzling 且类型为 tf32
stride 及相关细节如下:
确切布局:Swizzle<0,4,3> o ((8,2),(4,4)):((4,32),(1,64))
规范布局:Swizzle<0,4,3> o ((8,m),(T,2k)):((1T,SBO),(1,LBO))
参数
取值
T
4
m
2
k
2
LBO
64*sizeof(tf32)
SBO
32*sizeof(tf32)
描述符中 LBO 的编码
(LBO) >> 4 = 16
描述符中 SBO 的编码
(SBO) >> 4 = 8
-
K-Major,32B swizzling 且类型为 tf32:图 170
图 170 K major,32B swizzling 且类型为 tf32
stride 及相关细节如下:
确切布局:Swizzle<1,4,3> o ((8,2),(4,2)):((8,64),(1,4))
规范布局:Swizzle<1,4,3> o ((8,m),(T,2k)):((2T,SBO),(1,T))
参数
取值
T
4
m
2
k
1
LBO
NA
SBO
64*sizeof(tf32)
描述符中 LBO 的编码
1(假定)
描述符中 SBO 的编码
(SBO) >> 4 = 16
-
MN-Major,无 swizzling 且类型为 bf16:图 171
图 171 MN major,无 swizzling 且类型为 bf16
stride 及相关细节如下:
确切布局:Swizzle<0,4,3> o ((8,1,2),(8,2)):((1,8,64),(8,128))
规范布局:Swizzle<0,4,3> o ((T,1,m),(8,k)):((1,T,SBO),(1T,LBO))
参数
取值
T
8
m
2
k
2
LBO
128*sizeof(bf16)
SBO
64*sizeof(bf16)
描述符中 LBO 的编码
(LBO) >> 4 = 16
描述符中 SBO 的编码
(SBO) >> 4 = 8
-
MN-Major,32B swizzling 且类型为 bf16:图 172
图 172 MN major,32B swizzling 且类型为 bf16
stride 及相关细节如下:
确切布局:Swizzle<1,4,3> o ((8,2,2),(8,2)):((1,8,128),(16,256))
规范布局:Swizzle<1,4,3> o ((T,2,m),(8,k)):((1,T,LBO),(2T,SBO))
参数
取值
T
8
m
2
k
2
LBO
128*sizeof(bf16)
SBO
256*sizeof(bf16)
描述符中 LBO 的编码
(LBO) >> 4 = 16
描述符中 SBO 的编码
(SBO) >> 4 = 32
-
MN-Major,64B swizzling 且类型为 bf16:图 173
图 173 MN major,64B swizzling 且类型为 bf16
stride 及相关细节如下:
确切布局:Swizzle<2,4,3> o ((8,4,2),(8,2)):((1,8,256),(32,512))
规范布局:Swizzle<2,4,3> o ((T,4,m),(8,k)):((1,T,LBO),(4T,SBO))
参数
取值
T
8
m
2
k
2
LBO
256*sizeof(bf16)
SBO
512*sizeof(bf16)
描述符中 LBO 的编码
(LBO) >> 4 = 32
描述符中 SBO 的编码
(SBO) >> 4 = 64
9.7.17.5.1.2.2. 矩阵描述符格式#
矩阵描述符用于指定共享内存中矩阵的属性,该矩阵是矩阵乘加运算中的一个被乘数。它是一个保存在寄存器中的 64 位值,具有以下布局:
位域 |
位数 |
说明 |
|---|---|---|
13–0 |
14 |
matrix-descriptor-encode(矩阵起始地址) |
29–16 |
14 |
matrix-descriptor-encode (前导维度字节偏移) |
45–32 |
14 |
matrix-descriptor-encode (Stride 维度字节偏移) |
51–49 |
3 |
矩阵基偏移。对于除无 swizzle 模式之外的所有 swizzling 模式,该字段都有效。 |
63–62 |
2 |
指定要使用的 swizzling 模式:
|
其中
matrix-descriptor-encode(x) = (x & 0x3FFFF) >> 4
当指定的 swizzling 模式的重复模式按下表开始时,基偏移的值为 0:
swizzle 模式
重复模式的起始地址
128-Byte swizzle
1024-Byte 边界
64-Byte swizzle
512-Byte 边界
32-Byte swizzle
256-Byte 边界
否则,基偏移必须为非零值,并使用以下公式计算:
base offset = (pattern start addr >> 0x7) & 0x7
9.7.17.5.2. 异步乘加指令:wgmma.mma_async#
wgmma.mma_async
在整个 warpgroup 上执行矩阵乘加运算
语法
半精度浮点类型:
wgmma.mma_async.sync.aligned.shape.dtype.f16.f16 d, a-desc, b-desc, scale-d, imm-scale-a, imm-scale-b, imm-trans-a, imm-trans-b;
wgmma.mma_async.sync.aligned.shape.dtype.f16.f16 d, a, b-desc, scale-d, imm-scale-a, imm-scale-b, imm-trans-b;
.shape = {.m64n8k16, .m64n16k16, .m64n24k16, .m64n32k16,
.m64n40k16, .m64n48k16, .m64n56k16, .m64n64k16,
.m64n72k16, .m64n80k16, .m64n88k16, .m64n96k16,
.m64n104k16, .m64n112k16, .m64n120k16, .m64n128k16,
.m64n136k16, .m64n144k16, .m64n152k16, .m64n160k16,
.m64n168k16, .m64n176k16, .m64n184k16, .m64n192k16,
.m64n200k16, .m64n208k16, .m64n216k16, .m64n224k16,
.m64n232k16, .m64n240k16, .m64n248k16, .m64n256k16};
.dtype = {.f16, .f32};
其他浮点类型:
.bf16 floating point type:
wgmma.mma_async.sync.aligned.shape.dtype.bf16.bf16 d, a-desc, b-desc, scale-d, imm-scale-a, imm-scale-b, imm-trans-a, imm-trans-b;
wgmma.mma_async.sync.aligned.shape.dtype.bf16.bf16 d, a, b-desc, scale-d, imm-scale-a, imm-scale-b, imm-trans-b;
.shape = {.m64n8k16, .m64n16k16, .m64n24k16, .m64n32k16,
.m64n40k16, .m64n48k16, .m64n56k16, .m64n64k16,
.m64n72k16, .m64n80k16, .m64n88k16, .m64n96k16,
.m64n104k16, .m64n112k16, .m64n120k16, .m64n128k16,
.m64n136k16, .m64n144k16, .m64n152k16, .m64n160k16,
.m64n168k16, .m64n176k16, .m64n184k16, .m64n192k16,
.m64n200k16, .m64n208k16, .m64n216k16, .m64n224k16,
.m64n232k16, .m64n240k16, .m64n248k16, .m64n256k16};
.dtype = {.f32};
.tf32 floating point type:
wgmma.mma_async.sync.aligned.shape.dtype.tf32.tf32 d, a-desc, b-desc, scale-d, imm-scale-a, imm-scale-b;
wgmma.mma_async.sync.aligned.shape.dtype.tf32.tf32 d, a, b-desc, scale-d, imm-scale-a, imm-scale-b;
.shape = {.m64n8k8, .m64n16k8, .m64n24k8, .m64n32k8,
.m64n40k8, .m64n48k8, .m64n56k8, .m64n64k8,
.m64n72k8, .m64n80k8, .m64n88k8, .m64n96k8,
.m64n104k8, .m64n112k8, .m64n120k8, .m64n128k8,
.m64n136k8, .m64n144k8, .m64n152k8, .m64n160k8,
.m64n168k8, .m64n176k8, .m64n184k8, .m64n192k8,
.m64n200k8, .m64n208k8, .m64n216k8, .m64n224k8,
.m64n232k8, .m64n240k8, .m64n248k8, .m64n256k8};
.dtype = {.f32};
FP8 floating point type
wgmma.mma_async.sync.aligned.shape.dtype.atype.btype d, a-desc, b-desc, scale-d, imm-scale-a, imm-scale-b;
wgmma.mma_async.sync.aligned.shape.dtype.atype.btype d, a, b-desc, scale-d, imm-scale-a, imm-scale-b;
.shape = {.m64n8k32, .m64n16k32, .m64n24k32, .m64n32k32,
.m64n40k32, .m64n48k32, .m64n56k32, .m64n64k32,
.m64n72k32, .m64n80k32, .m64n88k32, .m64n96k32,
.m64n104k32, .m64n112k32, .m64n120k32, .m64n128k32,
.m64n136k32, .m64n144k32, .m64n152k32, .m64n160k32,
.m64n168k32, .m64n176k32, .m64n184k32, .m64n192k32,
.m64n200k32, .m64n208k32, .m64n216k32, .m64n224k32,
.m64n232k32, .m64n240k32, .m64n248k32, .m64n256k32};
.atype = {.e4m3, .e5m2};
.btype = {.e4m3, .e5m2};
.dtype = {.f16, .f32};
整数类型:
wgmma.mma_async.sync.aligned.shape{.satfinite}.s32.atype.btype d, a-desc, b-desc, scale-d;
wgmma.mma_async.sync.aligned.shape{.satfinite}.s32.atype.btype d, a, b-desc, scale-d;
.shape = {.m64n8k32, .m64n16k32, .m64n24k32, .m64n32k32,
.m64n48k32, .m64n64k32, .m64n80k32, .m64n96k32,
.m64n112k32, .m64n128k32, .m64n144k32, .m64n160k32,
.m64n176k32, .m64n192k32, .m64n208k32, .m64n224k32};
.atype = {.s8, .u8};
.btype = {.s8, .u8};
单比特:
wgmma.mma_async.sync.aligned.shape.s32.b1.b1.op.popc d, a-desc, b-desc, scale-d;
wgmma.mma_async.sync.aligned.shape.s32.b1.b1.op.popc d, a, b-desc, scale-d;
.shape = {.m64n8k256, .m64n16k256, .m64n24k256, .m64n32k256,
.m64n48k256, .m64n64k256, .m64n80k256, .m64n96k256,
.m64n112k256, .m64n128k256, .m64n144k256, .m64n160k256,
.m64n176k256, .m64n192k256, .m64n208k256, .m64n224k256,
.m64n240k256, .m64n256k256};
.op = {.and};
说明
指令 wgmma.mma_async 发起一个 MxNxK 矩阵乘加运算 D = A*B+D,其中 A 矩阵为 MxK,B 矩阵为 KxN,D 矩阵为 MxN。
当输入谓词参数 scale-d 为 false 时,发起形式为 D = A*B 的运算。
必须使用 wgmma.fence 指令为 wgmma.mma_async 指令的寄存器访问相对于其先前的访问建立栅栏。否则,行为未定义。
在访问结果之前,必须使用 wgmma.commit_group 和 wgmma.wait_group 操作等待异步矩阵乘加运算完成。
寄存器操作数 d 表示累加矩阵,同时也是目标矩阵,分布于参与运算的线程之间。寄存器操作数 a 表示被乘矩阵 A,以寄存器形式分布于参与运算的线程之间。64 位寄存器操作数 a-desc 和 b-desc 是矩阵描述符,分别表示共享内存中的被乘矩阵 A 和 B。矩阵描述符的内容在 warpgroup 中的所有 warp 之间必须相同。矩阵描述符的格式见 矩阵描述符格式。
矩阵 A 和 B 分别以行主序和列主序格式存储。对于某些浮点变体,可以通过分别为立即数整数参数 imm-trans-a 和 imm-trans-b 指定值 1 来转置输入矩阵 A 和 B。使用值 0 可以避免转置操作。imm-trans-a 和 imm-trans-b 的有效值为 0 和 1。转置操作仅在 .f16/.bf16 类型的 wgmma.mma_async 变体上受支持,且这些矩阵须使用矩阵描述符从共享内存访问。
对于 wgmma.mma_async 运算的浮点变体,可以分别为操作数 imm-scale-a 和 imm-scale-b 指定值 -1 来对输入矩阵 A 和 B 的每个元素取负。使用值 1 可以避免取负操作。imm-scale-a 和 imm-scale-b 的有效值为 -1 和 1。
限定符 .dtype、.atype 和 .btype 分别表示矩阵 D、A 和 B 中元素的数据类型。除 FP8 浮点变体外,所有浮点 wgmma.mma_async 变体的 .atype 和 .btype 必须相同。在 wgmma.mma_async 运算的其他浮点变体中,矩阵 A 和 B 各数据元素的大小如下:
当
.atype/.btype为.e4m3/.e5m2时,矩阵 A 和 B 具有 8 位数据元素。当
.atype/.btype为.bf16时,矩阵 A 和 B 具有 16 位数据元素。当
.atype/.btype为.tf32时,矩阵 A 和 B 具有 32 位数据元素。
精度与舍入:
-
浮点运算:
矩阵 A 和 B 的逐元素乘法以至少单精度执行。当
.dtype为.f32时,中间值的累加以至少单精度执行。当.dtype为.f16时,累加以至少半精度执行。累加顺序、舍入以及次正规输入的处理均未指定。
-
.bf16和.tf32浮点运算:矩阵 A 和 B 的逐元素乘法以指定的精度执行。涉及
.tf32类型的wgmma.mma_async运算会在发起乘法之前截断 32 位输入数据的低 13 位。中间值的累加以至少单精度执行。累加顺序、舍入以及次正规输入的处理均未指定。
-
整数运算:
整数
wgmma.mma_async运算使用.s32累加器执行。.satfinite限定符表示在溢出时,累加值被限制在范围 MIN_INT32.. MAX_INT32 内(其中边界分别定义为最小负的有符号 32 位整数和最大正的有符号 32 位整数)。如果未指定
.satfinite,则累加值改为回绕。
注释
对于 .atype 和 .btype 为 .e4m3 或 .e5m2 且 .dtype 为 .f32 的情况,当前实现以高于半精度但低于单精度的精度进行累加。
必需的 .sync 限定符表示 wgmma.mma_async 指令会使执行线程等待,直到 warp 中的所有线程都执行同一条 wgmma.mma_async 指令后才继续执行。
必需的 .aligned 限定符表示 warpgroup 中的所有线程必须执行同一条 wgmma.mma_async 指令。在有条件执行的代码中,只有当已知 warpgroup 中的所有线程对该条件的求值结果相同时,才应使用 wgmma.mma_async 指令,否则行为未定义。
半精度浮点类型的示例
.reg .f16x2 f16a<40>, f16d<40>;
.reg .f32 f32d<40>;
.reg .b64 descA, descB;
.reg .pred scaleD;
wgmma.mma_async.sync.aligned.m64n8k16.f32.f16.f16
{f32d0, f32d1, f32d2, f32d3},
{f16a0, f16a1, f16a2, f16a3},
descB,
1, -1, -1, 1;
wgmma.mma_async.sync.aligned.m64n72k16.f16.f16.f16
{f16d0, f16d1, f16d2, f16d3, f16d4, f16d5, f16d6, f16d7, f16d8,
f16d9, f16d10, f16d11, f16d12, f16d13, f16d14, f16d15, f16d16, f16d17},
descA,
descB,
scaleD, -1, 1, 1, 0;
其他浮点类型的示例
.reg .f32 f32d<40>;
.reg .b32 bf16a<40>
.reg .b64 descA, descB;
wgmma.mma_async.sync.aligned.m64n120k16.f32.bf16.bf16
{f32d0, f32d1, f32d2, f32d3, f32d4, f32d5, f32d6, f32d7, f32d8, f32d9,
f32d10, f32d11, f32d12, f32d13, f32d14, f32d15, f32d16, f32d17, f32d18, f32d19,
f32d20, f32d21, f32d22, f32d23, f32d24, f32d25, f32d26, f32d27, f32d28, f32d29,
f32d30, f32d31, f32d32, f32d33, f32d34, f32d35, f32d36, f32d37, f32d38, f32d39,
f32d40, f32d41, f32d42, f32d43, f32d44, f32d45, f32d46, f32d47, f32d48, f32d49,
f32d50, f32d51, f32d52, f32d53, f32d54, f32d55, f32d56, f32d57, f32d58, f32d59},
{bf16a0, bf16a1, bf16a2, bf16a3},
descB,
scaleD, -1, -1, 0;
.reg .f32 f32d<40>;
.reg .b64 descA, descB;
wgmma.mma_async.sync.aligned.m64n16k8.f32.tf32.tf32
{f32d0, f32d1, f32d2, f32d3, f32d4, f32d5, f32d6, f32d7},
descA,
descB,
0, -1, -1;
.reg .b32 f16d<8>, f16a<8>;
.reg .f32 f32d<8>;
.reg .b64 descA, descB;
wgmma.mma_async.sync.aligned.m64n8k32.f16.e4m3.e5m2
{f16d0, f16d1},
descA,
descB,
scaleD, -1, 1;
wgmma.mma_async.sync.aligned.m64n8k32.f32.e5m2.e4m3
{f32d0, f32d1, f32d2, f32d3},
{f16a0, f16a1, f16a2, f16a3},
descB,
1, -1, -1;
整数类型的示例
.reg .s32 s32d<8>, s32a<8>;
.reg .u32 u32a<8>;
.reg .pred scaleD;
.reg .b64 descA, descB;
wgmma.mma_async.sync.aligned.m64n8k32.s32.s8.s8.satfinite
{s32d0, s32d1, s32d2, s32d3},
{s32a0, s32a1, s32a2, s32a3},
descB,
1;
wgmma.mma_async.sync.aligned.m64n8k32.s32.u8.u8
{s32d0, s32d1, s32d2, s32d3},
descA,
descB,
scaleD;
wgmma.mma_async.sync.aligned.m64n8k32.s32.s8.u8.satfinite
{s32d0, s32d1, s32d2, s32d3},
{s32a0, s32a1, s32a2, s32a3},
descB,
scaleD;
wgmma.mma_async.sync.aligned.m64n8k32.s32.u8.s8
{s32d0, s32d1, s32d2, s32d3},
descA,
descB,
scaleD;
单比特类型的示例
.reg .s32 s32d<4>;
.reg .b32 b32a<4>;
.reg .pred scaleD;
.reg .b64 descA, descB;
wgmma.mma_async.sync.aligned.m64n8k256.s32.b1.b1.and.popc
{s32d0, s32d1, s32d2, s32d3},
{b32a0, b32a1, b32a2, b32a3},
descB,
scaleD;
9.7.17.6. 使用 wgmma.mma_async.sp 指令的异步 Warpgroup 级乘加运算#
本节描述 warp 级的 wgmma.mma_async.sp 指令(使用稀疏矩阵 A)。当 A 是一个结构化稀疏矩阵,且每行按形状特定的粒度分布有 50% 的零元素时,可以使用 wgmma.mma_async 运算的这一变体。对于一个 MxNxK 稀疏 wgmma.mma_async.sp 运算,MxK 矩阵 A 被打包为 MxK/2 个元素。对于矩阵 A 的每一条 K 宽的行,有 50% 的元素为零,其余 K/2 个非零元素被打包进表示矩阵 A 的操作数中。这 K/2 个元素到相应 K 宽行的映射由元数据显式提供。
9.7.17.6.1. 稀疏矩阵存储#
稀疏矩阵 A 的粒度定义为:矩阵行的子块中非零元素的数量与该子块中元素总数的比值,其中子块的大小是形状特定的。例如,对于一个用于浮点 wgmma.mma_async 运算的 64x32 矩阵 A,稀疏性要求为 2:4 粒度,即矩阵行的每个 4 元素向量(即由 4 个连续元素构成的子块)包含 2 个零。子块中每个非零元素的索引存储在元数据操作数中。值 0b0000、0b0101、0b1010、0b1111 是元数据的无效值,将导致未定义行为。在一组四个连续线程中,由一个或多个线程存储整组的元数据,具体取决于矩阵形状。这些线程由一个额外的稀疏性选择器操作数指定。
矩阵 A 及其对应的稀疏 wgmma 输入操作数与 图 114 所示的示意图类似,只是矩阵尺寸相应不同。
不同矩阵形状与数据类型的粒度如下所述。
稀疏 wgmma.mma_async.sp,半精度与 .bf16 类型
对于 .f16 和 .bf16 类型,对于所有受支持的 64xNx32 形状,矩阵 A 以 2:4 粒度结构化稀疏。换言之,矩阵 A 某一行中每 4 个相邻元素构成的块含有两个零和两个非零元素。只有这两个非零元素被存储在矩阵 A 中,它们在矩阵 A 中四宽块内的位置由元数据操作数中的两个 2 位索引指示。
图 174 稀疏 WGMMA 元数据示例(.f16/.bf16 类型)。
稀疏性选择器指示一组四个连续线程中提供稀疏性元数据的线程对。因此,稀疏性选择器必须为 0(线程 T0、T1)或 1(线程 T2、T3);任何其他值都会导致未定义行为。
稀疏 wgmma.mma_async.sp,.tf32 类型
对于 .tf32 类型,对于所有受支持的 64xNx16 形状,矩阵 A 以 1:2 粒度结构化稀疏。换言之,矩阵 A 某一行中每 2 个相邻元素构成的块含有一个零和一个非零元素。只有非零元素被存储在矩阵 A 的操作数中,元数据中的 4 位索引指示该非零元素在二宽块内的位置。0b1110 和 0b0100 是唯一有意义的索引值,其余取值都会导致未定义行为。
图 175 稀疏 WGMMA 元数据示例(.tf32 类型)。
稀疏性选择器指示一组四个连续线程中提供稀疏性元数据的线程对。因此,稀疏性选择器必须为 0(线程 T0、T1)或 1(线程 T2、T3);任何其他值都会导致未定义行为。
稀疏 wgmma.mma_async.sp,.e4m3 与 .e5m2 浮点类型
对于 .e4m3 和 .e5m2 类型,对于所有受支持的 64xNx64 形状,矩阵 A 以 2:4 粒度结构化稀疏。换言之,矩阵 A 某一行中每 4 个相邻元素构成的块含有两个零和两个非零元素。只有这两个非零元素被存储在矩阵 A 中,它们在矩阵 A 中四宽块内的位置由元数据操作数中的两个 2 位索引指示。
图 176 稀疏 WGMMA 元数据示例(.e4m3/.e5m2 类型)。
所有线程都提供稀疏性元数据,稀疏性选择器必须为 0;任何其他值都会导致未定义行为。
稀疏 wgmma.mma_async.sp,整数类型
对于整数类型,对于所有受支持的 64xNx64 形状,矩阵 A 以 2:4 粒度结构化稀疏。换言之,矩阵 A 某一行中每 4 个相邻元素构成的块含有两个零和两个非零元素。只有这两个非零元素被存储在矩阵 A 中,元数据中的两个 2 位索引指示这两个非零元素在四宽块内的位置。
图 177 稀疏 WGMMA 元数据示例(.u8/.s8 类型)。
所有线程都提供稀疏性元数据,稀疏性选择器必须为 0;任何其他值都会导致未定义行为。
9.7.17.6.2. 稀疏矩阵 A 的 warpgroup 级乘加运算的矩阵片段#
本节描述线程寄存器的内容如何与 A 矩阵的片段以及稀疏性元数据相关联。
warpgroup 中的每个 warp 提供矩阵 A 的 16 行的稀疏性信息。下表给出各 warp 到矩阵 A 各行的分配关系:
warp |
矩阵 A 各行的稀疏性信息 |
|---|---|
|
48-63 |
|
32-47 |
|
16-31 |
|
0-15 |
本节通篇使用以下约定:
对于矩阵 A,仅以寄存器向量大小及其与矩阵数据的关联关系来描述片段的布局。
对于矩阵 D,由于矩阵维度与数据类型的组合对所有支持的形状都相同,并且已在使用 wgmma.mma_async 指令的异步 Warpgroup 级矩阵乘加运算中涵盖,因此本节不再给出矩阵片段的图示表示。
对于元数据操作数,给出了矩阵 A 元素索引与元数据操作数内容之间关联关系的图示表示。出现在单元格
[x][y..z]中的Tk: [m..n]表示%laneid=k的线程的元数据操作数中第m位到第n位(m为较高位)包含矩阵 A 的[x][y]..[x][z]块中非零元素的索引。
9.7.17.6.2.1. 稀疏 wgmma.mma_async.m64nNk32 的矩阵片段#
执行稀疏 wgmma.mma_async.m64nNk32 的一个 warpgroup 将计算形状为 .m64nNk32 的 MMA 运算,其中 N 是矩阵形状中列出的一个合法 n 维度。
矩阵的元素分布在 warpgroup 中的各个线程上,因此 warpgroup 的每个线程都持有矩阵的一个片段。
来自共享内存的被乘数 A 记录在共享内存矩阵布局中。
-
来自寄存器的被乘数 A:
-
累加器 D:
累加器 D 的矩阵片段与wgmma.mma_async.m64nNk32 的矩阵片段中相同
.dtype格式的情况相同。 -
被乘数 B:
矩阵 B 的共享内存布局记录在共享内存矩阵布局中。
-
元数据操作数是一个
.b32寄存器,包含 16 个 2 位向量,每个向量存储矩阵 A 的某个 4 宽块中一个非零元素的索引。图 179 给出一个 warp 的元数据位到矩阵 A 各元素的映射。在该图中,变量
i表示稀疏性选择器操作数的值。
图 179 稀疏 WGMMA .m64nNk32 元数据布局(
.f16/.bf16类型)。
9.7.17.6.2.2. 稀疏 wgmma.mma_async.m64nNk16 的矩阵片段#
执行稀疏 wgmma.mma_async.m64nNk16 的一个 warpgroup 将计算形状为 .m64nNk16 的 MMA 运算,其中 N 是矩阵形状中列出的一个合法 n 维度。
矩阵的元素分布在 warpgroup 中的各个线程上,因此 warpgroup 的每个线程都持有矩阵的一个片段。
来自共享内存的被乘数 A 记录在共享内存矩阵布局中。
-
来自寄存器的被乘数 A:
-
累加器 D:
累加器 D 的矩阵片段与wgmma.mma_async.m64nNk8 的矩阵片段中相同
.dtype格式的情况相同。 -
被乘数 B:
矩阵 B 的共享内存布局记录在共享内存矩阵布局中。
-
元数据操作数是一个
.b32寄存器,包含 8 个 4 位向量,每个向量存储矩阵 A 的某个 2 宽块中一个非零元素的索引。图 181 给出一个 warp 的元数据位到矩阵 A 各元素的映射。在该图中,变量
i表示稀疏性选择器操作数的值。
图 181 稀疏 WGMMA .m64nNk16 元数据布局(
.tf32类型)。
9.7.17.6.2.3. 稀疏 wgmma.mma_async.m64nNk64 的矩阵片段#
执行稀疏 wgmma.mma_async.m64nNk64 的一个 warpgroup 将计算形状为 .m64nNk64 的 MMA 运算,其中 N 是矩阵形状中列出的一个合法 n 维度。
矩阵的元素分布在 warpgroup 中的各个线程上,因此 warpgroup 的每个线程都持有矩阵的一个片段。
来自共享内存的被乘数 A 记录在稀疏 wgmma.mma_async.m64nNk64 的矩阵片段中。
-
来自寄存器的被乘数 A:
.atype
矩阵片段
元素
.e4m3/.e5m2一个包含四个.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 8 个连续元素里的四个非零.e4m3/.e5m2元素。.s8/.u8一个包含四个.b32寄存器的向量表达式,其中每个寄存器包含矩阵 A 中 8 个连续元素里的四个非零.s8/.u8元素。不同线程所持有的片段布局如图 182所示。
图 182 稀疏 WGMMA .m64nNk64 矩阵片段布局(矩阵 A,
.e4m3/.e5m2/.s8/.u8类型)。 -
累加器 D:
累加器 D 的矩阵片段与wgmma.mma_async.m64nNk32 的矩阵片段中相同
.dtype格式的情况相同。 -
被乘数 B:
矩阵 B 的共享内存布局记录在稀疏 wgmma.mma_async.m64nNk64 的矩阵片段中。
-
元数据操作数是一个
.b32寄存器,包含 16 个 4 位向量,每个向量存储矩阵 A 的某个 4 宽块中两个非零元素的索引。图 183 给出元数据位到矩阵 A 第 0–31 列各元素的映射。
图 183 稀疏 WGMMA .m64nNk64 元数据布局(
.e4m3/.e5m2/.s8/.u8类型,第 0–31 列)图 184 给出元数据位到矩阵 A 第 32–63 列各元素的映射。
图 184 稀疏 WGMMA .m64nNk64 元数据布局(
.e4m3/.e5m2/.s8/.u8类型,第 32–63 列)
9.7.17.6.3. 异步乘加指令:wgmma.mma_async.sp#
wgmma.mma_async.sp
在 warpgroup 范围内使用稀疏矩阵 A 执行矩阵乘加运算
语法
半精度浮点类型:
wgmma.mma_async.sp.sync.aligned.shape.dtype.f16.f16 d, a-desc, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b, imm-trans-a, imm-trans-b;
wgmma.mma_async.sp.sync.aligned.shape.dtype.f16.f16 d, a, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b, imm-trans-b;
.shape = {.m64n8k32, .m64n16k32, .m64n24k32, .m64n32k32,
.m64n40k32, .m64n48k32, .m64n56k32, .m64n64k32,
.m64n72k32, .m64n80k32, .m64n88k32, .m64n96k32,
.m64n104k32, .m64n112k32, .m64n120k32, .m64n128k32,
.m64n136k32, .m64n144k32, .m64n152k32, .m64n160k32,
.m64n168k32, .m64n176k32, .m64n184k32, .m64n192k32,
.m64n200k32, .m64n208k32, .m64n216k32, .m64n224k32,
.m64n232k32, .m64n240k32, .m64n248k32, .m64n256k32};
.dtype = {.f16, .f32};
其他浮点类型:
.bf16 floating point type:
wgmma.mma_async.sp.sync.aligned.shape.dtype.bf16.bf16 d, a-desc, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b, imm-trans-a, imm-trans-b;
wgmma.mma_async.sp.sync.aligned.shape.dtype.bf16.bf16 d, a, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b, imm-trans-b;
.shape = {.m64n8k32, .m64n16k32, .m64n24k32, .m64n32k32,
.m64n40k32, .m64n48k32, .m64n56k32, .m64n64k32,
.m64n72k32, .m64n80k32, .m64n88k32, .m64n96k32,
.m64n104k32, .m64n112k32, .m64n120k32, .m64n128k32,
.m64n136k32, .m64n144k32, .m64n152k32, .m64n160k32,
.m64n168k32, .m64n176k32, .m64n184k32, .m64n192k32,
.m64n200k32, .m64n208k32, .m64n216k32, .m64n224k32,
.m64n232k32, .m64n240k32, .m64n248k32, .m64n256k32};
.dtype = {.f32};
.tf32 floating point type:
wgmma.mma_async.sp.sync.aligned.shape.dtype.tf32.tf32 d, a-desc, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b;
wgmma.mma_async.sp.sync.aligned.shape.dtype.tf32.tf32 d, a, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b;
.shape = {.m64n8k16, .m64n16k16, .m64n24k16, .m64n32k16,
.m64n40k16, .m64n48k16, .m64n56k16, .m64n64k16,
.m64n72k16, .m64n80k16, .m64n88k16, .m64n96k16,
.m64n104k16, .m64n112k16, .m64n120k16, .m64n128k16,
.m64n136k16, .m64n144k16, .m64n152k16, .m64n160k16,
.m64n168k16, .m64n176k16, .m64n184k16, .m64n192k16,
.m64n200k16, .m64n208k16, .m64n216k16, .m64n224k16,
.m64n232k16, .m64n240k16, .m64n248k16, .m64n256k16};
.dtype = {.f32};
FP8 floating point type
wgmma.mma_async.sp.sync.aligned.shape.dtype.atype.btype d, a-desc, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b;
wgmma.mma_async.sp.sync.aligned.shape.dtype.atype.btype d, a, b-desc, sp-meta, sp-sel, scale-d, imm-scale-a, imm-scale-b;
.shape = {.m64n8k64, .m64n16k64, .m64n24k64, .m64n32k64,
.m64n40k64, .m64n48k64, .m64n56k64, .m64n64k64,
.m64n72k64, .m64n80k64, .m64n88k64, .m64n96k64,
.m64n104k64, .m64n112k64, .m64n120k64, .m64n128k64,
.m64n136k64, .m64n144k64, .m64n152k64, .m64n160k64,
.m64n168k64, .m64n176k64, .m64n184k64, .m64n192k64,
.m64n200k64, .m64n208k64, .m64n216k64, .m64n224k64,
.m64n232k64, .m64n240k64, .m64n248k64, .m64n256k64};
.atype = {.e4m3, .e5m2};
.btype = {.e4m3, .e5m2};
.dtype = {.f16, .f32};
整数类型:
wgmma.mma_async.sp.sync.aligned.shape{.satfinite}.s32.atype.btype d, a-desc, b-desc, sp-meta, sp-sel, scale-d;
wgmma.mma_async.sp.sync.aligned.shape{.satfinite}.s32.atype.btype d, a, b-desc, sp-meta, sp-sel, scale-d;
.shape = {.m64n8k64, .m64n16k64, .m64n24k64, .m64n32k64,
.m64n48k64, .m64n64k64, .m64n80k64, .m64n96k64,
.m64n112k64, .m64n128k64, .m64n144k64, .m64n160k64,
.m64n176k64, .m64n192k64, .m64n208k64, .m64n224k64,
.m64n240k64, .m64n256k64};
.atype = {.s8, .u8};
.btype = {.s8, .u8};
说明
指令 wgmma.mma_async 发起一次 MxNxK 矩阵乘加运算 D = A*B+D,其中 A 矩阵为 MxK,B 矩阵为 KxN,D 矩阵为 MxN。
矩阵 A 以打包格式 Mx(K/2) 存储,如稀疏矩阵存储所述。
当输入谓词参数 scale-d 为 false 时,发起形式为 D = A*B 的运算。
必须使用 wgmma.fence 指令来对 wgmma.mma_async 指令的寄存器访问与其先前的访问进行栅栏隔离。否则,行为未定义。
在访问结果之前,必须使用 wgmma.commit_group 和 wgmma.wait_group 操作来等待异步矩阵乘加运算完成。
寄存器操作数 d 既表示累加器矩阵也表示目标矩阵,分布在参与运算的各线程之间。寄存器操作数 a 表示以寄存器形式存在的被乘数矩阵 A,分布在参与运算的各线程之间。64 位寄存器操作数 a-desc 和 b-desc 是矩阵描述符,分别表示共享内存中的被乘数矩阵 A 和 B。矩阵描述符的内容在 warpgroup 的所有 warp 中必须相同。矩阵描述符的格式如矩阵描述符格式所述。矩阵 A 按稀疏矩阵存储所述组织为结构化稀疏。操作数 sp-meta 和 sp-sel 分别表示稀疏性元数据和稀疏性选择器。操作数 sp-meta 是 32 位整数,操作数 sp-sel 是取值在 0..3 范围内的 32 位整数常量。
sp-meta 和 sp-sel 对每种形状的有效取值在稀疏矩阵存储中给出,此处汇总如下:
矩阵形状 |
|
|
|
|---|---|---|---|
|
|
0b1110 , 0b0100 |
0(线程 T0、T1)或 1(线程 T2、T3) |
|
|
0b00, 0b01, 0b10, 0b11 |
0(线程 T0、T1)或 1(线程 T2、T3) |
|
|
0b00, 0b01, 0b10, 0b11 |
0(所有线程都提供) |
矩阵 A 和 B 分别以行主序和列主序格式存储。对于某些浮点变体,可以通过分别为立即数整数参数 imm-trans-a 和 imm-trans-b 指定值 1 来对输入矩阵 A 和 B 进行转置。使用值 0 可避免转置操作。imm-trans-a 和 imm-trans-b 的有效取值为 0 和 1。转置操作仅对带 .f16/ .bf16 类型的 wgmma.mma_async 变体、且矩阵通过矩阵描述符从共享内存访问时才受支持。
对于 wgmma.mma_async 运算的浮点变体,可以通过分别为操作数 imm-scale-a 和 imm-scale-b 指定值 -1 来对输入矩阵 A 和 B 的每个元素取负。使用值 1 可避免取负操作。imm-scale-a 和 imm-scale-b 的有效取值为 -1 和 1。
限定符 .dtype、.atype 和 .btype 分别表示矩阵 D、A 和 B 中元素的数据类型。对于所有浮点 wgmma.mma_async 变体(FP8 浮点变体除外),.atype 和 .btype 必须相同。wgmma.mma_async 运算的其他浮点变体中,矩阵 A 和 B 各数据元素的大小如下:
当
.atype/.btype为.e4m3/.e5m2时,矩阵 A 和 B 的数据元素为 8 位。当
.atype/.btype为.bf16时,矩阵 A 和 B 的数据元素为 16 位。当
.atype/.btype为.tf32时,矩阵 A 和 B 的数据元素为 32 位。
精度与舍入:
-
浮点运算:
矩阵 A 与 B 的逐元素乘法至少以单精度执行。当
.dtype为.f32时,中间值的累加至少以单精度执行。当.dtype为.f16时,累加至少以半精度执行。累加顺序、舍入以及对次正规输入的处理是未指定的。
-
.bf16与.tf32浮点运算:矩阵 A 与 B 的逐元素乘法以指定的精度执行。涉及
.tf32类型的wgmma.mma_async运算会在发起乘法之前截断 32 位输入数据的低 13 位。中间值的累加至少以单精度执行。累加顺序、舍入以及对次正规输入的处理是未指定的。
-
整数运算:
整数
wgmma.mma_async运算使用.s32累加器执行。.satfinite限定符表示在溢出时,累加值被限制在 MIN_INT32.. MAX_INT32 范围内(其中这两个边界分别定义为最小负的有符号 32 位整数和最大正的有符号 32 位整数)。若未指定
.satfinite,则累加值改为回绕。
必需的 .sync 限定符表示 wgmma.mma_async 指令使执行线程等待,直到 warp 中的所有线程都执行同一条 wgmma.mma_async 指令后才继续执行。
必需的 .aligned 限定符表示 warpgroup 中的所有线程必须执行同一条 wgmma.mma_async 指令。在条件执行的代码中,只有在确知 warpgroup 中所有线程对该条件的求值结果相同时,才应使用 wgmma.mma_async 指令,否则行为未定义。
整数类型示例
wgmma.fence.sync.aligned;
wgmma.mma_async.sp.sync.aligned.m64n8k64.s32.u8.u8 {s32d0, s32d1, s32d2, s32d3},
descA, descB, spMeta, 0, scaleD;
wgmma.mma_async.sp.sync.aligned.m64n8k64.s32.s8.u8 {s32d0, s32d1, s32d2, s32d3},
descA, descB, spMeta, 0, scaleD;
wgmma.commit_group.sync.aligned;
wgmma.wait_group.sync.aligned 0;
9.7.17.7. 异步 wgmma 代理操作#
本节介绍 warpgroup 级别的 wgmma.fence、wgmma.commit_group 和 wgmma.wait_group 指令。
9.7.17.7.1. 异步乘加指令:wgmma.fence#
wgmma.fence
在 wgmma.mma_async 与其他操作之间强制施加寄存器访问的顺序。
语法
wgmma.fence.sync.aligned;
说明
wgmma.fence 指令在先前对任意 warpgroup 寄存器的访问与随后由 wgmma.mma_async 指令对同一批寄存器的访问之间建立顺序。只有累加器寄存器以及包含矩阵 A 的 fragment 的输入寄存器需要这种顺序。
wgmma.fence 指令必须由 warpgroup 的所有 warp 在以下位置发出:
在 warpgroup 中的第一个
wgmma.mma_async操作之前。在 warpgroup 中某个线程的寄存器访问与任何访问相同寄存器的
wgmma.mma_async指令之间(这些寄存器要么是累加器,要么是包含矩阵 A 的 fragment 的输入寄存器),除非这些是跨多条相同形状的wgmma.mma_async指令的累加器寄存器访问。在后一种情况下,默认提供顺序保证。
否则,行为未定义。
必须使用异步代理栅栏来在先前对共享内存矩阵的写入与随后在 wgmma.mma_async 指令中对同一批矩阵的读取之间建立顺序。
强制的 .sync 限定符表示 wgmma.fence 指令会使执行线程等待,直到 warp 中的所有线程都执行同一条 wgmma.fence 指令后才恢复执行。
强制的 .aligned 限定符表示 warpgroup 中的所有线程都必须执行同一条 wgmma.fence 指令。在条件执行的代码中,只有在已知 warpgroup 中的所有线程对该条件的求值结果相同时,才应使用 wgmma.fence 指令,否则行为未定义。
示例
// Example 1, first use example:
wgmma.fence.sync.aligned; // Establishes an ordering w.r.t. prior accesses to the registers s32d<0-3>
wgmma.mma_async.sync.aligned.m64n8k32.s32.u8.u8 {s32d0, s32d1, s32d2, s32d3},
descA, descB, scaleD;
wgmma.commit_group.sync.aligned;
wgmma.wait_group.sync.aligned 0;
// Example 2, use-case with the input value updated in between:
wgmma.fence.sync.aligned;
wgmma.mma_async.sync.aligned.m64n8k32.s32.u8.u8 {s32d0, s32d1, s32d2, s32d3},
descA, descB, scaleD;
…
mov.b32 s32d0, new_val;
wgmma.fence.sync.aligned;
wgmma.mma_async.sync.aligned.m64n8k32.s32.u8.u8 {s32d4, s32d5, s32d6, s32d7},
{s32d0, s32d1, s32d2, s32d3},
descB, scaleD;
wgmma.commit_group.sync.aligned;
wgmma.wait_group.sync.aligned 0;
9.7.17.7.2. 异步乘加指令:wgmma.commit_group#
wgmma.commit_group
把所有先前未提交的 wgmma.mma_async 操作提交到一个 wgmma-group 中。
语法
wgmma.commit_group.sync.aligned;
说明
wgmma.commit_group 指令为每个 warpgroup 创建一个新的 wgmma-group,并把由执行 warp 发起、但尚未提交到任何 wgmma-group 的所有先前 wgmma.mma_async 指令批量归入这个新的 wgmma-group。如果没有未提交的 wgmma.mma_async 指令,那么 wgmma.commit_group 会产生一个空的 wgmma-group。
执行线程可以通过使用 wgmma.wait_group 来等待某个 wgmma-group 中所有 wgmma.mma_async 操作完成。
强制的 .sync 限定符表示 wgmma.commit_group 指令会使执行线程等待,直到 warp 中的所有线程都执行同一条 wgmma.commit_group 指令后才恢复执行。
强制的 .aligned 限定符表示 warpgroup 中的所有线程都必须执行同一条 wgmma.commit_group 指令。在条件执行的代码中,只有在已知 warpgroup 中的所有线程对该条件的求值结果相同时,才应使用 wgmma.commit_group 指令,否则行为未定义。
示例
wgmma.commit_group.sync.aligned;
9.7.17.7.3. 异步乘加指令:wgmma.wait_group#
wgmma.wait_group
发出前一个 warpgroup 操作已完成的信号。
语法
wgmma.wait_group.sync.aligned N;
说明
wgmma.wait_group 指令会使执行线程等待,直到最近的 wgmma-group 中仅有 N 个或更少个仍处于待处理状态,并且由执行线程先前提交的所有 wgmma-group 都已完成。例如,当 N 为 0 时,执行线程会等待所有先前的 wgmma-group 完成。操作数 N 是一个整数常量。
如果没有先执行一条 wgmma.wait_group 指令来等待包含该 wgmma.mma_async 指令的 wgmma-group,就访问某条 wgmma.mma_async 指令的累加器寄存器或包含矩阵 A 的 fragment 的输入寄存器,属于未定义行为。
强制的 .sync 限定符表示 wgmma.wait_group 指令会使执行线程等待,直到 warp 中的所有线程都执行同一条 wgmma.wait_group 指令后才恢复执行。
强制的 .aligned 限定符表示 warpgroup 中的所有线程都必须执行同一条 wgmma.wait_group 指令。在条件执行的代码中,只有在已知 warpgroup 中的所有线程对该条件的求值结果相同时,才应使用 wgmma.wait_group 指令,否则行为未定义。
示例
wgmma.fence.sync.aligned;
wgmma.mma_async.sync.aligned.m64n8k32.s32.u8.u8 {s32d0, s32d1, s32d2, s32d3},
descA, descB, scaleD;
wgmma.commit_group.sync.aligned;
wgmma.mma_async.sync.aligned.m64n8k16.f32.f16.f16 {f32d0, f32d1, f32d2, f32d3},
{f16a0, f16a1, f16a2, f16a3},
descB, 1, -1, -1, 1;
wgmma.commit_group.sync.aligned;
wgmma.wait_group.sync.aligned 0;
9.7.18. TensorCore 第五代指令族#
9.7.18.1. Tensor Memory#
第五代 TensorCore 配有专供 TensorCore 运算使用的片上存储器。该 Tensor Memory 按二维矩阵组织:横向的行称为 lane,纵向的列称为 column。
在 sm_100a/sm_100f 架构上,第五代 TensorCore 的 Tensor Memory 具有每 CTA 512 列、128 行的二维结构,每个单元大小为 32 位。
通过加载与存储操作访问 Tensor Memory 时的线程限制,见 访问限制 一节。
9.7.18.1.1. Tensor Memory 寻址#
Tensor Memory 地址宽 32 位,由两个分量组成。
Lane 索引
Column 索引
布局如下:
31 16
15 0
Lane 索引
Column 索引
图 185 展示了 CTA 内 Tensor Memory 布局的视图。
图 185 Tensor Memory 布局与寻址
9.7.18.1.2. Tensor Memory 分配#
Tensor Memory 采用动态分配。必须由 CTA 中的单个 warp 使用 Tensor Memory 分配与管理指令 进行分配。
Tensor Memory 的分配与释放以列为单位进行。分配单位是 32 列,且所分配的列数必须是 2 的幂。分配一列时,该列的全部 128 个 lane 都会被分配。
kernel 中分配的所有 Tensor Memory 都必须在 kernel 退出前显式释放。
9.7.18.2. 矩阵与数据移动形状#
涉及两类形状。
数据移动操作中的形状
MMA 操作中的形状
9.7.18.2.1. 矩阵形状#
矩阵乘加运算对操作数矩阵 A、B 和 D 仅支持一组有限的形状。三个矩阵操作数的形状统一由元组 MxNxK 描述,其中 A 是 MxK 矩阵,B 是 KxN 矩阵,D 是 MxN 矩阵。
表 48 给出了 tcgen05.mma 运算针对指定类型所支持的矩阵形状。
各种组合 |
支持的形状 |
|||||||
|---|---|---|---|---|---|---|---|---|
.kind::* |
是否有 .ws |
CTA 组 |
稀疏性 |
dtype |
atype/btype |
|||
|
无 |
1 |
稠密 |
|
|
64xNxK 128xNxK |
N = {8, 16, 24, … 256},步长为 8 |
K = 16 |
|
|
|||||||
稀疏 |
|
|
K = 32 |
|||||
|
|
|||||||
2 |
稠密 |
|
|
128xNxK 256xNxK |
N = {16, 32, … 256},步长为 16 |
K = 16 |
||
|
|
|||||||
稀疏 |
|
|
K = 32 |
|||||
|
|
|||||||
|
1 |
稠密 |
|
|
32xNxK 64xNxK 128xNxK |
N = {64, 128, 256} |
K = 16 |
|
|
|
|||||||
稀疏 |
|
|
N = {64, 128} |
K = 32 |
||||
|
|
|||||||
2 |
任意 |
|
|
无效 |
||||
|
|
|||||||
|
无 |
1 |
稠密 |
|
|
64xNxK 128xNxK |
N = {8, 16, 24, … 256},步长为 8 |
K = 8 |
稀疏 |
K = 16 |
|||||||
2 |
稠密 |
128xNxK 256xNxK |
N = {16, 32, … 256},步长为 16 |
K = 8 |
||||
稀疏 |
K = 16 |
|||||||
|
1 |
稠密 |
32xNxK 64xNxK 128xNxK |
N = {64, 128, 256} |
K = 8 |
|||
稀疏 |
N = {64, 128} |
K = 16 |
||||||
2 |
稠密 |
无效 |
||||||
稀疏 |
||||||||
|
无 |
1 |
稠密 |
|
|
64xNxK 128xNxK 128xNxK1 |
N = {8, 16, … 256},步长为 8 或 N = {16, 32, … 256},步长为 16 |
K = 32 K1 = 64 |
稀疏 |
K = 64 / 128 |
|||||||
2 |
稠密 |
128xNxK 256xNxK 256xNxK1 |
N = {16, 32, … 256},步长为 16 |
K = 32 K1 = 64 |
||||
稀疏 |
K = 64 / 128 |
|||||||
|
1 |
稠密 |
32xNxK 64xNxK 128xNxK |
N = {64, 128, 256} |
K = 32 / 64 |
|||
稀疏 |
N = {64, 128} |
K = 64 / 128 |
||||||
2 |
稠密 |
无效 |
||||||
稀疏 |
||||||||
|
无 |
1 |
稠密 |
|
X (Scale)
|
128xNxK |
N = {8, 16, … 256},步长为 8 |
K = 32 / 64 |
稀疏 |
K = 64 / 128 |
|||||||
2 |
稠密 |
128xNxK 256xNxK 256xNxK1 |
N = {16, 32, … 256},步长为 16 |
K = 32, K1 = 64 |
||||
稀疏 |
256xNxK |
K = 64 / 128 |
||||||
|
1 |
稠密 |
无效 |
|||||
稀疏 |
||||||||
2 |
稠密 |
|||||||
稀疏 |
||||||||
|
无 |
1 |
稠密 |
|
|
64xNxK 128xNxK |
N = {8, 16, 24, 32, 48, … 256} N > 32 后步长为 16 |
K = 32 |
稀疏 |
K = 64 |
|||||||
2 |
稠密 |
128xNxK 256xNxK |
N = {32, 64, … 256},步长为 32 |
K = 32 |
||||
稀疏 |
K = 64 |
|||||||
|
1 |
稠密 |
32xNxK 64xNxK 128xNxK |
N = {64, 128, 256} |
K = 32 |
|||
稀疏 |
N = {64, 128} |
K = 64 |
||||||
2 |
稠密 |
无效 |
||||||
稀疏 |
||||||||
|
无 |
1 |
稠密 |
|
X (Scale)
|
128xNxK |
N = {8, 16, … 256},步长为 8 |
K = 64 / 96 |
稀疏 |
K = 128 / 192 |
|||||||
2 |
稠密 |
128xNxK 256xNxK 256xNxK1 |
N = {16, 32, … 256},步长为 16 |
K = 64, K1 = 96 / 128 |
||||
稀疏 |
256xNxK |
K = 128 / 192 |
||||||
|
1 / 2 |
任意 |
无效 |
|||||
|
无 |
1 |
稠密 |
|
X (Scale)
|
128xNxK |
N = {8, 16, … 256},步长为 8 |
K = 64 / 96 |
稀疏 |
K = 128 / 192 |
|||||||
2 |
稠密 |
128xNxK 256xNxK 256xNxK1 |
N = {16, 32, … 256},步长为 16 |
K = 64, K1 = 96 / 128 |
||||
稀疏 |
256xNxK |
K = 128 / 192 |
||||||
|
1 / 2 |
任意 |
无效 |
|||||
|
无 |
1 |
稠密 |
|
|
64xN1 xK 128xN2 xK |
N1 = {8, 16, 24, … 256},步长为 8;N2 = {16, 32, … 256},步长为 16 |
K = 16 |
稀疏 |
K = 32 |
|||||||
2 |
稠密 |
128xNxK 256xNxK |
N = {32, 64, … 256},步长为 32 |
K = 16 |
||||
稀疏 |
K = 32 |
|||||||
|
1 |
稠密 |
32xNxK 64xNxK 128xNxK |
N = {64, 128, 256} |
K = 16 |
|||
稀疏 |
N = {64, 128} |
K = 32 |
||||||
2 |
稠密 |
无效 |
||||||
稀疏 |
||||||||
9.7.18.2.1.1. 目标 ISA 说明#
-
K = 96 仅在以下架构特定目标上受支持:
sm_103a.sm_107a
-
对于稠密矩阵 K = 64、稀疏矩阵 K = 128,配合
.kind::f8f6f4/.kind::mxf8f6f4时,在以下家族特定架构上受支持:sm_107f或同一家族中的更高架构
-
对于稠密矩阵 K = 128、稀疏矩阵 K = 192,配合
.kind::mxf4/.kind::mxf4nvf4时,在以下家族特定架构上受支持:sm_107f或同一家族中的更高架构
9.7.18.2.2. 指定矩阵形状#
M 和 N 可以在指令描述符中指定。
如果给定 MMA 变体支持多个 K 值,则 K 可以被显式指定。否则,如果 K 能按照表 48唯一确定,那么与 K 对应的指令描述符位必须置为 0。
9.7.18.2.3. 数据搬运形状#
数据搬运形状表示要被搬运到 Tensor Memory 或从其中搬运出的数据的维度。这些形状被描述为一个元组 lane x size,其中:
lane表示 Tensor Memory 中的行数;以及size表示跨越 Tensor Memory 各列的数据量,单位为比特(b)。
各种 tcgen05 操作支持以下形状:
形状 |
tcgen05.<op> |
|---|---|
|
|
|
|
|
|
9.7.18.2.3.1. 内存布局#
下面展示了矩阵片段在 warp 各线程之间的布局。
9.7.18.2.3.1.1. 形状 .32x32b 的矩阵片段#
tcgen05{.ld,.st}.32x32b 指令具有以下数据向量寄存器。
片段 |
元素(从低到高) |
|---|---|
一个包含 |
r0, r1, … |
执行 tcgen05{.ld,.st}.32x32b 的 warp 将访问 Tensor Memory 的 32 个 lane。它向每个 lane 加载或从每个 lane 存储 (32 * .num) 比特的数据,如图 186所示。
图 186 形状 .32x32b 的矩阵片段
9.7.18.2.3.1.2. 形状 .16x64b 的矩阵片段#
tcgen05{.ld,.st}.16x64b 指令具有以下数据向量寄存器。
片段 |
元素(从低到高) |
|---|---|
一个包含 |
r0, r1, … |
执行 tcgen05{.ld,.st}.16x64b 的 warp 将访问 Tensor Memory 的 16 个 lane。它向每个 lane 加载或从每个 lane 存储 (64 * .num) 比特的数据,如图 187所示。
图 187 形状 .16x64b 的矩阵片段
9.7.18.2.3.1.3. 形状 .16x128b 的矩阵片段#
tcgen05{.ld,.st}.16x128b 指令具有以下数据向量寄存器。
片段 |
元素(从低到高) |
|---|---|
一个包含 |
r0, r1, … |
执行 tcgen05{.ld,.st}.16x128b 的 warp 将访问 Tensor Memory 的 16 个 lane。它向每个 lane 加载或从每个 lane 存储 (128 * .num) 比特的数据,如图 188所示。
图 188 形状 .16x128b 的矩阵片段
9.7.18.2.3.1.4. 形状 .16x256b 的矩阵片段#
tcgen05{.ld,.st}.16x256b 指令具有以下数据向量寄存器。
片段 |
元素(从低到高) |
|---|---|
一个包含 |
r0, r1, r2, r3, … |
执行 tcgen05{.ld,.st}.16x256b 的 warp 将访问 Tensor Memory 的 16 个 lane。它向每个 lane 加载或从每个 lane 存储 (256 * .num) 比特的数据,如图 189所示。
图 189 形状 .16x256b 的矩阵片段
9.7.18.2.3.1.5. 形状 .16x32bx2 的矩阵片段#
tcgen05{.ld,.st}.16x32bx2 指令具有以下数据向量寄存器。
片段 |
元素(从低到高) |
|---|---|
一个包含 |
r0, r1, … |
执行 tcgen05{.ld,.st}.16x32bx2 的 warp 将访问 Tensor Memory 的 16 个 lane。它向每个 lane 加载或从每个 lane 存储 (32 * .num) 比特的数据,如图 190所示。
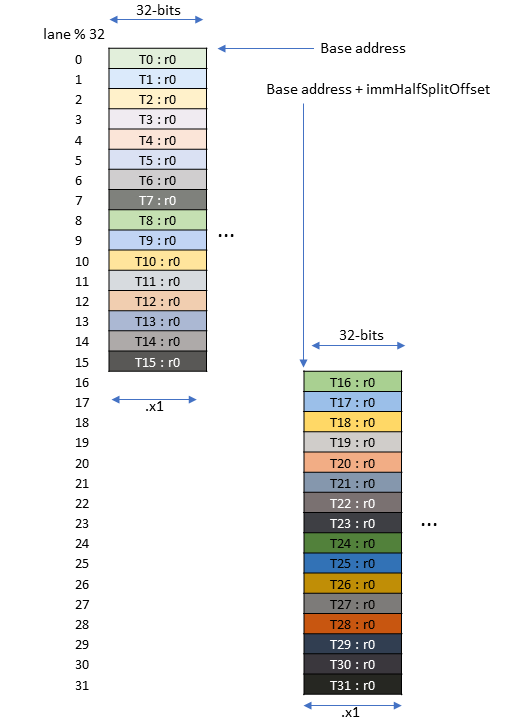
图 190 形状 .16x32bx2 的矩阵片段
9.7.18.3. Strides 所支持的 Major-ness#
从共享内存访问矩阵时涉及两个 stride:
Leading dimension stride(字节偏移或绝对地址)
Stride dimension 字节偏移
9.7.18.3.1. Leading Dimension Stride:相对偏移或绝对地址#
Leading Dimension Stride 有两种模式,如下所述。共享内存描述符 中的第 52 位用于区分这两种模式。
9.7.18.3.1.1. 相对偏移模式#
在此模式下,leading dimension stride 被指定为列之间的相对字节偏移,如下表所述。leading dimension stride 既可以被指定为列之间的相对偏移,也可以被指定为下一个缓冲区的绝对字节地址。对于转置矩阵和非转置矩阵,leading dimension stride 的定义不同。对于元素类型被归一化为 128 位的矩阵,leading dimension stride 的定义如下:
Major-ness |
定义 |
|---|---|
K-Major |
|
MN-Major |
|
9.7.18.3.1.2. K 维度为 48B 时的绝对地址模式#
如果数据连续打包,K-dimension 为 48B 的 tcgen05.mma 指令将溢出 128B 共享内存边界。
在这种情况下,可以使用绝对地址模式将共享内存中的数据拆分为两个块,使得这两个块都布局在对齐的 128 字节地址边界内。leading dimension 绝对地址可以指向共享内存中的第二个数据块。
9.7.18.3.1.2.1. 对 Leading Dimension 绝对地址 Stride 的限制#
以下是绝对地址 stride 模式的限制:
仅支持 128B swizzle(具有 16B 原子性)。
仅支持 K-Major 模式。也就是说,指令描述符 中的转置位(第 15 位和第 16 位)必须为 0。
矩阵基址偏移必须为 0。
9.7.18.3.2. Stride Dimension 字节偏移#
对于转置矩阵和非转置矩阵,stride dimension 字节偏移的定义不同。对于元素类型被归一化为 128 位的矩阵,stride dimension 字节偏移的定义如下:
Major-ness |
定义 |
|---|---|
K-Major |
从第一个 8 行到接下来 8 行的偏移。 |
MN-Major |
|
9.7.18.3.3. 规范布局#
就 CuTe 布局 而言,规范布局可以表示如下:
Major-ness |
Swizzling 模式 |
无 swizzling 的规范布局 |
Swizzling 应用于前一列 |
|---|---|---|---|
MN-major |
No-swizzling 或 Interleaved |
((T,1,m),(8,k)):((1,T,SBO),(1T,LBO)) |
Swizzle<0, 4, 3> |
32B Swizzling |
((T,2,m),(8,k)):((1,T,LBO),(2T,SBO)) |
Swizzle<1, 4, 3> |
|
64B Swizzling |
((T,4,m),(8,k)):((1,T,LBO),(4T,SBO)) |
Swizzle<2, 4, 3> |
|
128B Swizzling |
((T,8,m),(8,k)):((1,T,LBO),(8T,SBO)) |
Swizzle<3, 4, 3> |
|
K-major |
No-swizzling 或 Interleaved |
((8,m),(T,2k)):((1T,SBO),(1,LBO)) |
Swizzle<0, 4, 3> |
32B Swizzling |
((8,m),(T,2k)):((2T,SBO),(1,T)) |
Swizzle<1, 4, 3> |
|
64B Swizzling |
((8,m),(T,2k)):((4T,SBO),(1,T)) |
Swizzle<2, 4, 3> |
|
128B Swizzling |
((8,m),(T,2k)):((8T,SBO),(1,T)) |
Swizzle<3, 4, 3> |
其中
T = 128 / sizeof-elements-in-bits,T 表示将矩阵元素类型归一化为 128 位的缩放因子。
m 表示跨行重复模式的数量。
k 表示跨列重复模式的数量。
示例
-
K-Major、no-swizzling 和 tf32 类型:图 191
图 191 K major、no-swizzling 和 tf32 类型
stride 及相关细节如下:
精确布局:Swizzle<0,4,3> o ((8,2),(4,4)):((4,32),(1,64))
规范布局:Swizzle<0,4,3> o ((8,m),(T,2k)):((1T,SBO),(1,LBO))
参数
值
T
4
m
2
k
2
LBO(相对偏移)
64*sizeof(tf32)
SBO
32*sizeof(tf32)
描述符中 LBO 的编码
(LBO) >> 4 = 16
描述符中 SBO 的编码
(SBO) >> 4 = 8
-
K-Major、32B swizzling 和 tf32 类型:图 192
图 192 K major、32B swizzling 和 tf32 类型
stride 及相关细节如下:
精确布局:Swizzle<1,4,3> o ((8,2),(4,2)):((8,64),(1,4))
规范布局:Swizzle<1,4,3> o ((8,m),(T,2k)):((2T,SBO),(1,T))
参数
值
T
4
m
2
k
1
LBO(相对偏移)
NA
SBO
64*sizeof(tf32)
描述符中 LBO 的编码
1(假定)
描述符中 SBO 的编码
(SBO) >> 4 = 16
-
MN-Major、no-swizzling 和 bf16 类型:图 193
图 193 MN major、no-swizzling 和 bf16 类型
stride 及相关细节如下:
精确布局:Swizzle<0,4,3> o ((8,1,2),(8,2)):((1,8,64),(8,128))
规范布局:Swizzle<0,4,3> o ((T,1,m),(8,k)):((1,T,SBO),(1T,LBO))
参数
值
T
8
m
2
k
2
LBO(相对偏移)
128*sizeof(bf16)
SBO
64*sizeof(bf16)
描述符中 LBO 的编码
(LBO) >> 4 = 16
描述符中 SBO 的编码
(SBO) >> 4 = 8
-
MN-Major、32B swizzling 和 bf16 类型:图 194
图 194 MN major、32B swizzling 和 bf16 类型
stride 及相关细节如下:
精确布局:Swizzle<1,4,3> o ((8,2,2),(8,2)):((1,8,128),(16,256))
规范布局:Swizzle<1,4,3> o ((T,2,m),(8,k)):((1,T,LBO),(2T,SBO))
参数
值
T
8
m
2
k
2
LBO(相对偏移)
128*sizeof(bf16)
SBO
256*sizeof(bf16)
描述符中 LBO 的编码
(LBO) >> 4 = 16
描述符中 SBO 的编码
(SBO) >> 4 = 32
-
MN-Major、64B swizzling 和 bf16 类型:图 195
图 195 MN major、64B swizzling 和 bf16 类型
stride 及相关细节如下:
精确布局:Swizzle<2,4,3> o ((8,4,2),(8,2)):((1,8,256),(32,512))
规范布局:Swizzle<2,4,3> o ((T,4,m),(8,k)):((1,T,LBO),(4T,SBO))
参数
值
T
8
m
2
k
2
LBO(相对偏移)
256*sizeof(bf16)
SBO
512*sizeof(bf16)
描述符中 LBO 的编码
(LBO) >> 4 = 32
描述符中 SBO 的编码
(SBO) >> 4 = 64
9.7.18.4. 矩阵描述符#
tcgen05 系列指令使用三种矩阵描述符。
9.7.18.4.1. 共享内存描述符#
共享内存描述符描述共享内存中被乘数矩阵的属性,包括其在当前 CTA 共享内存中的位置。它是包含在寄存器中的一个 64 位值,布局如下:
位域 |
位数 |
说明 |
|---|---|---|
0-14 |
15 |
matrix-descriptor-encode (矩阵起始地址) |
15 |
1 |
保留 - 必须为 0 |
16-30 |
15 |
matrix-descriptor-encode (相对的前导维度字节偏移) 或 matrix-descriptor-encode (绝对的前导维度字节地址) |
31 |
1 |
保留 - 必须为 0 |
32-45 |
14 |
matrix-descriptor-encode (步幅维度字节偏移) |
46-48 |
3 |
固定常量值 0b001 |
49-51 |
3 |
矩阵基偏移 |
52 |
1 |
前导维度步幅模式: - 0:字节偏移(相对) - 1:字节地址(绝对) |
53 |
1 |
lut::b 矩阵 B 的 K_Segment 起始偏移(位于 K=128(48B)块中) - 0:0 - 1:24 |
54-60 |
7 |
固定常量值 0xb00000000 |
61-63 |
3 |
指定要使用的 swizzling 模式: 0. 无 swizzling 1. 128 字节且带 32B 原子 swizzling 2. 128 字节 swizzling 4. 64 字节 swizzling 6. 32 字节 swizzling 注:取值 3、5 和 7 无效 |
其中 matrix-descriptor-encode(x) = (x & 0x3FFFF) >> 4
当指定的 swizzling 模式的重复模式按 表 50 所示开始时,基偏移的值为 0。
当使用 decompress::lut::b 限定符时,tcgen05.mma 指令从共享内存读取 B 矩阵的 48 字节并存入收集器缓冲区。tcgen05.mma 指令只需要 24 字节(3 * 64 / 8)。根据共享内存描述符中第 53 位的值,将使用第一个或第二个 24 字节块。
Swizzling 模式 |
重复模式的起始地址 |
|---|---|
128 字节 swizzle |
1024 字节边界 |
64 字节 swizzle |
512 字节边界 |
32 字节 swizzle |
256 字节边界 |
否则,基偏移必须为非零值,使用以下公式计算:base offset = (pattern start addr >> 0x7) & 0x7
以下内容必须 16 字节对齐:
矩阵起始地址
前导维度字节偏移
步幅维度字节偏移
9.7.18.4.1.1. 目标 ISA 说明#
前导维度步幅的字节地址模式在
sm_103a上受支持。
9.7.18.4.2. 指令描述符#
指令描述符描述所有矩阵以及矩阵乘累加运算的形状、类型和其他细节。它是寄存器中的一个 32 位值,其确切布局取决于 MMA-Kind:
位 |
大小 (位) |
说明 |
取值 |
||||
|---|---|---|---|---|---|---|---|
.kind::tf32 |
.kind::f16 |
.kind::f8f6f4 |
.kind::i8 |
.kind::ti16 |
|||
0-1 |
2 |
稀疏性选择器,如果启用了稀疏性 |
0-3 |
||||
2 |
1 |
稀疏性 |
稠密 = 0 稀疏 = 1 |
||||
3 |
1 |
整数类型的饱和 |
0(不适用) |
无饱和 = 0 饱和 = 1 |
0(不适用) |
||
4-5 |
2 |
dtype(矩阵 D 类型) |
F32 = 1 |
F16 = 0 F32 = 1 |
S32 = 2 |
S32 = 2 |
|
6 |
1 |
保留 - 必须为 0 |
0 |
||||
7-9 |
3 |
atype(矩阵 A 类型) |
TF32 = 2 |
F16 = 0 BF16 = 1 |
E4M3 = 0 E5M2 = 1 E2M3 = 3 E3M2 = 4 E2M1 = 5 |
无符号 8b = 0 有符号 8b = 1 |
S1Z4M11 = 3 |
10-12 |
3 |
btype(矩阵 B 类型) |
|||||
13 |
1 |
取反矩阵 A |
不取反 = 0 取反 = 1 |
不取反 = 0 |
不取反 = 0 取反 = 1 |
||
14 |
1 |
取反矩阵 B |
|||||
15 |
1 |
转置矩阵 A |
不转置 = 0 转置 = 1 |
不转置 = 0 |
|||
16 |
1 |
转置矩阵 B |
|||||
17-22 |
6 |
N,矩阵 B 的维度 (不含最低 3 位) |
N >> 3 |
||||
23 |
1 |
保留 - 必须为 0 |
0 |
||||
24-28 |
5 |
M,矩阵 A 的维度 (不含最低 4 位) |
M >> 4 |
||||
29 |
1 |
K 维度 |
(Dense K=8 / Sparse K=16) = 0 |
(Dense K= 16 / Sparse K=32) = 0 |
(Dense K=32 / Sparse K=64) = 0 (Dense K=64) = 1 |
NA |
|
30-31 |
2 |
在 |
无移位 = 0 最大移位 8 = 1 最大移位 16 = 2 最大移位 32 = 3 |
||||
对于 .kind::ti16 限定符,atype 和 btype 的类型为 .s1z4m11,它是一个 16 位有符号整数,范围为 [-211 + 1, 211 - 1]。
位 |
大小 (位) |
说明 |
取值 |
|---|---|---|---|
.kind::mxf8f6f4 |
|||
0-1 |
2 |
保留 - 必须为 0 |
0 |
2 |
1 |
稀疏性 |
稠密 = 0 稀疏 = 1 |
3 |
1 |
保留 - 必须为 0 |
0 |
4-5 |
2 |
0-3 |
|
6 |
1 |
保留 - 必须为 0 |
0 |
7-9 |
3 |
atype(矩阵 A 类型) |
E4M3 = 0 E5M2 = 1 E2M3 = 3 E3M2 = 4 E2M1 = 5 |
10-12 |
3 |
btype(矩阵 B 类型) |
|
13 |
1 |
取反矩阵 A |
不取反 = 0 取反 = 1 |
14 |
1 |
取反矩阵 B |
|
15 |
1 |
转置矩阵 A |
不转置 = 0 转置 = 1 |
16 |
1 |
转置矩阵 B |
|
17-22 |
6 |
N,矩阵 B 的维度 (不含最低 3 位) |
N >> 3 |
23 |
1 |
缩放矩阵类型,用于 scale_A / scale_B |
UE8M0 = 1 |
24-25 |
2 |
保留 - 必须为 0 |
0 |
26 |
1 |
矩阵 A 缩放因子布局 |
32 Lane = 0 128 Lane = 1 |
27-28 |
2 |
M,矩阵 A 的维度 (不含最低 7 位) |
M >> 7 |
29-30 |
2 |
0-3 |
|
31 |
1 |
K 维度 |
(Dense K=32 / Sparse K=64) = 0 (Dense K=64 / Sparse K=128) = 1 |
位 |
大小 (位) |
说明 |
取值 |
|
|---|---|---|---|---|
.kind::mxf4 |
.kind::mxf4nvf4 |
|||
0-1 |
2 |
保留 - 必须为 0 |
0 |
|
2 |
1 |
稀疏性 |
稠密 = 0 稀疏 = 1 |
|
3 |
1 |
K 维度 |
K 维度的高位。参见第 31 位的说明。 |
|
4-5 |
2 |
0 或 2 |
||
6 |
1 |
保留 - 必须为 0 |
0 |
|
7-9 |
3 |
atype(矩阵 A 类型) |
E2M1 = 1 |
|
10-11 |
2 |
btype(矩阵 B 类型) |
||
12 |
1 |
稀疏性版本 |
|
|
13 |
1 |
取反矩阵 A |
不取反 = 0 取反 = 1 |
|
14 |
1 |
取反矩阵 B |
||
15 |
1 |
转置矩阵 A |
不转置 = 0 |
|
16 |
1 |
转置矩阵 B |
||
17-22 |
6 |
N,矩阵 B 的维度 (不含最低 3 位) |
N >> 3 |
|
23-24 |
2 |
缩放矩阵类型,用于 scale_A / scale_B |
UE8M0 = 1 |
UE4M3 = 0 UE8M0 = 1 UE5M3 = 2 |
25 |
1 |
保留 - 必须为 0 |
0 |
|
26 |
1 |
矩阵 A 缩放因子布局 |
32 Lane = 0 128 Lane = 1 |
|
27-28 |
2 |
M,矩阵 A 的维度 (不含最低 7 位) |
M >> 7 |
|
29-30 |
2 |
0 或 2 |
||
31 |
1 |
K 维度 |
(Dense K=64 / Sparse K=128) = 0 (Dense K=96 / Sparse K=192) = 1 (Dense K=128) = 2 要将 K 维度编码为 2 位字段,需使用第 3 位作为高位,而第 31 位作为低位 |
|
9.7.18.4.2.1. 目标 ISA 说明#
-
对于
.kind::f16、.kind::tf32、.kind:f8f6f4:K 维度的第 29 位对于架构
sm_107f或同一家族中更高架构有效。
-
对于
.kind::mxf8f6f4:矩阵 A 缩放因子布局的第 26 位对于
sm_107f或同一家族中更高架构有效。K 维度的第 31 位对于架构
sm_107f或同一家族中更高架构有效。
-
对于
.kind::mxf4、.kind::mxf4nvf4:K 维度的第 3 位对于架构
sm_107f或同一家族中更高架构有效。稀疏性版本的第 12 位对于架构
sm_100a、sm_103a、sm_110a必须映射为v0,对于架构sm_107a必须映射为v1,否则行为未定义。矩阵 A 缩放因子布局的第 26 位对于
sm_107f或同一家族中更高架构有效。
9.7.18.4.3. 零列掩码描述符#
零列掩码描述符用于生成一个掩码,该掩码指定 B 矩阵的哪些列在 MMA 操作中将具有零值,而无论共享内存中存在的值为何。所生成掩码的总大小为 N 位。
掩码中的 0 位指定矩阵 B 中对应列的值应被用于 MMA 操作。掩码中的 1 位指定该列整体在 MMA 操作中必须使用 0。
零列掩码描述符是寄存器中的一个 64 位值,具有以下布局:
位 |
大小(位) |
字段名称 |
说明 |
|---|---|---|---|
0-7 |
8 |
起始计数 0 (sc0) |
指定必须跳过的 LSB (针对子掩码 mask-i) |
8-15 |
8 |
起始计数 1 (sc1) |
|
16-23 |
8 |
起始计数 2 (sc2) |
|
24-31 |
8 |
起始计数 3 (sc3) |
|
32 |
1 |
首个跨度 0 (fs0) |
指定子掩码 mask-i 的 起始值 |
33 |
1 |
首个跨度 1 (fs1) |
|
34 |
1 |
首个跨度 2 (fs2) |
|
35 |
1 |
首个跨度 3 (fs3) |
|
36-38 |
3 |
保留 - 必须为 0 |
|
39 |
1 |
非零掩码 |
值 0 表示生成的掩码将全为 0 值 1 表示必须生成该掩码 |
40-47 |
8 |
跳过的跨度 |
(使用 B 矩阵的连续列数)- 1 |
48-55 |
8 |
使用的跨度 |
(使用 0 的连续列数)- 1 |
56-61 |
6 |
列偏移 |
按指定量偏移列。因而允许在非 0 起始列上进行 MMA。对于 M=32,最大偏移量 = 16 否则最大偏移量 = 32 |
零列掩码由一个或多个子掩码组成,具体取决于 M,如下表所示:
M |
零列掩码拆分 |
子掩码 |
使用的首个跨度 |
使用的起始列 |
|---|---|---|---|---|
128 |
单个大小为 N 位的子掩码 |
mask0 |
fs0 |
sc0 |
64 |
两个子掩码,每个大小为 N/2 位 |
mask0, mask1 |
fs0, fs1 |
sc0, sc1 |
32 |
四个子掩码,每个大小为 N/4 位 |
mask0, mask1 mask2, mask3 |
fs0, fs1, fs2, fs3 |
sc0, sc1, sc2, sc3 |
下表展示了子掩码在 N 维度上的覆盖范围:
子掩码 |
M |
||
|---|---|---|---|
128 |
64 |
32 |
|
mask0 |
列 [0, N-1] |
列 [0, N/2-1] |
列 [0, N/4-1] |
mask1 |
– |
列 [N/2, N-1] |
列 [N/4, N/2-1] |
mask2 |
– |
– |
列 [N/2, (N/4*3)-1] |
mask3 |
– |
– |
列 [(N/4*3), N-1] |
以下示例展示了零列掩码描述符及其生成的对应掩码:
-
示例 1:M = 128
输入的零列掩码描述符:
起始计数
首个跨度
非零掩码
跳过的跨度
使用的跨度
偏移
{0, 0, 0, 0}
{0, 0, 0, 0}
0
4
3
0
输出的零列掩码:0x0。
由于非零掩码字段为 0,掩码为 0x0。矩阵
B的所有列都将用于 MMA 操作。 -
示例 2:M = 128
输入的零列掩码描述符:
起始计数
首个跨度
非零掩码
跳过的跨度
使用的跨度
偏移
{-, -, -, 0}
{-, -, -, 0}
1
2
3
0
输出 mask0:0b … 111 0000 111 0000(大小 = N)
-
示例 3:M = 64
输入的零列掩码描述符:
起始计数 {.., sc1, sc0}
首个跨度 {.., fs1, fs0}
非零掩码
跳过的跨度
使用的跨度
偏移
{-, -, 0, 0}
{-, -, 0, 1}
1
2
3
0
输出 mask0:0b … 111 0000 111 0000 111
输出 masl1:0b … 0000 111 0000 111 0000
-
示例 4:M = 32
输入的零列掩码描述符:
起始计数 {sc3, sc2, sc1, sc0}
首个跨度 {fs3, fs2, fs1, fs0}
非零掩码
跳过的跨度
使用的跨度
偏移
{1, 2, 1, 0}
{0, 0, 1, 1}
1
2
3
2
输出 mask0:0b … 0000 111 0000 111
输出 mask1:0b … 0000 111 0000 11
输出 mask2:0b … 111 0000 111 00
输出 mask3:0b … 111 0000 111 000
如果 N = 128,则由于偏移为 2,将使用列 2 到 129 的
B矩阵进行 MMA 操作。
9.7.18.5. 发出粒度#
每个 tcgen05 操作对需要发出它们的线程/warp 数量有不同的要求。
下表列出了每个 tcgen05 操作的执行粒度要求:
tcgen05 操作 |
.cta_group |
发出粒度 |
|---|---|---|
.mma,
.cp,
.shift,
.commit
|
::1 |
由当前 CTA 中的单个线程发出即可启动该基础操作。 |
::2 |
由 CTA 对中的单个线程发出即可启动该基础操作。当当前 CTA 发出该操作时,对等 CTA 应处于活动状态且不应已退出。 |
|
.alloc,
.dealloc,
.relinquish_alloc_permit
|
::1 |
由当前 CTA 中的单个 warp 发出即可启动该分配管理指令。 |
::2 |
由两个 warp(当前 CTA 及其 对等 CTA 中各一个)发出,以共同执行该操作,即,第一个执行该操作的 warp 可能会阻塞,直到 对等 CTA 中的第二个 warp 也执行该操作(参见下面的示例)。 |
|
.ld,
.st,
.wait::{ld, st}
|
N/A |
由当前 CTA 中的一个 warp 发出只能访问当前 CTA 的 Tensor Memory 的 1/4。因此,需要由 warpgroup 来访问当前 CTA 的整个 Tensor Memory。 |
.fence::*
|
N/A |
一个线程需要对其想要与其他线程对 tensor memory 的访问进行排序的所有 tensor memory 访问执行 fence。 |
下面的示例表明:
在尝试解除分配 Tensor Memory 之前,只需确保没有来自 对等 CTA的并发 Tensor Memory 访问即可。
warp 可以在解除分配 Tensor Memory 后立即退出;无需额外的同步。
CTA0 Warp |
CTA1 Warp |
|---|---|
barrier.cluster.arrive; barrier.cluster.wait; tcgen05.dealloc.2cta.sync.aligned; exit; |
barrier.cluster.arrive; barrier.cluster.wait; tcgen05.dealloc.2cta.sync.aligned; exit; |
此示例出于说明目的使用了 cluster 栅栏,但在实践中通常使用其他同步机制。
下面的示例展示了一种场景:由于 .dealloc 可能阻塞也可能不阻塞,程序会因不正确的同步而表现出非确定性行为:
CTA0 Warp |
CTA1 Warp |
|---|---|
barrier.cluster.arrive; barrier.cluster.wait; tcgen05.dealloc.2cta.sync.aligned; exit; |
tcgen05.dealloc.2cta.sync.aligned; barrier.cluster.arrive; barrier.cluster.wait; exit; |
9.7.18.5.1. CTA 对#
cluster 内任意 2 个 CTA,若其 %cluster_ctarank 仅最后一位不同,则称它们构成一个 CTA 对。
在一个 CTA 对内,其 %cluster_ctarank 的最后一位为以下值的 CTA:
0 的 CTA 称为该 CTA 对内的偶数编号 CTA。
1 的 CTA 称为该 CTA 对内的奇数编号 CTA。
大多数 tcgen05 操作既可以按单个 CTA 级别的粒度执行,也可以按 CTA 对级别的粒度执行。当以 CTA 对粒度执行某个 tcgen05 操作时,会访问该 CTA 对内两个 CTA 的 Tensor Memory。需要发出该 tcgen05 操作的线程集合列于发出粒度中。
9.7.18.5.2. 对等 CTA#
CTA 对内奇数 CTA 的对等 CTA 是同一对内的偶数 CTA。类似地,CTA 对内偶数 CTA 的对等 CTA 是同一对内的奇数 CTA。
9.7.18.6. 第五代 TensorCore 操作的内存一致性模型#
tcgen05 指令的顺序通过两个关键概念来描述:
流水化的 tcgen05 指令
专用的 tcgen05 特有的线程间同步机制。
这些概念组合形成四种规范同步模式,下文将进一步描述。
9.7.18.6.1. 异步操作#
tcgen05 指令家族分为 2 类:
-
异步指令:
这些
tcgen05操作与同一线程中的其他tcgen05操作之间没有固有的顺序关系(除非按下文所述进行流水线化)。 -
同步指令:
这些
tcgen05操作相对于同一顺序中的其他tcgen05操作具有固有顺序关系。与共享内存相关的 Tensor Memory 分配指令相对于非
tcgen05指令保持同地址顺序。
下表列出了每个 tcgen05 指令所属的类别:
tcgen05.* 操作 |
类别 |
|---|---|
|
同步 指令 |
|
|
|
|
|
|
|
|
|
|
|
异步 指令 |
|
|
|
|
|
|
|
9.7.18.6.2. 流水线化的 tcgen05 指令#
异步 tcgen05 操作的执行和完成顺序可能与它们被发出的顺序不同。然而,来自同一 warp 的异步 tcgen05 指令的某些特定配对会形成 tcgen05 流水线,其中保证这两个异步操作以与发出它们的指令相同的顺序访问张量内存中的某些操作数。具体的配对如下:
tcgen05.mma.cta_group::N (A and metadata reads)->tcgen05.mma.cta_group::N (D writes)(相同的 N)tcgen05.mma.cta_group::N (A and metadata reads)->tcgen05.cp.cta_group::N (writes)(相同的 N)tcgen05.mma.cta_group::N (A and metadata reads)->tcgen05.shift.cta_group::N (writes)(相同的 N)tcgen05.mma.cta_group::N (C reads)->tcgen05.mma.cta_group::N (D writes)(相同的 N 以及累加器地址与形状)tcgen05.mma.cta_group::N (D writes)->tcgen05.mma.cta_group::N (C reads)(相同的 N 以及累加器地址与形状)tcgen05.mma.cta_group::N (D writes)->tcgen05.mma.cta_group::N (D writes)(相同的 N 以及累加器地址与形状)tcgen05.cp.<not .4x256b>.cta_group::N (writes)->tcgen05.mma.cta_group::N (A and metadata reads)(相同的 N 与地址)tcgen05.cp.4x256b.cta_group::N (writes)->tcgen05.mma.cta_group::N (A and metadata reads)(相同的 N)tcgen05.shift.cta_group::N (writes)->tcgen05.mma.cta_group::N (A and metadata reads)(相同的 N)tcgen05.shift.cta_group::N (reads and writes)->tcgen05.mma.cp.4x256b.cta_group::N (writes)(相同的 N)tcgen05.st.sync.aligned->tcgen05.ld.sync.alignedtcgen05.st.sync.aligned->tcgen05.st.sync.alignedtcgen05.ld.sync.aligned->tcgen05.st.sync.aligned
由不同 warp 发出的指令始终是非流水线化的。
9.7.18.6.2.1. 隐式流水线化的 tcgen05 指令#
指令 tcgen05.commit 和 tcgen05.wait 分别相对于它们从同一线程跟踪的、先前发出的 tcgen05.{mma,cp,shift} 和 tcgen05.{ld,st} 指令是隐式流水线化的。
9.7.18.6.2.1.1. 基于 mbarrier 的完成机制#
以下指令的异步操作的完成通过基于 mbarrier 的等待机制来观察:
tcgen05.mmatcgen05.cptcgen05.shift
tcgen05.commit 用于跟踪上述异步指令的完成。
以下是使用基于 mbarrier 的完成机制的隐式流水线化 tcgen05 指令配对:
tcgen05.mma.cta_group::N->tcgen05.commit.cta_group::N(相同的 N)tcgen05.cp.cta_group::N->tcgen05.commit.cta_group::N(相同的 N)tcgen05.shift.cta_group::N->tcgen05.commit.cta_group::N(相同的 N)
9.7.18.6.2.1.2. 基于 tcgen05.wait 指令的完成机制#
以下指令的异步操作的完成通过基于 tcgen05.wait 的等待机制来观察:
tcgen05.ldtcgen05.st
tcgen05.wait::ld 和 tcgen05.wait::st 用于跟踪 tcgen05.ld 和 tcgen05.st 异步指令的完成。
以下是使用基于 tcgen05.wait 的完成机制的隐式流水线化 tcgen05 指令配对:
tcgen05.ld->tcgen05.wait::ldtcgen05.st->tcgen05.wait::st
9.7.18.6.3. tcgen05 指令的专用线程间同步#
tcgen05 指令支持一种针对 tcgen05 指令家族优化的专用线程间同步。标准内存一致性模型同步机制也适用于 tcgen05 指令家族。
TensorCore 第五代专用同步操作 一节包含针对 tcgen05 指令的专用线程间同步。
tcgen05.fence::before_thread_sync 和 tcgen05.fence::after_thread_sync 与执行顺序指令(如 morally strong 的 ld/st/atom 指令、mbarrier 指令、barrier 指令等)组合使用,以在线程之间建立 tcgen05 操作之间的顺序关系。在同一 warp 中跨线程排序的异步 tcgen05 指令也形成一个 tcgen05 流水线。
位于 tcgen05.fence::before_thread_sync 之前的异步 tcgen05 操作被排序在所有后续 tcgen05 操作和执行顺序操作之前。
位于 tcgen05.fence::after_thread_sync 之后的异步 tcgen05 操作被排序在所有先前的 tcgen05 操作和执行顺序操作之后。
9.7.18.6.4. 规范同步模式#
使用上述规则,可以得到以下五种规范同步模式:
9.7.18.6.4.1. 流水线化指令,同一线程#
在此模式中,不需要显式的排序机制,排序保证由流水线化指令配对提供。
示例:
tcgen05.cp (A matrix)
tcgen05.mma.cta_group::N (writes to D)
tcgen05.mma.cta_group::N (reads C, which is written by the previous instruction, using the same shape)
这两条指令将按程序顺序执行。
9.7.18.6.4.2. 非流水线化指令,同一线程#
在此模式中,使用显式等待机制来等待异步 tcgen05 操作的完成。
示例 1:
tcgen05.st
tcgen05.wait::st
tcgen05.ld
tcgen05.wait::st 用于等待先前的异步指令 tcgen05.st 的完成。
示例 2:
tcgen05.mma [d], ...
tcgen05.commit.mbarrier::arrive::one
mbarrier.try_wait.relaxed.cluster (loop until successful)
tcgen05.fence::after_thread_sync
tcgen05.ld ..., [d]
对于异步 tcgen05.mma 的完成,使用 tcgen05.commit。
由于 tcgen05.ld 是异步操作,因此需要 tcgen05.fence::after_thread_sync 指令。
不需要显式的 tcgen05.fence::before_thread_sync,因为它由 tcgen05.commit 隐式执行。tcgen05.mma 与 tcgen05.commit 的组合形成一个概念上的异步流水线,并建立执行顺序。
tcgen05.mma [d], ...
tcgen05.fence::before_thread_sync
mbarrier::arrive
9.7.18.6.4.3. 流水线化指令,同一 warp 中的不同线程#
在此模式中,不需要显式的等待机制,但线程之间需要适当的同步。
示例:
线程 0 |
线程 1 |
|---|---|
tcgen05.cp.cta_group::N [a], ...
bar.warp.sync 0xffffffff
|
|
mbarrier.try_wait.relaxed.cluster // loop until success
tcgen05.fence::after_thread_sync
tcgen05.mma
bar.warp.sync 0xffffffff
tcgen05.mma.cta_group::N ..., [a]
|
9.7.18.6.4.4. 非流水线化指令,不同线程#
在此模式中,发出异步 tcgen05 指令的生产者线程必须显式等待这些指令完成,然后才能与消费者线程同步。
示例 1:
线程 0 |
线程 1 |
|---|---|
tcgen05.ld
tcgen05.wait::ld
tcgen05.fence::before_thread_sync
mbarrier.arrive.relaxed.cluster
|
|
mbarrier.try_wait.relaxed.cluster // loop until success
tcgen05.fence::after_thread_sync
tcgen05.mma
|
示例 2:
线程 0 |
线程 1 |
|---|---|
tcgen05.mma
tcgen05.commit.mbarrier::arrive::one [mbar]
|
|
mbarrier.try_wait.relaxed.cluster [mbar] // loop until success
tcgen05.fence::after_thread_sync
tcgen05.ld
|
这些同步机制也可以相互组合。例如:
线程 0 |
线程 1 |
|---|---|
tcgen05.mma
tcgen05.commit.mbarrier::arrive::one [bar1]
mbarrier.try_wait.relaxed.cluster [bar1] // loop
...
tcgen05.fence::after_thread_sync
...// completion is guaranteed
tcgen05.fence::before_thread_sync
mbarrier.arrive.relaxed.cluster [bar2] // loop
...
|
|
mbarrier.try_wait.relaxed.cluster [bar2] // loop
...
tcgen05.fence::after_thread_sync
tcgen05.ld
|
9.7.18.6.4.5. 寄存器依赖,同一线程#
对于 tcgen05.ld,通过真实寄存器依赖实现的线程内顺序将得到遵守,无论是否存在其他形式的同步。这种形式的寄存器依赖并不意味着任何其他形式的排序。例如,寄存器依赖并不意味着被依赖指令的内存访问会在依赖指令的内存访问之前执行。为了强制实现此类内存排序并避免 tcgen05.ld 周围的反依赖冒险,必须使用 tcgen05.wait::ld。
示例:
tcgen05.ld %r1, ...;
tcgen05.mma ..., %r1, ...;
9.7.18.6.5. 共享内存访问#
tcgen05.mma 和 tcgen05.cp 操作对共享内存的访问是异步执行的,并且通过异步代理(async proxy)进行。这些共享内存访问不受上述流水线规则的约束。
跨多个代理访问同一内存位置需要跨代理栅栏。对于异步代理,应使用 fence.proxy.async 在通用代理与异步代理之间同步内存。
9.7.18.7. Tensor Memory 分配与管理指令#
9.7.18.7.1. TensorCore 第五代指令:tcgen05.alloc 、 tcgen05.dealloc 、 tcgen05.relinquish_alloc_permit#
tcgen05.alloc, tcgen05.dealloc, tcgen05.relinquish_alloc_permit
动态 Tensor Memory 分配管理指令
语法
tcgen05.alloc{.exclusive}.cta_group.sync.aligned{.shared::cta}.b32 [dst], nCols;
tcgen05.dealloc{.exclusive}.cta_group.sync.aligned.b32 taddr, nCols;
tcgen05.relinquish_alloc_permit.cta_group.sync.aligned;
.cta_group = { .cta_group::1, .cta_group::2 }
说明
tcgen05.alloc 是一条阻塞指令,它动态地在 Tensor Memory 中分配指定数量的列,并将所分配 Tensor Memory 的地址写入共享内存中由地址操作数 dst 指定的位置。若所请求数量的 Tensor Memory 不可用,则 tcgen05.alloc 会阻塞,并在所请求数量的 Tensor Memory 可供分配时立即解除阻塞。
tcgen05.dealloc 是一条可能阻塞的指令,它释放由 Tensor Memory 地址 taddr 所指定的 Tensor Memory。操作数 taddr 必须指向先前的一次 Tensor Memory 分配。若指定了 .cta_group::2,
发起 warp 与 对等 CTA 的 warp 在尝试集合地释放该 Tensor Memory 之前,必须同步 Tensor Memory 访问,并且
tcgen05.dealloc可能与另一个 对等 CTA 的 warp 一起集合地执行释放,从而发生阻塞。
在内核中使用 tcgen05.alloc 指令分配的所有 Tensor Memory,都必须在内核退出之前使用 tcgen05.dealloc 显式释放。
无符号 32 位操作数 nCols 指定要分配或释放的列数。分配与释放的单位是 32 列以及每列的所有 lane。在 CTA 内按执行顺序排列的任意两次分配之间,所分配的列数都不应增加。
若未指定 .exclusive,则操作数 nCols 必须是 2 的幂,取值范围为 [32, 512]。若指定了 .exclusive,则在目标 sm_100f 上 nCols 必须是 32 的倍数且取值范围为 [32, 512],或者在目标 sm_107f 上取值范围为 [32, 576]。
表 58 给出了 nCols 的有效取值。
分配类型 |
nCols 最小值 |
nCols 最大值 |
nCols 模数 |
nCols 置位数 |
|---|---|---|---|---|
非独占 |
32 |
512 |
32 |
= 1(2 的幂) |
独占( |
sm_100, sm_103, sm_110 -> 512sm_107 -> 576 |
(无限制) |
指令 tcgen05.relinquish_alloc_permit 表示执行线程所属的 CTA 放弃分配 Tensor Memory 的权利。因此,若某个 CTA 的任一组成线程执行了 tcgen05.relinquish_alloc_permit,该 CTA 再执行 tcgen05.alloc 就是非法的。
若未指定状态空间,则使用 通用寻址。若由 dst 指定的地址不落在 .shared::cta 状态空间的地址窗口内,则行为未定义。
可选限定符 .exclusive 描述对分配许可产生的影响。
未指定
.exclusive时,分配是非独占的。该指令使用分配许可,但不声明对其的所有权。可以同时存在多个非独占分配。指定
.exclusive时,分配是独占的。该指令声明对分配许可的所有权。独占分配存在时,不得同时存在任何其他分配。独占分配通常会占用全部 Tensor Memory 容量,但也可能占用较少。当且仅当使用
.exclusive分配内存时,才必须使用.exclusive释放该内存。
独占分配:
tcgen05.alloc.exclusive 操作执行一次独占分配,取得对 Tensor Memory 和分配许可的控制权。在被相应的 tcgen05.dealloc.exclusive 操作释放之前,它必须是唯一存活的分配。
独占分配操作会阻塞,直到不存在其他存活的分配。在唯一存活的分配被释放之前,其他任何 CTA 都不得分配,无论是独占还是非独占。该唯一分配必须由列数相同的匹配 tcgen05.dealloc.exclusive 来释放,此时分配许可重新变为可用。
独占分配操作可以分配不是 2 的幂的列数。
若指定了 .cta_group::1,则唯一分配的所有权由单个 CTA 持有。若指定了 .cta_group::2,则所有权由两个对等 CTA 共同持有。
限定符 .cta_group 指定分配与释放操作所涉及的 CTA 数量。指定 .cta_group::1 时,必须由该 CTA 中的一个 warp 执行分配与释放。指定 .cta_group::2 时,必须由每个 对等 CTA 中的一个 warp 集合地执行分配与释放。参见 发射粒度 一节。指定 .cta_group::2 时,发起 warp 必须确保对等 CTA 已启动,且其 warp 最终会参与集合操作。
内核中的所有 tcgen05 指令都必须为 .cta_group 限定符指定相同的值。
必需的 .sync 限定符表示该指令使执行线程等待,直到 warp 中的所有线程都执行同一条指令后才恢复执行。
必需的 .aligned 限定符表示 warp 中的所有线程都必须执行同一条指令。在条件执行的代码中,只有在确知 warp 中所有线程对该条件的求值结果相同的情况下才应使用该指令,否则行为未定义。
若 warp 中并非所有线程都使用相同的 nCols 值,或者 warp 中有任何线程已退出,则该指令的行为未定义。
tcgen05.alloc 中的存储操作在 内存一致性模型 中被视为弱内存操作。
示例
// Example 1: Non-exclusive allocation and deallocation for 1-CTA
tcgen05.alloc.cta_group::1.sync.aligned.shared::cta.b32 [sMemAddr1], 32;
ld.shared.b32 taddr, [sMemAddr1];
// use taddr …
// more allocations and its usages …
tcgen05.dealloc.cta_group::1.sync.aligned.b32 taddr, 32;
// more deallocations …
tcgen05.relinquish_alloc_permit.cta_group::1.sync.aligned;
// Example 2: Exclusive allocation and deallocation for 2-CTA
// Following instructions are performed by current warp and the warp in the peer-CTA:
tcgen05.alloc.cta_group::2.sync.aligned.shared::cta.b32 [sMemAddr2], 32;
ld.shared.b32 taddr, [sMemAddr2];
// use taddr …
// more allocations and its usages …
tcgen05.dealloc.cta_group::2.sync.aligned.b32 taddr, 32;
// more deallocations …
tcgen05.relinquish_alloc_permit.cta_group::2.sync.aligned;
// Example 3: Exclusive allocation and deallocation for 2-CTA
.reg .b32 sMemAddr, taddr;
.reg .u32 nCols;
mov.u32 nCols, 576;
tcgen05.alloc.exclusive.cta_group::2.sync.aligned.shared::cta.b32 [sMemAddr], nCols;
// …
tcgen05.dealloc.exclusive.cta_group::2.sync.aligned.b32 taddr, nCols;
// …
tcgen05.relinquish_alloc_permit.cta_group::2.sync.aligned;
9.7.18.8. Tensor Memory 与寄存器加载/存储指令#
CTA 的线程可以对 CTA 的 Tensor Memory 执行加载与存储,并在寄存器与 Tensor Memory 之间移动数据。数据的加载与存储可按 矩阵与数据移动形状 一节所述以特定形状执行。
9.7.18.8.1. 访问限制#
并非 CTA 的所有线程都能通过 tcgen05.ld 与 tcgen05.st 操作访问整个 Tensor Memory。
CTA 的 Tensor Memory 被划分为 4 个相等的块,使 CTA 中某个 warpgroup 的每个 warp 可以访问其中一个块。Tensor Memory 的所有列可被一个 warpgroup 的全部四个 warp 访问。Tensor Memory 的一个 lane 可被该 warpgroup 中的单个 warp 访问。下表描述了访问限制。
warp 在 warpgroup 内的 ID |
可访问的 lane |
|---|---|
0 |
0-31 |
1 |
32-63 |
2 |
64-95 |
3 |
96-127 |
9.7.18.8.2. 打包与解包#
可选地,在加载与存储期间可以执行以下打包与解包操作:
打包:在
tcgen05.ld中可将两个 16 位块打包为寄存器中的一个 32 位块解包:在
tcgen05.st中可将寄存器中的单个 32 位块解包为两个 16 位块
如图 图 196 所示。
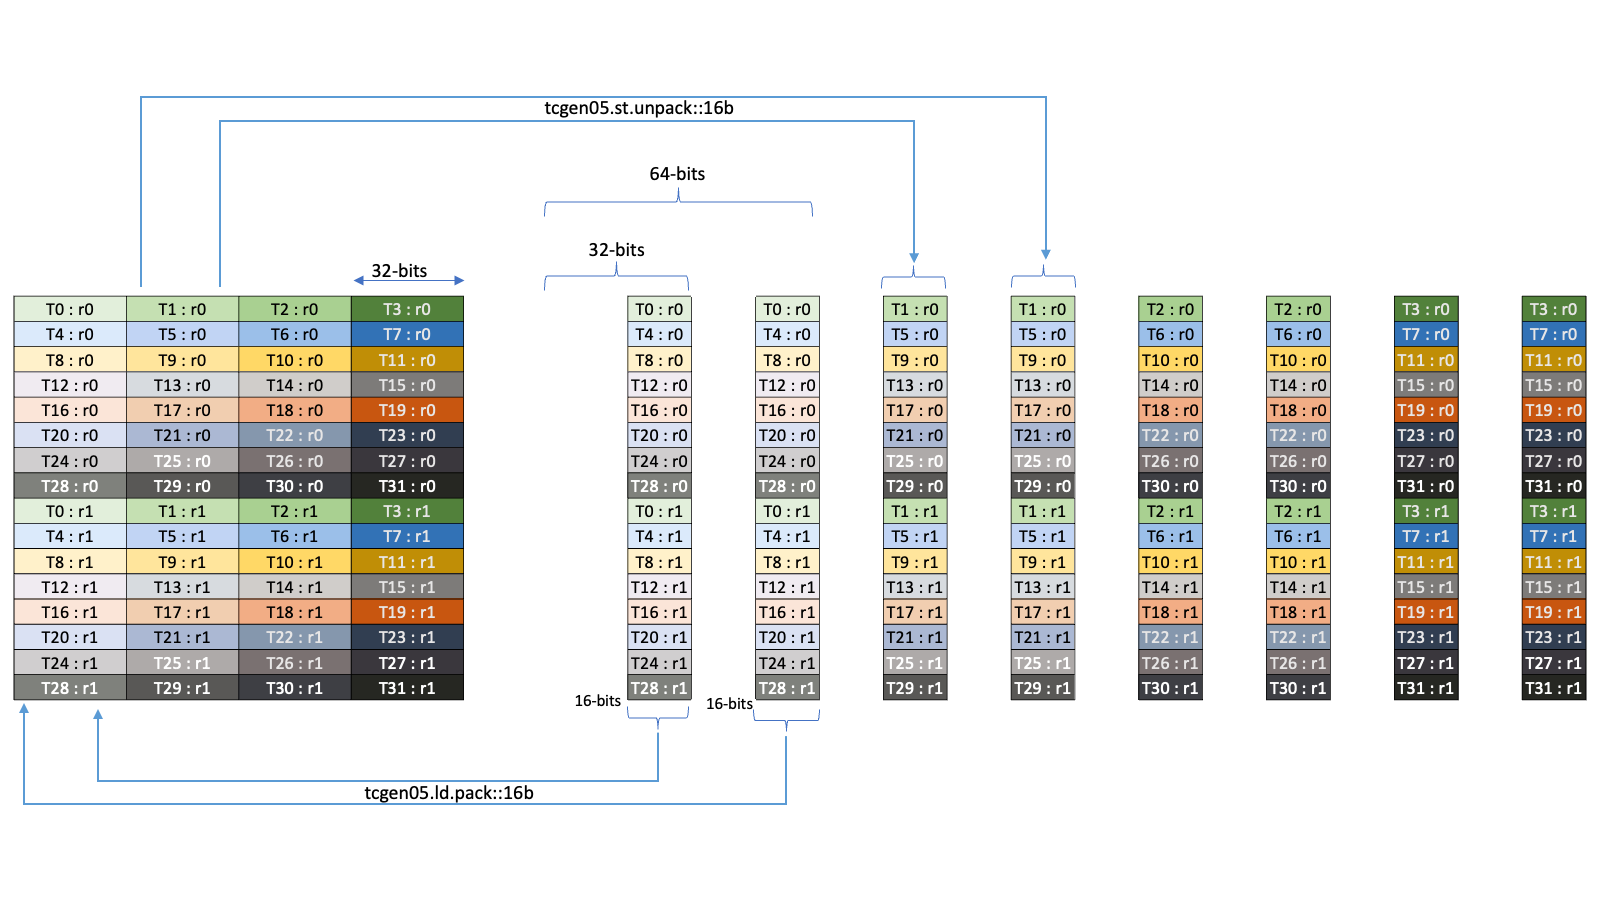
图 196 tcgen05 ld/st 的打包/解包操作
9.7.18.8.3. TensorCore 第五代指令:tcgen05.ld#
tcgen05.ld
从 Tensor Memory 异步集合加载到寄存器。
语法
// Base load instruction:
tcgen05.ld.sync.aligned.shape1.num{.pack}.b32 r, [taddr];
tcgen05.ld.sync.aligned.shape2.num{.pack}.b32 r, [taddr], immHalfSplitoff;
.shape1 = { .16x64b, .16x128b, .16x256b, .32x32b }
.shape2 = { .16x32bx2 }
.num = { .x1, .x2, .x4, .x8, .x16, .x32, .x64, .x128 }
.pack = { .pack::16b }
// Floating point type load along with reduction :
tcgen05.ld.red.sync.aligned.shape3.num.redOp{.abs}{.NaN}.f32 r, redval, [taddr];
tcgen05.ld.red.sync.aligned.shape4.num.redOp{.abs}{.NaN}.f32 r, redval, [taddr], immHalfSplitoff;
// Integer type load along with reduction :
tcgen05.ld.red.sync.aligned.shape3.num.redOp.type r, redval, [taddr];
tcgen05.ld.red.sync.aligned.shape4.num.redOp.type r, redval, [taddr], immHalfSplitoff;
.shape3 = { .32x32b }
.shape4 = { .16x32bx2 }
.redOp = { .min, .max }
.type = { .u32, .s32 }
tcgen05.ld.spcompress.sync.aligned.shape.num.rowop.spfactor{.abs}.type.idxsize mdata, cdata, [taddr];
tcgen05.ld.red.spcompress.sync.aligned.shape.num.rowop.spfactor{.abs}{.NaN}.type.idxsize mdata, cdata, redval, [taddr];
.shape = { .32x32b }
.rowop = { .min, .max }
.type = { .f32 }
.idxsize = { .b2 }
.spfactor = { .sp::2:4 }
.num = { .x4, .x8, .x16, .x32, .x64, .x128 }
说明
指令 tcgen05.ld 从 Tensor Memory 中由 32 位地址操作数 taddr 指定的位置异步加载数据到目标寄存器 r,在所有 warp 的所有线程之间集合执行。
warp 中的所有线程必须指定相同的 taddr 值,且该值必须是集合加载操作的基地址。否则行为未定义。
.shape 限定符与 .num 限定符共同决定从 Tensor Memory 加载的数据总维度。.shape 限定符指示要访问的数据的基础维度,见 数据移动形状。.num 限定符指示基础维度上的重复因子,从而得到所访问数据的总维度。
形状 .16x32bx2 执行两次形状为 .16x32b 的 Tensor Memory 访问。第一次访问的基地址由 taddr 指定,第二次访问的基地址由 taddr+immHalfSplitoff 指定,其中 immHalfSplitoff 是立即数参数。
目标操作数 r 是一个花括号包围的向量表达式,根据 .shape 与 .num 的取值由一个或多个 32 位寄存器组成。.num 与 .shape 各种组合下向量的大小见 表 59。
.num |
.shape |
||
|---|---|---|---|
.16x32bx2 / .16x64b / .32x32b |
.16x128b |
.16x256b |
|
|
1 |
2 |
4 |
|
2 |
4 |
8 |
|
4 |
8 |
16 |
|
8 |
16 |
32 |
|
16 |
32 |
64 |
|
32 |
64 |
128 |
|
64 |
128 |
NA |
|
128 |
NA |
NA |
限定符 .red 指定对每个 lane 中跨列加载的数据执行由 .redOp 指定的归约操作。归约操作的结果写入对应线程的 32 位目标寄存器操作数 redVal。当指定 .red 限定符时,.num 修饰符必须至少为 .x2。
若指定 .abs 限定符,则归约操作使用加载数据的绝对值。若指定 .NaN 限定符,则当归约操作的任一输入为 NaN 时,归约操作的结果为规范 NaN。
当指定限定符 .spcompress 时,指令在从 Tensor Memory 加载数据的同时执行内联 spcompress 操作。压缩因子由限定符 .spfactor 指定。.spfactor 唯一允许的值是 .sp::2:4,即对从 Tensor Memory 加载的数据进行 2:4 压缩。在此情形下,从 Tensor Memory 读取的数据的一半存入向量操作数 cdata,而描述所选元素索引的相应元数据信息存入向量操作数 mdata。每个数据元素的大小由 .type 给出,且必须为 .f32。每个数据元素所得元数据索引的大小由 .idxsize 给出,且始终必须为 .b2。.rowop 连同可选的 .abs 限定符一起指定从每 4 个元素一组中选出 2 个元素的判据。当限定符 .red 与 .spcompress 一起指定时,同一个 .rowop 连同可选的 .abs 限定符还指定归约运算符。但请注意,在此类情形下,若指定 .NaN 限定符,则它仅适用于操作的归约部分(.red 部分),而不适用于操作的 spcompress 部分。这是因为从根本上说 spcompress 操作在输出中始终保留 NaN。操作数 mdata、cdata 是花括号包围的向量表达式,由一个或多个 .b32 寄存器组成。每个操作数期望的向量大小可依据 表 60 计算。
操作数 |
向量大小 |
|---|---|
|
|
|
|
可选限定符 .pack::16b 可用于在加载期间将相邻列的两个 16 位元素打包为单个 32 位元素,见 打包与解包 一节。
必需的 .sync 限定符指示 tcgen05.ld 使执行线程等待,直到 warp 中所有线程都执行同一条 tcgen05.ld 指令后才继续执行。
必需的 .aligned 限定符指示 warp 中所有线程必须执行同一条 tcgen05.ld 指令。在条件执行的代码中,仅当已知 warp 中所有线程对条件的求值结果相同时才应使用 tcgen05.ld 指令,否则行为未定义。
若所有线程未使用相同的 taddr 值,或 warp 中有任何线程已退出,则 tcgen05.ld 的行为未定义。
指令 tcgen05.ld 异步执行,更多细节见 第五代 TensorCore 操作的内存一致性模型 一节。
示例
tcgen05.ld.sync.aligned.32x32b.x2.b32 {r0, r1}, [taddr1];
tcgen05.ld.sync.aligned.16x128b.x4.b32 {r0, r1, r2, r3, r4, r5, r6, r7}, [taddr2];
tcgen05.ld.red.sync.aligned.16x32bx2.x8.u32.max {r0, r1, r2, r3, r4, r5, r6, r7},
redVal, [taddr3], 16;
tcgen05.ld.red.spcompress.sync.aligned.32x32b.x32.max.sp::2:4.abs.f32.b2
{mdata_0}, {r0, r1, r2, r3, r4, r5, r6, r7, r8, r9, r10, r11, r12, r13, r14, r15},
redval, [taddr];
9.7.18.8.4. TensorCore 第五代指令:tcgen05.st#
tcgen05.st
从寄存器异步集合存储到 Tensor Memory。
语法
tcgen05.st.sync.aligned.shape1.num{.unpack}.b32 [taddr], r;
tcgen05.st.sync.aligned.shape2.num{.unpack}.b32 [taddr], immHalfSplitoff, r;
.shape1 = { .16x64b, .16x128b, .16x256b, .32x32b }
.shape2 = { .16x32bx2 }
.num = { .x1, .x2, .x4, .x8, .x16, .x32, .x64, .x128 }
.unpack = { .unpack::16b }
说明
指令 tcgen05.st 异步地将数据从源寄存器 r 存储到 Tensor Memory 中由 32 位地址操作数 taddr 指定的位置,在所有 warp 的所有线程之间集合执行。
warp 中的所有线程必须指定相同的 taddr 值,且该值必须是集合存储操作的基地址。否则行为未定义。
.shape 限定符与 .num 限定符共同决定存储到 Tensor Memory 的数据总维度。.shape 限定符指示要访问的数据的基础维度,见 数据移动形状。.num 限定符指示基础维度上的重复因子,从而得到所访问数据的总维度。
形状 .16x32bx2 执行两次形状为 .16x32b 的 Tensor Memory 访问。第一次访问的基地址由 taddr 指定,第二次访问的基地址由 taddr+immHalfSplitoff 指定,其中 immHalfSplitoff 是立即数参数。
源操作数 r 是一个花括号包围的向量表达式,根据 .shape 与 .num 的取值由一个或多个 32 位寄存器组成。.num 与 .shape 各种组合下向量的大小见 表 61。
.num |
.shape |
||
|---|---|---|---|
.16x32bx2 / .16x64b / .32x32b |
.16x128b |
.16x256b |
|
|
1 |
2 |
4 |
|
2 |
4 |
8 |
|
4 |
8 |
16 |
|
8 |
16 |
32 |
|
16 |
32 |
64 |
|
32 |
64 |
128 |
|
64 |
128 |
NA |
|
128 |
NA |
NA |
可选限定符 .unpack::16b 可用于将寄存器中的一个 32 位元素解包为两个 16 位元素,并将它们存储在相邻列中,见 打包与解包 一节。
必需的 .sync 限定符指示 tcgen05.st 使执行线程等待,直到 warp 中所有线程都执行同一条 tcgen05.st 指令后才继续执行。
必需的 .aligned 限定符指示 warp 中所有线程必须执行同一条 tcgen05.st 指令。在条件执行的代码中,仅当已知 warp 中所有线程对条件的求值结果相同时才应使用 tcgen05.st 指令,否则行为未定义。
若所有线程未使用相同的 taddr 值,或 warp 中有任何线程已退出,则 tcgen05.st 的行为未定义。
指令 tcgen05.st 异步执行,更多细节见 第五代 TensorCore 操作的内存一致性模型 一节。
示例
tcgen05.st.sync.aligned.16x64b.x4.b32 [taddr0], {r0, r1, r2, r3};
tcgen05.st.sync.aligned.16x128b.x1.unpack::16b.b32 [taddr1], {r0, r1};
9.7.18.8.5. TensorCore 第五代指令:tcgen05.wait#
tcgen05.wait
等待所有先前异步 tcgen05.ld / tcgen05.st 指令完成。
语法
tcgen05.wait_operation.sync.aligned;
.wait_operation = { .wait::ld, .wait::st }
说明
指令 tcgen05.wait::st 使执行线程阻塞,直到该执行线程先前发出的所有 tcgen05.st 操作完成为止。
指令 tcgen05.wait::ld 使执行线程阻塞,直到该执行线程先前发出的所有 tcgen05.ld 操作完成为止。
必需的 .sync 限定符指示 tcgen05.wait_operation 使执行线程等待,直到 warp 中所有线程都执行同一条 tcgen05.wait_operation 指令后才继续执行。
必需的 .aligned 限定符指示 warp 中所有线程必须执行同一条 tcgen05.wait_operation 指令。
示例
Example 1:
tcgen05.ld.sync.aligned.32x32b.x2.b32 {r0, r1}, [taddr0];
// Prevents subsequent tcgen05.mma from racing ahead of the tcgen05.ld
tcgen05.wait::ld.sync.aligned;
tcgen05.mma.cta_group::1.kind::f16 [taddr0], a-desc, b-desc, idesc, p;
Example 2:
tcgen05.st.sync.aligned.32x32b.x2.b32 [taddr0], {r0, r1};
// Prevents the write to taddr0 in tcgen05.mma from racing ahead of the tcgen05.st
tcgen05.wait::st.sync.aligned;
tcgen05.mma.cta_group::1.kind::f16 [taddr0], a-desc, b-desc, idesc, p;
9.7.18.9. Tensor Memory 数据移动指令#
可以使用 TensorCore 第五代指令:tcgen05.cp 操作将共享内存中的数据异步复制到 Tensor Memory。
9.7.18.9.1. 可选解压缩#
可选地,在复制过程中,可以将由 4 位与 6 位自定义浮点类型构成的向量解压缩为 8 位类型。
9.7.18.9.1.1. 将 4 位浮点解压缩为 8 位类型#
一组连续的 16 个 4 位元素后跟 8 字节填充,可转换为 16 个 8 位元素,见 图 197。
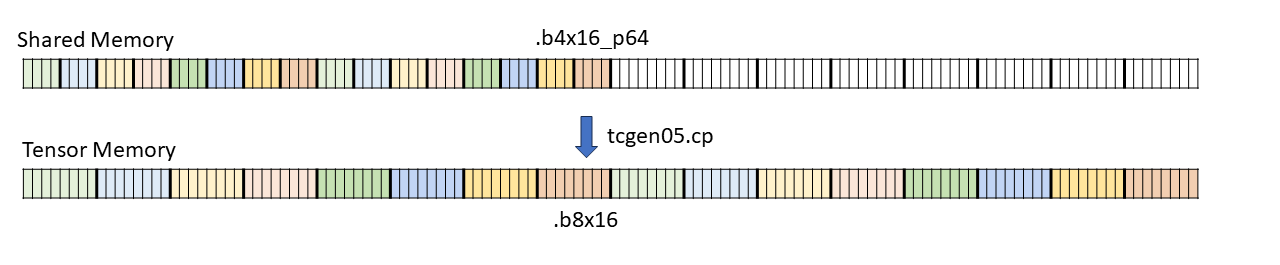
图 197 从 4 位解压缩到 8 位
单个 4 位到 8 位的解压缩见 图 198。
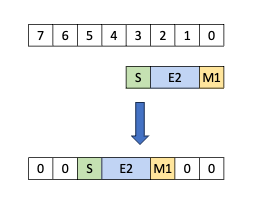
图 198 单个 4 位到 8 位的解压缩
9.7.18.9.1.2. 将 6 位浮点解压缩为 8 位类型#
一组连续的 16 个 6 位元素后跟 4 字节填充,解压缩为 16 个 8 位元素,见 图 199。
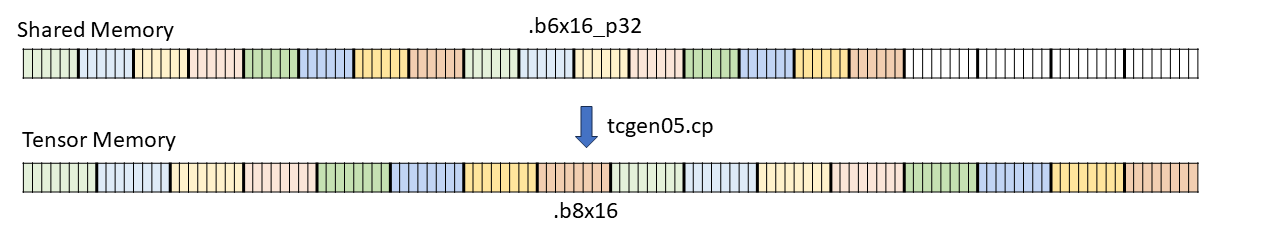
图 199 从 6 位解压缩到 8 位
类型 E3M2 与 E2M3 的单个 6 位到 8 位解压缩分别见 图 200 与 图 201。
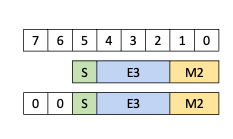
图 200 E3M2 类型单个 6 位到 8 位的解压缩
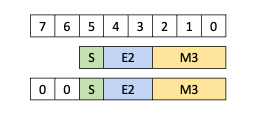
图 201 E2M3 类型单个 6 位到 8 位的解压缩
9.7.18.9.2. TensorCore 第五代指令:tcgen05.cp#
tcgen05.cp
发起一次从共享内存到 Tensor Memory 的异步复制操作。
语法
tcgen05.cp.cta_group.shape{.multicast}{.dst_fmt.src_fmt} [taddr], s-desc;
.cta_group = { .cta_group::1, .cta_group::2 }
.src_fmt = { .b6x16_p32 , .b4x16_p64 }
.dst_fmt = { .b8x16 }
.shape = { .128x256b, .4x256b, .128x128b, .64x128b**, .32x128b*** }
.multicast = { .warpx2::02_13** , .warpx2::01_23**, .warpx4*** }
说明
指令 tcgen05.cp 发起一次从共享内存到 Tensor Memory 中由地址操作数 taddr 指定位置的异步复制操作。
64 位寄存器操作数 s-desc 是矩阵描述符,表示共享内存中需要复制的源矩阵。矩阵描述符的格式见 矩阵描述符。
限定符 .shape 指示要复制的数据维度,见 数据移动形状。
限定符 .cta_group 指定当单个 CTA 的单个线程执行 tcgen05.cp 指令时访问其 Tensor Memory 的 CTA 数量。当指定 .cta_group::1 时,数据被复制到当前 CTA 的 Tensor Memory 中。执行带 .cta_group::2 的 tcgen05.cp 指令的线程会使当前 CTA 与 对等 CTA 都将数据从其共享内存复制到 Tensor Memory。
一个 kernel 内的所有 tcgen05 指令必须为 .cta_group 限定符指定相同的值。
当指定限定符 .dst_fmt 与 .src_fmt 时,复制操作会将共享内存中源格式 .src_fmt 的数据解压缩为 Tensor Memory 中的目标格式 .dst_fmt。源格式与目标格式的细节见 可选解压缩 一节。
部分 .shape 限定符要求特定的 .multicast 限定符。
.64x128b要求.warpx2::02_13或.warpx2::01_23.32x128b要求.warpx4
当 .multicast 限定符指定为 .warpx2::02_13 或 .warpx2::01_23 时,被复制的数据会多播到 warp 对中,且 warp 对中的每个 warp 接收一半数据。warp 对的形成方式如下:
.warpx2::02_13:warp 0 与 warp 2 组成一对;warp 1 与 warp 3 组成一对。.warpx2::01_23:warp 0 与 warp 1 组成一对;warp 2 与 warp 3 组成一对。
当 .multicast 修饰符指定为 .warpx4 时,被复制的数据会多播到全部 4 个 warp。
示例
tcgen05.cp.cta_group::1.128x256b [taddr0], sdesc0;
tcgen05.cp.cta_group::2.128x128b.b8x16.b6x16_p32 [taddr1], sdesc1;
tcgen05.cp.cta_group::1.64x128b.warpx2::02_13 [taddr2], sdesc2;
9.7.18.9.3. TensorCore 第五代指令:tcgen05.shift#
tcgen05.shift
为某个 warp 异步下移 Tensor Memory 中矩阵的各行。
语法
tcgen05.shift.cta_group.down [taddr];
.cta_group = { .cta_group::1, .cta_group::2 }
说明
指令 tcgen05.shift 是一条异步指令,它发起将所有行(最后一行除外)的 32 字节元素整体下移一行。地址操作数 taddr 指定 Tensor Memory 中需要下移行的矩阵的基地址。
地址操作数 taddr 的 lane 必须对齐到 32。
限定符 .cta_group 指定当单个 CTA 的单个线程执行 tcgen05.shift 指令时触及其 Tensor Memory 的 CTA 数量。当指定 .cta_group::1 时,移位操作在当前 CTA 的 Tensor Memory 中执行。当指定 .cta_group::2 时,移位操作在当前 CTA 与 对等 CTA 的 Tensor Memory 中执行。
一个 kernel 内的所有 tcgen05 指令必须为 .cta_group 限定符指定相同的值。
示例
tcgen05.shift.down.cta_group::1 [taddr0];
tcgen05.shift.down.cta_group::2 [taddr1];
9.7.18.10. TensorCore 第五代矩阵乘加运算#
形状为 MxNxK 的第五代 TensorCore 运算执行如下形式的矩阵乘加:
D = A*B+D
其中:
A矩阵形状为 MxK,位于 Tensor Memory 或共享内存中B矩阵形状为 KxN,位于当前 CTA 的共享内存中,可选地也可位于 peer CTA 中D矩阵形状为 MxN,位于 Tensor Memory 中
可选地,可使用一个输入谓词禁用来自累加矩阵的输入,此时执行如下运算
D = A*B
矩阵乘加运算根据输入类型以及乘法运算的吞吐量划分为若干大类。下面列出所支持的各种 MMA 运算大类:
f16:支持f16与bf16输入类型。tf32:支持tf32输入类型。f8f6f4:支持f8、f6与f4类型的所有输入组合。i8:支持有符号与无符号 8 位整数输入类型。mxf8f6f4/mxf4:支持 mx 浮点输入类型。mxf4nvf4:支持mxf4类型以及一种 NVIDIA 自定义浮点类型,其输入的向量元素类型为 4 位,且与其他 mx 类型类似,需要一个公共缩放因子来构成完整的浮点类型。
可选地,第五代 TensorCore MMA 支持稠密与稀疏矩阵 A。稀疏矩阵 一节描述了稀疏矩阵的细节。
部分 MMA 大类在执行 MMA 运算之前,需要从内存中读取输入矩阵并进行缩放以构成矩阵 A 与矩阵 B。tcgen05.mma 的块缩放 一节描述了矩阵缩放的细节。
下表列出 MMA 运算中涉及的各种矩阵以及它们可驻留的内存:
矩阵类型 |
内存 |
|---|---|
|
Tensor Memory 或共享内存 |
|
共享内存 |
|
Tensor Memory |
|
|
|
|
|
Tensor Memory,要求 |
一串 MMA 指令可以用同一个 A 矩阵配一串 B 矩阵,也可以用同一个 B 矩阵配一串 A 矩阵。在这些模式中,TensorCore 可以只加载一次未发生变化的矩阵,并在整个指令串中复用它,而无需多次重新加载。A 或 B 矩阵被加载到 TensorCore 的收集器缓冲区(即一种特殊缓存)中。
MMA 指令带有一个可选的 collector 限定符,用于指定某个 A 或 B 矩阵在该指令串中是首次出现因而应被加载、在指令串中未发生变化因而应被复用、还是在该指令串中最后一次使用因而应被丢弃。collector 限定符用于授权 TensorCore 复用此前已加载的 A 或 B 矩阵;但这种复用是机会性的,即即使 TensorCore 有权限复用某矩阵,它也可能重新加载该矩阵。因此,在使用某个 A 或 B 矩阵的 MMA 指令尚未完成之前,不得修改该矩阵的源内存——无论 collector 限定符是否授权。
第五代 TensorCore MMA 既可用于通用矩阵乘法,也可用于卷积运算。在卷积情形下,激活值可存储在矩阵 A 或矩阵 B 中,而权重则存储在另一个矩阵中。
激活 矩阵 |
权重 矩阵 |
运算 名称 |
指令 名称 |
收集器缓冲区适用性 |
|---|---|---|---|---|
|
|
激活 固定 |
(默认 |
收集器缓冲区适用于矩阵 |
|
|
权重 固定 |
|
收集器缓冲区适用于矩阵 |
9.7.18.10.1. 转置与取负运算#
通过在指令描述符中分别指定 Transpose A Matrix 与 Transpose B Matrix 位,可以对矩阵 A 与 B 进行转置。
通过在指令描述符中分别指定 Negate A Matrix 与 Negate B Matrix 位,可以对矩阵 A 与 B 的元素取负。
各 MMA 大类对转置与取负运算的支持情况见 表 62。
MMA 大类 |
是否支持转置 A/B |
是否支持取负 A/B |
|---|---|---|
|
是 |
是 |
|
是 |
是 |
|
是 |
是 |
|
|
是 |
|
|
是 |
|
是 |
否 |
|
否 |
是 |
|
否 |
是 |
对于 .kind::tf32,对矩阵 A 与 B 的转置运算仅在 128B 重排模式且 32B 重排原子性下受支持。
对于所有其他 MMA 大类,对矩阵 A 与 B 的转置运算在 128B 重排模式且 32B 重排原子性下不受支持。
表 63 给出 8 位转置 B 时 N 形状与 .cta_group 限定符的有效组合。
.cta_group |
N 形状 |
|---|---|
1 |
16 <= N <= 256,步长 16 |
2 |
32 <= N <= 256,步长 32 |
9.7.18.10.2. 矩阵布局组织#
表 64 描述了不同矩阵所使用的主序。
矩阵 |
所在内存 |
默认主序 |
|---|---|---|
D |
Tensor Memory |
行主序 |
A |
Tensor Memory |
|
共享内存 |
取决于重排模式。 参见 共享内存布局与重排 |
|
B |
共享内存 |
9.7.18.10.3. 类型大小、主序与重排的有效组合#
类型大小 |
主序 |
矩阵 |
支持的重排 |
|---|---|---|---|
4 位、 6 位、 8 位、 16 位、 32 位 |
行 |
A |
所有重排模式 |
列 |
B |
||
|
8 位 16 位 |
列(转置) |
A |
除 128B 重排且 32B 原子性外的 所有模式 |
行(转置) |
B |
||
32 位 |
列(转置) |
A |
仅 128B 重排 且 32B 原子性 |
行(转置) |
B |
9.7.18.10.4. Tensor 与共享内存中元素的打包格式#
9.7.18.10.4.1. Tensor Memory 中矩阵 D 的打包格式#
矩阵 D 的子字元素预期不打包在 32 位 Tensor Memory 字内。例如,若矩阵 D 的元素类型为 16 位,则一个 Tensor Memory 字将在其低 16 位中包含单个 16 位元素。
9.7.18.10.4.2. 矩阵 A 与 B 的打包格式#
6 位与 4 位浮点类型在 Tensor Memory 和共享内存中、针对不同 MMA 大类有不同的打包格式要求。要求如下。
9.7.18.10.4.3. .kind::mxf8f6f4 在 Tensor Memory 中用于矩阵 A 的打包格式#
所支持的容器大小与单个浮点类型元素的组合见 表 66
单个浮点类型 元素 |
容器 大小 |
稠密 K 维 (元素个数) |
|---|---|---|
FP4 |
8 位 |
32 |
FP6 |
6 位 |
64 |
8 位 (每个字节 填充 2 位) |
32 |
|
FP8 |
8 位 |
32 |
8 位或 6 位容器必须在 32 位 Tensor Memory 字中连续打包。例如,若矩阵 A 的元素类型为 6 位且使用 8 位容器,则 4 个连续的 A 元素应打包在一个 32 位 Tensor Memory 字中。
-
4 位打包格式置于 8 位容器中,见 图 202
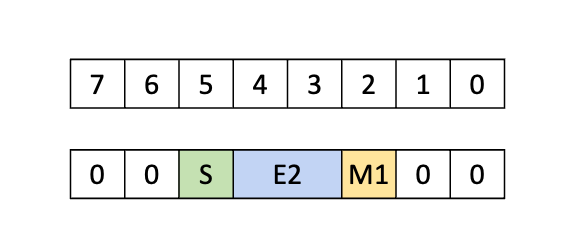
图 202 类型 E2M1 的 4 位打包格式
-
6 位打包格式置于 8 位容器中
-
6 位打包格式置于 6 位容器中
9.7.18.10.4.4. .kind::mxf8f6f4 在共享内存中用于矩阵 A 与 B 的打包格式#
共享内存中的 4 位与 6 位浮点元素必须连续打包,并且根据稠密 K 维,可能需要填充:
稠密 K 维 |
16 个元素之后是否需要填充 |
|---|---|
32 |
是 |
64 |
否 |
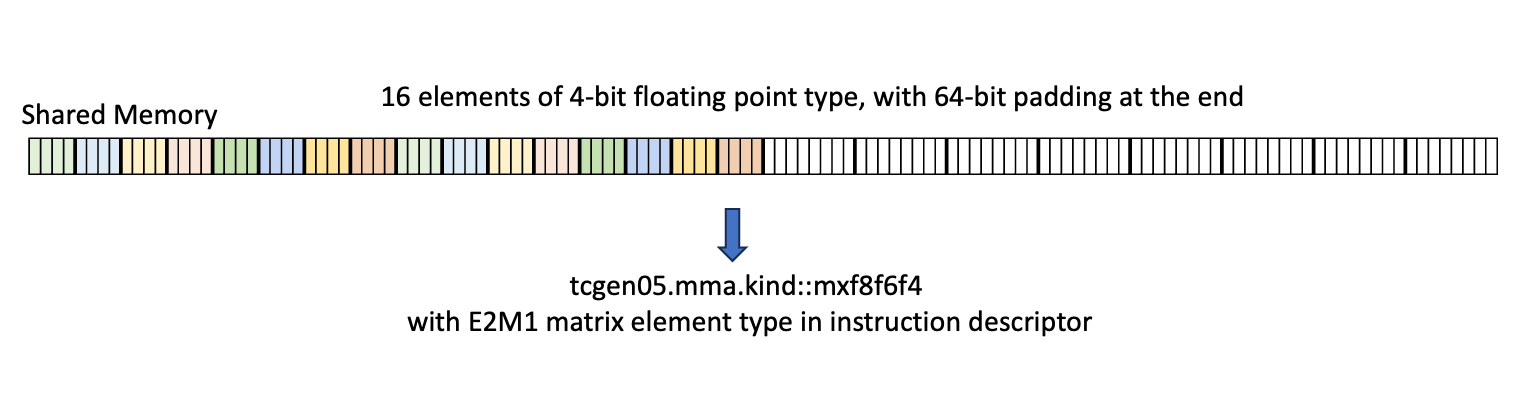
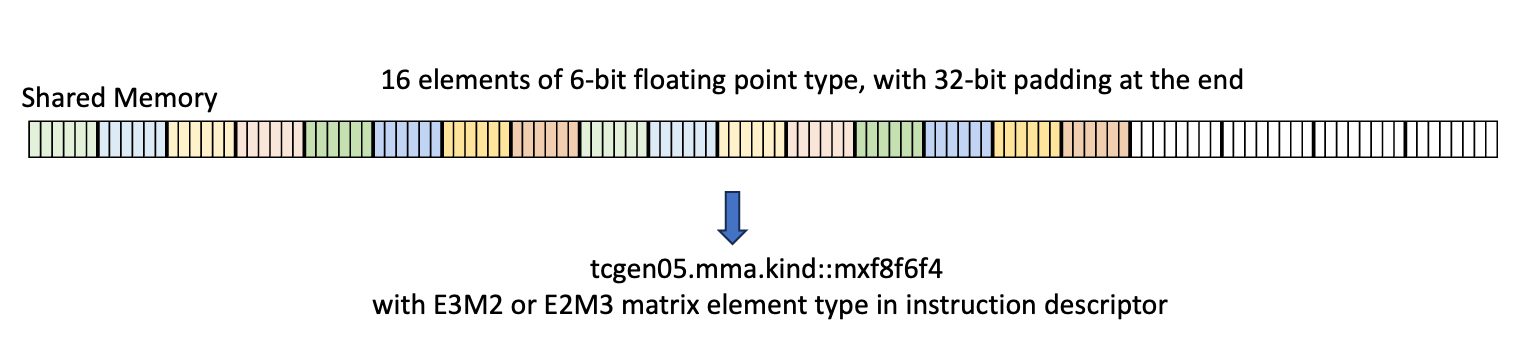
图 208 带填充的 6 位打包格式
不带填充的 6 位打包格式,见 图 209
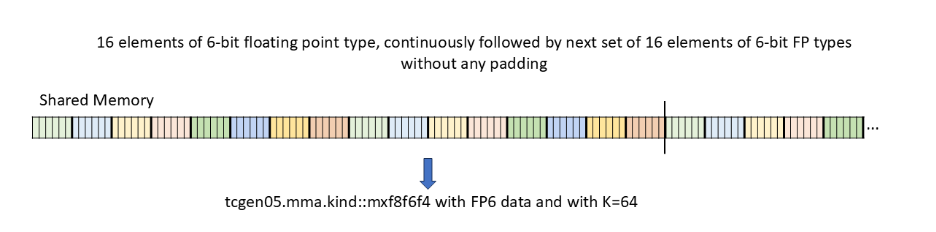
图 209 不带填充的 6 位打包格式
9.7.18.10.4.5. .kind::mxf4 与 .kind::mxf4nvf4 在 Tensor Memory 中用于矩阵 A 的打包格式#
两个 4 位浮点类型元素必须在 Tensor Memory 中打包进一个 8 位容器,对于 mxf4 见 图 210。
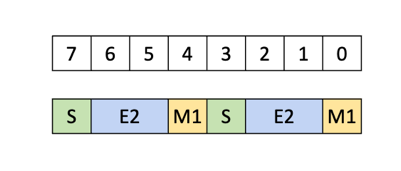
图 210 类型 E2M1 的 4 位打包格式
9.7.18.10.4.6. .kind::mxf4 与 .kind::mxf4nvf4 在共享内存中用于矩阵 A 与 B 的打包格式#
共享内存中 4 位浮点元素的打包格式为:将两个 4 位元素打包进一个 8 位容器,不填充。
9.7.18.10.5. 数据通路布局组织#
不同的 MMA 变体以不同的布局组织访问 Tensor Memory。下表列出了各种布局:
M |
cta_group |
A 稀疏性 |
是否 .ws 模式 |
数据通路组织 |
布局 ID |
Tensor Memory 数据通路 lane 对齐 |
|---|---|---|---|---|---|---|
32 |
::1 |
任意 |
是 |
1x4 |
0 |
|
64 |
::1 |
任意 |
是 |
2x2 |
0 |
|
64 |
::1 |
任意 |
否 |
4x1(使用 1/2 数据通路) |
0 或 16 |
|
128 |
::1 |
任意 |
任意 |
4x1 |
0 |
|
128 |
::2 |
稠密 |
N/A |
2x2 |
0 |
|
128 |
::2 |
稀疏 |
N/A |
4x1(使用 1/2 数据通路) |
0 或 16 |
|
256 |
::2 |
任意 |
N/A |
4x1 |
0 |
仅使用一半数据通路 lane 的布局(即 布局 F 和 布局 C)在矩阵 A、D 以及稀疏元数据矩阵之间必须使用相同的 Tensor Memory lane 对齐。
下面给出可通过 tcgen05.ld / tcgen05.st 访问 Tensor Memory 区域的 warp,以及各种 Tensor Memory 布局下的地址。
9.7.18.10.5.1. 布局 A(M = 256)#
M = 256 的布局组织见 图 211。
图 211 M = 256 的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 212
图 212 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.5.2. 布局 B(M = 128 + cta_group::2 + 稠密 A 矩阵)#
M = 128 + .cta_group::2 + 稠密 A 矩阵的布局组织见 图 213。
图 213 M = 128 + .cta_group::2 + 稠密 A 矩阵的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 214
图 214 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.5.3. 布局 C(M = 128 + cta_group::2 + 稀疏 A 矩阵)#
M = 128 + .cta_group::2 + 稀疏 A 矩阵的布局组织见 图 215。
图 215 M = 128 + .cta_group::2 + 稀疏 A 矩阵的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 216
图 216 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.5.4. 布局 D(M = 128 + cta_group::1)#
M = 128 + .cta_group::1 的布局组织见 图 217。
图 217 M = 128 + .cta_group::1 的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 218
图 218 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.5.5. 布局 E(M = 64 + .ws 模式)#
M = 64 + .ws 模式的布局组织见 图 219。
图 219 M = 64 + .ws 模式的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 220
图 220 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.5.6. 布局 F(M = 64 + 非 .ws 模式)#
M = 64 + 非 .ws 模式的布局组织见 图 221。
图 221 M = 64 + 非 .ws 模式的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 222
图 222 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.5.7. 布局 G(M = 32)#
M = 32 的布局组织见 图 223。
图 223 M = 32 的布局组织
上述区域在 tcgen05.ld / tcgen05.st 中使用的地址见 图 224
图 224 在 tcgen05.ld / tcgen05.st 中使用的地址
9.7.18.10.6. 共享内存布局与重排#
若 指令描述符 中的位 Transpose A Matrix / Transpose B Matrix 为 0,则矩阵 A / B 分别采用 K 主序。若 指令描述符 中的位 Transpose A Matrix 为 1,则矩阵 A 采用 M 主序。若 指令描述符 中的位 Transpose B Matrix 为 1,则矩阵 B 采用 N 主序。
在诸如 cuBLAS 这类默认为列主序的 BLAS 库中,带转置与不带转置的矩阵 A 与 B 可分类为 K 主序 或 M 或 N 主序,如下表所示:
非转置 |
转置 |
|
|---|---|---|
A |
K 主序 |
M 主序 |
B |
K 主序 |
N 主序 |
为避免与 A、B、row-major、col-major、transpose 和 non-transpose 混淆,本节通篇使用 MN 主序 与 K 主序。
共享内存中的矩阵由一个或多个“重排布局原子”组成。这些重排原子的确切布局取决于重排模式、重排原子性以及主维。重排的布局见 表 67
重排模式与 重排原子性 |
主维 |
重排原子布局 (128b 元素) |
|---|---|---|
128B 重排, 32B 原子性 |
M/N |
8x4 |
– |
– |
|
128B 重排, 16B 原子性 |
M/N |
8x8 |
K |
8x8 |
|
64B 重排模式 |
M/N |
4x8 |
K |
8x4 |
|
32B 重排模式 |
M/N |
2x8 |
K |
8x2 |
|
无 |
M/N |
1x8 |
K |
8x1 |
上述形状针对 128 位大小的元素。对于更小的元素大小,相同形状会沿主维乘以因子 128 / sizeof_bits(Element)。例如,对于 tf32 tensor core 输入,128B 的 MN 主序重排原子的形状为 (8*(128/32))x8 = 32x8。
下面给出若干 MxK 或 KxN 矩阵在不同重排模式下的布局示例,均以 128b 元素为单位,如每个彩色单元所示,见图 图 225、图 226、图 227、图 228、图 229、图 230、图 231、图 232、图 233。
图 225 MN 主序 128B 重排,32B 原子性
图 226 MN 主序 128B 重排
图 227 K 主序 128B 重排
图 228 MN 主序 64B 重排
图 229 K 主序 64B 重排
图 230 MN 主序 32B 重排
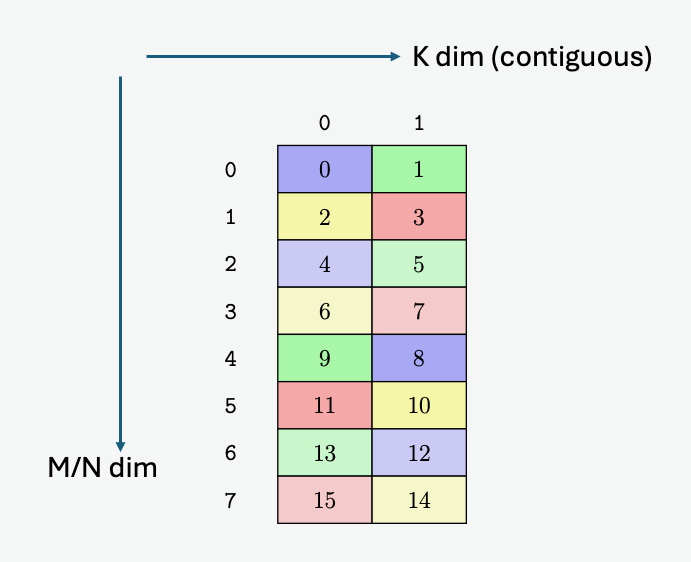
图 231 K 主序 32B 重排
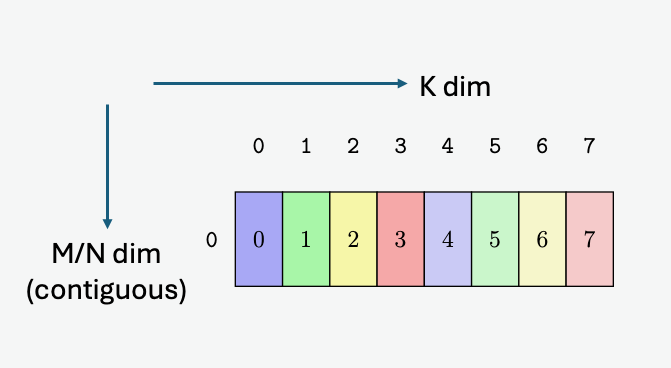
图 232 MN 主序无重排模式
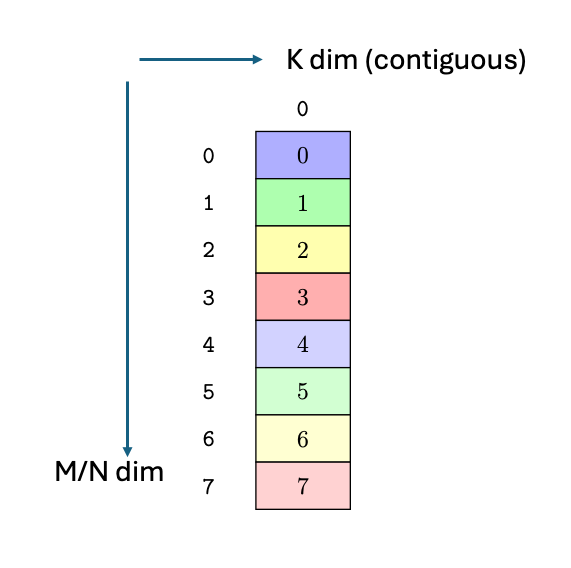
图 233 K 主序无重排模式
以下是 tf32 元素类型的 128B 重排布局的一些示例。
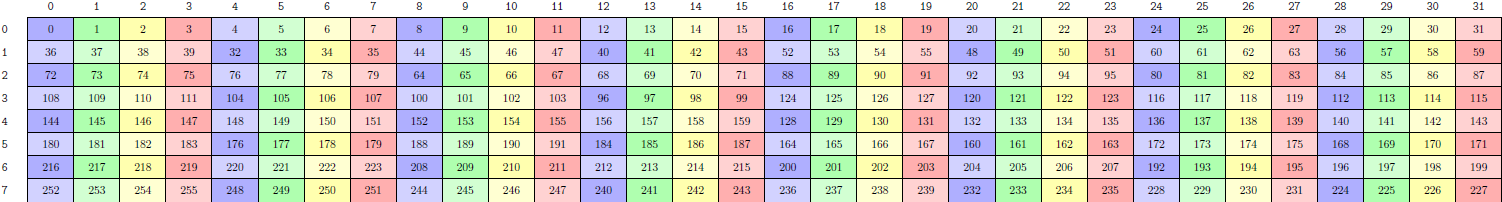
9.7.18.10.7. tcgen05.mma 的块缩放#
带有以下 .kind 限定符的 tcgen05.mma 指令:
.kind::mxf8f6f4.kind::mxf4.kind::mxf4nvf4
执行带块缩放的矩阵乘法。该运算具有如下形式:
(A * scale_A) * (B * scale_B) + D
其中 scale_A 和 scale_B 是驻留在 Tensor Memory 中的矩阵。
对于形状为 M x SFA_N 的 scale_A 矩阵,矩阵 A 的每一行被划分为 SFA_N 个分块,行中的每个分块都与同一行 SF_A 中对应的元素相乘。
类似地,对于形状为 SFB_M x N 的 scale_B 矩阵,矩阵 B 的每一列被划分为 SFB_M 个分块,列中的每个分块都与同一列 SF_B 中对应的元素相乘。
矩阵 B 的缩放因子需要复制到张量内存的全部 32 个 lane 分区中。但对于矩阵 A,若在 sm_107f 架构上通过 tcgen05.st 将缩放因子复制到 Tensor Memory,则不必进行复制。
图 236 展示了一个 tcgen05.mma 使用 scale_vec::2X 块缩放的示例。
图 236 使用 scale_vec::2X 块缩放的 tcgen05.mma
9.7.18.10.7.1. scale_vectorsize 与类型、MMA-Kind 的有效组合#
scale_A 和 scale_B 矩阵的形状取决于 .scale_vectorsize,如表 68所示。
.scale_vectorsize |
.kind::* |
K |
scale_A 的形状 |
scale_B 的形状 |
|---|---|---|---|---|
|
|
K 的所有受支持取值 |
M x 1 |
1 x N |
|
|
K 的所有受支持取值 |
M x 2 |
2 x N |
|
|
K 的所有受支持取值 |
M x 4 |
4 x N |
|
|
K = 96 |
M x 6 |
6 x N |
K = 128 |
M x 8 |
8 x N |
||
K 的所有受支持取值 (96 除外) |
M x 4 |
4 x N |
||
|
|
K = 96 |
M x 3 |
3 x N |
K = 128 |
M x 4 |
4 x N |
||
K 的所有受支持取值 (96 除外) |
M x 2 |
2 x N |
||
|
K 的所有受支持取值 |
M x 1 |
1 x N |
具体元素类型与 .scale_vectorsize 的有效组合在表 69中列出。
.kind::* |
元素数据类型 |
缩放数据类型 |
.scale_vectorsize |
|---|---|---|---|
|
E4M3, E5M2, E2M3 E3M2, E2M1 |
UE8M0 |
|
|
E2M1 |
UE8M0 |
|
|
E2M1 |
UE8M0 |
|
E2M1 |
UE4M3 |
|
|
E2M1 |
UE5M3 |
|
新增的 .blockN 限定符是 .scale_vec::NX 限定符的别名,对应关系如下:
.block32是.scale_vec::1X或.scale_vec::2X的别名,具体取决于.kind与 K 维度.block16是.scale_vec::4X的别名
9.7.18.10.7.2. 缩放因子 A ID#
缩放因子 A ID 的取值用于选择 Tensor Memory 中的子列,以构成缩放因子 A 矩阵,该矩阵用于对矩阵 A 进行缩放。
以下展示各种缩放向量大小下的缩放因子矩阵布局:
9.7.18.10.7.2.1. scale_vec::1X/block32 且 K=32/K=64 时缩放因子 A 矩阵的布局#
块大小为 32 时,矩阵 A 的每一行有一个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 1 字节对齐的子列内。SFA_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的字节偏移。图 237 展示了 SFA_ID 取不同值时哪些子列会被选中。
图 237 scale_vec::1X/block32 且 K=32/K=64 时缩放因子 A 矩阵的布局
例如,若 SFA_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,SFA_ID 取值 1、2 和 3 分别选中蓝色、黄色和红色列。
图 238 展示了 128 lane 的缩放因子 A 矩阵布局,该布局在 sm_107f 架构上受支持。此处 subp 的有效取值为 [0, 3];
图 238 scale_vec::1X/block32 且 K=32/K=64 时、128 lane 的缩放因子 A 矩阵布局
9.7.18.10.7.2.2. scale_vec::2X/block32 且 K=64/K=128 时缩放因子 A 矩阵的布局#
块大小为 32 时,矩阵 A 的每一行有两个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 2 字节对齐的子列内。SFA_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的半字偏移。图 239 展示了 SFA_ID 取不同值时哪些子列会被选中。
图 239 scale_vec::2X/block32 且 K=64/K=128 时缩放因子 A 矩阵的布局
例如,若 SFA_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,若 SFA_ID 为 2,则所有蓝色列被选中以构成缩放因子矩阵。
图 240 展示了 128 lane 的缩放因子 A 矩阵布局,该布局在 sm_107f 架构上受支持。此处 subp 的有效取值为 [0, 3];
图 240 scale_vec::2X/block32 且 K=64/K=128 时、128 lane 的缩放因子 A 矩阵布局
9.7.18.10.7.2.3. scale_vec::4X/block16 且 K=64/K=128 时缩放因子 A 矩阵的布局#
块大小为 16 时,矩阵 A 的每一行有四个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 4 字节对齐的子列内。SFA_ID 的取值必须为 0,这表示全部列(绿色)都将用于缩放因子矩阵。图 241 展示了 SFA_ID 取不同值时哪些子列会被选中。
图 241 scale_vec::4X/block16 且 K=64/K=128 时缩放因子 A 矩阵的布局
图 242 展示了 128 lane 的缩放因子 A 矩阵布局,该布局在 sm_107f 架构上受支持。此处 subp 的有效取值为 [0, 3];
图 242 scale_vec::4X/block16 且 K=64/K=128 时、128 lane 的缩放因子 A 矩阵布局
9.7.18.10.7.2.4. block32 且 K=96 时缩放因子 A 矩阵的布局(语义上等价于 scale_vec::3X)#
块大小为 32 时,矩阵 A 的每一行有三个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 4 字节对齐的子列内。SFA_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的字节偏移。图 243、图 244、图 245 和 图 246 展示了 SFA_ID 取不同值时哪些子列会被选中。
图 243 block32 且 K=96 时、SFA_ID=00 的缩放因子 A 矩阵布局
图 244 block32 且 K=96 时、SFA_ID=01 的缩放因子 A 矩阵布局
图 245 block32 且 K=96 时、SFA_ID=10 的缩放因子 A 矩阵布局
图 246 block32 且 K=96 时、SFA_ID=11 的缩放因子 A 矩阵布局
例如,若 SFA_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,SFA_ID 取值 1、2 和 3 分别选中蓝色、黄色和红色列。
图 247、图 248、图 249 和 图 250 展示了 128 lane 的缩放因子 A 矩阵布局,该布局在 sm_107f 架构上受支持。此处 subp 的有效取值为 [0, 3];
图 247 block32 且 K=96 时、128 lane 且 SFA_ID=00 的缩放因子 A 矩阵布局
图 248 block32 且 K=96 时、128 lane 且 SFA_ID=01 的缩放因子 A 矩阵布局
图 249 block32 且 K=96 时、128 lane 且 SFA_ID=10 的缩放因子 A 矩阵布局
图 250 block32 且 K=96 时、128 lane 且 SFA_ID=11 的缩放因子 A 矩阵布局
9.7.18.10.7.2.5. block16 且 K=96 时缩放因子 A 矩阵的布局(语义上等价于 scale_vec::6X)#
块大小为 16 时,矩阵 A 的每一行有六个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 4 字节对齐的子列内。SFA_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的字节偏移。图 251 和 图 252 展示了 SFA_ID 取不同值时哪些子列会被选中。
图 251 block16 且 K=96 时、SFA_ID=00 的缩放因子 A 矩阵布局
图 252 block16 且 K=96 时、SFA_ID=10 的缩放因子 A 矩阵布局
例如,若 SFA_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,若 SFA_ID 为 2,则所有蓝色列被选中以构成缩放因子矩阵。
图 253 和 图 254 展示了 128 lane 的缩放因子 A 矩阵布局,该布局在 sm_107f 架构上受支持。此处 subp 的有效取值为 [0, 3];
图 253 block16 且 K=96 时、128 lane 且 SFA_ID=00 的缩放因子 A 矩阵布局
图 254 block16 且 K=96 时、128 lane 且 SFA_ID=10 的缩放因子 A 矩阵布局
9.7.18.10.7.2.6. block16 且 K=128/256 时缩放因子 A 矩阵的布局(语义上等价于 scale_vec::8X)#
块大小为 16 时,矩阵 A 的每一行有八个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 4 字节对齐的子列内。SFA_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的字节偏移,且必须为 0。图 255 展示了哪些子列会被选中。
图 255 block16 且 K=128/256 时缩放因子 A 矩阵的布局
图 256 展示了 128 lane 的缩放因子 A 矩阵布局,该布局在 sm_107f 架构上受支持。此处 subp 的有效取值为 [0, 3];
图 256 block16 且 K=128/256 时、128 lane 的缩放因子 A 矩阵布局
9.7.18.10.7.3. 缩放因子 B ID#
缩放因子 B ID 的取值用于选择 Tensor Memory 中的子列,以构成缩放因子 B 矩阵,该矩阵用于对矩阵 B 进行缩放。
以下展示各种缩放向量大小下的缩放因子矩阵布局:
9.7.18.10.7.3.1. scale_vec::1X/block32 且 K=32/K=64 时缩放因子 B 矩阵的布局#
块大小为 32 时,矩阵 B 的每一行有一个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 1 字节对齐的子列内。SFB_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的字节偏移。图 257 展示了 SFB_ID 取不同值时哪些子列会被选中。
图 257 scale_vec::1X/block32 且 K=32/K=64 时缩放因子 B 矩阵的布局
例如,若 SFB_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,SFB_ID 取值 1、2 和 3 分别选中蓝色、黄色和红色列。
9.7.18.10.7.3.2. scale_vec::2X/block32 且 K=64/K=128 时缩放因子 B 矩阵的布局#
块大小为 32 时,矩阵 B 的每一行有两个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 2 字节对齐的子列内。SFB_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的半字偏移。图 258 展示了 SFB_ID 取不同值时哪些子列会被选中。
图 258 scale_vec::2X/block32 且 K=64/K=128 时缩放因子 B 矩阵的布局
例如,若 SFB_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,若 SFB_ID 为 2,则所有蓝色列被选中以构成缩放因子矩阵。
9.7.18.10.7.3.3. scale_vec::4X/block16 且 K=64/K=128 时缩放因子 B 矩阵的布局#
块大小为 16 时,矩阵 B 的每一行有四个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 4 字节对齐的子列内。SFB_ID 的取值必须为 0,这表示全部列(绿色)都将用于缩放因子矩阵。图 259 展示了 SFB_ID 取不同值时哪些子列会被选中。
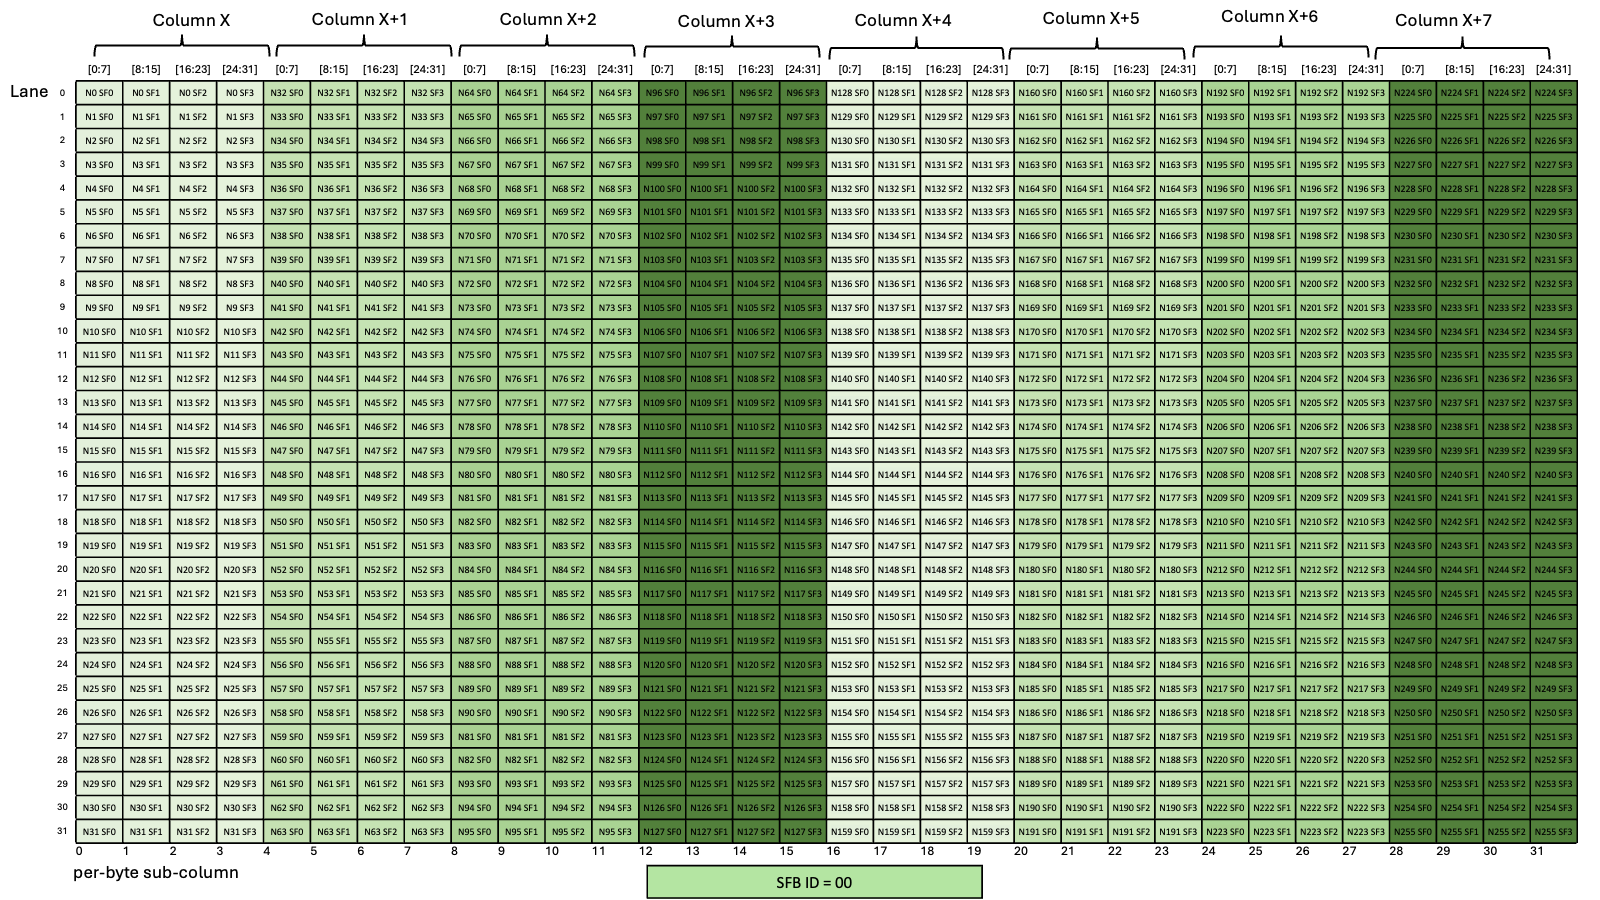
图 259 scale_vec::4X/block16 且 K=64/K=128 时缩放因子 B 矩阵的布局
9.7.18.10.7.3.4. block32 且 K=96 时缩放因子 B 矩阵的布局(语义上等价于 scale_vec::3X)#
块大小为 32 时,矩阵 B 的每一行有三个缩放因子,且该缩放因子必须提供在 Tensor Memory 中按 4 字节对齐的子列内。SFB_ID 指定 Tensor Memory 字中必须用于缩放因子矩阵的字节偏移。
对于 N<=128,图 260、图 261、图 262 和 图 263 展示了 SFB_ID 取不同值时哪些子列会被选中。
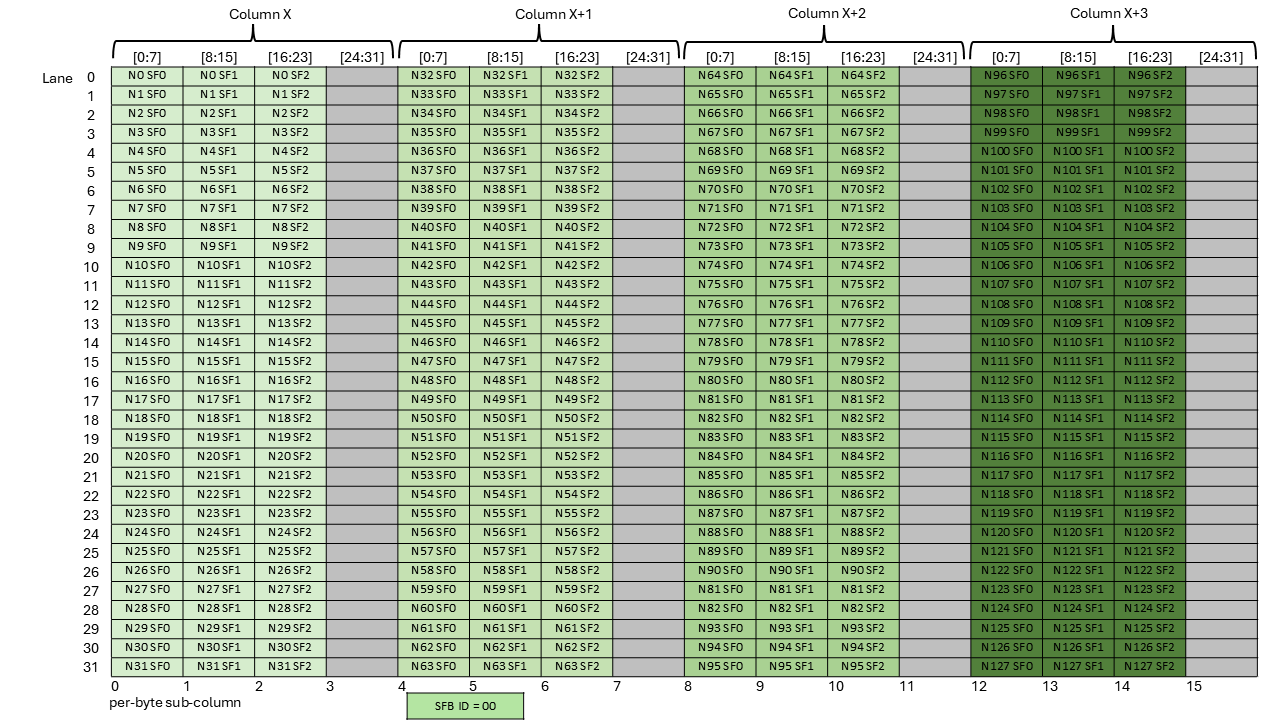
图 260 block32 且 K=96、N<=128 时,SFB_ID=00 的缩放因子 B 矩阵布局
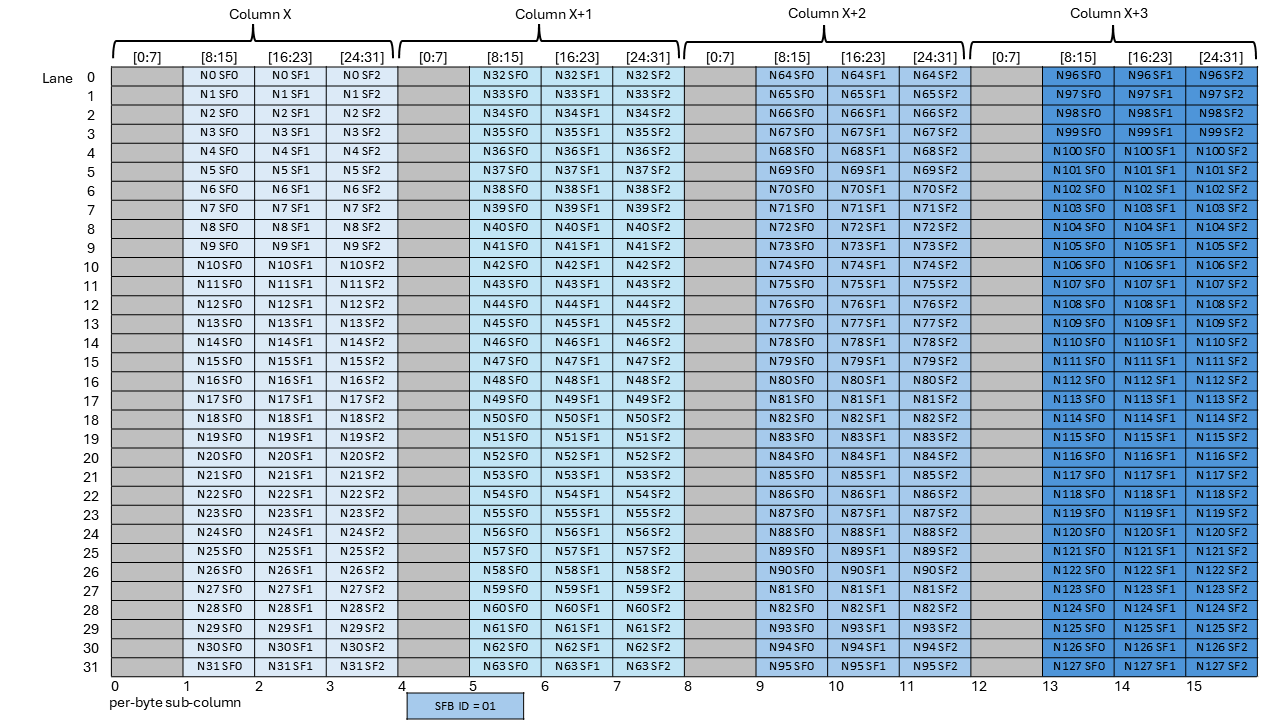
图 261 block32 且 K=96、N<=128 时,SFB_ID=01 的缩放因子 B 矩阵布局
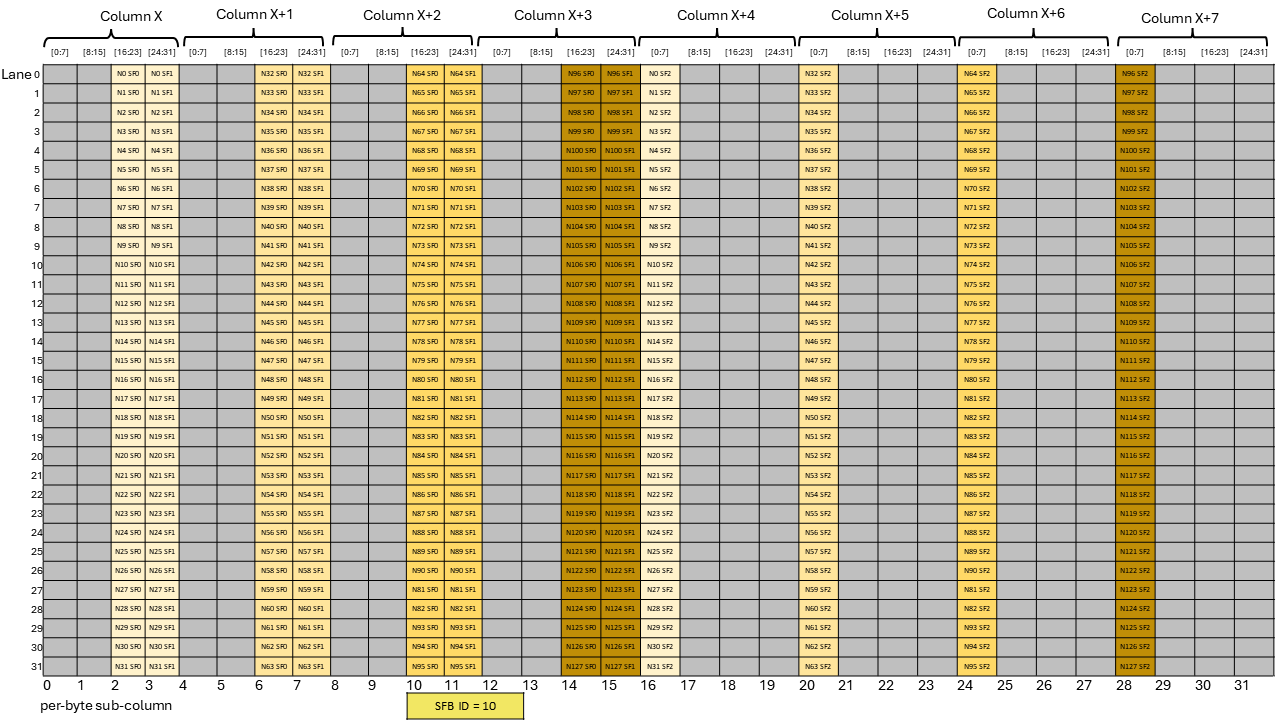
图 262 block32 且 K=96、N<=128 时,SFB_ID=10 的缩放因子 B 矩阵布局
图 263 block32 且 K=96、N<=128 时,SFB_ID=11 的缩放因子 B 矩阵布局
对于 N>128,图 264、图 265、图 266、图 267、图 268 和 图 269 展示了 SFB_ID 取不同值时哪些子列会被选中。
图 264 block32 且 K=96、N>128 时,SFB_ID=00 的缩放因子 B 矩阵布局
图 265 block32 且 K=96、N>128 时,SFB_ID=01 的缩放因子 B 矩阵布局
图 266 block32 且 K=96、N>128 时,SFB_ID=10 的缩放因子 B 矩阵布局
图 267 block32 且 K=96、N>128 时,SFB_ID=10 的缩放因子 B 矩阵布局
图 268 block32 且 K=96、N>128 时,SFB_ID=11 的缩放因子 B 矩阵布局
图 269 block32 且 K=96、N>128 时,SFB_ID=11 的缩放因子 B 矩阵布局
例如,若 SFB_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,SFB_ID 取值 1、2 和 3 分别选中蓝色、黄色和红色列。
9.7.18.10.7.3.5. block16 且 K=96 的缩放因子 B 矩阵布局(语义等价于 scale_vec::6X)#
块大小为 16 时,B 矩阵每行有六个缩放因子,且缩放因子必须提供在 Tensor Memory 中 4 字节对齐的子列里。SFB_ID 指定 Tensor Memory 字中用于缩放因子矩阵的字节偏移。
当 N<=128 时,图 270 和 图 271 显示了不同 SFB_ID 取值下会选中哪些子列。
图 270 block16、K=96、N<=128 且 SFB_ID=00 时缩放因子 B 矩阵的布局
图 271 block16、K=96、N<=128 且 SFB_ID=10 时缩放因子 B 矩阵的布局
当 N>128 时,图 272、图 273、图 274 和 图 275 显示了不同 SFB_ID 取值下会选中哪些子列。
图 272 block16、K=96、N>128 且 SFB_ID=00 时缩放因子 B 矩阵的布局
图 273 block16、K=96、N>128 且 SFB_ID=00 时缩放因子 B 矩阵的布局
图 274 block16、K=96、N>128 且 SFB_ID=10 时缩放因子 B 矩阵的布局
图 275 block16、K=96、N>128 且 SFB_ID=10 时缩放因子 B 矩阵的布局
例如,若 SFB_ID 为 0,则所有绿色列被选中以构成缩放因子矩阵。类似地,若 SFB_ID 为 2,则所有蓝色列被选中以构成缩放因子矩阵。
9.7.18.10.7.3.6. block16 且 K=128/256 的缩放因子 B 矩阵布局(语义等价于 scale_vec::8X)#
块大小为 16 时,B 矩阵每行有八个缩放因子,且缩放因子必须提供在 Tensor Memory 中 4 字节对齐的子列里。SFB_ID 指定 Tensor Memory 字中用于缩放因子矩阵的字节偏移。
当 N<=128 时,图 276 显示了不同 SFB_ID 取值下会选中哪些子列。
图 276 block16、K=128/256、N<=128 且 SFB_ID=00 时缩放因子 B 矩阵的布局
当 N>128 时,图 277 和 图 278 显示了不同 SFB_ID 取值下会选中哪些子列。
图 277 block16、K=128/256、N>128 且 SFB_ID=00 时缩放因子 B 矩阵的布局
图 278 block16、K=128/256、N>128 且 SFB_ID=00 时缩放因子 B 矩阵的布局
9.7.18.10.8. 输入矩阵的解压缩#
带以下 .kind 限定符的 tcgen05.mma 指令:
.kind::f8f6f4.kind::mxf8f6f4
支持对预先压缩的输入矩阵 B 解压缩。
矩阵 B 的取值位于 Tensor Memory 中的一张查找表内,指令中的输入操作数指向一个压缩矩阵,该矩阵包含查找表的索引。
图 279 显示了存储在 Tensor Memory 中的查找表的布局。
图 279 Tensor Memory 中查找表的布局
形状为 NxK 的 B 矩阵按 图 280 所示的方式压缩。
图 280 NxK 的 B 矩阵按 8B LUT 压缩
图 281 显示了压缩后的矩阵 B 在矩阵计算中的用法。
图 281 矩阵 B 在计算中的用法
图 282 显示了查找表的 GMEM 与 TMEM 布局。GMEM 布局显示了 4 个 128B 的块,每个块包含 8 行 2 列。
图 282 查找表的 GMEM 与 TMEM 布局
9.7.18.10.9. 稀疏矩阵#
当矩阵 A 是按稀疏粒度分布的、每行含 50% 零元素的结构化稀疏矩阵时,可以使用指令 tcgen05.mma.sp。
在 MxNxK 的稀疏 tcgen05.mma.sp 运算中,形状为 MxK 的矩阵 A 以打包形式按 Mx(K/2) 存储在内存中。对于矩阵 A 的每个 K 宽行,50% 的元素为零,其余 K/2 个非零元素存储在内存中。元数据指明在执行 MMA 运算之前,K/2 个非零元素到 K 个元素的映射。
稀疏矩阵 A 的粒度定义为:矩阵行中某个子块内非零元素个数与该子块内元素总数的比值,其中子块的大小由形状决定。下表列出了不同 tcgen05.mma.sp 变体的粒度:
tcgen05.mma 的 .kind |
稀疏粒度 |
稀疏性版本 |
|---|---|---|
|
1:2 |
不适用 |
|
2:4 |
|
|
||
|
||
|
||
|
||
|
4:8(成对) |
|
2:4 |
|
|
|
4:8(成对) |
|
2:4 |
|
9.7.18.10.9.1. 带 .kind::tf32 的稀疏 tcgen05.mma.sp#
对于 .kind::tf32,矩阵 A 以 1:2 的粒度结构化稀疏。换言之,矩阵 A 某行中每两个相邻元素组成的块含一个零元素和一个非零元素。内存中只存储非零元素,元数据中的 4 位索引指明非零元素在这个两宽块中的位置。该索引仅有以下取值有意义:
0b11100b0100
其余取值会导致行为未定义。
图 283 tf32 kind 的稀疏 tcgen05.mma 元数据示例
9.7.18.10.9.2. 带 .kind::f16、.kind::f8f6f4、.kind::mxf8f6f4、.kind::i8、.kind::ti16 的稀疏 tcgen05.mma.sp#
对于 tcgen05.mma 的以下 .kind 变体:
.kind::f16.kind::f8f6f4.kind::mxf8f6f4.kind::i8.kind::ti16
矩阵 A 以 2:4 的粒度结构化稀疏。换言之,矩阵 A 某行中每四个相邻元素组成的块含两个零元素和两个非零元素。内存中只存储非零元素,元数据中的两个 2 位索引指明这两个非零元素在这个四宽块中的位置。该索引仅有以下取值有意义:
0b01000b10000b11000b10010b11010b01100b1110
图 284 f16/f8f6f4/mxf8f6f4 kind 的稀疏 tcgen05.mma 元数据示例
9.7.18.10.9.3. 带 .kind::mxf4 和 .kind::mxf4nvf4 的稀疏 tcgen05.mma.sp#
.kind::mxf4 和 .kind::mxf4nvf4 的稀疏粒度由 指令描述符 的 SparsityVersion 字段(第 12 位)决定:
SparsityVersion
v0(第 12 位 = 0):适用于sm_100a、sm_103a和sm_110a。矩阵A以4:8的粒度成对结构化稀疏。某行中每八个相邻元素组成的块含四个零元素和四个非零元素,且非零元素聚集为两个元素的子块。内存中只存储这四个非零元素,元数据中的两个 2 位索引指明这两个非零的两宽子块在这个八宽块中的位置。SparsityVersion
v1(第 12 位 = 1):适用于sm_107a。矩阵A以2:4的粒度结构化稀疏。某行中每四个相邻元素组成的块含两个零元素和两个非零元素。内存中只存储这两个非零元素,元数据中的两个 2 位索引指明这两个非零元素在这个四宽块中的位置。元数据格式与有效索引取值同.kind::mxf8f6f4(参见 Sparse tcgen05.mma.sp with .kind::f16, .kind::f8f6f4, .kind::mxf8f6f4, .kind::i8, .kind::ti16)。
元数据索引仅有以下取值有意义:
0b01000b10000b11000b10010b11010b01100b1110
其余取值会导致行为未定义。
注
对于 sm_100a、sm_103a、sm_110a,指令描述符的第 12 位(SparsityVersion)必须设为 v0;对于 sm_107a 必须设为 v1。使用错误的 SparsityVersion 会导致行为未定义。详见 指令描述符。
图 285 mxf4 kind 的稀疏 tcgen05.mma 元数据示例(SparsityVersion v0,4:8)
图 286 mxf4 kind 的稀疏 tcgen05.mma 元数据示例(SparsityVersion v1,2:4)
9.7.18.10.9.4. 稀疏性选择器#
稀疏性选择器的取值用于选择 Tensor Memory 中的子列以构成稀疏元数据矩阵,该矩阵与矩阵 A 一起构成被乘数矩阵。
以下显示各种 MMA 变体在 Tensor Memory 中的稀疏元数据矩阵布局:
9.7.18.10.9.4.1. M = 64 时 .kind::f16、.kind::ti16 的稀疏元数据矩阵布局#
图 287 显示了不同稀疏性选择器取值下会选中哪些子列。
图 287 M = 64 时 .kind::f16 的稀疏元数据布局
9.7.18.10.9.4.2. M = 128 / M = 256 时 .kind::f16、.kind::ti16 的稀疏元数据矩阵布局#
图 288 显示了不同稀疏性选择器取值下会选中哪些子列。
图 288 M = 128 / M = 256 时 .kind::f16 的稀疏元数据布局
9.7.18.10.9.4.3. M = 64 时 .kind::tf32 的稀疏元数据矩阵布局#
图 289 显示了不同稀疏性选择器取值下会选中哪些子列。
图 289 M = 64 时 .kind::tf32 的稀疏元数据布局
9.7.18.10.9.4.4. M = 128 / M = 256 时 .kind::tf32 的稀疏元数据矩阵布局#
图 290 显示了不同稀疏性选择器取值下会选中哪些子列。
图 290 M = 128 / M = 256 时 .kind::tf32 的稀疏元数据布局
9.7.18.10.9.4.5. M = 64 时 .kind::f8f6f4、.kind::mxf8f6f4、.kind::i8、.kind::mxf4、.kind::mxf4nvf4 的稀疏元数据矩阵布局#
稀疏性选择器的取值:
对于
.kind::i8和.kind::f8f6f4必须为 0对于
.kind::mxf8f6f4、.kind::mxf4和.kind::mxf4nvf4假定为 0
并且所有列都被选中,如 图 291 所示
图 291 M = 64 时 .kind::f8f6f4、.kind::mxf8f6f4、.kind::i8、.kind::mxf4、.kind::mxf4nvf4 的稀疏元数据布局
9.7.18.10.9.4.6. M = 128 / M = 256 时 .kind::f8f6f4、.kind::mxf8f6f4、.kind::i8、.kind::mxf4、.kind::mxf4nvf4 的稀疏元数据矩阵布局#
稀疏性选择器的取值:
对于
.kind::i8和.kind::f8f6f4必须为 0对于
.kind::mxf8f6f4、.kind::mxf4和.kind::mxf4nvf4假定为 0
并且所有列都被选中,如 图 292 所示
图 292 M = 128 / M = 256 时 .kind::f8f6f4、.kind::mxf8f6f4、.kind::i8、.kind::mxf4、.kind::mxf4nvf4 的稀疏元数据布局
9.7.18.10.9.5. 对齐限制#
仅使用一半数据通路 lane 的布局(如 数据通路布局组织 中所述,即 布局 F 和 布局 C)在矩阵 A、D 和稀疏元数据矩阵之间必须使用相同的对齐。
9.7.18.10.10. TensorCore 第五代 MMA 指令#
9.7.18.10.10.1. TensorCore 第五代指令:tcgen05.mma#
tcgen05.mma
执行第五代矩阵乘加运算。
语法
// 1. Floating-point type without block scaling:
tcgen05.mma.cta_group.kind [d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d {, scale-input-d};
tcgen05.mma.cta_group.kind [d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d {, scale-input-d};
.kind = { .kind::f16, .kind::tf32, .kind::f8f6f4 }
.cta_group = { .cta_group::1, .cta_group::2 }
// 2. Floating-point type with block scaling:
tcgen05.mma.cta_group.kind.block_scale{.scale_vectorsize}
[d-tmem], a-desc, b-desc, idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
tcgen05.mma.cta_group.kind.block_scale{.scale_vectorsize}
[d-tmem], [a-tmem], b-desc, idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
.kind = { .kind::mxf8f6f4, .kind::mxf4, .kind::mxf4nvf4 }
.cta_group = { .cta_group::1, .cta_group::2 }
.scale_vectorsize = { .scale_vec::1X, .scale_vec::2X, .scale_vec::4X, .block16, .block32 }
// 3. Convolution MMA for floating-point type without block scaling:
tcgen05.mma.cta_group.kind.collector_a_usage{.collector_b_usage}
[d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d {, scale-input-d};
tcgen05.mma.cta_group.kind{.ashift}.collector_a_usage{.collector_b_usage}
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d {, scale-input-d};
tcgen05.mma.cta_group.kind.ashift{.collector_a_usage}{.collector_b_usage}
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d {, scale-input-d};
.kind = { .kind::f16, .kind::tf32, .kind::f8f6f4 }
.cta_group = { .cta_group::1, .cta_group::2 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 4. Activation Stationary MMA for floating-point type with block scaling:
tcgen05.mma.cta_group.kind.block_scale{.scale_vectorsize}.collector_a_usage{.collector_b_usage}
[d-tmem], a-desc, b-desc, idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
tcgen05.mma.cta_group.kind.block_scale{.scale_vectorsize}.collector_a_usage{.collector_b_usage}
[d-tmem], [a-tmem], b-desc, idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
.cta_group = { .cta_group::1, .cta_group::2 }
.scale_vectorsize = { .scale_vec::1X, .scale_vec::2X, .scale_vec::4X, .block16, .block32 }
.kind = { .kind::mxf8f6f4, .kind::mxf4, .kind::mxf4nvf4 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 5. Integer type:
tcgen05.mma.cta_group.kind [d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind [d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::ti16.collector_b_usage
[d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::ti16.collector_b_usage
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
.cta_group = { .cta_group::1, .cta_group::2 }
.kind = { .kind::i8, .kind::ti16 }
.collector_b_usage = { .collector::buffer::op }
::buffer = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 6. Convolution MMA for integer type:
tcgen05.mma.cta_group.kind.collector_a_usage [d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind.ashift{.collector_a_usage} [d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind{.ashift}.collector_a_usage [d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::ti16.collector_a_usage.collector_b_usage
[d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::ti16.ashift{.collector_a_usage}.collector_b_usage
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::ti16{.ashift}.collector_a_usage.collector_b_usage
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
.cta_group = { .cta_group::1, .cta_group::2 }
.kind = { .kind::i8, .kind::ti16 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 7. Decompression of pre-compressed B matrix
tcgen05.mma.cta_group.kind::f8f6f4.decompress::lut::b{.collector_a_usage}{.collector_b_usage}
[d-tmem], a-desc, b-compressed-desc,
[b-decompress-metadata], idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::f8f6f4.decompress::lut::b{.collector_a_usage}{.collector_b_usage}
[d-tmem], [a-tmem], b-compressed-desc,
[b-decompress-metadata], idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.cta_group.kind::mxf8f6f4.block_scale.decompress::lut::b{.scale_vectorsize}{.collector_a_usage}{.collector_b_usage}
[d-tmem], a-desc, b-compressed-desc,
[b-decompress-metadata], idesc,
[scale-A-tmem], [scale-B-tmem],
enable-input-d;
tcgen05.mma.cta_group.kind::mxf8f6f4.block_scale.decompress::lut::b{.scale_vectorsize}{.collector_a_usage}{.collector_b_usage}
[d-tmem], [a-tmem], b-compressed-desc,
[b-decompress-metadata], idesc,
[scale-A-tmem], [scale-B-tmem],
enable-input-d;
.cta_group = { .cta_group::1, .cta_group::2 }
.scale_vectorsize = { .block32 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
说明
指令 tcgen05.mma 是一条异步指令,它发起一次 MxNxK 矩阵乘加运算 D = A*B+D,其中 A 矩阵为 MxK,B 矩阵为 KxN,D 矩阵为 MxN。
当输入谓词参数 enable-input-d 为假时,发出形式为 D = A*B 的运算。
可指定可选立即数参数 scale-input-d,按如下方式对输入矩阵 D 进行缩放:D = A*B+D * (2 ^ - scale-input-d)
参数 scale-input-d 的有效取值范围为 [0, 15]。参数 scale-input-d 仅对 .kind::tf32 与 .kind::f16 有效。
32 位寄存器操作数 idesc 是指令描述符(见 指令描述符),它指定了输入矩阵、输出矩阵以及矩阵乘加运算的形状、确切类型、稀疏性及其他细节。
限定符 .cta_group::1 指定该矩阵乘加运算仅在执行线程所属 CTA 的 Tensor Memory 上执行。限定符 .cta_group::2 指定该矩阵乘加运算在执行线程所属 CTA 及其 对等 CTA 的 Tensor Memory 上执行。
一个 kernel 内的所有 tcgen05 指令必须为 .cta_group 限定符指定相同的值。
与集合指令 mma.sync 或 wgmma.mma_async 不同,指令 tcgen05.mma 具有单线程语义。因此,由单个线程发出 tcgen05.mma 即可发起整个矩阵乘加运算。参见 发射粒度 一节。
限定符 .kind 指定被乘数矩阵元素类型的大类。每种 MMA 大类对应的输入矩阵与输出矩阵元素的确切类型在 指令描述符 中给出。
地址操作数 d-tmem 指定目标及累加矩阵 D 在 Tensor Memory 中的地址。地址操作数 a-tmem 指定矩阵 A 在 Tensor Memory 中的地址。64 位寄存器操作数 a-desc 与 b-desc 是矩阵描述符,分别表示共享内存中的矩阵 A 与 B。矩阵描述符的格式见 矩阵描述符。
对于带 .decompress::lut::b 限定符的指令,B 矩阵元素从 查找表 获得。64 位寄存器操作数 b-compressed-desc 是 B 矩阵的共享内存描述符,b-decompress-metadata 是存储在 Tensor Memory 中的查找表的双列对齐地址。从共享内存加载的数据为每个元素包含一个 3 位索引,用该索引访问查找表即可得到 8 位值。B 矩阵中同一 8 列对齐的 8 列切片内的每个元素共享同一组 8 个可选值。例如,查找表对 N 坐标为 0-7 的元素包含 8 个唯一值,对 N 坐标为 8-15 的元素包含另外 8 个唯一值,依此类推。当指定 .decompress::lut::b 时,矩阵 B 不支持转置,且唯一允许的类型是 E4M3。布局 B(M = 128 + cta_group::2 + 稠密 A 矩阵)、布局 C(M = 128 + cta_group::2 + 稀疏 A 矩阵) 与 布局 F(M = 64 + 非 .ws 模式) 不允许用于在 Tensor Memory 中存储查找表。
向量操作数 disable-output-lane 指定 Tensor Memory 中不应以结果矩阵 D 更新的 lane。向量操作数 disable-output-lane 的各元素构成一个掩码,其中每一位对应 Tensor Memory 的一个 lane,向量第一个元素(语法中最左侧)的最低有效位对应 Tensor Memory 的 lane 0。若掩码中的某一位为 1,则结果矩阵 D 对应的 Tensor Memory lane 将不被更新。向量的大小如下:
.cta_group |
向量 disable-output-lane 的大小 |
|---|---|
::1 |
4 |
::2 |
8 |
限定符 .block_scale 指定在执行矩阵乘加运算之前,矩阵 A 与 B 分别用 scale_A 与 scale_B 矩阵进行缩放,如 tcgen05.mma 的块缩放 一节所述。地址操作数 scale-A-tmem 与 scale-B-tmem 分别指定矩阵 scale_A 与 scale_B 在 Tensor Memory 中的基地址。
对于限定符 .scale_vectorsize,
若指定
.scale_vec::NX:N 指定scale_A矩阵的列数以及scale_B矩阵的行数。若指定
.blockN:N 指定应用单个缩放因子的块大小。在此形式下,N 的值等于 K 维 /(.scale_vec::NX的 N)。
别名 .scale_vectorsize 变体:
-
.block16与以下别名等价:当
.kind = .kind::mxf4nvf4且 K = 64 或 128 时,为.scale_vec::4X
-
.block32与以下别名等价:当
.kind = .kind::mxf8f6f4时,对所有受支持的 K 值,为.scale_vec::1X当
.kind = .kind::mxf4或.kind::mxf4nvf4且 K = 64 或 128 时,为.scale_vec::2X
MMA 大类与 .scale_vectorsize 的有效组合见 表 68。对于 .kind::mxf4,当未指定限定符 .scale_vectorsize 时,默认为 .block32。对于 .kind::mxf4nvf4,必须显式指定限定符 .scale_vectorsize。
限定符 .ashift 将 A 矩阵的各行下移一行,Tensor Memory 中的最后一行除外。限定符 .ashift 仅在 M = 128 或 M = 256 时允许使用。
限定符 .collector_a_usage 指定矩阵 A 对收集器缓冲区的使用方式。限定符 .collector_b_usage 指定矩阵 B 对收集器缓冲区的使用方式。可指定以下收集器缓冲区操作:
.collector_usage |
语义 |
|---|---|
|
从内存读取的指定矩阵应填充到收集器缓冲区中。 |
|
可从收集器缓冲区中读取指定矩阵。这要求此前对收集器缓冲区的填充仍然有效。 |
|
可从收集器缓冲区中读取指定矩阵,此后收集器缓冲区的内容即可被丢弃。这要求此前对收集器缓冲区的填充在读取该缓冲区之前一直保持有效。 |
|
指定矩阵对应的收集器缓冲区内容可被丢弃。 |
若未指定 .collector_a_usage 限定符,则默认为 .collector::a::discard。若未指定 .collector_b_usage 限定符,则默认为 .collector::b::discard。将 .collector::a::use 或 .collector::a::fill 中任一项与 .ashift 一起指定是非法的。
对于 .kind::mxf8f6f4 与 .kind::f8f6f4,当稠密 K=64、稀疏 K=128 时,共享内存中的矩阵 A 仅对 E5M2 与 E4M3 格式支持转置。
示例
tcgen05.mma.cta_group::1.kind::tf32 [taddr0], adesc, bdesc, idesc, {m0, m1, m2, m3}, p;
tcgen05.mma.cta_group::1.kind::mxf8f6f4 [taddr2], [taddr1], bdesc, idesc,
[tmem_scaleA], [tmem_scaleB], p;
tcgen05.commit.cta_group::1.mbarrier::arrive::one.b64 [mbarObj0];
loop:
mbarrier.try_wait.parity.b64 p, [mbarObj0], 0;
@!p bra loop;
9.7.18.10.10.2. TensorCore 第五代指令:tcgen05.mma.sp#
tcgen05.mma.sp
使用稀疏 A 矩阵执行第五代矩阵乘加运算。
语法
// 1. Floating-point type without block scaling:
tcgen05.mma.sp.cta_group.kind [d-tmem], a-desc, b-desc, [sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d{, scale-input-d};
tcgen05.mma.sp.cta_group.kind [d-tmem], [a-tmem], b-desc, [sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d{, scale-input-d};
.kind = { .kind::f16, , .kind::tf32, .kind::f8f6f4 }
.cta_group = { .cta_group::1, .cta_group::2 }
// 2. Floating-point type with block scaling:
tcgen05.mma.sp.cta_group.kind.block_scale{.scale_vectorsize}
[d-tmem], a-desc, b-desc , [sp-meta-tmem] , idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
tcgen05.mma.sp.cta_group.kind.block_scale{.scale_vectorsize}
[d-tmem], [a-tmem], b-desc , [sp-meta-tmem] , idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
.scale_vectorsize = { .scale_vec::1X, .scale_vec::2X, .scale_vec::4X, .block16, .block32 }
.cta_group = { .cta_group::1, .cta_group::2 }
.kind = { .kind::mxf8f6f4, .kind::mxf4, .kind::mxf4nvf4 }
// 3. Convolution MMA with floating-point type without block scaling:
tcgen05.mma.sp.cta_group.kind.collector_a_usage{.collector_b_usage} [d-tmem], a-desc, b-desc,
[sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d
{, scale-input-d};
tcgen05.mma.sp.cta_group.kind.ashift{.collector_a_usage}{.collector_b_usage} [d-tmem], [a-tmem], b-desc,
[sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d
{, scale-input-d};
tcgen05.mma.sp.cta_group.kind{.ashift}.collector_a_usage{.collector_b_usage} [d-tmem], [a-tmem], b-desc,
[sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d
{, scale-input-d};
.kind = { .kind::f16, .kind::tf32, .kind::f8f6f4 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 4. Activation Stationary MMA with floating-point type with block scaling:
tcgen05.mma.sp.cta_group.kind.block_scale{.scale_vectorsize}.collector_a_usage{.collector_b_usage}
[d-tmem], a-desc, b-desc , [sp-meta-tmem] , idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
tcgen05.mma.sp.cta_group.kind.block_scale{.scale_vectorsize}.collector_a_usage{.collector_b_usage}
[d-tmem], [a-tmem], b-desc , [sp-meta-tmem] , idesc,
[scale-A-tmem], [scale-B-tmem], enable-input-d;
.kind = { .kind::mxf8f6f4, .kind::mxf4, .kind::mxf4nvf4 }
.scale_vectorsize = { .scale_vec::1X, .scale_vec::2X, .scale_vec::4X, .block16, .block32 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 5. Integer type:
tcgen05.mma.sp.cta_group.kind [d-tmem], a-desc, b-desc, [sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind [d-tmem], [a-tmem], b-desc, [sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind::ti16.collector_b_usage
[d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind::ti16.collector_b_usage
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
.cta_group = { .cta_group::1, .cta_group::2 }
.kind = { .kind::i8, .kind::ti16 }
.collector_b_usage = { .collector::buffer::op }
::buffer = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
// 6. Convolution MMA with Integer type:
tcgen05.mma.sp.cta_group.kind.collector_a_usage [d-tmem], a-desc, b-desc,
[sp-meta-tmem] , idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind.ashift{.collector_a_usage} [d-tmem], [a-tmem], b-desc,
[sp-meta-tmem], idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind{.ashift}.collector_a_usage [d-tmem], [a-tmem], b-desc,
[sp-meta-tmem], idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind::ti16.collector_a_usage.collector_b_usage
[d-tmem], a-desc, b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind::ti16.ashift{.collector_a_usage}.collector_b_usage
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
tcgen05.mma.sp.cta_group.kind::ti16{.ashift}.collector_a_usage.collector_b_usage
[d-tmem], [a-tmem], b-desc, idesc,
{ disable-output-lane }, enable-input-d;
.cta_group = { .cta_group::1, .cta_group::2 }
.kind = { .kind::i8, .kind::ti16 }
.collector_a_usage = { .collector::buffer_a::op }
.collector_b_usage = { .collector::buffer_b::op }
::buffer_a = { ::a }
::buffer_b = { ::b }
::op = { ::fill, ::use, ::lastuse, ::discard* }
说明
指令 tcgen05.mma.sp 是一条异步指令,它发起一次形式为 D = A*B+D 的 MxNxK 矩阵乘加运算,其中 A 矩阵为 Mx(K/2),B 矩阵为 KxN,D 矩阵为 MxN。稀疏矩阵 一节描述了稀疏性的细节。
当输入谓词参数 enable-input-d 为假时,发出形式为 D = A*B 的运算。
可指定可选立即数参数 scale-input-d,按如下方式对输入矩阵 D 进行缩放:D = A*B+D * (2 ^ - scale-input-d)
参数 scale-input-d 的有效取值范围为 [0, 15]。参数 scale-input-d 仅对 .kind::tf32 与 .kind::f16 有效。
32 位寄存器操作数 idesc 是指令描述符(见 指令描述符),它指定了输入矩阵、输出矩阵以及矩阵乘加运算的形状、确切类型、稀疏性及其他细节。
限定符 .cta_group::1 指定该矩阵乘加运算仅在执行线程所属 CTA 的 Tensor Memory 上执行。限定符 .cta_group::2 指定该矩阵乘加运算在执行线程所属 CTA 及其 对等 CTA 的 Tensor Memory 上执行。
一个 kernel 内的所有 tcgen05 指令必须为 .cta_group 限定符指定相同的值。
与集合指令 mma.sync 或 wgmma.mma_async 不同,指令 tcgen05.mma.sp 具有单线程语义。因此,由单个线程发出 tcgen05.mma.sp 即可发起整个矩阵乘加运算。参见 发射粒度 一节。
限定符 .kind 指定被乘数矩阵元素类型的大类。每种 MMA 大类对应的输入矩阵与输出矩阵元素的确切类型在 指令描述符 中给出。
地址操作数 d-tmem 指定目标及累加矩阵 D 在 Tensor Memory 中的地址。地址操作数 a-tmem 指定矩阵 A 在 Tensor Memory 中的地址。64 位寄存器操作数 a-desc 与 b-desc 是矩阵描述符,分别表示共享内存中的矩阵 A 与 B。矩阵描述符的格式见 矩阵描述符。
向量操作数 disable-output-lane 指定 Tensor Memory 中不应以结果矩阵 D 更新的 lane。向量操作数 disable-output-lane 的各元素构成一个掩码,其中每一位对应 Tensor Memory 的一个 lane,向量第一个元素(语法中最左侧)的最低有效位对应 Tensor Memory 的 lane 0。若掩码中的某一位为 1,则结果矩阵 D 对应的 Tensor Memory lane 将不被更新。向量的大小如下:
.cta_group |
向量 disable-output-lane 的大小 |
|---|---|
::1 |
4 |
::2 |
8 |
限定符 .block_scale 指定在执行矩阵乘加运算之前,矩阵 A 与 B 分别用 scale_A 与 scale_B 矩阵进行缩放,如 tcgen05.mma 的块缩放 一节所述。地址操作数 scale-A-tmem 与 scale-B-tmem 分别指定矩阵 scale_A 与 scale_B 在 Tensor Memory 中的基地址。
对于限定符 .scale_vectorsize,
若指定
.scale_vec::NX:N 指定scale_A矩阵的列数以及scale_B矩阵的行数。若指定
.blockN:N 指定应用单个缩放因子的块大小。在此形式下,N 的值等于 K 维 /(.scale_vec::NX的 N)。
别名 .scale_vectorsize 变体:
-
.block16与以下别名等价:当
.kind = .kind::mxf4nvf4且 K = 64 或 128 时,为.scale_vec::4X
-
.block32与以下别名等价:当
.kind = .kind::mxf8f6f4时,对所有受支持的 K 值,为.scale_vec::1X当
.kind = .kind::mxf4或.kind::mxf4nvf4且 K = 64 或 128 时,为.scale_vec::2X
MMA 大类与 .scale_vectorsize 的有效组合见 表 68。对于 .kind::mxf4,当未指定限定符 .scale_vectorsize 时,默认为 .block32。对于 .kind::mxf4nvf4,必须显式指定限定符 .scale_vectorsize。
限定符 .ashift 将 A 矩阵的各行下移一行,Tensor Memory 中的最后一行除外。限定符 .ashift 仅在 M = 128 或 M = 256 时允许使用。
限定符 .collector_a_usage 指定矩阵 A 对收集器缓冲区的使用方式。限定符 .collector_b_usage 指定矩阵 B 对收集器缓冲区的使用方式。可指定以下收集器缓冲区操作:
.collector_usage |
语义 |
|---|---|
|
从内存读取的指定矩阵应填充到收集器缓冲区中。 |
|
可从收集器缓冲区中读取指定矩阵。这要求此前对收集器缓冲区的填充仍然有效。 |
|
可从收集器缓冲区中读取指定矩阵,此后收集器缓冲区的内容即可被丢弃。这要求此前对收集器缓冲区的填充在读取该缓冲区之前一直保持有效。 |
|
指定矩阵对应的收集器缓冲区内容可被丢弃。 |
若未指定 .collector_a_usage 限定符,则默认为 .collector::a::discard。若未指定 .collector_b_usage 限定符,则默认为 .collector::b::discard。将 .collector::a::use 或 .collector::a::fill 中任一项与 .ashift 一起指定是非法的。
示例
tcgen05.mma.sp.cta_group::1.kind::f16 [taddr0], adesc, bdesc, [tmem_spmeta0], idesc, p;
tcgen05.mma.sp.cta_group::1.kind::mxf8f6f4.collector::a:fill
[taddr2], [taddr1], bdesc, [tmem_spmeta1], idesc,
[tmem_scaleA], [tmem_scaleB], p;
tcgen05.commit.cta_group::1.mbarrier::arrive::one.b64 [mbarObj0];
loop:
mbarrier.try_wait.parity.b64 p, [mbarObj0], 0;
@!p bra loop;
9.7.18.10.10.3. TensorCore 第五代指令:tcgen05.mma.ws#
tcgen05.mma.ws
执行第五代权重固定(weight stationary)卷积矩阵乘加运算。
语法
// 1. Floating-point type without block scaling:
tcgen05.mma.ws.cta_group::1.kind{.collector_usage} [d-tmem], a-desc, b-desc, idesc,
enable-input-d {, zero-column-mask-desc };
tcgen05.mma.ws.cta_group::1.kind{.collector_usage} [d-tmem], [a-tmem], b-desc, idesc,
enable-input-d {, zero-column-mask-desc };
.kind = { .kind::f16, .kind::tf32, .kind::f8f6f4 }
// 2. Integer type:
tcgen05.mma.ws.cta_group::1.kind{.collector_usage} [d-tmem], a-desc, b-desc, idesc,
enable-input-d {, zero-column-mask-desc};
tcgen05.mma.ws.cta_group::1.kind{.collector_usage} [d-tmem], [a-tmem], b-desc, idesc,
enable-input-d {, zero-column-mask-desc};
.collector_usage = { .collector::buffer::op }
.kind = { .kind::i8, .kind::ti16 }
::buffer = { ::b0, ::b1, ::b2, ::b3 }
::op = { ::fill, ::use, ::lastuse, ::discard}
说明
指令 tcgen05.mma.ws 是一条异步指令,它发起一次 MxNxK 矩阵乘加运算 D = A*B+D,其中 A 矩阵为 MxK,B 矩阵为 KxN,D 矩阵为 MxN。
当输入谓词参数 enable-input-d 为假时,发出形式为 D = A*B 的运算。
32 位寄存器操作数 idesc 是指令描述符(见 指令描述符),它指定了输入矩阵、输出矩阵以及矩阵乘加运算的形状、确切类型、稀疏性及其他细节。
限定符 .cta_group::1 指定该矩阵乘加运算仅在执行线程所属 CTA 的 Tensor Memory 上执行。
一个 kernel 内的所有 tcgen05 指令必须为 .cta_group 限定符指定相同的值。
与集合指令 mma.sync 或 wgmma.mma_async 不同,指令 tcgen05.mma.ws 具有单线程语义。因此,由单个线程发出 tcgen05.mma.ws 即可发起整个矩阵乘加运算。参见 发射粒度 一节。
限定符 .kind 指定被乘数矩阵元素类型的大类。每种 MMA 大类对应的输入矩阵与输出矩阵元素的确切类型在 指令描述符 中给出。
地址操作数 d-tmem 指定目标及累加矩阵 D 在 Tensor Memory 中的地址。地址操作数 a-tmem 指定矩阵 A 在 Tensor Memory 中的地址。64 位寄存器操作数 a-desc 与 b-desc 是矩阵描述符,分别表示共享内存中的矩阵 A 与 B。矩阵描述符的格式见 矩阵描述符。
可选操作数 zero-column-mask-desc 是一个 64 位寄存器,用于指定 零列掩码描述符。零列掩码描述符用于生成一个掩码,该掩码指定矩阵乘加运算中 B 矩阵的哪些列将取零值,而不管共享内存中实际存放的值为何。
限定符 .collector_usage 指定矩阵 B 对收集器缓冲区的使用方式。可指定以下收集器缓冲区操作:
.collector_usage |
语义 |
|---|---|
|
指定从内存读取的 |
|
指定可从收集器缓冲区 #N 中读取 |
|
指定可从收集器缓冲区 #N 中读取 |
|
指定收集器缓冲区 #N 的内容可被丢弃。 |
若未指定 .collector_usage 限定符,则默认为 .collector::b0::discard。
示例
tcgen05.mma.ws.cta_group::1.kind::i8.collector::b2:use [taddr2], [taddr1], bdesc, idesc, p;
tcgen05.commit.cta_group::1.mbarrier::arrive::one.b64 [mbarObj0];
loop:
mbarrier.try_wait.parity.b64 p, [mbarObj0], 0;
@!p bra loop;
9.7.18.10.10.4. TensorCore 第五代指令:tcgen05.mma.ws.sp#
tcgen05.mma.ws.sp
使用稀疏 A 矩阵执行第五代权重固定(weight stationary)卷积矩阵乘加运算。
语法
// 1. Floating-point type without block scaling:
tcgen05.mma.ws.sp.cta_group::1.kind{.collector_usage} [d-tmem], a-desc, b-desc,
[sp-meta-tmem] , idesc,
enable-input-d {, zero-column-mask-desc};
tcgen05.mma.ws.sp.cta_group::1.kind{.collector_usage} [d-tmem], [a-tmem], b-desc,
[sp-meta-tmem] , idesc,
enable-input-d {, zero-column-mask-desc};
.kind = { .kind::f16, .kind::tf32, .kind::f8f6f4 }
// 2. Integer type:
tcgen05.mma.ws.sp.cta_group::1.kind{.collector_usage} [d-tmem], a-desc, b-desc,
[sp-meta-tmem] , idesc,
enable-input-d {, zero-column-mask-desc};
tcgen05.mma.ws.sp.cta_group::1.kind{.collector_usage} [d-tmem], [a-tmem], b-desc,
[sp-meta-tmem] , idesc,
enable-input-d {, zero-column-mask-desc};
.collector_usage = { .collector::buffer::op }
.kind = { .kind::i8, .kind::ti16 }
::buffer = { ::b0, ::b1, ::b2, ::b3 }
::op = { ::fill, ::use, ::lastuse, ::discard }
说明
指令 tcgen05.mma.ws.sp 是一条异步指令,它发起一次 MxNxK 矩阵乘加运算 D = A*B+D,其中 A 矩阵为 Mx(K/2),B 矩阵为 KxN,D 矩阵为 MxN。稀疏矩阵 一节描述了稀疏性的细节。
当输入谓词参数 enable-input-d 为假时,发出形式为 D = A*B 的运算。
32 位寄存器操作数 idesc 是指令描述符(见 指令描述符),它指定了输入矩阵、输出矩阵以及矩阵乘加运算的形状、确切类型、稀疏性及其他细节。
限定符 .cta_group::1 指定该矩阵乘加运算仅在执行线程所属 CTA 的 Tensor Memory 上执行。
一个 kernel 内的所有 tcgen05 指令必须为 .cta_group 限定符指定相同的值。
与集合指令 mma.sync 或 wgmma.mma_async 不同,指令 tcgen05.mma.ws.sp 具有单线程语义。因此,由单个线程发出 tcgen05.mma.ws.sp 即可发起整个矩阵乘加运算。参见 发射粒度 一节。
限定符 .kind 指定被乘数矩阵元素类型的大类。每种 MMA 大类对应的输入矩阵与输出矩阵元素的确切类型在 指令描述符 中给出。
地址操作数 d-tmem 指定目标及累加矩阵 D 在 Tensor Memory 中的地址。地址操作数 a-tmem 指定矩阵 A 在 Tensor Memory 中的地址。64 位寄存器操作数 a-desc 与 b-desc 是矩阵描述符,分别表示共享内存中的矩阵 A 与 B。矩阵描述符的格式见 矩阵描述符。
可选操作数 zero-column-mask-desc 是一个 64 位寄存器,用于指定 零列掩码描述符。零列掩码描述符用于生成一个掩码,该掩码指定矩阵乘加运算中 B 矩阵的哪些列将取零值,而不管共享内存中实际存放的值为何。
限定符 .collector_usage 指定矩阵 B 对收集器缓冲区的使用方式。可指定以下收集器缓冲区操作:
.collector_usage |
语义 |
|---|---|
|
指定从内存读取的 |
|
指定可从收集器缓冲区 #N 中读取 |
|
指定可从收集器缓冲区 #N 中读取 |
|
指定收集器缓冲区 #N 的内容可被丢弃。 |
若未指定 .collector_usage 限定符,则默认为 .collector::b0::discard。
示例
tcgen05.mma.ws.sp.cta_group::1.kind::tf32.collector::b1::fill [taddr1], [taddr0], bdesc,
[tmem_spmeta0], idesc, p;
tcgen05.commit.cta_group::1.mbarrier::arrive::one.b64 [mbarObj0];
loop:
mbarrier.try_wait.parity.b64 p, [mbarObj0], 0;
@!p bra loop;
9.7.18.11. TensorCore 第五代专用同步操作#
9.7.18.11.1. TensorCore 第五代指令:tcgen05.fence#
tcgen05.fence
用于异步 tcgen05 操作的专用栅栏。
语法
tcgen05.fence::before_thread_sync ;
tcgen05.fence::after_thread_sync ;
说明
指令 tcgen05.fence::before_thread_sync 将此前所有异步 tcgen05 操作相对于其后的 tcgen05 操作以及执行排序操作进行排序。
指令 tcgen05.fence::after_thread_sync 将此后所有异步 tcgen05 操作相对于此前的 tcgen05 操作以及执行排序操作进行排序。
tcgen05.fence::* 指令在某一线程作用域内与执行排序指令组合使用,并在同一作用域内的各 tcgen05 指令之间提供排序。
tcgen05.fence::before_thread_sync 指令对其之前的 tcgen05 指令起到代码移动栅栏的作用,因为这些指令不能被上移越过它。tcgen05.fence::after_thread_sync 指令对其之后的 tcgen05 指令起到代码移动栅栏的作用,因为这些指令不能被上移越过它。
示例
// Producer thread:
tcgen05.cp.cta_group::1.128x256b [taddr0], sdesc0;
tcgen05.fence::before_thread_sync;
st.relaxed.b32 [flag], 1;
// Consumer thread:
loop:
ld.relaxed.b32 r, [flag];
setp.eq.u32 p, r, 1;
@!p bra loop;
tcgen05.fence::after_thread_sync;
tcgen05.mma.cta_group.kind [taddr0], adesc, bdesc, idesc, p;
9.7.18.12. TensorCore 第五代异步同步操作#
9.7.18.12.1. TensorCore 第五代指令:tcgen05.commit#
tcgen05.commit
使 mbarrier 对象跟踪由执行线程发起的所有先前异步 tcgen05 操作的完成情况。
语法
tcgen05.commit.cta_group.completion_mechanism{.shared::cluster}{.multicast}.b64
[mbar] {, ctaMask};
tcgen05.commit.cta_group.completion_mechanism.sync_restrict::shared::read::mma::a{.shared::cluster}{.multicast}.b64
[mbar] {, ctaMask};
.completion_mechanism = { .mbarrier::arrive::one }
.cta_group = { .cta_group::1, .cta_group::2 }
.multicast = { .multicast::cluster{::16b, ::32b} }
说明
指令 tcgen05.commit 是一条异步指令,它使由地址操作数 mbar 指定的 mbarrier 对象跟踪由执行线程发起的所有先前异步 tcgen05 操作(如基于 mbarrier 的完成机制中所列)的完成情况。在所跟踪的异步 tcgen05 操作完成后,由 .completion_mechanism 指定的信号由系统在该 mbarrier 对象上触发。该指令使用 generic-proxy 访问其 mbarrier 操作数。
指令 tcgen05.commit.cta_group::1 跟踪由当前线程发出的所有带有 .cta_group::1 的先前异步 tcgen05 操作的完成情况。类似地,指令 tcgen05.commit.cta_group::2 跟踪由当前线程发出的所有带有 .cta_group::2 的先前异步 tcgen05 操作的完成情况。
一个 kernel 中的所有 tcgen05 指令都必须为 .cta_group 限定符指定相同的值。
限定符 .mbarrier::arrive::one 表示:在当前线程发出的先前异步 tcgen05 操作完成后,会在 mbarrier 对象上传送一个计数参数为 1 的 arrive-on 操作。该 arrive-on 操作的作用域为 cluster 作用域。
可选限定符 .multicast::cluster 允许在 cluster 中多个 CTA 的 mbarrier 对象上传送信号。操作数 ctaMask 指定 cluster 中的 CTA,使得 16 位或 32 位 ctaMask 操作数中的每一个位位置都对应于目标 CTA 的 %cluster_ctarank。可以指定附加子限定符 ::16b 或 ::32b,以对应 ctaMask 实参的宽度。默认情况下,ctaMask 假定为 16 位宽度。mbarrier 信号会被多播到每个目标 CTA 的共享内存中与 mbar 相同的偏移处。
如果未指定状态空间,则使用通用寻址。如果由 mbar 指定的地址不落在 .shared::cluster 状态空间的地址窗口内,则行为未定义。
带有 .sync_restrict::shared::read::mma::a 的 tcgen05.commit 操作,在所有先前 tcgen05.mma 操作从共享内存读完 A 矩阵后,在该 barrier 上执行一次arrive-on操作。这并不表示任何先前 tcgen05.mma 操作的整体完成。
示例
Example 1:
tcgen05.cp.cta_group::1.128x256b [taddr0], sdesc0;
tcgen05.commit.cta_group::1.mbarrier::arrive::one.b64 [mbarObj1];
loop:
mbarrier.try_wait.parity.b64 p, [mbarObj1], 0;
@!p bra loop;
Example 2:
tcgen05.mma.cta_group::2.kind::tf32 [taddr0], adesc, bdesc, idesc, p;
tcgen05.commit.shared::cluster.multicast::cluster::32b.cta_group::2.mbarrier::arrive::one.b64 [mbarObj2];
loop:
mbarrier.try_wait.parity.b64 p, [mbarObj2], 0;
@!p bra loop;
// Example 3:
tcgen05.mma.cta_group::2.kind::tf32 [taddr0], adesc, bdesc, idesc, p;
tcgen05.mma.cta_group::2.kind::tf32 [taddr1], adesc1, bdesc1, idesc1, p1;
tcgen05.commit.cta_group::2.mbarrier::arrive::one.sync_restrict::shared::read::mma::a.b64 [mbarObj2];
9.7.19. 栈操作指令#
栈操作指令可在当前函数的栈帧上动态分配和释放内存。
栈操作指令包括:
stacksavestackrestorealloca
9.7.19.1. 栈操作指令:stacksave#
stacksave
将当前栈指针的值保存到寄存器。
语法
stacksave.type d;
.type = { .u32, .u64 };
说明
该指令把当前栈指针复制到目标寄存器 d。之后可将该值作为 stackrestore 的操作数,以恢复栈指针。如果在恢复之前修改了 d,可能破坏栈中的数据。
目标操作数 d 的类型必须与指令类型相同。
语义
d = stackptr;
示例
.reg .u32 rd;
stacksave.u32 rd;
.reg .u64 rd1;
stacksave.u64 rd1;
9.7.19.2. 栈操作指令:stackrestore#
stackrestore
用新值更新栈指针。
语法
stackrestore.type a;
.type = { .u32, .u64 };
说明
该指令将当前栈指针设为源寄存器 a 的值。
如果 a 保存的是先前 stacksave 写入的值,执行后即可恢复到保存时的栈状态。若将任意值用作 a,可能破坏栈指针。正确用法是在 stacksave.type a 之后执行 stackrestore.type a,并且两条指令之间不得重新定义 a。
操作数 a 的类型必须与指令类型相同。
语义
stackptr = a;
示例
.reg .u32 ra;
stacksave.u32 ra;
// Code that may modify stack pointer
...
stackrestore.u32 ra;
9.7.19.3. 栈操作指令:alloca#
alloca
在栈上动态分配内存。
语法
alloca.type ptr, size{, immAlign};
.type = { .u32, .u64 };
说明
该指令在当前函数的栈帧上动态分配内存,并相应更新栈指针。返回的指针 ptr 指向局部内存,可用于 ld.local 和 st.local 指令的地址操作数。
如果栈上没有足够空间,执行 alloca 可能导致栈溢出;此时再通过 ptr 访问所分配的内存会产生未定义行为。
alloca 分配的内存按以下方式释放:
函数退出时会自动释放。
也可以使用
stacksave和stackrestore指令显式释放:可在执行alloca之前用stacksave保存栈指针的值,并在alloca之后用stackrestore将栈指针恢复到先前用stacksave保存的原值。注意,执行stackrestore后再访问已释放的内存会导致未定义行为。
size 是无符号值,表示要在栈上分配的字节数。size = 0 不一定会得到有效的内存分配。
ptr 与 size 的类型都必须与指令类型相同。
immAlign 是 32 位整数常量,指定分配内存所需的字节对齐。它必须是 2 的幂,且不得大于 2^23。省略时默认值为 8 字节,这是保证的最小对齐值。
语义
alloca.type ptr, size, immAlign:
a = max(immAlign, frame_align); // frame_align is the minimum guaranteed alignment
// Allocate size bytes of stack memory with alignment a and update the stack pointer.
// Since the stack grows down, the updated stack pointer contains a lower address.
stackptr = alloc_stack_mem(size, a);
// Return the new value of stack pointer as ptr. Since ptr is the lowest address of the memory
// allocated by alloca, the memory can be accessed using ptr up to (ptr + size of allocated memory).
stacksave ptr;
示例
.reg .u32 ra, stackptr, ptr, size;
stacksave.u32 stackptr; // Save the current stack pointer
alloca ptr, size, 8; // Allocate stack memory
st.local.u32 [ptr], ra; // Use the allocated stack memory
stackrestore.u32 stackptr; // Deallocate memory by restoring the stack pointer
9.7.20. 视频指令#
所有视频指令都对 32 位寄存器操作数进行操作。不过,视频指令可以根据其核心运算作用于单个值还是多个值而分为标量或 SIMD 两类。
视频指令包括:
vadd,vadd2,vadd4vsub,vsub2,vsub4vmadvavrg2,vavrg4vabsdiff,vabsdiff2,vabsdiff4vmin,vmin2,vmin4vmax,vmax2,vmax4vshlvshrvset,vset2,vset4
9.7.20.1. 标量视频指令#
所有标量视频指令都对 32 位寄存器操作数进行操作。标量视频指令包括:
vaddvsubvabsdiffvminvmaxvshlvshrvmadvset
标量视频指令执行以下几个阶段:
从源操作数中提取字节、半字或字的值,并对其进行符号扩展或零扩展,以产生有符号的 33 位输入值。
执行一次标量算术运算,产生一个有符号的 34 位结果。
可选地将结果钳制到目标类型的取值范围内。
-
可选地执行下列操作之一:
对中间结果与第三个操作数再施加一次运算,或
把中间结果截断为字节或半字值,并合并到第三个操作数中的指定位置,以产生最终结果。
标量视频指令的通用格式如下:
// 32-bit scalar operation, with optional secondary operation
vop.dtype.atype.btype{.sat} d, a{.asel}, b{.bsel};
vop.dtype.atype.btype{.sat}.secop d, a{.asel}, b{.bsel}, c;
// 32-bit scalar operation, with optional data merge
vop.dtype.atype.btype{.sat} d.dsel, a{.asel}, b{.bsel}, c;
.dtype = .atype = .btype = { .u32, .s32 };
.dsel = .asel = .bsel = { .b0, .b1, .b2, .b3, .h0, .h1 };
.secop = { .add, .min, .max };
源操作数与目标操作数均为 32 位寄存器。每个操作数的类型(.u32 或 .s32)由指令类型指明;dtype、atype 与 btype 的所有组合都是合法的。借助 atype/btype 与 asel/bsel 说明符,输入值在内部被提取并符号扩展或零扩展为 .s33 值。随后执行主运算,产生一个 .s34 中间结果。中间结果的符号取决于 dtype。
中间结果可选地被钳制到目标类型(有符号或无符号)的取值范围内;在存在可选数据合并的情况下,还会把目标子字的大小考虑在内。
.s33 optSaturate( .s34 tmp, Bool sat, Bool sign, Modifier dsel ) {
if ( !sat ) return tmp;
switch ( dsel ) {
case .b0, .b1, .b2, .b3:
if ( sign ) return CLAMP( tmp, S8_MAX, S8_MIN );
else return CLAMP( tmp, U8_MAX, U8_MIN );
case .h0, .h1:
if ( sign ) return CLAMP( tmp, S16_MAX, S16_MIN );
else return CLAMP( tmp, U16_MAX, U16_MIN );
default:
if ( sign ) return CLAMP( tmp, S32_MAX, S32_MIN );
else return CLAMP( tmp, U32_MAX, U32_MIN );
}
plaintext
}
随后,该中间结果可选地通过一次二级算术运算或子字数据合并与第三个源操作数相结合,如下面的伪代码所示。第三个操作数的符号取决于 dtype。
.s33 optSecOp(Modifier secop, .s33 tmp, .s33 c) {
switch ( secop ) {
.add: return tmp + c;
.min: return MIN(tmp, c);
.max return MAX(tmp, c);
default: return tmp;
}
}
.s33 optMerge( Modifier dsel, .s33 tmp, .s33 c ) {
switch ( dsel ) {
case .h0: return ((tmp & 0xffff) | (0xffff0000 & c);
case .h1: return ((tmp & 0xffff) << 16) | (0x0000ffff & c);
case .b0: return ((tmp & 0xff) | (0xffffff00 & c);
case .b1: return ((tmp & 0xff) << 8) | (0xffff00ff & c);
case .b2: return ((tmp & 0xff) << 16) | (0xff00ffff & c);
case .b3: return ((tmp & 0xff) << 24) | (0x00ffffff & c);
default: return tmp;
}
}
随后,低 32 位被写入目标操作数。
9.7.20.1.1. 标量视频指令:vadd , vsub , vabsdiff , vmin , vmax#
vadd, vsub
整数字节/半字/字加法/减法。
vabsdiff
整数字节/半字/字差值的绝对值。
vmin, vmax
整数字节/半字/字最小值/最大值。
语法
// 32-bit scalar operation, with optional secondary operation
vop.dtype.atype.btype{.sat} d, a{.asel}, b{.bsel};
vop.dtype.atype.btype{.sat}.op2 d, a{.asel}, b{.bsel}, c;
// 32-bit scalar operation, with optional data merge
vop.dtype.atype.btype{.sat} d.dsel, a{.asel}, b{.bsel}, c;
vop = { vadd, vsub, vabsdiff, vmin, vmax };
.dtype = .atype = .btype = { .u32, .s32 };
.dsel = .asel = .bsel = { .b0, .b1, .b2, .b3, .h0, .h1 };
.op2 = { .add, .min, .max };
说明
执行标量算术运算,带可选饱和,以及可选的二级算术运算或子字数据合并。
语义
// extract byte/half-word/word and sign- or zero-extend
// based on source operand type
ta = partSelectSignExtend( a, atype, asel );
tb = partSelectSignExtend( b, btype, bsel );
switch ( vop ) {
case vadd: tmp = ta + tb;
case vsub: tmp = ta - tb;
case vabsdiff: tmp = | ta - tb |;
case vmin: tmp = MIN( ta, tb );
case vmax: tmp = MAX( ta, tb );
}
// saturate, taking into account destination type and merge operations
tmp = optSaturate( tmp, sat, isSigned(dtype), dsel );
d = optSecondaryOp( op2, tmp, c ); // optional secondary operation
d = optMerge( dsel, tmp, c ); // optional merge with c operand
示例
vadd.s32.u32.s32.sat r1, r2.b0, r3.h0;
vsub.s32.s32.u32.sat r1, r2.h1, r3.h1;
vabsdiff.s32.s32.s32.sat r1.h0, r2.b0, r3.b2, c;
vmin.s32.s32.s32.sat.add r1, r2, r3, c;
9.7.20.1.2. 标量视频指令:vshl , vshr#
vshl, vshr
整数字节/半字/字左移/右移。
语法
// 32-bit scalar operation, with optional secondary operation
vop.dtype.atype.u32{.sat}.mode d, a{.asel}, b{.bsel};
vop.dtype.atype.u32{.sat}.mode.op2 d, a{.asel}, b{.bsel}, c;
// 32-bit scalar operation, with optional data merge
vop.dtype.atype.u32{.sat}.mode d.dsel, a{.asel}, b{.bsel}, c;
vop = { vshl, vshr };
.dtype = .atype = { .u32, .s32 };
.mode = { .clamp, .wrap };
.dsel = .asel = .bsel = { .b0, .b1, .b2, .b3, .h0, .h1 };
.op2 = { .add, .min, .max };
说明
vshl-
把
a按b中的无符号量左移,带可选饱和,以及可选的二级算术运算或子字数据合并。左移以零填充。 vshr-
把
a按b中的无符号量右移,带可选饱和,以及可选的二级算术运算或子字数据合并。有符号移位以符号位填充,无符号移位以零填充。
语义
// extract byte/half-word/word and sign- or zero-extend
// based on source operand type
ta = partSelectSignExtend( a,atype, asel );
tb = partSelectSignExtend( b, .u32, bsel );
if ( mode == .clamp && tb > 32 ) tb = 32;
if ( mode == .wrap ) tb = tb & 0x1f;
switch ( vop ){
case vshl: tmp = ta << tb;
case vshr: tmp = ta >> tb;
}
// saturate, taking into account destination type and merge operations
tmp = optSaturate( tmp, sat, isSigned(dtype), dsel );
d = optSecondaryOp( op2, tmp, c ); // optional secondary operation
d = optMerge( dsel, tmp, c ); // optional merge with c operand
示例
vshl.s32.u32.u32.clamp r1, r2, r3;
vshr.u32.u32.u32.wrap r1, r2, r3.h1;
9.7.20.1.3. 标量视频指令:vmad#
vmad
整数字节/半字/字乘加。
语法
// 32-bit scalar operation
vmad.dtype.atype.btype{.sat}{.scale} d, {-}a{.asel}, {-}b{.bsel},
{-}c;
vmad.dtype.atype.btype.po{.sat}{.scale} d, a{.asel}, b{.bsel}, c;
.dtype = .atype = .btype = { .u32, .s32 };
.asel = .bsel = { .b0, .b1, .b2, .b3, .h0, .h1 };
.scale = { .shr7, .shr15 };
说明
计算 (a*b) + c,带可选的操作数取负、加一模式以及缩放。
源操作数支持可选的取负,但有一些限制。尽管 PTX 语法允许对 a 和 b 操作数分别取负,但在内部这被表示为对乘积 (a*b) 取负。也就是说,当且仅当 a 与 b 中恰好有一个被取负时,(a*b) 才被取负。PTX 允许对 (a*b) 或 c 取负。
加一模式(.po)计算 (a*b) + c + 1,用于计算平均值。在 .po 模式下源操作数不可取负。
若 atype 与 btype 均为无符号,且乘积 (a*b) 未被取负,则 (a*b) 的中间结果为无符号;否则中间结果为有符号。输入 c 与中间结果的符号相同。
若中间结果为无符号且 c 未被取负,则最终结果为无符号。
根据 a 与 b 操作数的符号以及操作数取负情况,VMAD 支持下列操作数组合:
(u32 * u32) + u32 // intermediate unsigned; final unsigned
-(u32 * u32) + s32 // intermediate signed; final signed
(u32 * u32) - u32 // intermediate unsigned; final signed
(u32 * s32) + s32 // intermediate signed; final signed
-(u32 * s32) + s32 // intermediate signed; final signed
(u32 * s32) - s32 // intermediate signed; final signed
(s32 * u32) + s32 // intermediate signed; final signed
-(s32 * u32) + s32 // intermediate signed; final signed
(s32 * u32) - s32 // intermediate signed; final signed
(s32 * s32) + s32 // intermediate signed; final signed
-(s32 * s32) + s32 // intermediate signed; final signed
(s32 * s32) - s32 // intermediate signed; final signed
中间结果可选地通过右移进行缩放;若最终结果为有符号,则该结果被符号扩展,否则被零扩展。
最终结果可选地按最终结果的类型(有符号或无符号)饱和到相应的 32 位范围。
语义
// extract byte/half-word/word and sign- or zero-extend
// based on source operand type
ta = partSelectSignExtend( a, atype, asel );
tb = partSelectSignExtend( b, btype, bsel );
signedFinal = isSigned(atype) || isSigned(btype) ||
(a.negate ^ b.negate) || c.negate;
tmp[127:0] = ta * tb;
lsb = 0;
if ( .po ) { lsb = 1; } else
if ( a.negate ^ b.negate ) { tmp = ~tmp; lsb = 1; } else
if ( c.negate ) { c = ~c; lsb = 1; }
c128[127:0] = (signedFinal) sext32( c ) : zext ( c );
tmp = tmp + c128 + lsb;
switch( scale ) {
case .shr7: result = (tmp >> 7) & 0xffffffffffffffff;
case .shr15: result = (tmp >> 15) & 0xffffffffffffffff;
}
if ( .sat ) {
if (signedFinal) result = CLAMP(result, S32_MAX, S32_MIN);
else result = CLAMP(result, U32_MAX, U32_MIN);
}
示例
vmad.s32.s32.u32.sat r0, r1, r2, -r3;
vmad.u32.u32.u32.shr15 r0, r1.h0, r2.h0, r3;
9.7.20.1.4. 标量视频指令:vset#
vset
整数字节/半字/字比较。
语法
// 32-bit scalar operation, with optional secondary operation
vset.atype.btype.cmp d, a{.asel}, b{.bsel};
vset.atype.btype.cmp.op2 d, a{.asel}, b{.bsel}, c;
// 32-bit scalar operation, with optional data merge
vset.atype.btype.cmp d.dsel, a{.asel}, b{.bsel}, c;
.atype = .btype = { .u32, .s32 };
.cmp = { .eq, .ne, .lt, .le, .gt, .ge };
.dsel = .asel = .bsel = { .b0, .b1, .b2, .b3, .h0, .h1 };
.op2 = { .add, .min, .max };
说明
使用指定的比较对输入值进行比较,带可选的二级算术运算或子字数据合并。
比较的中间结果始终为无符号,因此目标操作数 d 与操作数 c 也为无符号。
语义
// extract byte/half-word/word and sign- or zero-extend
// based on source operand type
ta = partSelectSignExtend( a, atype, asel );
tb = partSelectSignExtend( b, btype, bsel );
tmp = compare( ta, tb, cmp ) ? 1 : 0;
d = optSecondaryOp( op2, tmp, c ); // optional secondary operation
d = optMerge( dsel, tmp, c ); // optional merge with c operand
示例
vset.s32.u32.lt r1, r2, r3;
vset.u32.u32.ne r1, r2, r3.h1;
9.7.20.2. SIMD 视频指令#
SIMD 视频指令对成对的 16 位值和由四个 8 位值构成的组进行操作。
SIMD 视频指令包括:
vadd2,vadd4vsub2,vsub4vavrg2,vavrg4vabsdiff2,vabsdiff4vmin2,vmin4vmax2,vmax4vset2,vset4
PTX 包含用于对成对的 16 位值和由四个 8 位值构成的组进行操作的 SIMD 视频指令。SIMD 视频指令执行以下几个阶段:
通过从源操作数中提取字节或半字值并进行符号扩展或零扩展来构成输入向量,以形成成对的 17 位有符号值。
对输入对执行一次 SIMD 算术运算。
可选地把结果钳制到由目标类型确定的相应有符号或无符号范围。
-
可选地执行下列操作之一:
执行一次二级 SIMD 合并运算,或
施加一次标量累加运算,把中间 SIMD 结果归约为单个标量。
双半字 SIMD 视频指令的通用格式如下:
// 2-way SIMD operation, with second SIMD merge or accumulate
vop2.dtype.atype.btype{.sat}{.add} d{.mask}, a{.asel}, b{.bsel}, c;
.dtype = .atype = .btype = { .u32, .s32 };
.mask = { .h0, .h1, .h10 };
.asel = .bsel = { .hxy, where x,y are from { 0, 1, 2, 3 } };
四字节 SIMD 视频指令的通用格式如下:
// 4-way SIMD operation, with second SIMD merge or accumulate
vop4.dtype.atype.btype{.sat}{.add} d{.mask}, a{.asel}, b{.bsel}, c;
.dtype = .atype = .btype = { .u32, .s32 };
.mask = { .b0,
.b1, .b10
.b2, .b20, .b21, .b210,
.b3, .b30, .b31, .b310, .b32, .b320, .b321, .b3210 };
.asel = .bsel = .bxyzw, where x,y,z,w are from { 0, …, 7 };
源操作数与目标操作数均为 32 位寄存器。每个操作数的类型(.u32 或 .s32)由指令类型指明;dtype、atype 与 btype 的所有组合都是合法的。借助 atype/btype 与 asel/bsel 说明符,输入值在内部被提取并符号扩展或零扩展为 .s33 值。随后执行主运算,产生一个 .s34 中间结果。中间结果的符号取决于 dtype。
中间结果可选地被钳制到目标类型(有符号或无符号)的取值范围内;在存在可选数据合并的情况下,还会把目标子字的大小考虑在内。
9.7.20.2.1. SIMD 视频指令:vadd2 , vsub2 , vavrg2 , vabsdiff2 , vmin2 , vmax2#
vadd2, vsub2
整数双半字 SIMD 加法/减法。
vavrg2
整数双半字 SIMD 平均值。
vabsdiff2
整数双半字 SIMD 差值的绝对值。
vmin2, vmax2
整数双半字 SIMD 最小值/最大值。
语法
// SIMD instruction with secondary SIMD merge operation
vop2.dtype.atype.btype{.sat} d{.mask}, a{.asel}, b{.bsel}, c;
// SIMD instruction with secondary accumulate operation
vop2.dtype.atype.btype.add d{.mask}, a{.asel}, b{.bsel}, c;
vop2 = { vadd2, vsub2, vavrg2, vabsdiff2, vmin2, vmax2 };
.dtype = .atype = .btype = { .u32, .s32 };
.mask = { .h0, .h1, .h10 }; // defaults to .h10
.asel = .bsel = { .hxy, where x,y are from { 0, 1, 2, 3 } };
.asel defaults to .h10
.bsel defaults to .h32
说明
带二级运算的双向 SIMD 并行算术运算。
参与运算的每个双半字源的元素,都借助 asel 与 bsel 修饰符,从两个源操作数 a 与 b 的四个半字中选取。
随后,被选中的半字被并行地运算。
结果可选地被钳制到由目标类型(有符号或无符号)确定的相应范围。饱和不能与二级累加运算同时使用。
对于带二级 SIMD 合并运算的指令:
对于 mask 所指示的半字位置,被选中的半字结果被复制到目标操作数
d。对于所有其他位置,来自源操作数c的相应半字被复制到d。
对于带二级累加运算的指令:
对于 mask 所指示的半字位置,被选中的半字结果与操作数
c相加,在d中产生结果。
语义
// extract pairs of half-words and sign- or zero-extend
// based on operand type
Va = extractAndSignExt_2( a, b, .asel, .atype );
Vb = extractAndSignExt_2( a, b, .bsel, .btype );
Vc = extractAndSignExt_2( c );
for (i=0; i<2; i++) {
switch ( vop2 ) {
case vadd2: t[i] = Va[i] + Vb[i];
case vsub2: t[i] = Va[i] - Vb[i];
case vavrg2: if ( ( Va[i] + Vb[i] ) >= 0 ) {
t[i] = ( Va[i] + Vb[i] + 1 ) >> 1;
} else {
t[i] = ( Va[i] + Vb[i] ) >> 1;
}
case vabsdiff2: t[i] = | Va[i] - Vb[i] |;
case vmin2: t[i] = MIN( Va[i], Vb[i] );
case vmax2: t[i] = MAX( Va[i], Vb[i] );
}
if (.sat) {
if ( .dtype == .s32 ) t[i] = CLAMP( t[i], S16_MAX, S16_MIN );
else t[i] = CLAMP( t[i], U16_MAX, U16_MIN );
}
}
// secondary accumulate or SIMD merge
mask = extractMaskBits( .mask );
if (.add) {
d = c;
for (i=0; i<2; i++) { d += mask[i] ? t[i] : 0; }
} else {
d = 0;
for (i=0; i<2; i++) { d |= mask[i] ? t[i] : Vc[i]; }
}
示例
vadd2.s32.s32.u32.sat r1, r2, r3, r1;
vsub2.s32.s32.s32.sat r1.h0, r2.h10, r3.h32, r1;
vmin2.s32.u32.u32.add r1.h10, r2.h00, r3.h22, r1;
9.7.20.2.2. SIMD 视频指令:vset2#
vset2
整数双半字 SIMD 比较。
语法
// SIMD instruction with secondary SIMD merge operation
vset2.atype.btype.cmp d{.mask}, a{.asel}, b{.bsel}, c;
// SIMD instruction with secondary accumulate operation
vset2.atype.btype.cmp.add d{.mask}, a{.asel}, b{.bsel}, c;
.atype = .btype = { .u32, .s32 };
.cmp = { .eq, .ne, .lt, .le, .gt, .ge };
.mask = { .h0, .h1, .h10 }; // defaults to .h10
.asel = .bsel = { .hxy, where x,y are from { 0, 1, 2, 3 } };
.asel defaults to .h10
.bsel defaults to .h32
说明
带二级运算的双向 SIMD 并行比较。
参与运算的每个双半字源的元素,都借助 asel 与 bsel 修饰符,从两个源操作数 a 与 b 的四个半字中选取。
随后,被选中的半字被并行地比较。
比较的中间结果始终为无符号,因此目标操作数 d 与操作数 c 的半字也为无符号。
对于带二级 SIMD 合并运算的指令:
对于 mask 所指示的半字位置,被选中的半字结果被复制到目标操作数
d。对于所有其他位置,来自源操作数b的相应半字被复制到d。
对于带二级累加运算的指令:
对于 mask 所指示的半字位置,被选中的半字结果与操作数
c相加,在d中产生a结果。
语义
// extract pairs of half-words and sign- or zero-extend
// based on operand type
Va = extractAndSignExt_2( a, b, .asel, .atype );
Vb = extractAndSignExt_2( a, b, .bsel, .btype );
Vc = extractAndSignExt_2( c );
for (i=0; i<2; i++) {
t[i] = compare( Va[i], Vb[i], .cmp ) ? 1 : 0;
}
// secondary accumulate or SIMD merge
mask = extractMaskBits( .mask );
if (.add) {
d = c;
for (i=0; i<2; i++) { d += mask[i] ? t[i] : 0; }
} else {
d = 0;
for (i=0; i<2; i++) { d |= mask[i] ? t[i] : Vc[i]; }
}
示例
vset2.s32.u32.lt r1, r2, r3, r0;
vset2.u32.u32.ne.add r1, r2, r3, r0;
9.7.20.2.3. SIMD 视频指令:vadd4、vsub4、vavrg4、vabsdiff4、vmin4、vmax4#
vadd4, vsub4
整数四字节 SIMD 加法/减法。
vavrg4
整数四字节 SIMD 平均值。
vabsdiff4
整数四字节 SIMD 差值绝对值。
vmin4, vmax4
整数四字节 SIMD 最小值/最大值。
语法
// SIMD instruction with secondary SIMD merge operation
vop4.dtype.atype.btype{.sat} d{.mask}, a{.asel}, b{.bsel}, c;
// SIMD instruction with secondary accumulate operation
vop4.dtype.atype.btype.add d{.mask}, a{.asel}, b{.bsel}, c;
vop4 = { vadd4, vsub4, vavrg4, vabsdiff4, vmin4, vmax4 };
.dtype = .atype = .btype = { .u32, .s32 };
.mask = { .b0,
.b1, .b10
.b2, .b20, .b21, .b210,
.b3, .b30, .b31, .b310, .b32, .b320, .b321, .b3210 };
defaults to .b3210
.asel = .bsel = .bxyzw, where x,y,z,w are from { 0, …, 7 };
.asel defaults to .b3210
.bsel defaults to .b7654
说明
带次级操作的四路 SIMD 并行算术运算。
运算所用的每个四字节源元素,都通过 asel 和 bsel 修饰符,从两个源操作数 a 和 b 的八个字节中选取。
随后并行地对选中的字节进行运算。
结果可选择性地钳制到由目标类型(有符号或无符号)确定的相应范围内。饱和不能与次级累加运算一起使用。
对于带次级 SIMD 合并操作的指令:
对于掩码中指明的字节位置,选中的字节结果被复制到目标
d。对于所有其他位置,源操作数c中的对应字节被复制到d。
对于带次级累加操作的指令:
对于掩码中指明的字节位置,选中的字节结果被加到操作数
c上,在d中产生结果。
语义
// extract quads of bytes and sign- or zero-extend
// based on operand type
Va = extractAndSignExt_4( a, b, .asel, .atype );
Vb = extractAndSignExt_4( a, b, .bsel, .btype );
Vc = extractAndSignExt_4( c );
for (i=0; i<4; i++) {
switch ( vop4 ) {
case vadd4: t[i] = Va[i] + Vb[i];
case vsub4: t[i] = Va[i] - Vb[i];
case vavrg4: if ( ( Va[i] + Vb[i] ) >= 0 ) {
t[i] = ( Va[i] + Vb[i] + 1 ) >> 1;
} else {
t[i] = ( Va[i] + Vb[i] ) >> 1;
}
case vabsdiff4: t[i] = | Va[i] - Vb[i] |;
case vmin4: t[i] = MIN( Va[i], Vb[i] );
case vmax4: t[i] = MAX( Va[i], Vb[i] );
}
if (.sat) {
if ( .dtype == .s32 ) t[i] = CLAMP( t[i], S8_MAX, S8_MIN );
else t[i] = CLAMP( t[i], U8_MAX, U8_MIN );
}
}
// secondary accumulate or SIMD merge
mask = extractMaskBits( .mask );
if (.add) {
d = c;
for (i=0; i<4; i++) { d += mask[i] ? t[i] : 0; }
} else {
d = 0;
for (i=0; i<4; i++) { d |= mask[i] ? t[i] : Vc[i]; }
}
示例
vadd4.s32.s32.u32.sat r1, r2, r3, r1;
vsub4.s32.s32.s32.sat r1.b0, r2.b3210, r3.b7654, r1;
vmin4.s32.u32.u32.add r1.b00, r2.b0000, r3.b2222, r1;
9.7.20.2.4. SIMD 视频指令:vset4#
vset4
整数四字节 SIMD 比较。
语法
// SIMD instruction with secondary SIMD merge operation
vset4.atype.btype.cmp d{.mask}, a{.asel}, b{.bsel}, c;
// SIMD instruction with secondary accumulate operation
vset4.atype.btype.cmp.add d{.mask}, a{.asel}, b{.bsel}, c;
.atype = .btype = { .u32, .s32 };
.cmp = { .eq, .ne, .lt, .le, .gt, .ge };
.mask = { .b0,
.b1, .b10
.b2, .b20, .b21, .b210,
.b3, .b30, .b31, .b310, .b32, .b320, .b321, .b3210 };
defaults to .b3210
.asel = .bsel = .bxyzw, where x,y,z,w are from { 0, …, 7 };
.asel defaults to .b3210
.bsel defaults to .b7654
说明
带次级操作的四路 SIMD 并行比较。
运算所用的每个四字节源元素,都通过 asel 和 bsel 修饰符,从两个源操作数 a 和 b 的八个字节中选取。
随后并行地比较选中的字节。
比较的中间结果始终是无符号的,因此目标 d 和操作数 c 的字节也是无符号的。
对于带次级 SIMD 合并操作的指令:
对于掩码中指明的字节位置,选中的字节结果被复制到目标
d。对于所有其他位置,源操作数b中的对应字节被复制到d。
对于带次级累加操作的指令:
对于掩码中指明的字节位置,选中的字节结果被加到操作数
c上,在d中产生结果。
语义
// extract quads of bytes and sign- or zero-extend
// based on operand type
Va = extractAndSignExt_4( a, b, .asel, .atype );
Vb = extractAndSignExt_4( a, b, .bsel, .btype );
Vc = extractAndSignExt_4( c );
for (i=0; i<4; i++) {
t[i] = compare( Va[i], Vb[i], cmp ) ? 1 : 0;
}
// secondary accumulate or SIMD merge
mask = extractMaskBits( .mask );
if (.add) {
d = c;
for (i=0; i<4; i++) { d += mask[i] ? t[i] : 0; }
} else {
d = 0;
for (i=0; i<4; i++) { d |= mask[i] ? t[i] : Vc[i]; }
}
示例
vset4.s32.u32.lt r1, r2, r3, r0;
vset4.u32.u32.ne.max r1, r2, r3, r0;
9.7.21. 杂项指令#
杂项指令包括:
brkptnanosleeppmeventtrapsetmaxnreg
9.7.21.1. 杂项指令:brkpt#
brkpt
断点。
语法
brkpt;
说明
暂停执行。
示例
brkpt;
@p brkpt;
9.7.21.2. 杂项指令:nanosleep#
nanosleep
让线程暂停约定的纳秒数。
语法
nanosleep.u32 t;
说明
线程暂停时长约为 t 纳秒;t 可以是寄存器,也可以是立即数。
实际时长是近似值,但保证位于 [0, 2*t] 区间内,最长为 1 毫秒。实现可以缩短同一 warp 中个别线程的等待时间,使该 warp 内所有休眠线程同时唤醒。
示例
.reg .b32 r;
.reg .pred p;
nanosleep.u32 r;
nanosleep.u32 42;
@p nanosleep.u32 r;
9.7.21.3. 杂项指令:pmevent#
pmevent
触发一个或多个性能监控事件。
语法
pmevent a; // trigger a single performance monitor event
pmevent.mask a; // trigger one or more performance monitor events
说明
操作数 a 是立即数,用作事件编号或事件位掩码。
不带修饰符 .mask 的 pmevent 按立即数操作数 a 指定的编号触发单个性能监控事件,编号范围为 0..15。
pmevent.mask 触发一个或多个性能监控事件。16 位立即数操作数 a 中的每一位分别控制一个事件。
程序触发的性能监控事件可以通过布尔函数与其他硬件事件组合,用来增加四个性能计数器之一。事件与计数器之间的对应关系由主机端 API 调用配置。
示例
pmevent 1;
@p pmevent 7;
@q pmevent.mask 0xff;
9.7.21.4. 杂项指令:trap#
trap
执行陷阱操作。
语法
trap;
说明
中止执行,并向主机 CPU 产生中断。
示例
trap;
@p trap;
9.7.21.5. 杂项指令:setmaxnreg#
setmaxnreg
提示系统调整 warp 所拥有的寄存器数量。
语法
setmaxnreg.action.sync.aligned.u32 imm-reg-count;
.action = { .inc, .dec };
说明
该指令提示系统,将执行该指令的 warp 所拥有的每线程寄存器数上限调整为 imm-reg-count。
.dec 将上限从当前值降低到指定值,以释放多余寄存器;.inc 则请求更多寄存器,将上限提高到指定值。
每个 CTA 都维护一个可用寄存器池。系统根据 .action 的值,从池中向请求的 warp 提供寄存器,或将该 warp 的多余寄存器归还给池中。
setmaxnreg.inc 会阻塞,直到 CTA 的寄存器池中有足够寄存器可用。新分配寄存器的初始内容未定义,使用前必须先初始化。
同一条 setmaxnreg 指令必须由某个 warpgroup 中的所有 warp 执行。执行完一条 setmaxnreg 指令后,该 warpgroup 中的所有 warp 必须先显式同步,然后才能执行后续的 setmaxnreg 指令。如果一条 setmaxnreg 指令并非由该 warpgroup 中的所有 warp 执行,则行为未定义。
imm-reg-count 必须是整数常量,取值范围为 24 至 256(含端点),且必须是 8 的倍数。
warp 寄存器文件的调整始终发生在寄存器文件的高编号端。
启动 kernel 时,必须通过相应的编译选项或性能调优指令指定有效的每线程寄存器数上限;否则 setmaxnreg 可能不起作用。
使用 .dec 时,执行前 warp 所拥有的每线程寄存器数上限必须大于或等于 imm-reg-count;否则行为未定义。
使用 .inc 时,执行前 warp 所拥有的每线程寄存器数上限必须小于或等于 imm-reg-count;否则行为未定义。
必需的 .sync 修饰符表示:执行线程会等待,直到 warp 中所有线程都执行同一条 setmaxnreg 指令,然后才继续执行。
必需的 .aligned 修饰符表示:warpgroup 中所有线程都必须执行同一条 setmaxnreg 指令。在条件执行的代码中,只有确定 warpgroup 内所有线程对条件的判断一致时,才应使用 setmaxnreg;否则行为未定义。
示例
setmaxnreg.dec.sync.aligned.u32 64;
setmaxnreg.inc.sync.aligned.u32 192;