3.1. 一组 SIMT 多处理器#
NVIDIA GPU 架构以可扩展的多线程流式多处理器(Streaming Multiprocessors,SM)阵列为基础。主机程序启动一个 kernel grid 后,grid 中的线程块会被编号,并分配给有可用执行资源的多处理器。一个线程块中的线程会在同一个多处理器上并发执行。随着线程块执行完毕,新的线程块会被调度到腾出的多处理器上。
一个多处理器包含多个标量处理器(Scalar Processor,SP)核心、一个多线程指令单元和片上共享内存。多处理器在硬件中创建、管理和执行并发线程,无需调度开销。它支持单指令 barrier 同步。快速 barrier 同步、轻量级线程创建和零开销线程调度共同支持非常细粒度的并行;例如,可以用较小的粒度分解问题,为每个数据元素分配一个线程,例如图像中的像素、体数据中的体素,或基于网格的计算中的单元。
为了管理数百个同时运行的线程(这些线程可能执行多个不同的程序),多处理器采用了一种称为 **SIMT(单指令多线程,single-instruction, multiple-thread)**的架构。多处理器将每个线程映射到一个标量处理器核心,每个标量线程都能独立执行,并拥有各自的指令地址和寄存器状态。多处理器的 SIMT 单元按称为 warp 的并行线程组来创建、管理、调度和执行线程。(warp 一词源自织布,是早期并行线程技术中的术语。)组成一个 SIMT warp 的各个线程从同一程序地址同时开始执行,但除此之外,各自可以自由地分支和独立执行。
多处理器获得一个或多个线程块后,会将它们拆分为 warp,再交由 SIMT 单元调度。线程块拆分为 warp 的方式始终一致:每个 warp 包含线程标识符连续递增的线程,并且第一个 warp 从线程 0 开始。
在每次发射指令时,SIMT 单元都会选取一个已准备好执行的 warp,并向该 warp 中活动的线程发射下一条指令。一个 warp 在同一时刻执行一条共同指令;只有当 warp 内所有线程选择相同的执行路径时,执行效率才最高。如果 warp 内的线程由于依赖数据的条件分支而发生分歧(divergence),warp 会依次执行实际采用的各条分支路径,并暂时停用不在当前路径上的线程;所有路径执行完成后,线程会重新汇合到相同执行路径。分支分歧只会发生在单个 warp 内;不同 warp 相互独立执行,即使它们执行的是相同或完全不同的代码路径,也不会彼此影响。
SIMT 架构与 SIMD(单指令多数据,Single Instruction, Multiple Data)向量架构类似:一条指令控制多个处理单元。关键区别在于,SIMD 向量架构会把 SIMD 宽度暴露给软件,而 SIMT 指令描述的是单个线程的执行与分支行为。与 SIMD 向量机器不同,SIMT 让程序员可以针对相互独立的标量线程编写线程级并行代码,也可以针对彼此协作的线程编写数据并行代码。
为了保证正确性,程序员基本可以忽略 SIMT 的执行方式;不过,如果编写代码时尽量减少 warp 内线程的执行分歧,就可能获得显著的性能提升。这与传统代码中的缓存行类似:设计正确性时可以忽略缓存行大小,但要获得峰值性能,就需要在代码结构中考虑它。相比之下,向量架构要求软件显式地将加载操作合并成向量,并手动处理分歧。
一个多处理器能同时处理多少个线程块,取决于给定 kernel 所需的每线程寄存器数量和每块共享内存数量,因为多处理器的寄存器和共享内存要由批次中的所有线程块共同分配。如果多处理器可用的寄存器或共享内存不足以至少处理一个线程块,kernel 将无法启动。
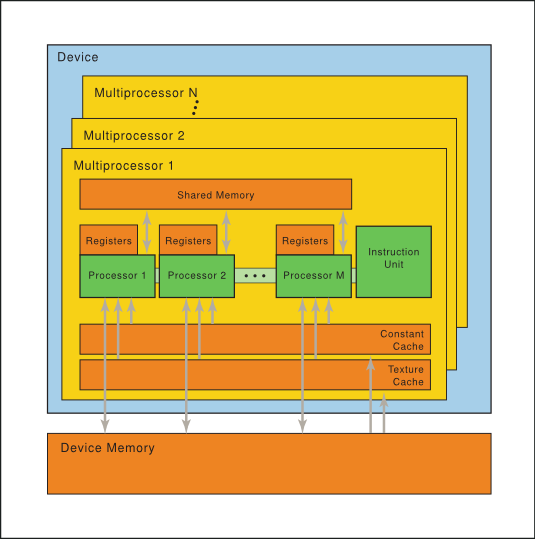
图 4 硬件模型
一组带有片上共享内存的 SIMT 多处理器。
3.2. 独立线程调度#
在 Volta 之前的架构上,一个 warp 的 32 个线程共用一个程序计数器,并使用活动掩码标记 warp 中当前活动的线程。因此,如果同一 warp 中的线程执行不同的分支路径或处于不同的执行状态,它们便不能相互发信号或交换数据。对于需要在锁或互斥量保护下细粒度共享数据的算法,竞争线程来自哪个 warp 可能导致死锁。
从 Volta 架构开始,独立线程调度(Independent Thread Scheduling)允许各线程充分并发,而不受 warp 边界限制。采用独立线程调度后,GPU 为每个线程维护执行状态,包括程序计数器和调用栈;GPU 还可以在线程粒度上暂停某个线程,以便更好地利用执行资源,或让某个线程等待另一个线程生成的数据。调度优化器会决定如何将同一 warp 中活动的线程分组到 SIMT 单元中。该机制保留了此前 NVIDIA GPU 上 SIMT 执行的高吞吐量,同时提供更大的灵活性:现在,线程可以在小于一个 warp 的粒度上发生分歧,并重新汇合。
如果开发者仍假设较早硬件架构的 warp 同步行为,独立线程调度可能使实际参与执行代码的线程集合与预期大不相同。尤其需要重新检查所有依赖 warp 同步的代码,例如不依赖同步操作的 warp 内归约,以确保它们与 Volta 及更新架构兼容。详情请参阅《CUDA 编程指南》中关于计算能力 7.x 的章节。
3.3. 片上共享内存#
如图 4所示,每个多处理器都具有以下四类片上存储:
- 每个处理器都有一组本地 32 位寄存器。
- 共享内存是一种并行数据缓存,由所有标量处理器核心共享;共享内存空间位于此处。
- 常量缓存由所有标量处理器核心共享,只读,用于加速从常量内存空间读取数据。常量内存空间是设备内存中的一个只读区域。
- 纹理缓存由所有标量处理器核心共享,只读,用于加速从纹理内存空间读取数据。纹理内存空间是设备内存中的一个只读区域;每个多处理器都通过纹理单元访问纹理缓存,由纹理单元实现多种寻址模式和数据过滤。
本地内存空间和全局内存空间都是设备内存中可读写的区域。