2.1. 高度多线程的协处理器#
GPU 是一种计算设备,能够并行执行大量线程。它作为主 CPU(即主机,host)的协处理器运行:也就是说,主机应用程序中数据并行且计算密集的部分会被卸载到设备上执行。
更具体地说,如果应用程序的一部分需要对不同数据彼此独立地重复执行多次,就可以将其抽取为一个 kernel 函数,再由 GPU 上的多个线程执行。为此,需要将该函数编译为 PTX 指令集,并在安装时将生成的 kernel 转换为目标 GPU 的指令集。
2.2. 线程层级#
执行 kernel 的线程批次组织成一个 grid。grid 由协作线程数组(cooperative thread arrays,CTA)组成,也可以由 CTA 的集群组成;本节的说明与图 1和图 2相对应。CTA 对应 CUDA 线程块(thread block),集群对应 CUDA 线程块集群。
2.2.1. 协作线程数组#
并行线程执行(Parallel Thread Execution,PTX)编程模型是显式并行的:一个 PTX 程序描述并行线程数组中单个线程的执行。协作线程数组(cooperative thread array,CTA)是并发或并行执行一个 kernel 的线程数组。
一个 CTA 内的线程可以相互通信。为了协调这些线程之间的通信,可以设置同步点,让线程在此等待,直到 CTA 中的所有线程都已到达。
一个 CTA 内的每个线程都有唯一的线程标识符。程序使用数据并行分解方法,将输入、工作和结果分配给 CTA 中的线程。每个 CTA 线程根据自身的线程标识符确定承担的任务、指定输入和输出的位置、计算地址,以及选择要执行的工作。线程标识符是一个三元素向量 tid(各元素为 tid.x、tid.y 和 tid.z),表示线程在一维、二维或三维 CTA 中的位置。在每个维度上,线程标识符分量从零开始,取值范围一直到该维度的线程数量。
每个 CTA 都有一维、二维或三维的形状,由三元素向量 ntid(各元素为 ntid.x、ntid.y 和 ntid.z)指定。向量 ntid 给出 CTA 在各个维度上的线程数量。
一个 CTA 内的线程以 SIMT(单指令多线程,single-instruction, multiple-thread)方式分组执行,这种分组称为 warp。一个 warp 是同一个 CTA 中能够同时执行相同指令的最大线程子集。warp 内的线程按顺序编号。warp 大小是依赖机器的常量,通常为 32 个线程。了解 warp 大小可能有助于某些应用最大化性能,因此 PTX 提供运行时立即数常量 WARP_SZ,可用于任何允许立即数操作数的指令。
2.2.2. 协作线程数组集群#
集群是并发或并行运行的一组 CTA,它们可以通过共享内存相互同步和通信。执行中的 CTA 必须先确保对端 CTA 的共享内存已经存在,才能通过共享内存与其通信;在完成共享内存操作之前,还必须确保对端 CTA 尚未退出。
集群中不同 CTA 的线程可以通过共享内存相互同步和通信。可以使用集群范围的 barrier 来同步集群中的所有线程。集群中的每个 CTA 都有一个在该集群内唯一的 CTA 标识符(cluster_ctaid)。每个 CTA 集群由参数 cluster_nctaid 指定其一维、二维或三维形状。集群中的每个 CTA 还具有一个跨越所有维度的唯一 CTA 标识符(cluster_ctarank);集群所有维度上的 CTA 总数由 cluster_nctarank 指定。线程可通过预定义的只读特殊寄存器 %cluster_ctaid、%cluster_nctaid、%cluster_ctarank 和 %cluster_nctarank 读取并使用这些值。
集群层级仅适用于目标架构 sm_90 或更高版本。启动 kernel 时可以选择是否指定集群层级。如果用户在启动时指定集群维度,这就是显式集群启动;否则就是维度默认为 1×1×1 的隐式集群启动。PTX 提供只读特殊寄存器 %is_explicit_cluster,用于区分显式和隐式集群启动。
2.2.3. 集群网格#
一个 CTA 所能包含的线程数有上限,一个集群所能包含的 CTA 数量也有上限。不过,执行相同 kernel 的多个 CTA 集群可以合并成一个集群网格。这样,单次 kernel 调用就能启动非常多的线程,代价是线程间的通信和同步能力会降低,因为不同集群中的线程无法相互通信或同步。
每个集群在集群网格中都有唯一的集群标识符(clusterid)。每个集群网格的一维、二维或三维形状由参数 nclusterid 指定。每个网格还具有唯一的时间网格标识符(gridid)。线程可通过预定义的只读特殊寄存器 %tid、%ntid、%clusterid、%nclusterid 和 %gridid 读取并使用这些值。
每个 CTA 在网格中都有唯一标识符(ctaid)。每个 CTA 网格的一维、二维或三维形状由参数 nctaid 指定。线程可通过预定义的只读特殊寄存器 %ctaid 和 %nctaid 读取并使用这些值。
每个 kernel 都作为一批线程执行,这批线程组织成由 CTA 集群组成的网格;集群是可选层级,并且只适用于目标架构 sm_90 及更高版本。图 1展示由 CTA 组成的网格,图 2展示由集群组成的网格。
不同网格之间可以有启动依赖关系:一个网格可以是依赖网格,也可以是前置网格。有关如何定义网格依赖关系,请参阅《CUDA 编程指南》中的 CUDA Graphs 一节。
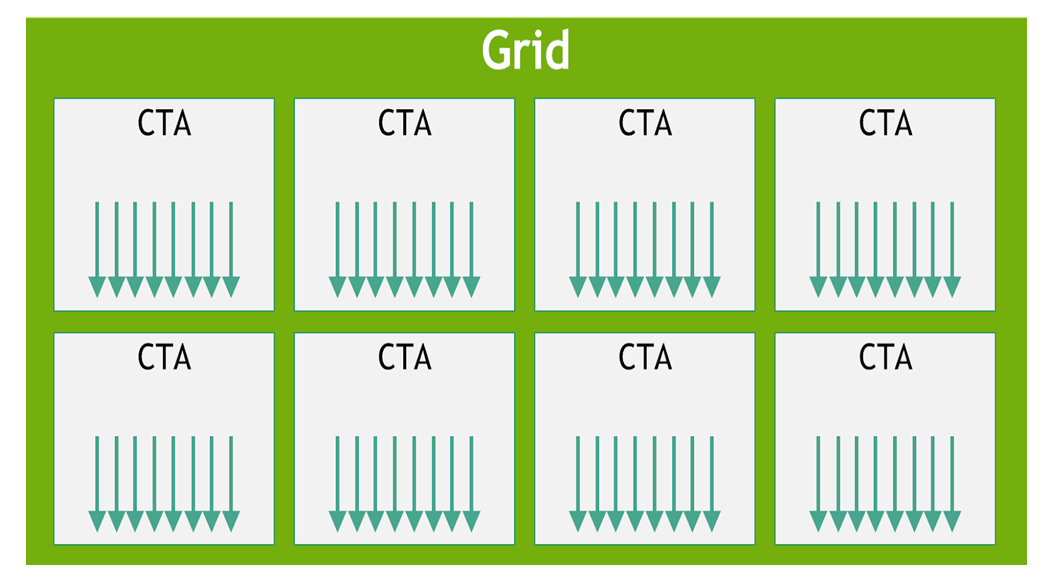
图 1 由 CTA 组成的网格
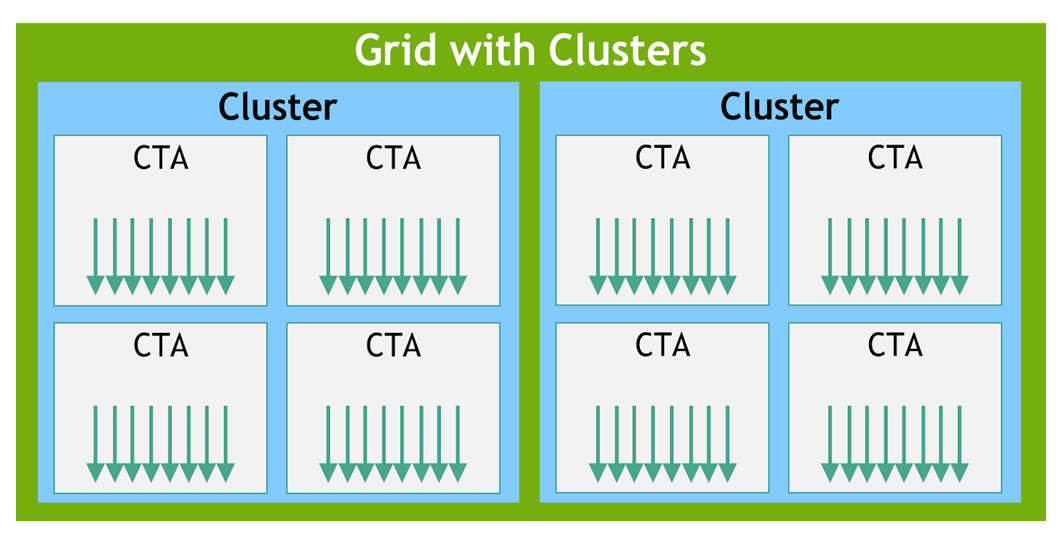
图 2 由集群组成的网格
一个集群由多个协作线程数组(CTA)组成;一个 CTA 是一组并发执行相同 kernel 程序的线程。一个 grid 则由多个彼此独立执行的 CTA 集群组成。
2.3. 内存层级#
执行期间,PTX 线程可以访问多个状态空间中的数据,如图 3所示。目标架构从 sm_90 起引入了集群层级。每个线程都有私有的本地内存。每个线程块(CTA)都有共享内存;线程块中的所有线程,以及集群中所有活动线程块,都可以访问该共享内存。共享内存的生命周期与线程块相同。最后,所有线程都可以访问同一全局内存。
所有线程还可以访问其他状态空间:常量、参数(param)、纹理和表面状态空间。常量内存和纹理内存是只读的;表面内存则可读写。全局、常量、参数、纹理和表面状态空间针对不同的内存用途分别优化。例如,纹理内存提供不同的寻址模式,并能对特定数据格式进行过滤。
需要注意,纹理内存和表面内存都带有缓存。在同一次 kernel 调用期间,这些缓存与对全局内存或表面内存的写入并不保持一致。因此,如果某个地址在同一次 kernel 调用中被全局内存写入或表面内存写入,之后对该地址进行纹理读取或表面读取,结果是未定义的。换言之,只有在该纹理或表面内存位置已由先前的 kernel 调用或内存复制更新时,线程才能安全地读取它;如果该位置是在同一次 kernel 调用中由当前线程或其他线程更新的,则不能安全读取。
同一个应用程序的多次 kernel 启动之间,全局、常量和纹理状态空间会保持持久。
主机和设备各自都有本地内存,分别称为主机内存(host memory)和设备内存(device memory)。主机可以映射设备内存并对其读写。也可以通过优化的 API 调用,利用设备的高性能直接内存访问(Direct Memory Access,DMA)引擎,将数据从主机内存复制到设备内存,以实现更高效的传输。
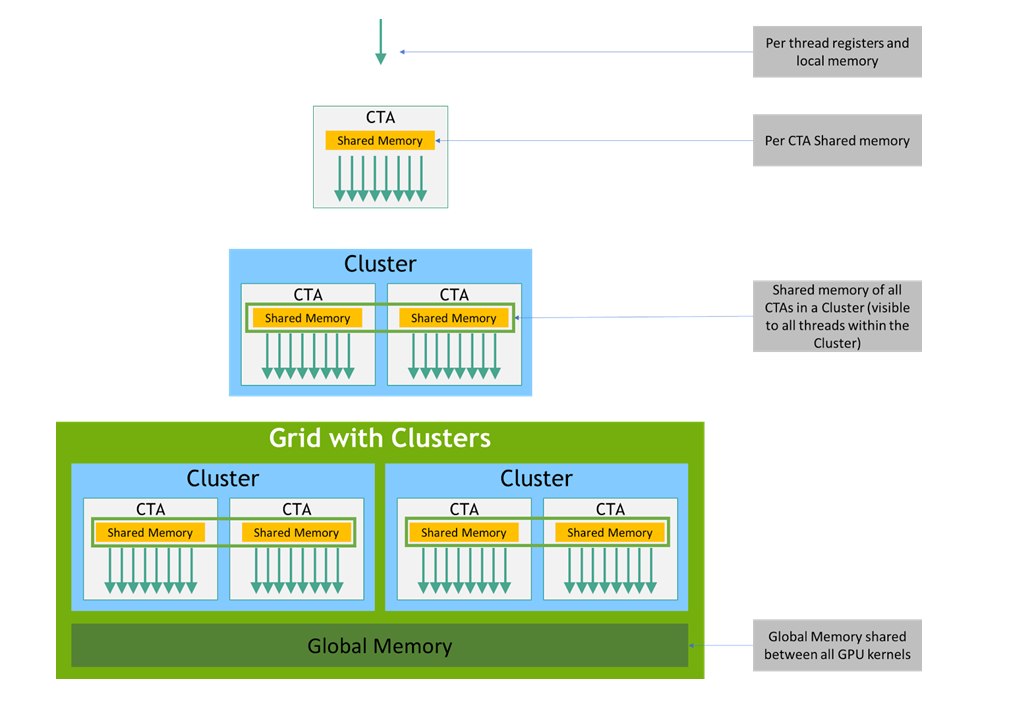
图 3 内存层级